GraphRAG論文の72-83%勝率と4段階
「GraphRAGって、要はベクトルRAGに勝つやつでしょ」と言われるたびに、私は少しだけ言葉に詰まります。勝ちます。ただし、どの数字も同じ意味では勝っていません。
Microsoft の GraphRAG 論文 (arXiv 2404.16130 “From Local to Global”) は、ちゃんと読むと「勝率」の中身が4つに分かれています。今日はその中身を、論文とリポジトリと公式ドキュメントを突き合わせながらほどきます。
何を測ったのか — 2データセットの正体
論文が使ったデータセットは2つです。どちらも公開素材で、桁だけ書き出すとこう並びます。
| データセット | 規模 | 分割 |
|---|---|---|
| Podcast transcripts | 約1M tokens | 1,669 チャンク × 600 tokens、100 tokens重複 |
| News articles | 約1.7M tokens | 3,197 チャンク × 600 tokens、100 tokens重複 |
2Mトークンいかない規模で、しかもチャンクは600トークン固定です。ここを最初に押さえておかないと、「大規模データで勝った」という抽象化を勝手にしてしまいます。論文が主張しているのは、あくまでこの2データセットでの sensemaking (概観理解) 質問クラスに対する勝率です。
GraphRAG の4段階 C0-C3 は「コミュニティ階層」
論文は GraphRAG を4段階のコミュニティレベル C0-C3 として提示します。ここが実装ドキュメントより一段抽象度が高くて、最初は混乱しました。
- C0 (root level): 最も粗い要約。コミュニティを最上位でまとめる
- C1 (high level): 中間の上
- C2 (intermediate level): 中間
- C3 (low level): 最も細かい要約。C0 の対極
Leiden アルゴリズムで抽出したエンティティのコミュニティを、階層的にまとめ直したものです。C0 は「森全体」、C3 は「一本一本の木の説明」に近いイメージ、と自分の頭では整理しています。
論文の勝率は C0-C3 のそれぞれに対して測っています。単一の GraphRAG が単一の SS (Semantic Search = ベクトルRAG) と勝負したわけではありません。この点が読み流されがちです。
4つの評価軸 — 主軸2つと対照軸2つ
論文は生成された回答を LLM ジャッジで比較し、4つの軸で勝率を出しています。この4つの取り扱いが違うので、丁寧に分けます。
- Comprehensiveness (包括性): 質問の全側面をどれだけ細部までカバーしているか
- Diversity (多様性): 異なる視点・洞察をどれだけ豊かに提供しているか
- Empowerment (啓発性): 読者が主題を理解し情報に基づき判断する助けになるか
- Directness (直接性): 質問に対して具体的・明確に答えているか (対照軸 / control criterion)
Comprehensiveness / Diversity / Empowerment の3つが目的軸で、Directness だけが論文で明示的に「control criterion」と位置づけられた対照軸です。Directness は、GraphRAG が要約経由で答える設計上、SS (直接テキスト検索) に有利な軸として組まれていて、論文自身も「4軸すべてで勝つことは想定していない」と書いています。
72-83%勝率の中身 — 勝ったのは主軸2つだけ
論文が本文で報告している勝率を並べます。すべて対戦相手は SS (Semantic Search)、有意水準は括弧内です。
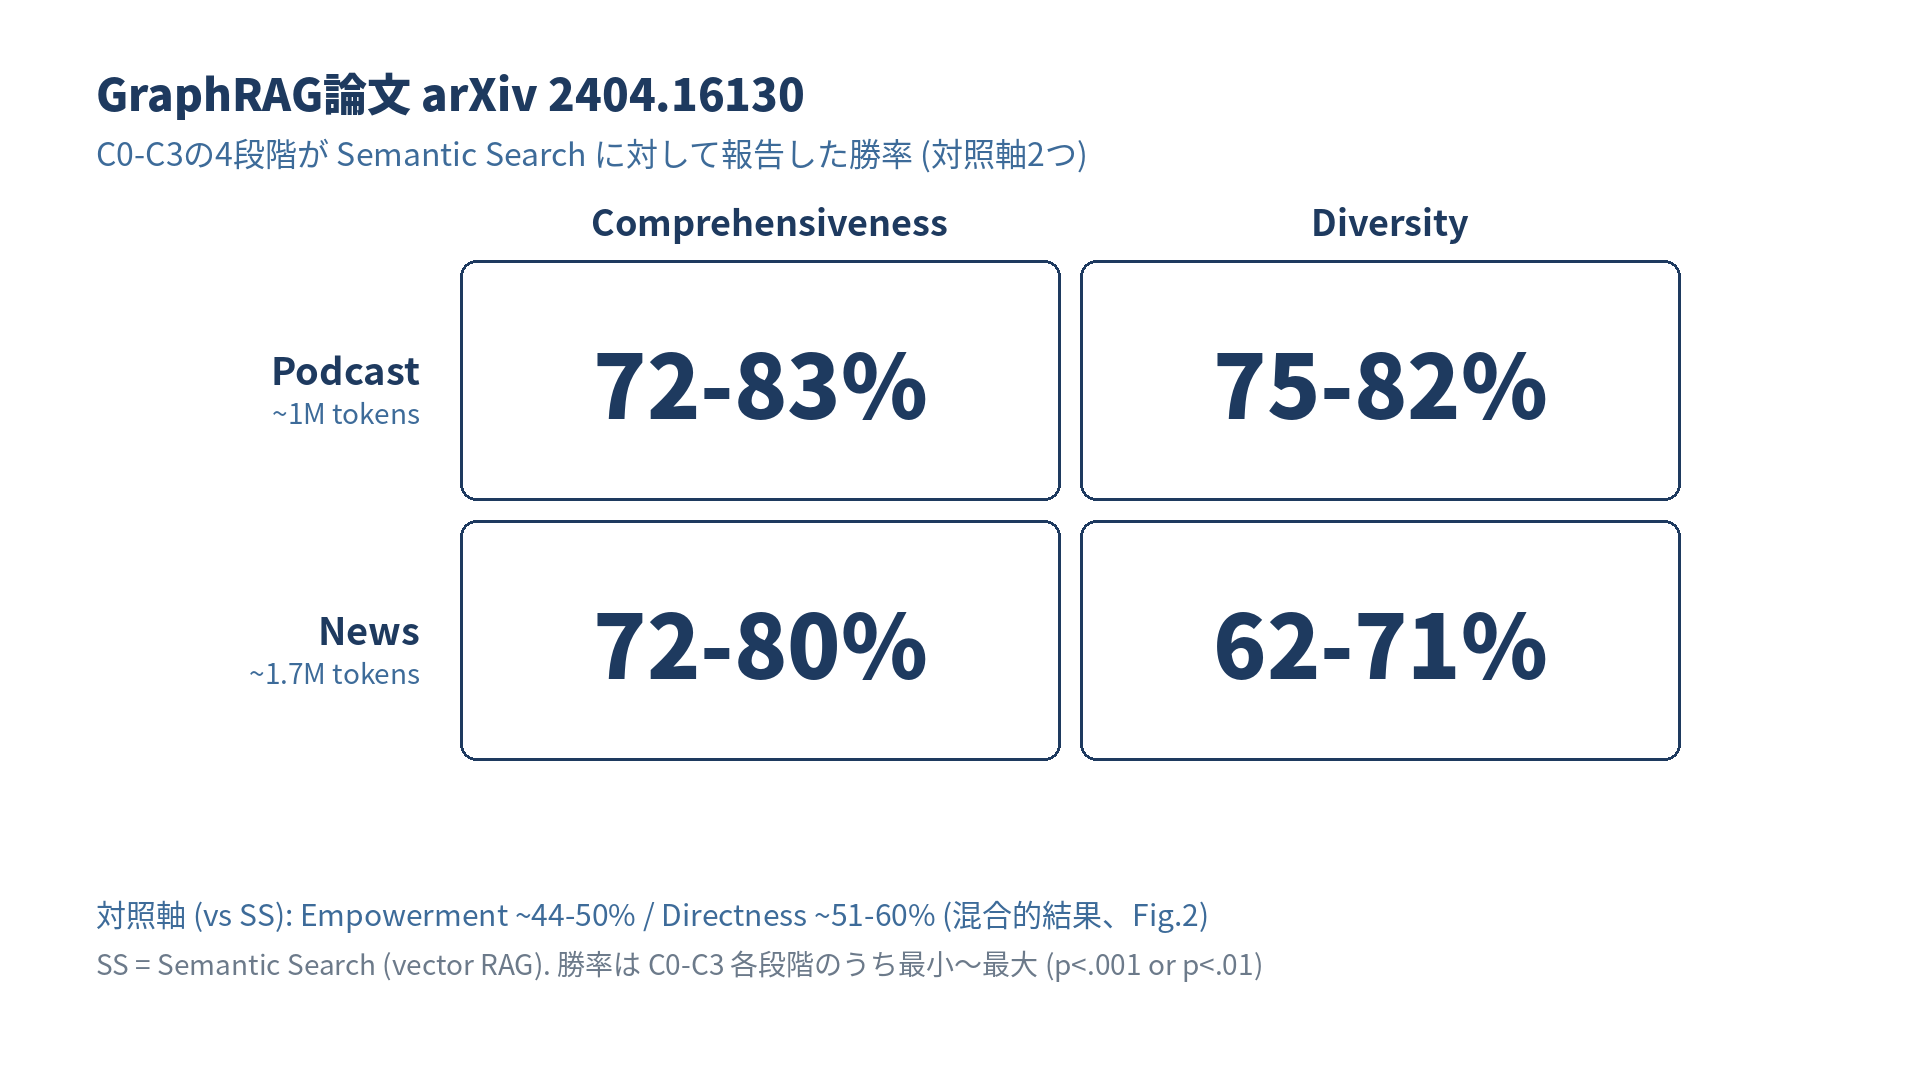
- Comprehensiveness: Podcast 72-83% / News 72-80% (ともに p<.001)
- Diversity: Podcast 75-82% (p<.001) / News 62-71% (p<.01)
- Empowerment: Figure 2 での視覚化のみ、本文は「混合的結果 (mixed results)」と記述
- Directness: 対照軸として設計、GraphRAG は SS に負ける方向 (SS が 51-59% で勝つ)
範囲で書いてあるのは C0-C3 の4段階のうち最小と最大です。Comprehensiveness と Diversity では勝ち、Empowerment は五分、対照軸 Directness では SS 側が勝つ、と読むのが正確です。ここを潰して「GraphRAG は80%勝つ」と丸めた瞬間、対照軸を捨てたことになります。
私は最初これを見落として、下書きの段階で「勝率80%」と丸めていました。書き出してから対照軸2つを見直して、あとで自分で書き直しました。勝率の分母は、書き出せば書き出すほど狭くなっていくのが正直な読み方です。
Token cost の階段 — C0で最大97%削減
もう一つ、勝率と同じくらい面白いのがトークン消費の階段です。TS (Text Summarization、グラフを使わない要約) を100%として、各段階が何%を使うかで比べます。
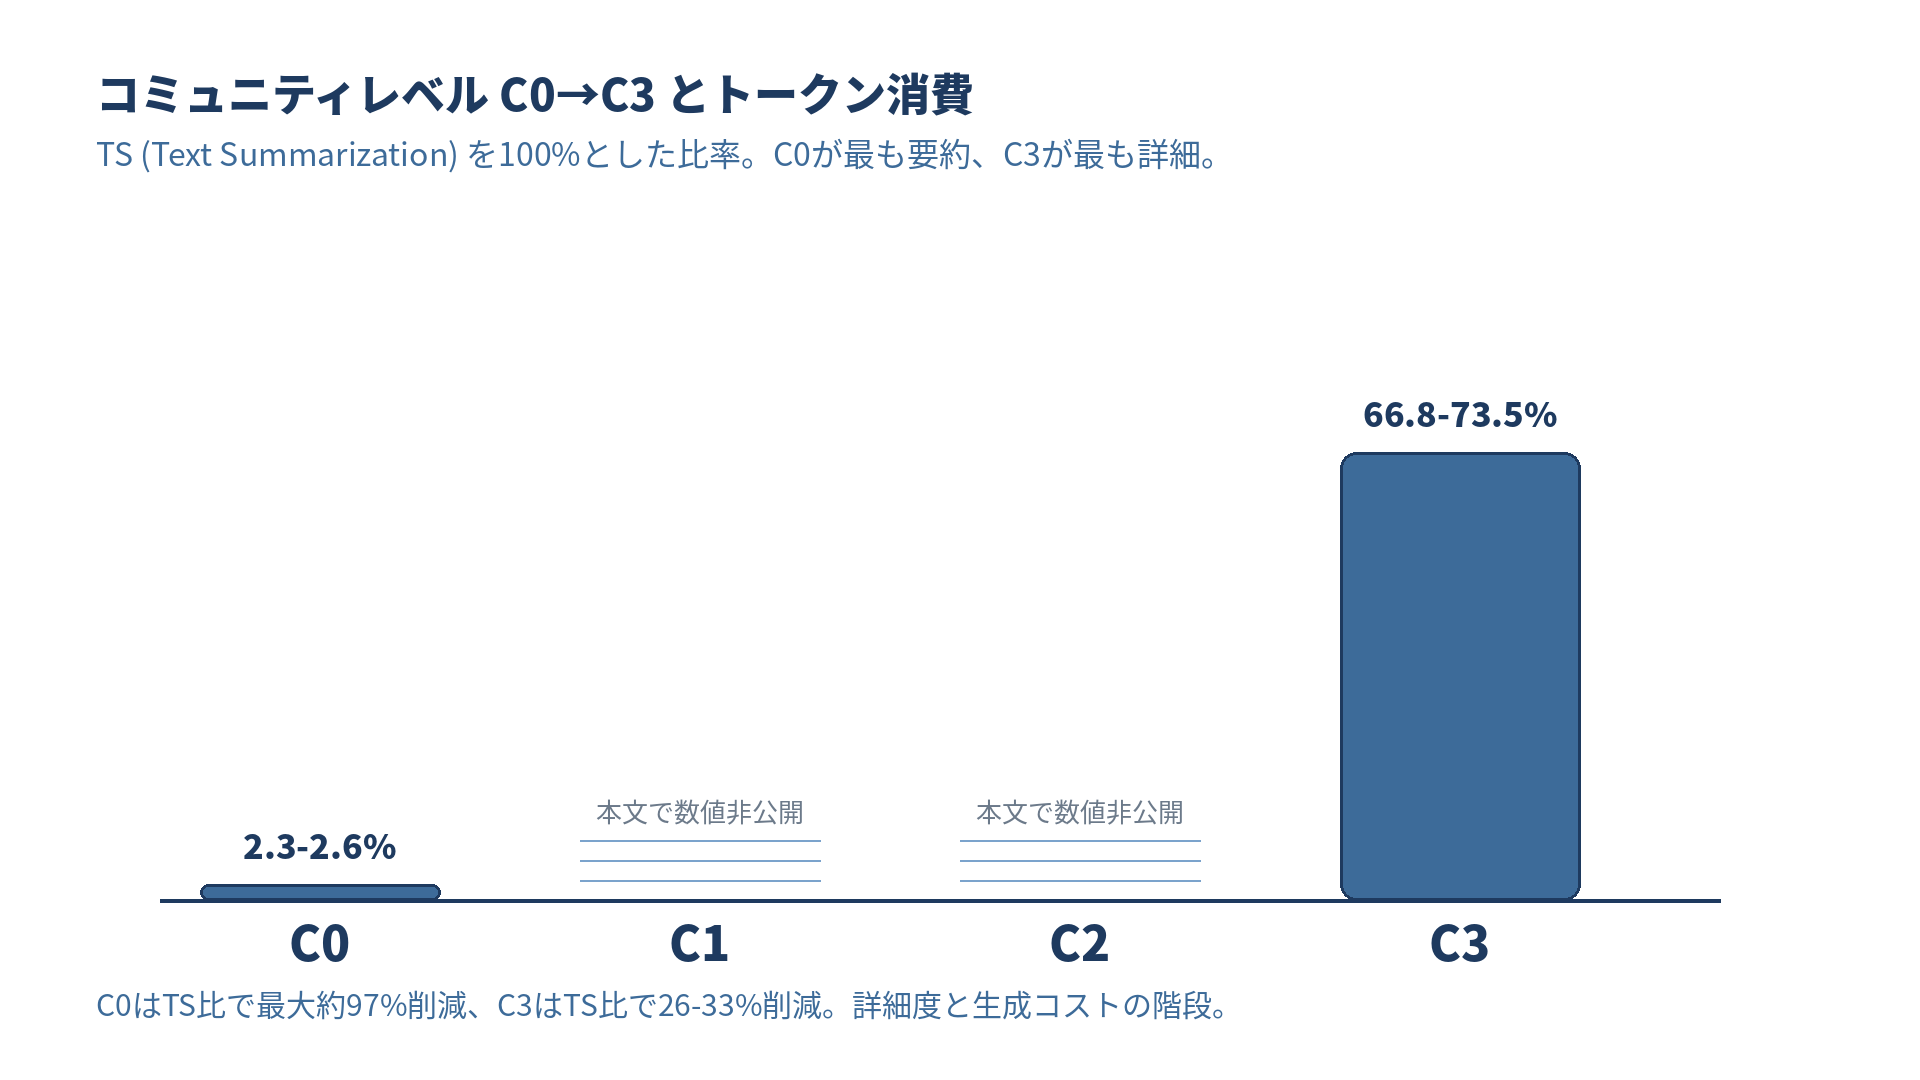
- C0: TS の 2.3-2.6% (最大約 97% 削減)
- C3: TS の 66.8-73.5% (26-33% 削減)
C0 は極端に安く、C3 は TS に近づいていきます。詳細度が上がるほどコストも上がる、という素直な階段です。ここに Comprehensiveness の勝率を重ねると、「C0 のような安い段階でも 72% 前後の Comprehensiveness を取れる」ことがわかります。これは「詳細を捨てても包括性は落ちない」という、少し意外な結論の入り口です。
論文語彙と実装語彙の違い — Global/Local Search はどこから来たか
私が読んで最初に混乱したのは、論文本文に 「Global Search」「Local Search」という用語が明示的には出てこないことでした。論文が言っているのは「global sensemaking queries」に対する Graph RAG アプローチであって、“モード名”としての Global Search ではありません。
一方、Microsoft GraphRAG 公式クエリドキュメント では4つのモードが明示されています。
| モード | 使うインデックス | 想定質問 |
|---|---|---|
| Global Search | community reports (map-reduce) | データセット全体の理解 |
| Local Search | knowledge-graph + text chunks | 特定エンティティの詳細 |
| DRIFT Search | Local + community 情報 | Local を広い事実まで拡張 |
| Basic Search | text unit chunks (top-k) | 従来ベクトルRAG との比較用 |
つまり 論文の C0-C3 は「グラフ検出の階層」の話、Global/Local/DRIFT/Basic は「実装ドキュメントが後から整理したクエリモード」の話 です。層が違います。ここを混ぜて「Global Search が72-83%勝った」と書くと、論文にない主張を書くことになります。私も口頭で説明するときは、意識してこの2つを別々に呼ぶようにしています。
関連の話として、以前書いた LinkedIn GraphRAG 事例 (arXiv 2404.17723) の28.6%短縮 は、この Microsoft GraphRAG とは別実装・別データセットの本番導入報告です。指標も違います (MRR / BLEU / 解決時間中央値)。「28.6% と 72-83% を並べて比較する」のは意味を持ちません — 測っているものが違うからです。
前提として押さえておくべき「maintenance mode」
もう一つ、実装側で無視できない前提があります。microsoft/graphrag リポジトリの README には次の一文が書かれています。
This project is largely in maintenance mode, and won’t be accepting new PRs or implementing new features.
論文で提案された C0-C3 と 4評価軸の骨格は動きます。ただし、DRIFT Search を含む新しい機能を積極的に追加するフェーズは終わっています。バグ修正と依存更新のみ、というスタンスです。
論文の勝率数字を根拠に「Microsoft GraphRAG を本番に載せる」判断をするなら、この maintenance mode 前提を織り込んでおく必要があります。私自身は、企業導入の壁は別記事の GraphRAG企業導入で詰まる3つの壁 でNTT東日本の4ステップと重ねて整理しました。この論文の数字は、そこで書いた「壁」の前提知識にあたります。
まとめ — 4つの数字を1つに丸めない
- 論文が報告する勝率は主に4つ: Comprehensiveness / Diversity / Empowerment / Directness
- 勝ったのは Comprehensiveness と Diversity だけ。Empowerment は混合的結果、対照軸 Directness は SS 側が勝つ
- Comprehensiveness 72-83% / Diversity 62-82% は、C0-C3 の4段階それぞれの勝率レンジ
- Podcast (~1M tokens) と News (~1.7M tokens) の2データセットに閉じた話。この規模を暗黙に広げない
- 論文の C0-C3 (グラフ階層) と、公式ドキュメントの Global/Local/DRIFT/Basic Search (クエリモード) は別レイヤー
- リポジトリは maintenance mode。数字を根拠に本番採用するときの前提として組み込む
GraphRAG の設計判断 (RDF か Property Graph か、KGを7ステップで組むかどうか) を体系的に整理したい方には、私が書いた ナレッジグラフ活用大全 が近い話をしています。第5章がまさに GraphRAG の仕組み、第6章が企業導入で、この論文の C0-C3 と対応する構造がそのまま解説されています。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?