ナレッジグラフは要るのか 実測と構築の6章
ナレッジグラフの記事は「LLMは関係を辿れないからグラフが要る」で始まるものが多いのですが、では何段目から辿れなくなるのか、グラフを渡せば辿れるようになるのかは、あまり測られていません。このシリーズの前半3章はそこを測り、要るかどうかを問いの段数とモデルの容量から決めます。後半3章は作る側です。何をグラフにするかを4つの型で比べ、ノード1,050のグラフを組んで関係が一意に決まらない3つの場所をさばき、Neo4jに載せて段数を書かずに辿ります。手元で動かした範囲と、一次資料から評価しただけの範囲は、各章で列を分けて示します。
読み終えるとできること
- 本番のクエリの段数と使うモデルから、ベクトル検索のままにするか、グラフから1段渡すか、グラフを足さないでおくかを選べます
- グラフを足すと逆効果になる条件を先に知って設計に入れます。4bでは完全一致率が12.7%から1.4%に落ち、35bも思考を有効にすると下がりました
- 構造化データ・コード・文書・個人メモの4つから、何をグラフにするかを更新の自動化と腐りやすさで選べます。最初の1つは答え合わせのできる構造化データです
- 循環・分岐・葉の定義という、関係が一意に決まらない3つの場所を、消さずに印を付けてさばけます
- ヒープ512MBのNeo4jにグラフを載せ、段数を書かないクエリで原材料と影響範囲を辿れます
シリーズ目次全 7 章
- 0 ナレッジグラフは要るのか 実測と構築の6章 Pillar (現在のページ)
- 1 ナレッジグラフとは: 表とベクトルとの3つの違い ナレッジグラフは、ものと関係を機械が辿れる形にしたものです。マインクラフトのクラフトを例に、同じ問いを表・ベクトル検索・グラフに投げて違いを3つに絞ります。
- 2 なぜ今ナレッジグラフ 2024〜25年の3つの変化 ナレッジグラフは2012年からある道具です。変わったのはLLM側でした。2024〜25年の3つの変化を一次資料で追い、出回っている出所の辿れない数字も見分けます。
- 3 ナレッジグラフが効く段数をマインクラフトで実測 ナレッジグラフは何段目から効くのか。マインクラフトのクラフトツリーを正解にして5サイズのモデルに1,010回聞きました。効いたのは9bと35bで、4bは渡すと逆に落ちました。
- 4 ナレッジグラフ4つの型を6軸で比較する 作ると決めたら次は何をグラフにするかです。構造化データ・コード・文書・個人メモの4つを6軸で比べます。実測済みと未検証は列で分けています。
- 5 ナレッジグラフ1050ノードを作って踏んだ3つの罠 ノード1,050・エッジ2,261のグラフを組みました。詰まったのは全部「関係が一意に決まらない場所」で、3種類ありました。1つは実験を丸ごと捨てさせました。
- 6 ナレッジグラフをNeo4jに載せて4つ問う ノード1,050・エッジ2,261をNeo4jに投入して、段数を書かずに辿るクエリを4本書きました。ヒープ512MBで足ります。表では書けない問いだけを並べます。
ナレッジグラフの記事は、たいてい「LLM は関係を辿れないからグラフが要る」で始まります。では関係を何段 (ホップ。関係を1本辿ると1段) 辿ったところで崩れるのか。グラフを渡せば、辿れるようになるのか。そこを測った例は、あまり見当たりません。
要るかどうかは問いの段数で決まり、効くかどうかは使うモデルの容量と設定で決まります。
最初にやるのは、本番のクエリログを読んで段数を数えることです。問いが1段で閉じるならベクトル検索のまま、2段が混ざっていて 9b 以上のモデルを思考を切って使うならグラフから直下の関係を1段渡す、4b 級のモデルにはグラフを足さない、というのが測れた範囲の判定です。3段以上が主なら辿る処理をモデルに任せずグラフの側で終わらせますが、その形で渡したときの結果は測っていません。
思考 (thinking) を切った qwen3.5:9b にグラフから直下の関係を1段ぶん渡すと、完全一致率 (挙げた材料の集合が正解と一致した割合) は2段の問題で 70%、3段で 37% でした。渡して上がったのは 9b と 35b で、4b は渡すと2段以上の完全一致率が 12.7% から 1.4% に落ちました。渡された中間の名前を答えから落とせず、正しい材料と混ぜて返すためです。35b も思考を有効にすると、渡したほうが下がります。
作ると決めたら、グラフにするのは多くの場合、構造化データかコードです。構造化データは元データの参照をそのままエッジに読み替えるだけで、コードは構文解析器が構造を返すので、どちらも抽出に LLM が要らず、元データの差分から機械的に組み直せます。最初の1つは、組めたかどうかを機械で検算できる構造化データで作るのを勧めます。
組む作業で詰まったのは、ノードとエッジを決めるところではありませんでした。関係が一意に決まらない場所です。循環、分岐、どこで辿るのをやめるか、の3種類があり、曖昧なものは消さずに印を付けて残します。消すと「無い」と「分からない」が同じ表示になるからです。
載せる先の Neo4j はヒープ 512MB で足りました。書けるようになるのは段数を書かずに行き止まりまで辿るクエリで、表で同じことをするには JOIN の回数を先に決める必要があるので、差はそこに出ます。載せたグラフをどう更新し続けるかは、まだ測っていません。
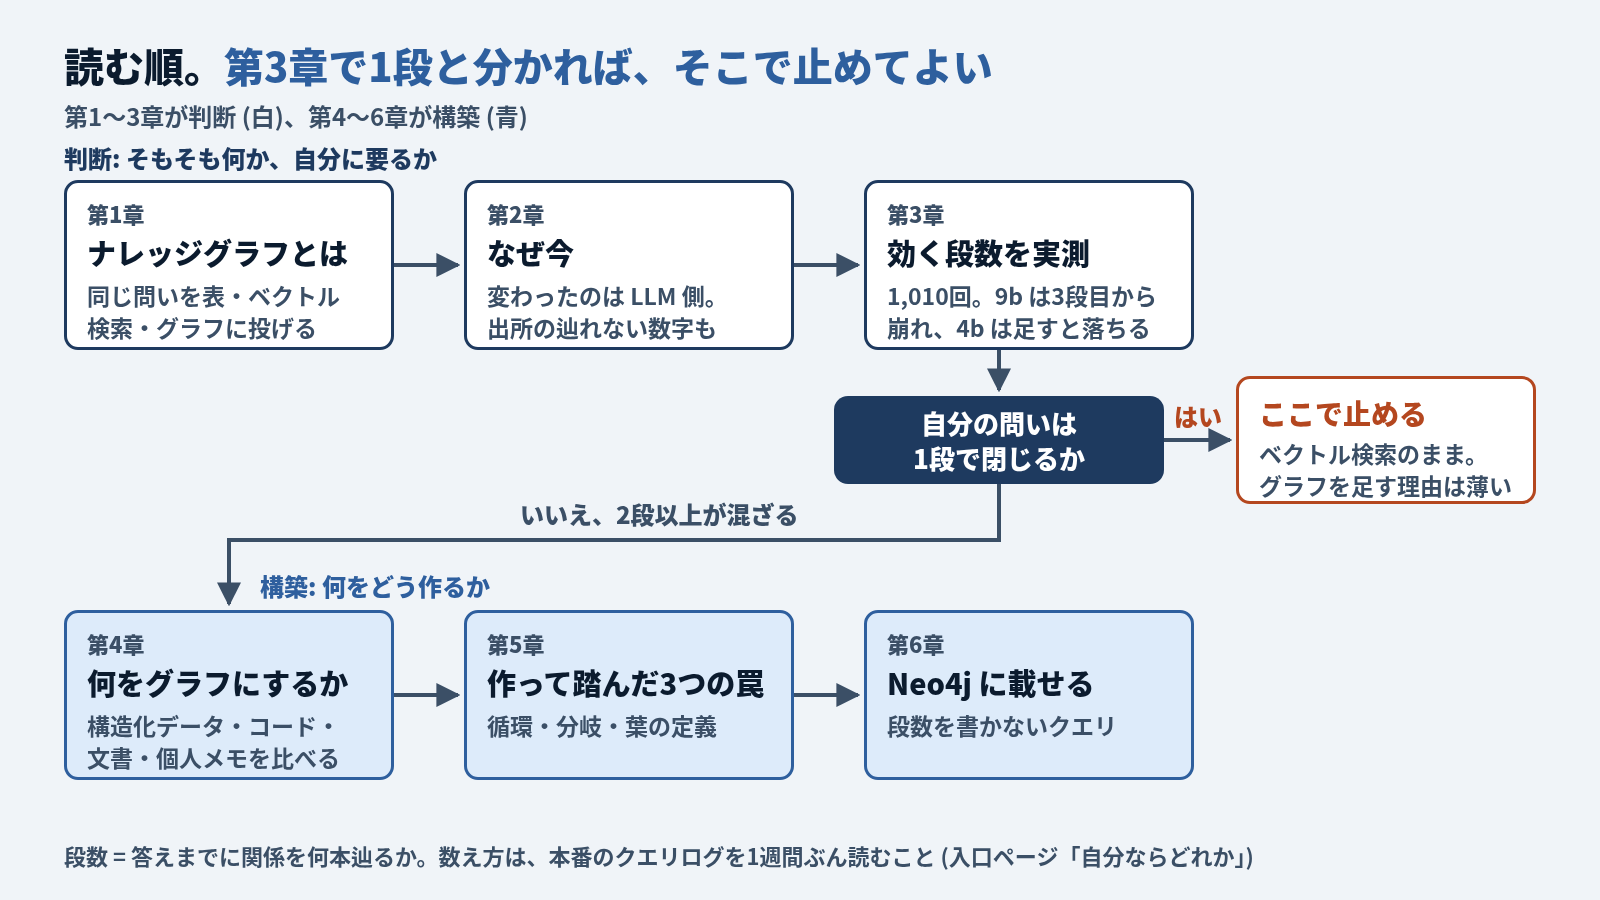
第1〜3章が判断、第4〜6章が構築です。第3章まで読んで、自分の問いが1段で閉じていると分かったなら、そこで止めて構いません。
揃える課題
判断の側では5つのモデルに同じ仕事をさせます。題材はマインクラフト (Minecraft) のクラフトレシピで、材料の関係がゲーム自身から機械可読な形で配られているので、そのまま有向グラフになり、正解を人が書かずに済みます。聞くのは1種類だけで、「この道具を1個作るのに最終的に必要な材料を、全部挙げてください」。採掘・精錬・収穫・取引・モブドロップで手に入るものが止まる場所で、これを葉 (それ以上辿れない原材料) と呼びます。
| 項目 | 条件 |
|---|---|
| グラフ | ノード 1,050・エッジ 2,261。ノードはアイテム、エッジは「材料である」の1種類ずつ |
| 正解データ | クラフトできる 887 件から、分岐・自己複製・葉が実は作れるものの 515 件を外した 372 件。人手のアノテーションは挟まない |
| 問題 | 372 件から 101 問。1段 30・2段 30・3段 30・4段 9・5段 2 |
| モデル | qwen3.5 の 0.8b / 2b / 4b / 9b / 35b-a3b |
| 条件 | bare は何も渡さない。graph は直下の材料だけを渡し、葉までの答えは渡さない |
| 回数 | 101問 × 2条件 × 5モデル = 1,010回。温度0、思考は切る、パース失敗0件 |
| 採点 | 材料の種類の集合が、正解と完全に一致したか |
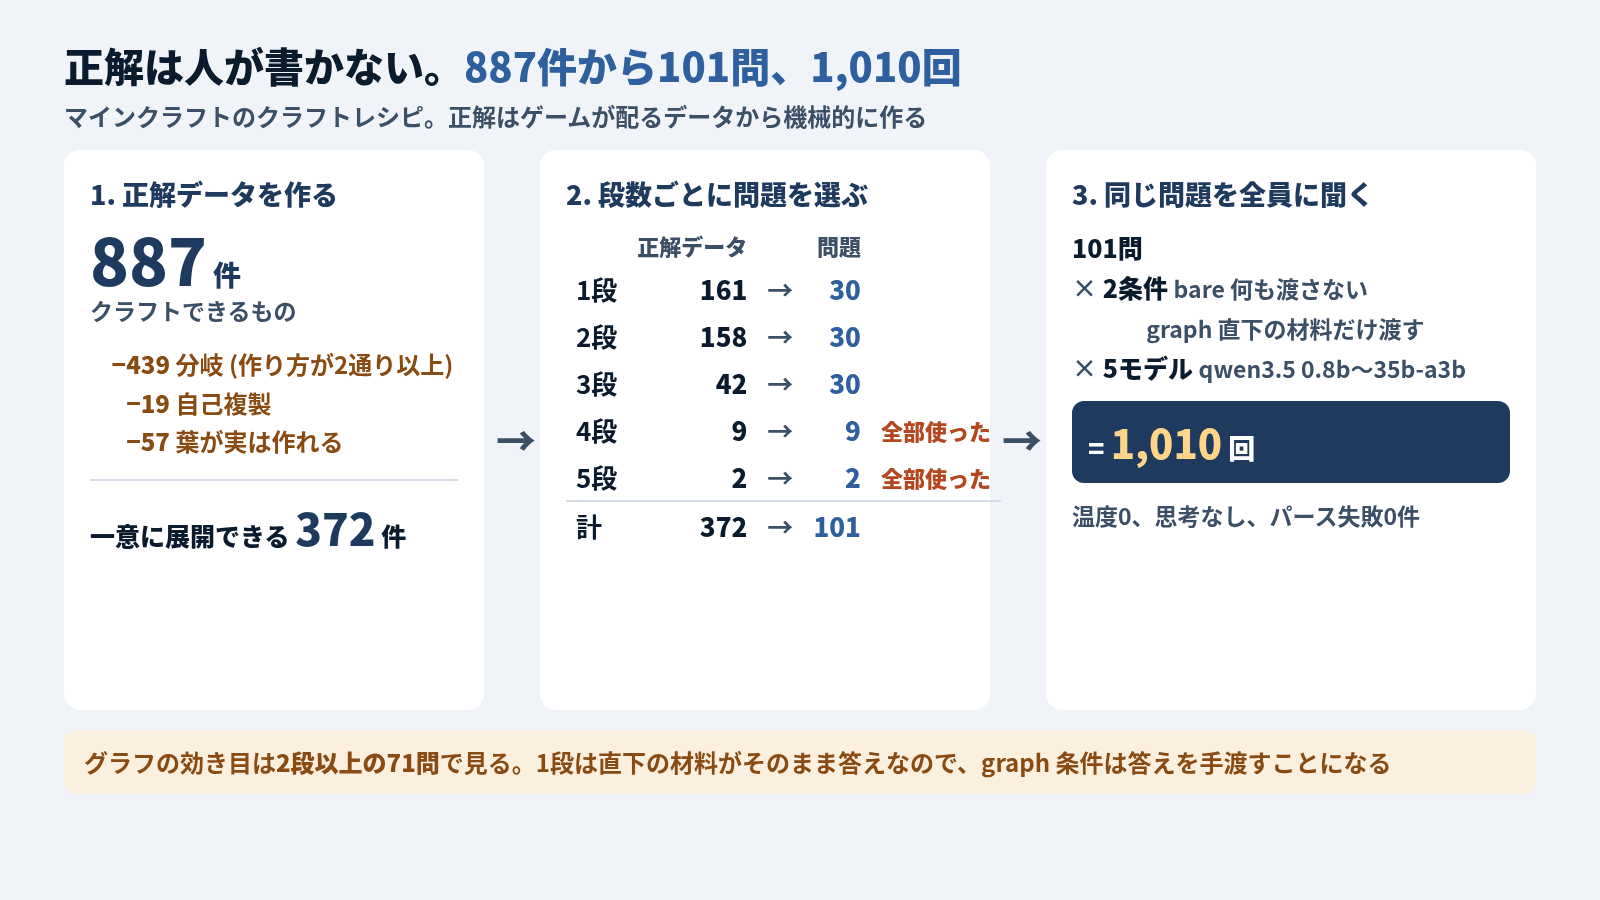
1段の問題では、直下の材料がそのまま答えです。graph 条件は答えを手渡すことになり、測れるのは知識より写せるかどうかになるので、グラフの効き目は2段以上の71問で見ます。
構築の側では、この同じグラフを第5章で組み、第6章で Neo4j に載せます。第4章で4つの型を比べるときは、似た文書を上位から返すだけでは答えにならない「A と B はどう繋がっているか」という同じ問いを、どの型にも投げます。
選択肢は、渡し方3つと作る型4つ
| 選択肢 | やること | 章 | |
|---|---|---|---|
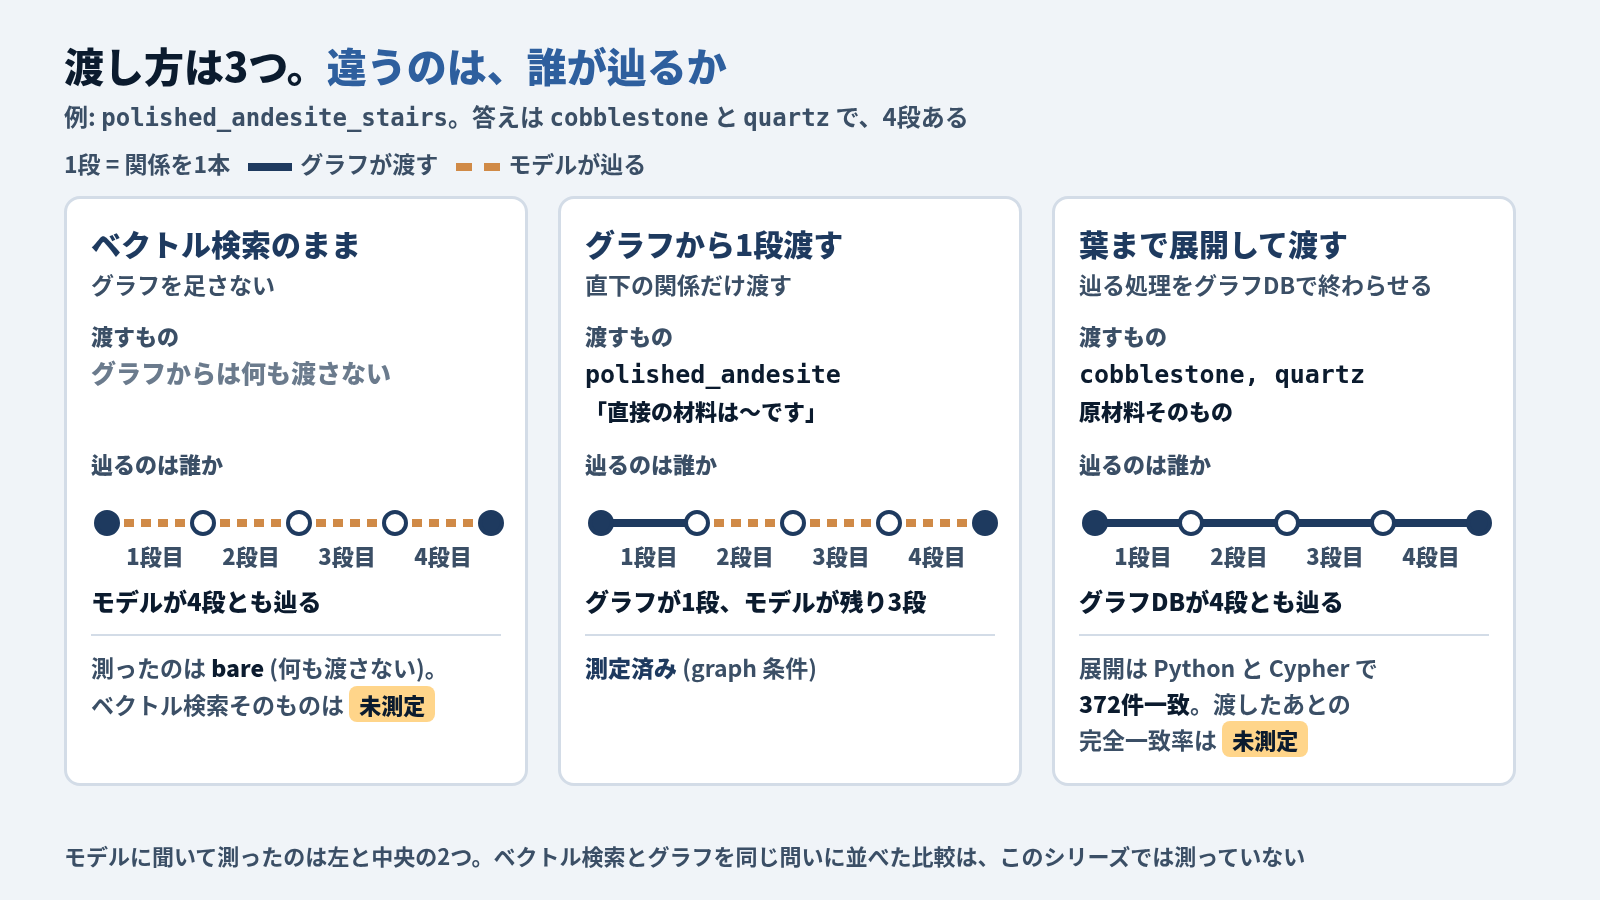
| 渡し方 | ベクトル検索のまま | グラフを足さない | 3 |
| グラフから1段渡す | 直下の関係だけ渡し、その先はモデルに辿らせる (graph 条件) | 3 | |
| グラフ側で葉まで展開して渡す | 辿る処理をグラフ DB で終わらせ、原材料まで出してから渡す | 3・5・6 | |
| 作る型 | 構造化データ | 元データのレコードと参照を、そのままノードとエッジに読み替える | 4・5・6 |
| コード | 構文解析で関数・ファイルと、呼び出し・依存を取る | 4 | |
| 文書 | wiki や議事録から、LLM で人・システム・決定を取り出して繋ぐ | 4 | |
| 個人 | 自分のメモや読書ノートを繋ぐ | 4 |
渡し方のうち、モデルに聞いて測ったのは上の2つです。3つ目の「葉まで展開」は、展開そのものが Python と Cypher の2実装で372件一致することまでは確かめました。渡したあとの完全一致率は未測定です。
マトリクス
| 軸 | 構造化データ | コード | 文書 | 個人 |
|---|---|---|---|---|
| 構築コスト | 最低 | 中 | 高 | 低 |
| 更新の自動化 | できる | できる | 難しい | 手動 |
| 腐りやすさ | 最低 | 低 | 中 | 高 |
| 多段の効き | 大 | 大 | 最大 | 中 |
| 説明可能性 | 大 | 大 | 最大 | 小 |
| 必要な道具 | グラフDB だけ | 構文解析器 + グラフDB | グラフDB + LLM | メモアプリ |
| 検証状態 | 実測済み | 実測済み | 未検証 | 未検証 |
左の2列は、作りやすく腐りにくい側です。文書は効いたときの効果が一番大きい代わりに取り込みに LLM のコストが乗り、どの文書が変わったかを検知する仕組みも別に要ります。個人は始めるのが一番軽い型です。そして参照しなくなった瞬間に更新が止まります。
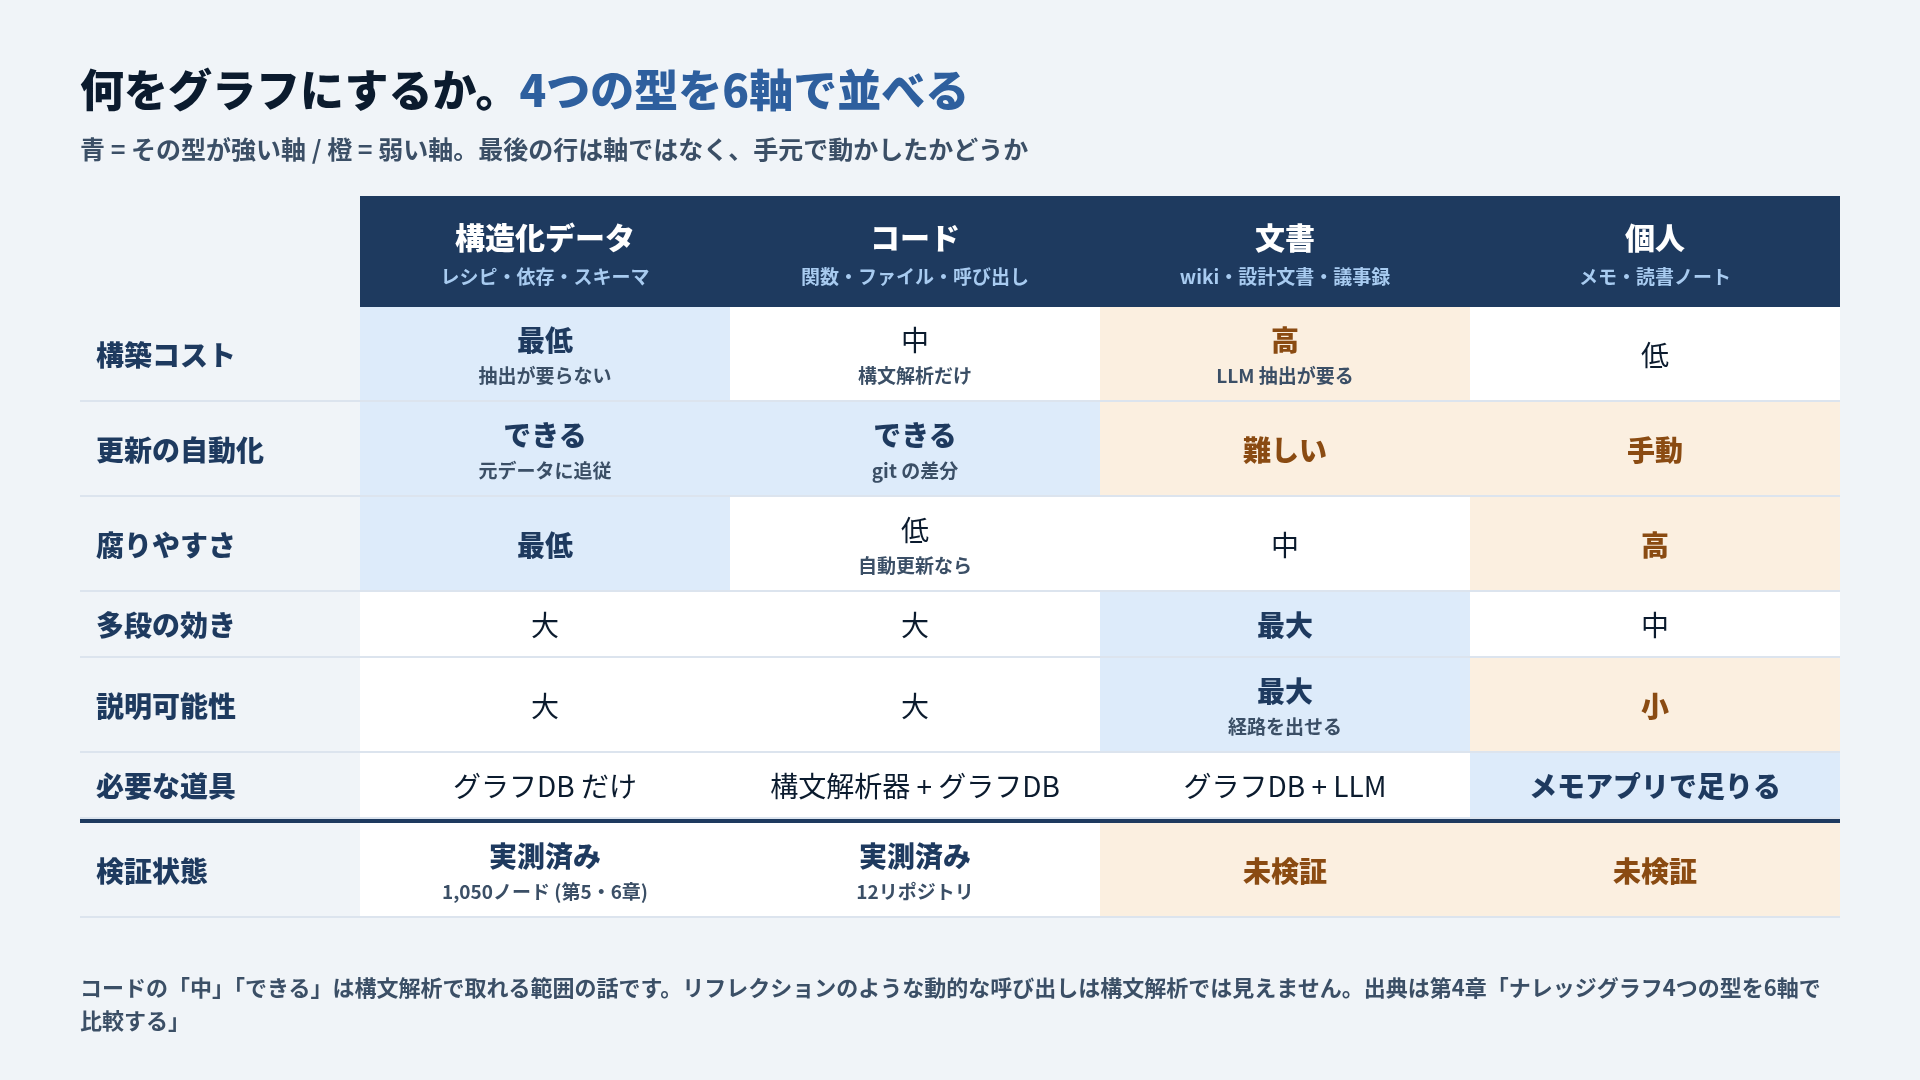
コードの「中」と「できる」は、構文解析で取れる範囲に限った話です。リフレクションのような動的な呼び出しは構文解析では見えず、Android の静的解析ツールが実行時に呼ばれたメソッドの平均61%を取りこぼしていたという報告があります (別の記事「静的解析コードKGが落とす61%の動的呼び出し」)。
表の軸と、判断の2軸
表の行に並べた6つが何をグラフにするかの物差しで、前半の判断ではその手前にもう2つ、問いの段数とモデルの容量を使います。
| 軸 | 何を見るか | 数字の出どころ |
|---|---|---|
| 問いの段数 | 答えまでに関係を何段辿るか | 第3章。1〜5段の101問 |
| モデルの容量と設定 | 渡された中間の名前を、答えから切り離せるか。思考の有無 | 第3章。5サイズ、35b だけ思考ありも |
| 構築コスト | 最初にグラフを作るまでの手間。LLM による抽出が要るか | 第4章。コードは12リポジトリのシンボル 1,931 を構文解析だけで取得 |
| 更新の自動化 | 元データの差分から、機械的に組み直せるか | 第4章 |
| 腐りやすさ | 更新が止まったとき、どれだけ早く実態からずれるか | 第4章。ずれる速さは第6章で未測定と明記 |
| 多段の効き | 2段以上を辿る問いがどれだけあるか | 第3章の実測と第4章 |
| 説明可能性 | 答えの理由を経路として示せるか | 第4章 |
| 必要な道具 | 着手に何が要るか | 第4章。Neo4j の大きさは第6章 (ヒープ 512MB) |
一番効くのは更新の自動化です。作るのは一度きりで、更新は永久に続きます。更新が止まったグラフは間違った答えを自信を持って返すようになるので、空のグラフより古いグラフのほうが危険だと私は見ていますが、ずれる速さは測っていません。
自分ならどれか
最初の一手は、本番のクエリログを1週間ぶん読んで、関係を2段以上辿らないと答えられない質問がどれだけ混ざっているかを数えることです。
1段で閉じる     この API のタイムアウト値は
2段以上が要る   この関数を直すと、どのテストが落ちるのか
                この方針は、どの決定を受けて変わったのか
数える前に構築を始めると、作ったあとで使いどころが無いという形になりがちです。
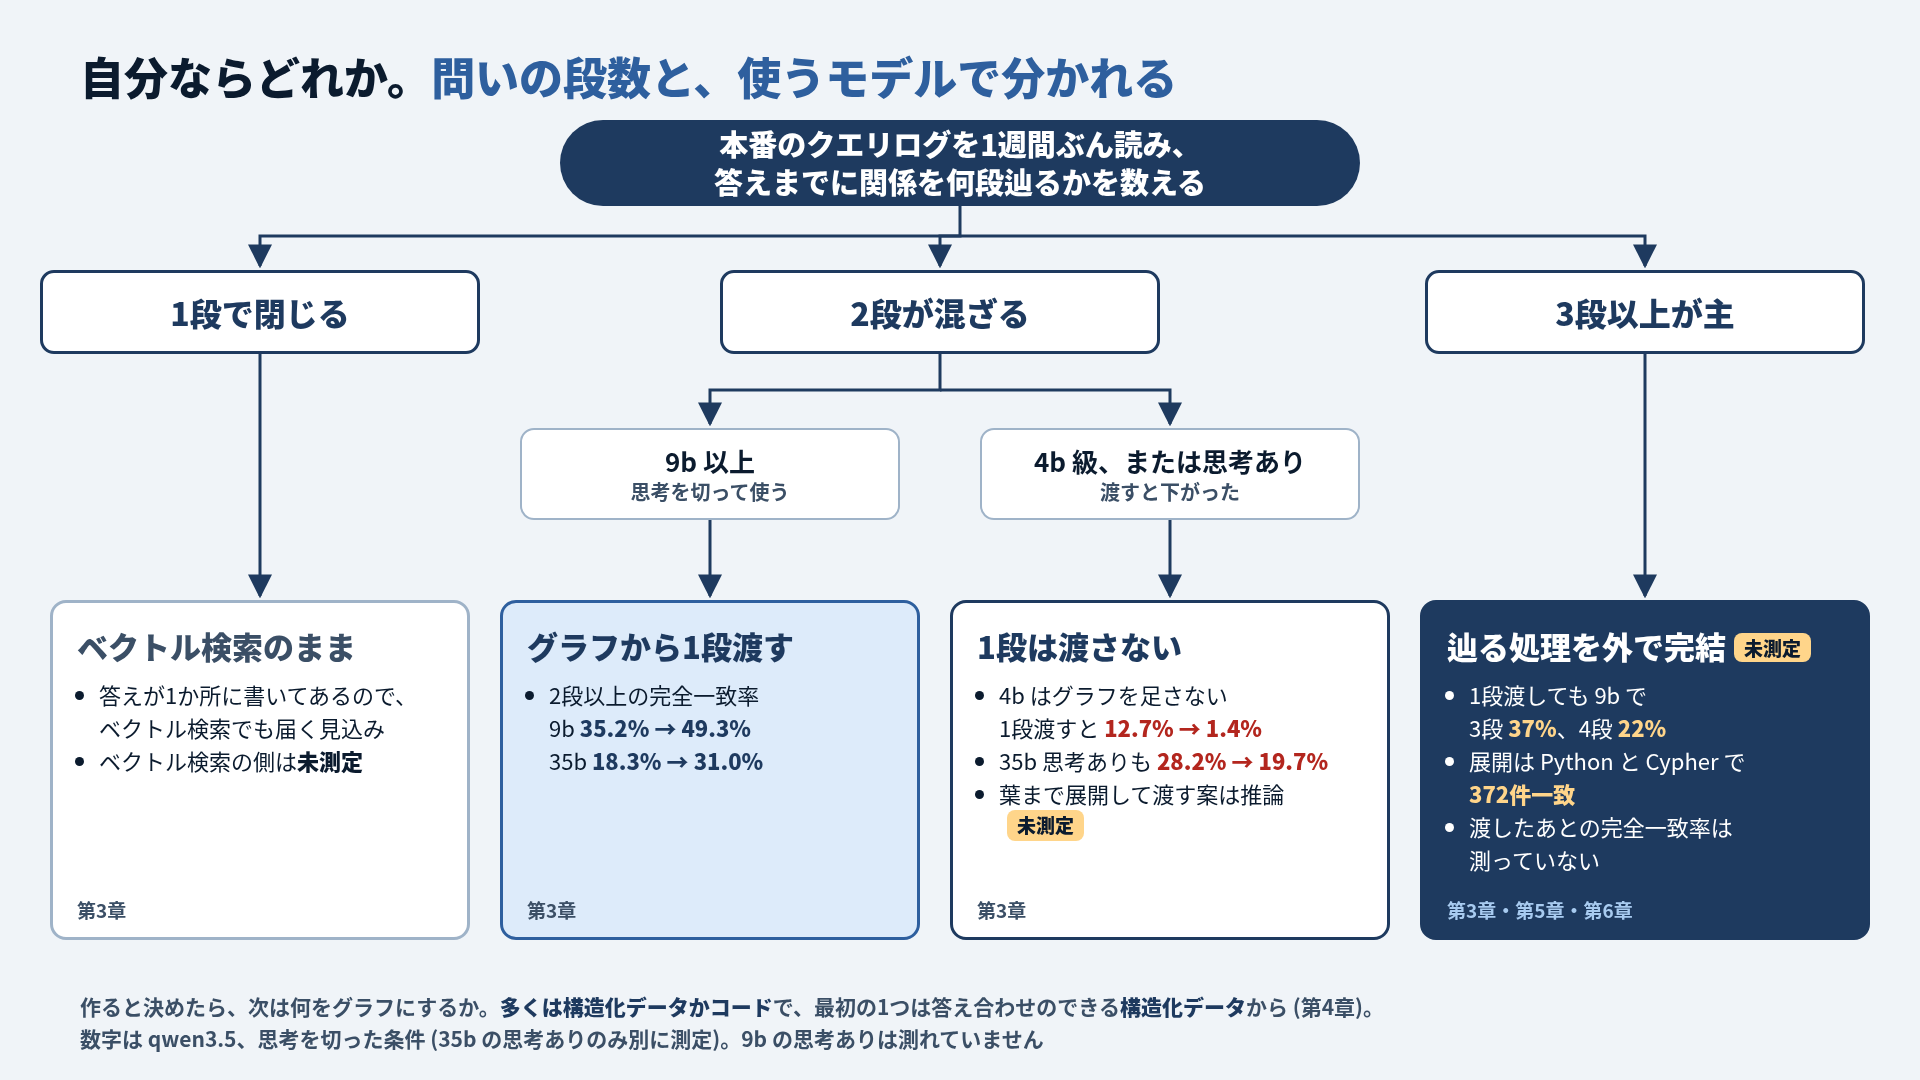
数えたら、段数と使うモデルで手段が分かれます。
| 本番の問い | 使うモデル | 手段 | 効いている数字 (第3章) |
|---|---|---|---|
| 1段で閉じる | どれでも | ベクトル検索のまま | 答えが1か所に書いてあるので、ベクトル検索でも届く見込み (ベクトル検索の側は未測定) |
| 2段が混ざる | 9b 以上、思考を切る | グラフから1段渡す | 2段以上で 9b 35.2% → 49.3%、35b 18.3% → 31.0% |
| 2段が混ざる | 4b 級 | グラフを足さない | 1段渡すと 12.7% → 1.4%。葉まで展開して渡したらどうなるかは未測定 |
| 2段が混ざる | 思考あり | 1段は渡さない (葉まで展開して渡す案は推論で、未測定) | 35b は1段渡すと 28.2% → 19.7% |
| 3段以上が主 | どれでも | 辿る処理を外で完結させる (未測定) | 1段渡しても 9b で3段 37%、4段 22%。3回に2回は間違える |
4b 級と思考ありの2行は、1段渡したら下がったという第3章の結果だけから来ています。葉まで展開してから渡せば、中間の名前が答えに混ざる余地が無くなるので下がらずに済むかもしれませんが、これは私の推論で、測っていません。
3段以上の行は、9b でも3段目から崩れたので、辿る処理をモデルに任せずグラフ DB の側で終わらせるという第3章の結論をそのまま持ってきています。展開そのものは Python と Cypher の2実装で372件一致しましたが、展開した結果をモデルに渡したときの完全一致率は測っていません。
近い数字として、1段の問題では graph 条件が答えを手渡すことになり、それを写せたのは 9b と 35b で 90%、4b で 77% でした。9b の思考ありは測れていません。構造化出力を指定すると空の配列を返し、指定を外すと出力上限を思考に使い切って答えまで届かなかったためです。
作ると決めたら、次は何をグラフにするかです。
| 状況 | 残る候補 | 効いている軸 |
|---|---|---|
| 依存やレシピの影響範囲を出したい | 構造化データ | 構築コスト・更新の自動化 |
| コードレビューの範囲を絞りたい | コード | 更新の自動化 |
| 社内の「これ誰が決めたんだっけ」に答えたい | 文書 | 説明可能性・多段の効き |
| ベクトル検索の精度が頭打ちになった | まず問いの形を見る | 多段の効き |
| メモが増えすぎて繋がりが見えない | 個人 | 必要な道具 |
4行目は、そもそもグラフが要らない可能性があり、問いが1段で閉じているなら、リランカーを足すほうが安上がりなはずです。5行目の個人グラフは着手が軽いぶん、続けられるかどうかの見積もりを先にしてください。参照しない日が2週間続いたら危ないというのが私の目安ですが、測った数字ではありません。
どれを本命にするかとは別に、最初の1つは構造化データで作るのを勧めます。 元データが構造を持っていれば、グラフが正しく組めたかを別の実装で検算できるからです。文書から抽出したグラフでは、正しさを人が読んで判断するしかなくなります。
このシリーズの検証状態
手元で動かした範囲と、一次資料から評価しただけの範囲を分けます。 各章にもその章の分だけを書いた同じ形の囲みがあり、ここではそれを章の順に並べています。2026-09-30 の時点で実測しているのは第3・5・6章と、第4章の構造化データとコードの型です。
| 章 | 何を確かめたか | 検証状態 |
|---|---|---|
| 1 ナレッジグラフとは | Google の 5億オブジェクト・35億の事実は公式ブログの原文、GraphRAG は arXiv の論文本体 | 一次資料 |
| 2 なぜ今 | 3つの変化の日付と数字 (LazyGraphRAG の索引コストは GraphRAG の 0.1% 等) を原典で確認。出所の辿れない数字は、辿れないと明記 | 一次資料 |
| 3 効く段数 | 5モデル × 2条件 × 101問 = 1,010回を手元の GPU で実行。温度0、パース失敗0。35b だけ思考ありも | 実測済み |
| 3 効く段数 | gpt-oss:20b と Anthropic のモデル、9b の思考あり | 未計測 |
| 4 構造化データ | 第5・6章のグラフで確認 | 実測済み |
| 4 コード | 12リポジトリの最新スナップショットで、シンボル 1,931・エッジ 2,417 を構文解析だけで取得 (LLM 抽出は0)。定期実行はしておらず、最後は 2026-08-05 | 実測済み |
| 4 文書 | LLM でテキストから関係を取り出す工程は、手元で動かしていない | 未検証 |
| 4 個人 | 公開されている実装と運用記録からの評価。長期運用は測っていない | 未検証 |
| 5 3つの罠 | 887 件から 439・19・57 件を外して 372 件。足すと元の件数に戻る。Python と Cypher で 372 件すべて一致 (不一致0) | 実測済み |
| 6 Neo4j | Neo4j 5 Community (Docker)、ヒープ 512MB、投入 0.6 秒、4本のクエリ | 実測済み |
| 6 更新 | 更新を止めたグラフが、どのくらいの速さで実態からずれるか | 未測定 |
ベクトル検索とグラフを同じ問いに並べて、どちらが何%正しく答えるかは測っていません。 葉まで展開して渡す形の完全一致率も未測定です。
検証が進んだら、この表のセルを「未検証」から「実測済み」に書き換えます。
読む順
まず、そもそも何なのか、自分に要るのか。
- ナレッジグラフとは: 表とベクトルとの3つの違い — 同じ問いを3つの持ち方に投げる
- なぜ今ナレッジグラフ 2024〜25年の3つの変化 — 変わったのは LLM 側。出所の辿れない数字の見分け方も
- ナレッジグラフが効く段数をマインクラフトで実測 — 1,010回。9b は3段目から崩れ、4b は足すと逆に落ちる
作ると決めたら、何をどう作るか。
- ナレッジグラフ4つの型を6軸で比較する — 構造化データ・コード・文書・個人メモ
- ナレッジグラフ1050ノードを作って踏んだ3つの罠 — 循環・分岐・葉の定義
- ナレッジグラフをNeo4jに載せて4つ問う — 段数を書かないクエリ
周辺として読めるもの。
- AIエージェントが「空気を読めない」本当の理由 — なぜグラフという層が要るのか
- 作る前に、エージェントに見えていない3層を可視化する — Step 1 に入る前に決まること
- RDF か Property Graph か、3つの質問で決める — 形式の分岐
- 静的解析コードKGが落とす61%の動的呼び出し — 構文解析だけでは届かない範囲
- GraphRAG で LinkedIn のサポートが 28.6% 短縮した話 — 外部の公開事例
Minecraft は Mojang Synergies AB の商標です。このページは Mojang Studios および Microsoft とは無関係で、承認も後援も受けていません。クラフトデータは PrismarineJS/minecraft-data から取得しています。
この記事は役に立ちましたか?