AIっぽい表現1位は「適切な」180記事
AIっぽい表現の代表格は「浮き彫りにする」だ、と私は思っていました。180記事で数えたら、1回も出てきませんでした。英語圏の delves が28倍に増えた話の日本語版を、6モデル31語で調べた結果です。
Kobak らの研究は、ChatGPT 登場後の論文で delves の使用頻度が 28倍 に増えたことを報告しました。同じ研究では underscores が13.8倍。showcasing が10.7倍。学術論文という、書き手が最も慎重になる場所で、これだけの差が出ています。
では日本語ではどうか。「日本語版 delve」に相当する表現は何なのか。探した範囲では、誰も数えていませんでした。なので数えました。6モデル × 10テーマ × 3回で180サンプル。あらかじめ決めた31語について、1記事あたりの出現回数を測っています。
結果を先に書くと、私の予想は外れました。
私が一番AIっぽいと思っていた表現は、0回だった
「〜を浮き彫りにする」。
英語の highlight を直訳したような言い回し。日常会話ではまず出てきません。私はこれを日本語AI文体の代表格だと思っていました。180サンプルでの出現回数は 0.00 回です。 1回も出てきませんでした。
代わりに1位だったのは「適切な」で、1記事あたり 0.59回。以下、実測の上位5つはこうなります。
| 順位 | 表現 | 1記事あたり |
|---|---|---|
| 1 | 適切な | 0.59 |
| 2 | 重要です | 0.34 |
| 3 | 本記事では | 0.27 |
| 4 | 〜を活用する | 0.23 |
| 5 | 不可欠 | 0.16 |
どれも派手さがありません。「浮き彫りにする」のような、いかにも翻訳調の表現ではない。当たり障りのない修飾語が上位を占めています。
「適切な」が何と結びつくかを考えると、この語の性質が見えてきます。適切なライブラリ。適切な設計。適切なタイミング。何が適切なのかは、どれも書かれていません。 具体を書かずに文を成立させられる。だから頻度が上がります。「重要です」も同じ役割。段落の締めに使われます。何が重要なのかを説明する代わりに、重要だと宣言して終わる。
AIっぽさの感覚と、AIの実際の癖は別物だった
この実験で一番効いたのは、順位そのものより 自分の感覚が当てにならなかった ことでした。
私が挙げていた10表現のうち、実測で上位に来たのは半分です。「浮き彫りにする」(0.00)、「〜の可能性を秘めている」(0.01)、「〜という観点から」(0.02) は、ほぼ使われていませんでした。逆に、リストに入れていなかった「〜を実現する」は 0.43回。
リストに入れていれば2位に食い込む密度です。
なぜズレるのか。おそらく、目立つ表現ほど記憶に残るからです。「浮き彫りにする」は1回読んだだけで引っかかります。「適切な」は0.59回出ていても、読み流してしまう。
頻度の高い語ほど気づかれない。
これは実務的な問題を生みます。
「AIっぽい文章を直そう」と思ったとき、人は目立つ語から潰しにいきます。ところが実際に密度を上げているのは、目立たない語のほうです。感覚で直すと、頻度の低い語だけが消えて、上位5語がそのまま残ります。
商用モデルほど濃い
モデル別に見ると、はっきりした差が出ました。
| モデル | AI頻出語彙(1記事あたり) |
|---|---|
| Claude Sonnet 4 | 3.43 |
| GPT-4o | 3.33 |
| Qwen 3.5-4B | 2.70 |
| Qwen 3.5-9B | 2.30 |
| Llama 3.2-1B | 1.83 |
| gpt-oss 20B | 0.80 |
Claude Sonnet 4 と GPT-4o が3を超えて並び、オープンソースモデルは低い。パラメータ数が大きいほど濃くなる、という単純な話でもありません(gpt-oss 20B の 0.80 は最少です)。
商用モデルが濃くなる理由は、RLHF にあると考えています。人間のフィードバックによる強化学習では「丁寧で網羅的な文章」が高く評価されます。そして丁寧で網羅的な文章を最短距離で書く方法が、抽象的な修飾語を足すことです。「適切な」を入れておけば、具体を書かずに配慮した雰囲気が出ます。学習データの偏りだけなら、Web 記事を大量に読んだモデルは全部似た傾向になるはずです。商用モデルだけが濃いのは、その後の調整が効いていることを示しています。
同じ 2.70 が、割り方を変えると逆になる
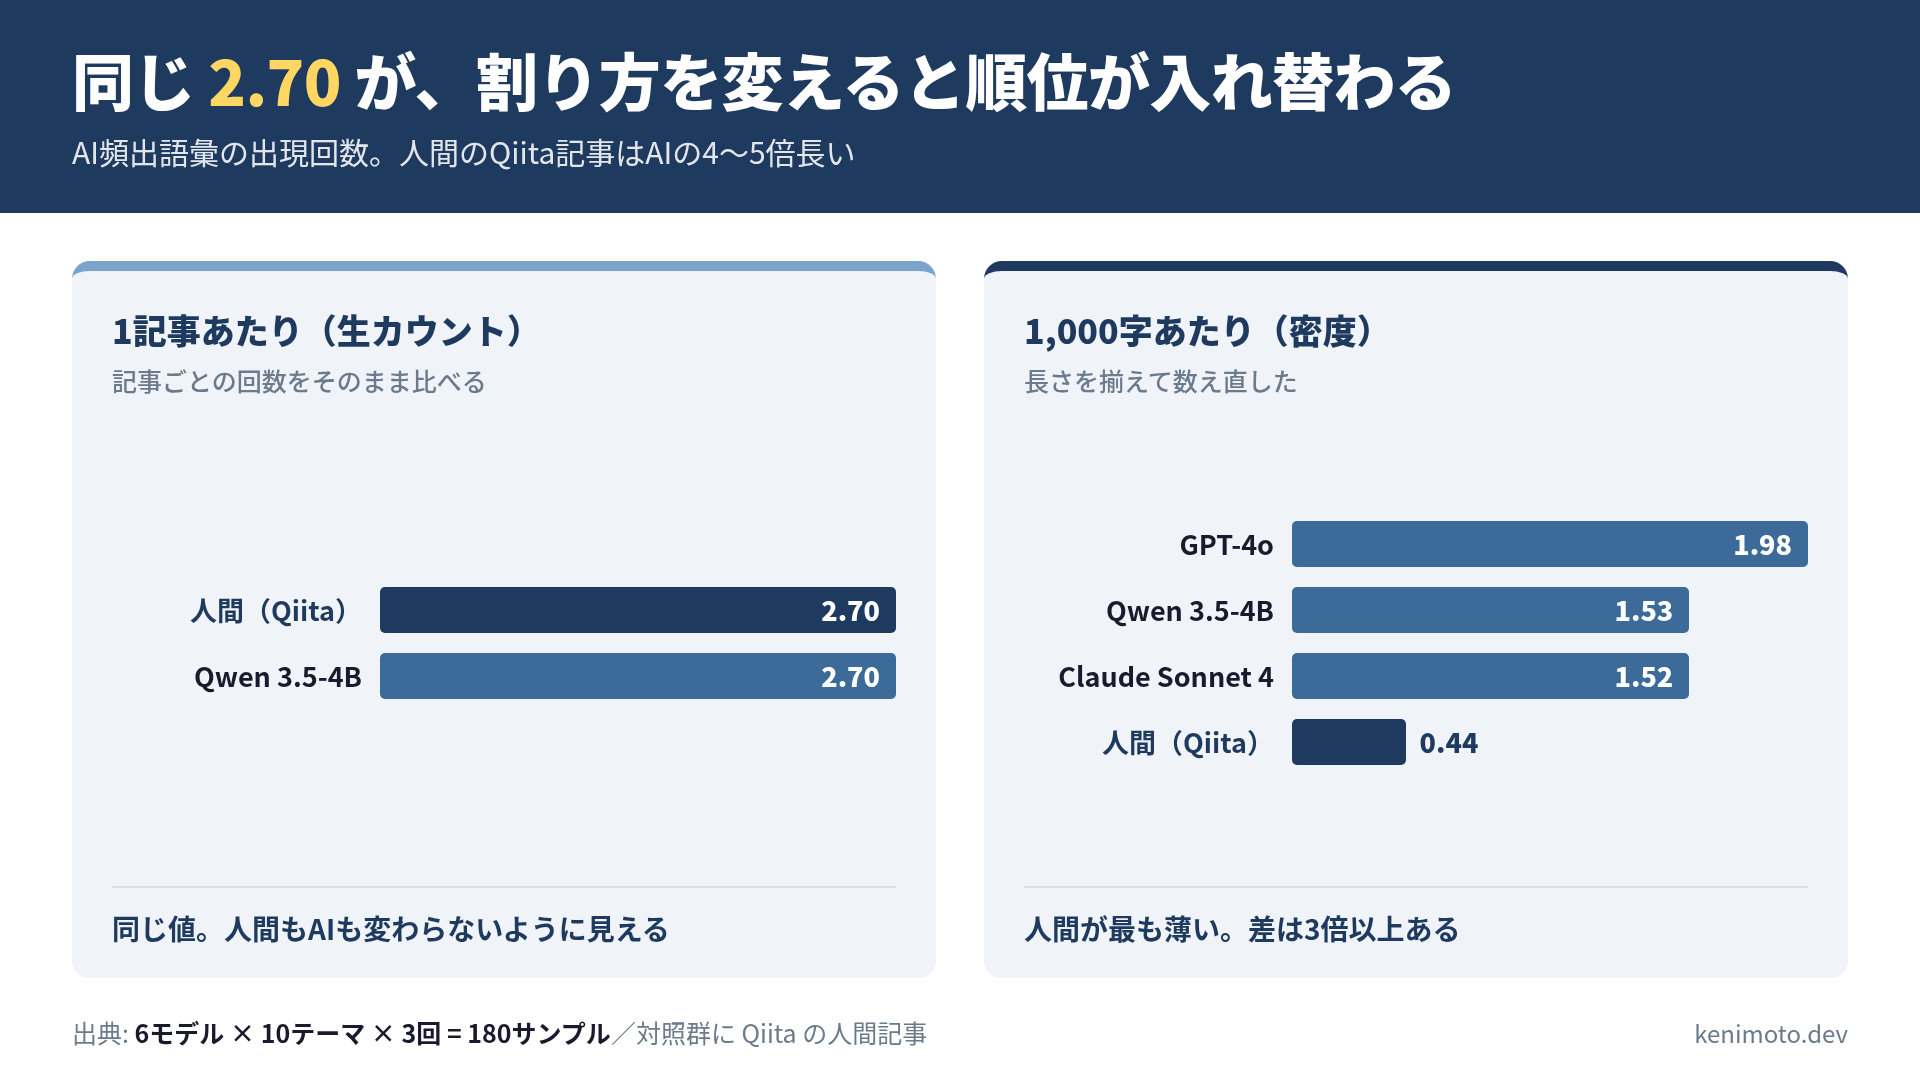
同じ実験で、人間が書いた Qiita 記事も測っていました。スコアは 2.70。Qwen 3.5-4B とまったく同じ値です。
この数字だけを見ると「人間もAIと同じくらいAIっぽい語彙を使っている」と読めます。
私は最初そう読んで、間違えました。
表の数字は1記事あたりの生カウントで、人間の Qiita 記事は AI の4〜5倍長いからです。1,000字あたりに直すと、こうなります。
| 1,000字あたり | |
|---|---|
| GPT-4o | 1.98 |
| Qwen 3.5-4B | 1.53 |
| Claude Sonnet 4 | 1.52 |
| 人間(Qiita) | 0.44 |
人間は7者中で最も薄い。
同じスコアに見えたのは、長さが作った錯覚でした。
1,000字の記事に「さまざまな」が2回出てくる。4,000字の記事には3回出てくる。生カウントで多いのは後者です。密度に直すと前者2.0に対して後者0.75。順位がひっくり返ります。
角砂糖2個のコーヒーカップと、角砂糖3個のバケツを並べて、バケツのほうが甘いと言っていたようなものでした。
密度で見ると、これらの語彙は人間とAIを分ける手がかりとして機能していて、差は3倍以上あります。生カウントのまま比べていたら、この差は見えませんでした。測り方を揃えないまま比較すると、結論が反転します。 これはAI文体に限った話ではありません。長さの違うものを個数で比べるときは、割る前に一度止まったほうがいいです。
直すとどうなるか
上位5語を避けると、文章は自動的に具体的になります。避けようとすると、書くことがなくなるからです。
Before(AIが書いた例)
Reactの状態管理にはさまざまなアプローチがあり、効率的な設計が不可欠です。適切なライブラリを活用することで、パフォーマンスの向上を実現できます。
After(書き直しの方向)
Reactの状態管理で最初に悩むのは「useStateの多重ネストが3階層を超えたとき」です。ここに、選んだライブラリ名、移行前後の re-render 数、移行にかかった工数、Lighthouseスコアの前後——数字と固有名詞と判断の根拠を書けば、埋め草の入る余地はなくなります。
Before の文には「誰が・何を・どうなったか」が1つもありません。抽象的な修飾語は、書くことがないときの埋め草として機能します。 だから頻度が上がるし、だから読者に何も残らない。
置換辞書を作って機械的に潰す方法もありますが、それだけでは足りません。語彙を消しても、構造とリズムには別の癖が残ります。そちらは語彙とリズムのどちらで検出されるのかを7モデルで検証した記事に書きました。判別力で言えば語彙が圧勝(AUC 0.998 対 0.897)でした。リズムには別の役割があります。
実験データと続き
この記事は、6モデル180サンプル・16指標で測った実験の一部です。31語の全リストとモデル別の内訳、置換辞書、そして語彙以外の15指標については『AIくさい文章から脱出する技術』にまとめました。全26章、Kindle Unlimited 対象です。
第5部は初版の訂正にあてています。上に書いた「長さの交絡」もそこで扱った1つで、ほかに2箇所、間違いを撤回の経緯ごと残しました。過去に発表した過剰語彙651語のリストは、統計アーティファクトを除くと生存424語、そのうちAI過剰側は458語中237語まで減っています。
実験コードと全サンプルは GitHub で公開しています。
 関連書籍 AIくさい文章から脱出する技術 AIくささ 消し方 · AIっぽい文章 特徴 · AI判定 誤検知 · 6モデル180サンプルを自分で測った全記録 (Kindle Unlimited 対象) 書籍ページを見る →
この記事は役に立ちましたか?