なぜ今ナレッジグラフ 2024〜25年の3つの変化
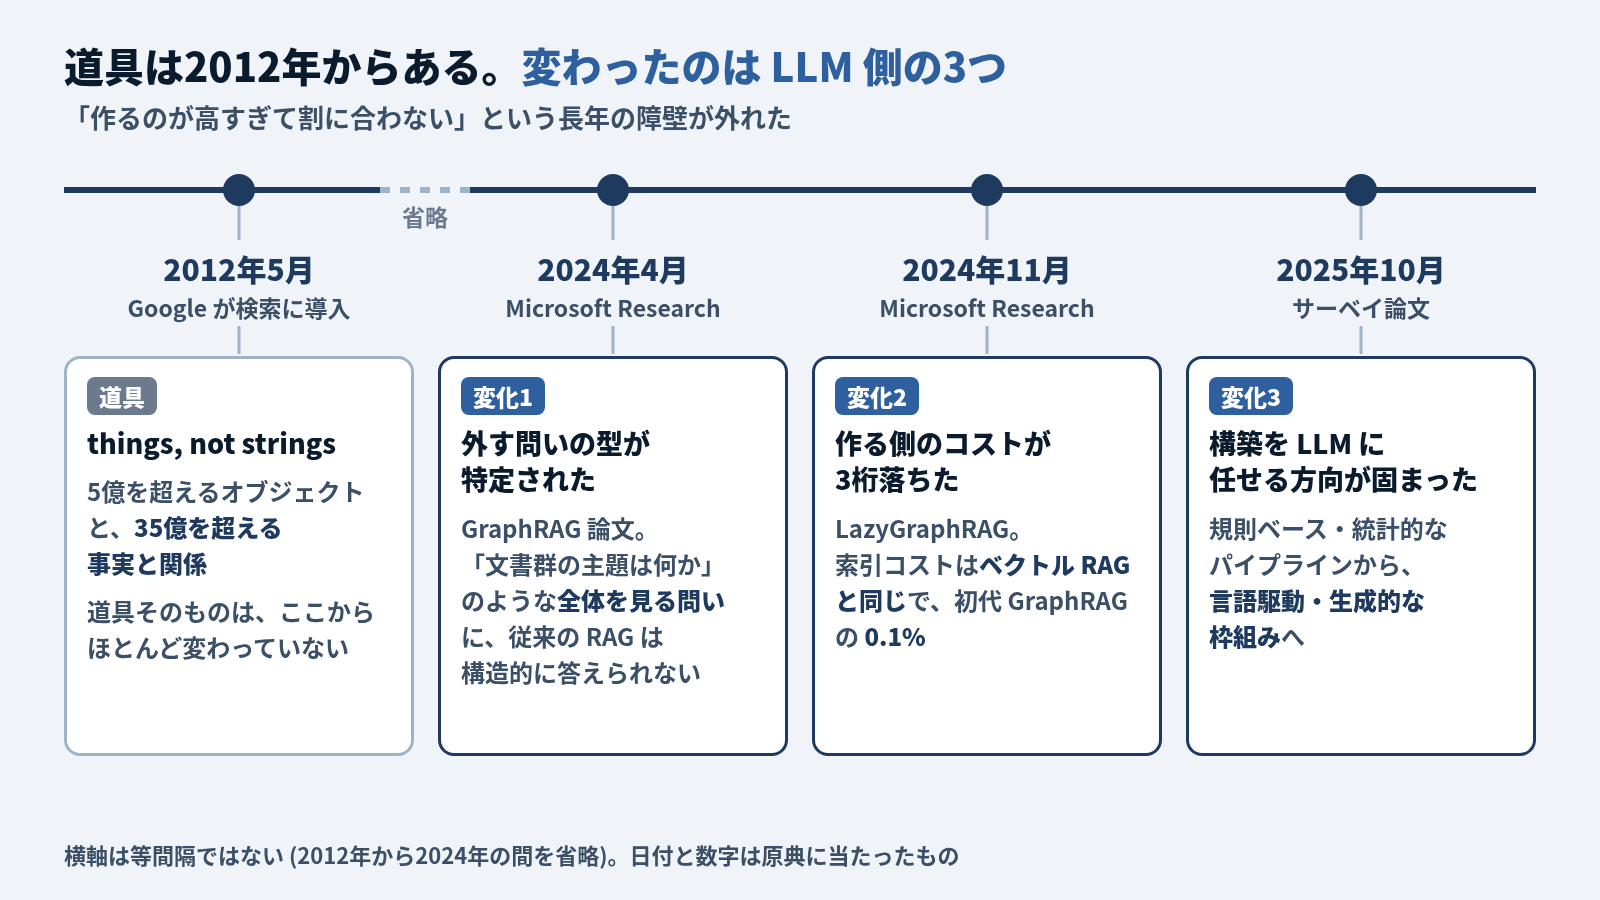
ナレッジグラフという道具は新しくありません。Google が検索に入れたのは2012年です。技術としては、それよりさらに古い系譜を持ちます。
では何が変わったのか。変わったのは LLM 側です。 2024年から2025年にかけて3つ起きました。ベクトル検索が構造的に外す問いの型が特定されたこと。作る側の索引コストが3桁落ちたこと。そして構築そのものを LLM に任せる方向が固まったこと。
「作るのが高すぎて割に合わない」という長年の障壁が外れた、というのが実態に近いです。以下、3つとも原典に当たって確認します。
変化1: 外す問いの型が特定された (2024年4月)
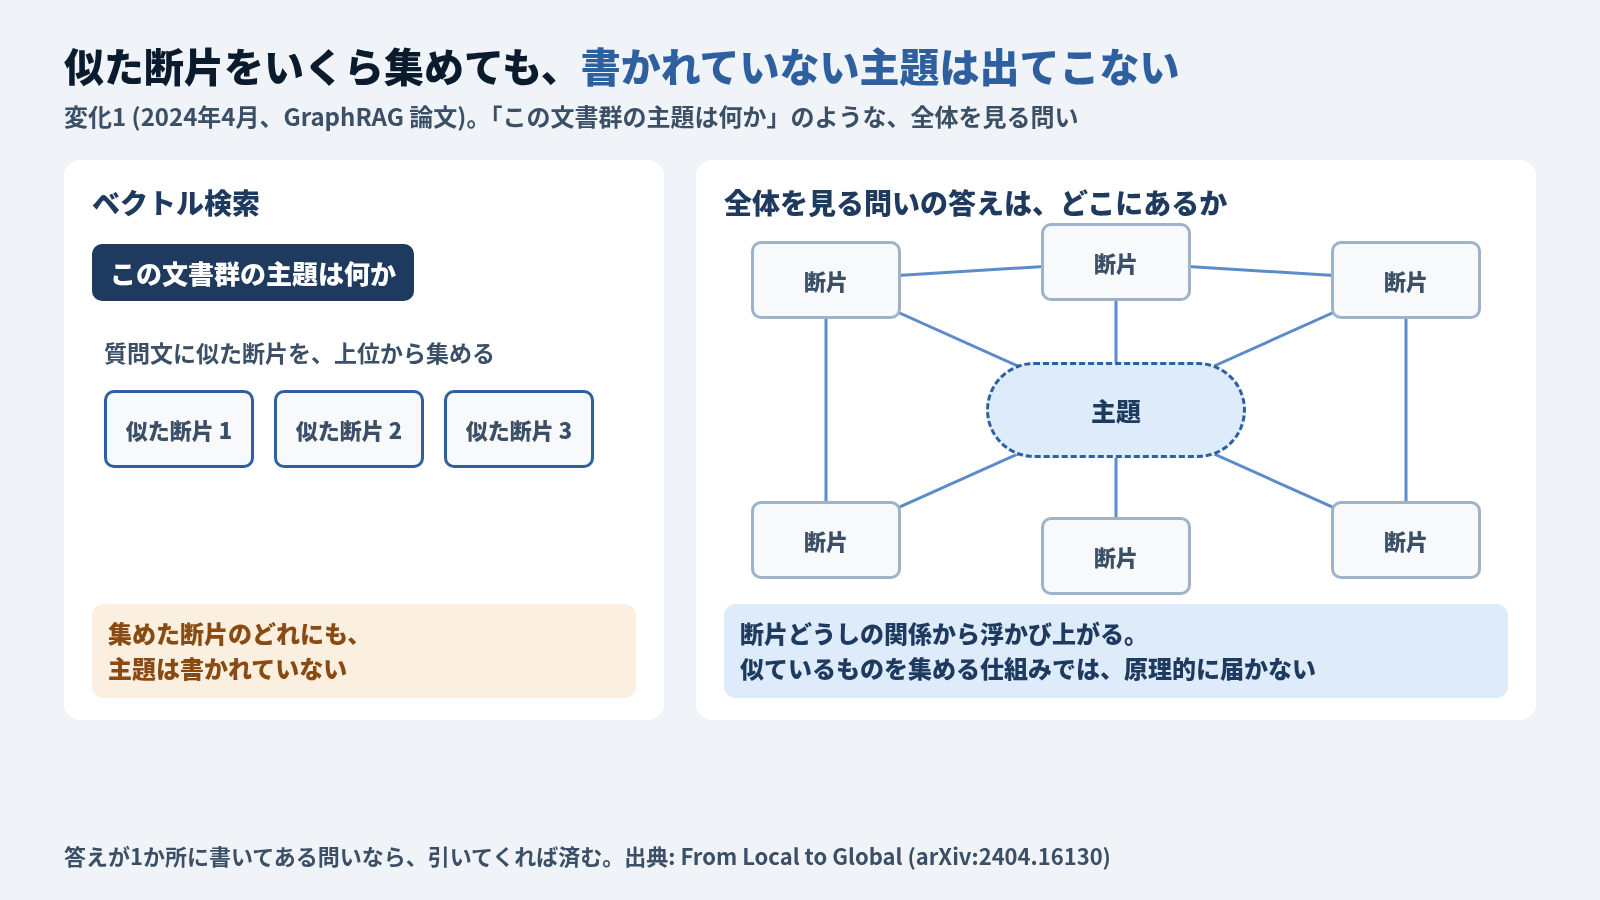
Microsoft Research が2024年4月24日に出した論文が起点です。タイトルは「From Local to Global: A Graph RAG Approach to Query-Focused Summarization」で、扱っているのは従来の RAG が何に失敗するかです (arXiv:2404.16130)。
指摘は明快です。「この文書群の主題は何か」のような、全体を見ないと答えられない問いに、従来の RAG は構造的に答えられません。理由は仕組みを見れば分かります。ベクトル検索は、質問文に似た断片を上位から集めてきます。ところがデータセット全体の主題は、どの断片にも書かれていません。 断片どうしの関係から浮かび上がるものだからです。似ているものをいくら集めても、書かれていないものは出てきません。
「RAG は精度が低い」という話から、この形の問いには原理的に届かないという話へ、型が定まったことが効きました。ぼんやりした不満が、対処できる問題になりました。
変化2: 作る側のコストが3桁落ちた (2024年11月)
同じ Microsoft Research が2024年11月25日に LazyGraphRAG を出しています。ここに具体的な数字があります。
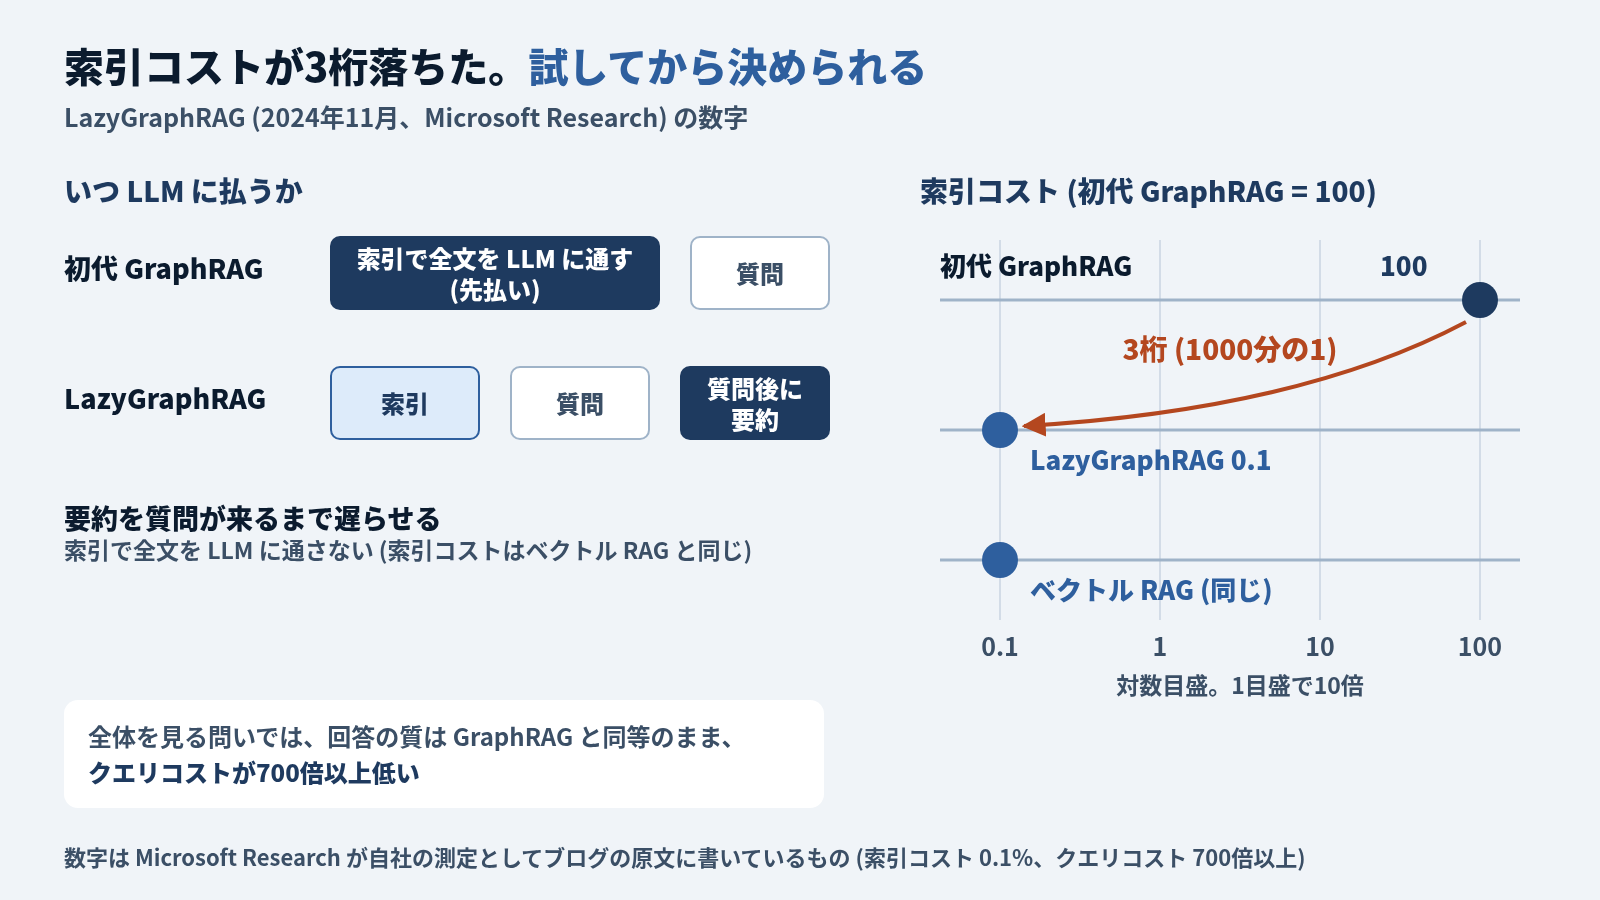
LazyGraphRAG data indexing costs are identical to vector RAG and 0.1% of the costs of full GraphRAG.
全体を見る問いについては、こう書かれています。
comparable answer quality to GraphRAG Global Search for global queries, but more than 700 times lower query cost
初代の GraphRAG は、質問が来る前にコミュニティ要約を作りきる設計でした。索引を作る時点で全文を LLM に通すので、文書が増えるほど先払いが膨らみます。LazyGraphRAG はその要約を質問が来るまで遅らせます。
桁が変われば、判断そのものが変わります。索引コストがベクトル検索と同じなら、試してから決められます。 従来は先に大きく払って、効くかどうかは後で分かるという賭けでした。作る前に投資判断を求められるのと、動かしてから決められるのとでは、話が別です。
変化3: 構築を LLM に任せる方向が固まった (2025年)
最後の障壁が、作る手間そのものでした。ナレッジグラフの構築は長らく、語彙を設計し、抽出規則を書き、人手で直す作業の積み重ねでした。
2025年10月のサーベイ論文は、この領域が「規則ベース・統計的なパイプラインから、言語駆動・生成的な枠組みへ」転換したと表現しています (arXiv:2510.20345)。語彙を先に決める作り方と、決めずに始める作り方の両方が整理され、エージェントの動的な記憶としての使い方まで射程に入っています。
つまり LLM がナレッジグラフを作り、そのナレッジグラフが LLM を助ける、という循環が回り始めたところです。
同時に、出所の辿れない数字も増えている
ここは注意が要ります。この話題を調べると、次のような数字にすぐ当たります。
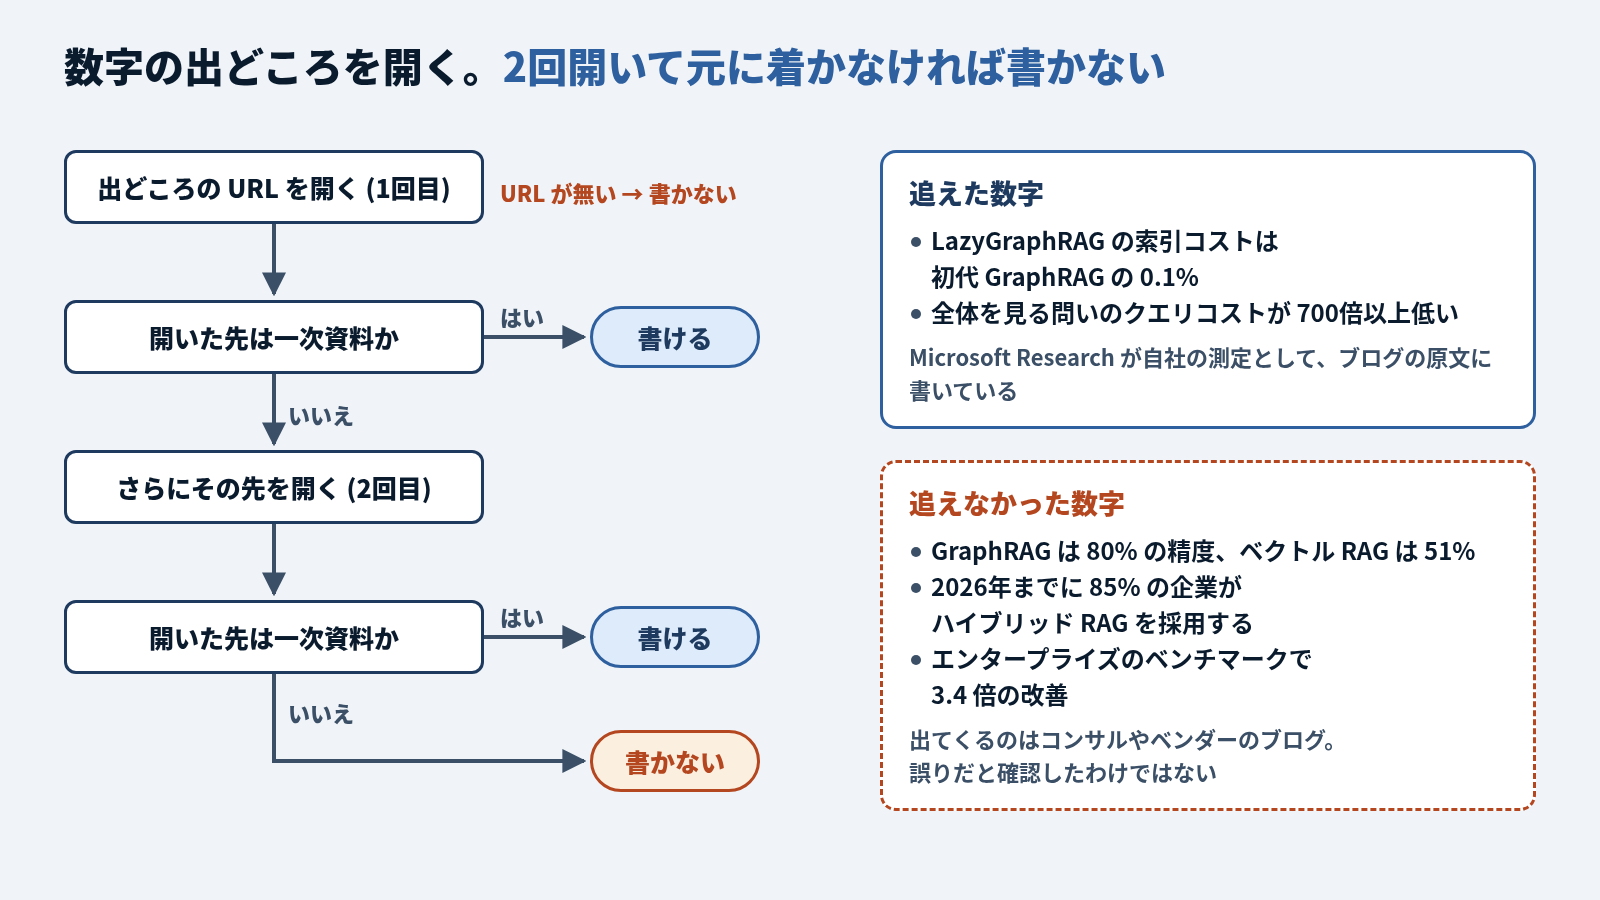
「GraphRAG は 80% の精度、従来のベクトル RAG は 51%」
「2026年までに 85% の企業がハイブリッド RAG を採用する」
「エンタープライズのベンチマークで 3.4 倍の改善」具体的で、覚えやすく、記事に引きやすい数字です。そして私が辿った範囲では、どれも一次資料に届きませんでした。 出てくるのはコンサルティング会社やベンダーのブログで、そこから先の出典が示されていないか、示されていても同じ種類のブログに繋がります。
前の節で引いた数字と比べてみてください。0.1% と 700倍は、Microsoft Research が自社の測定として原文に書いています。追える数字と、追えない数字があります。
見分け方は単純です。その数字の出どころの URL を開けるか。 開いた先が一次資料でなければ、さらにその先を開く。2回開いて元に着かない数字は、記事に書かない。これだけで大半は落ちます。
そして、足せば良くなるわけではない
もうひとつ、注目の説明としてよく使われる論法があります。「LLM は関係を辿れない。だからグラフを足す」。
前半は正しいのですが、後半は条件付きです。このシリーズで実際に測りました。
5サイズのモデルで測ったところ、思考 (thinking) を切った条件でグラフを1歩渡して効いたのは 9b と 35b で、4b では完全一致率が 12.7% から 1.4% に落ちています。小さいモデルにグラフを繋いで安く済ませる構成は、少なくとも測った範囲では成立していません。 条件と数字は段数の実測にあります。
何を見て判断するか
「今すぐ検討すべきか」の入口は手元のクエリにあります。流行の強さは判断材料になりません。本番のクエリログを読んで、関係を2段 (ホップ。関係を1本辿ると1段) 以上辿らないと答えられない質問がどれだけ混ざっているかを数えるのが最初の一手です。手順は入口のページに書いてあります。
数えた結果、2段以上の問いが混ざっていたなら、次に確かめるのは、手元のモデルにグラフを渡して本当に効くかどうかです。何段目から崩れるのか、どの大きさのモデルなら効くのかを、ナレッジグラフが効く段数をマインクラフトで実測で測っています。
この記事は役に立ちましたか?