6 documentos antes do prompt: Claude Code na 5ª
“Faça um login bonito aí” e sai um login bonito que compila: na primeira vez, dá pra se sentir um gênio. O encanto costuma durar até o dia em que você não consegue mais explicar o próprio código. A primeira geração funciona. A segunda correção desvia um pouco. Na terceira começa o espaguete, e na quinta a sensação é de que recomeçar do zero sai mais barato. Essa curva de colapso é familiar pra muita gente, e não é limite do modelo. É falta de estrutura na entrada.
É o problema do que a comunidade chama de Vibe Coding. Você digita “faça um login bonito aí”, recebe algo que compila, pede um ajuste, pede outro, e na terceira iteração o diff começa a brigar com o próprio diff anterior. Na quinta você considera recomeçar do zero.
A solução vem com prompt depois.
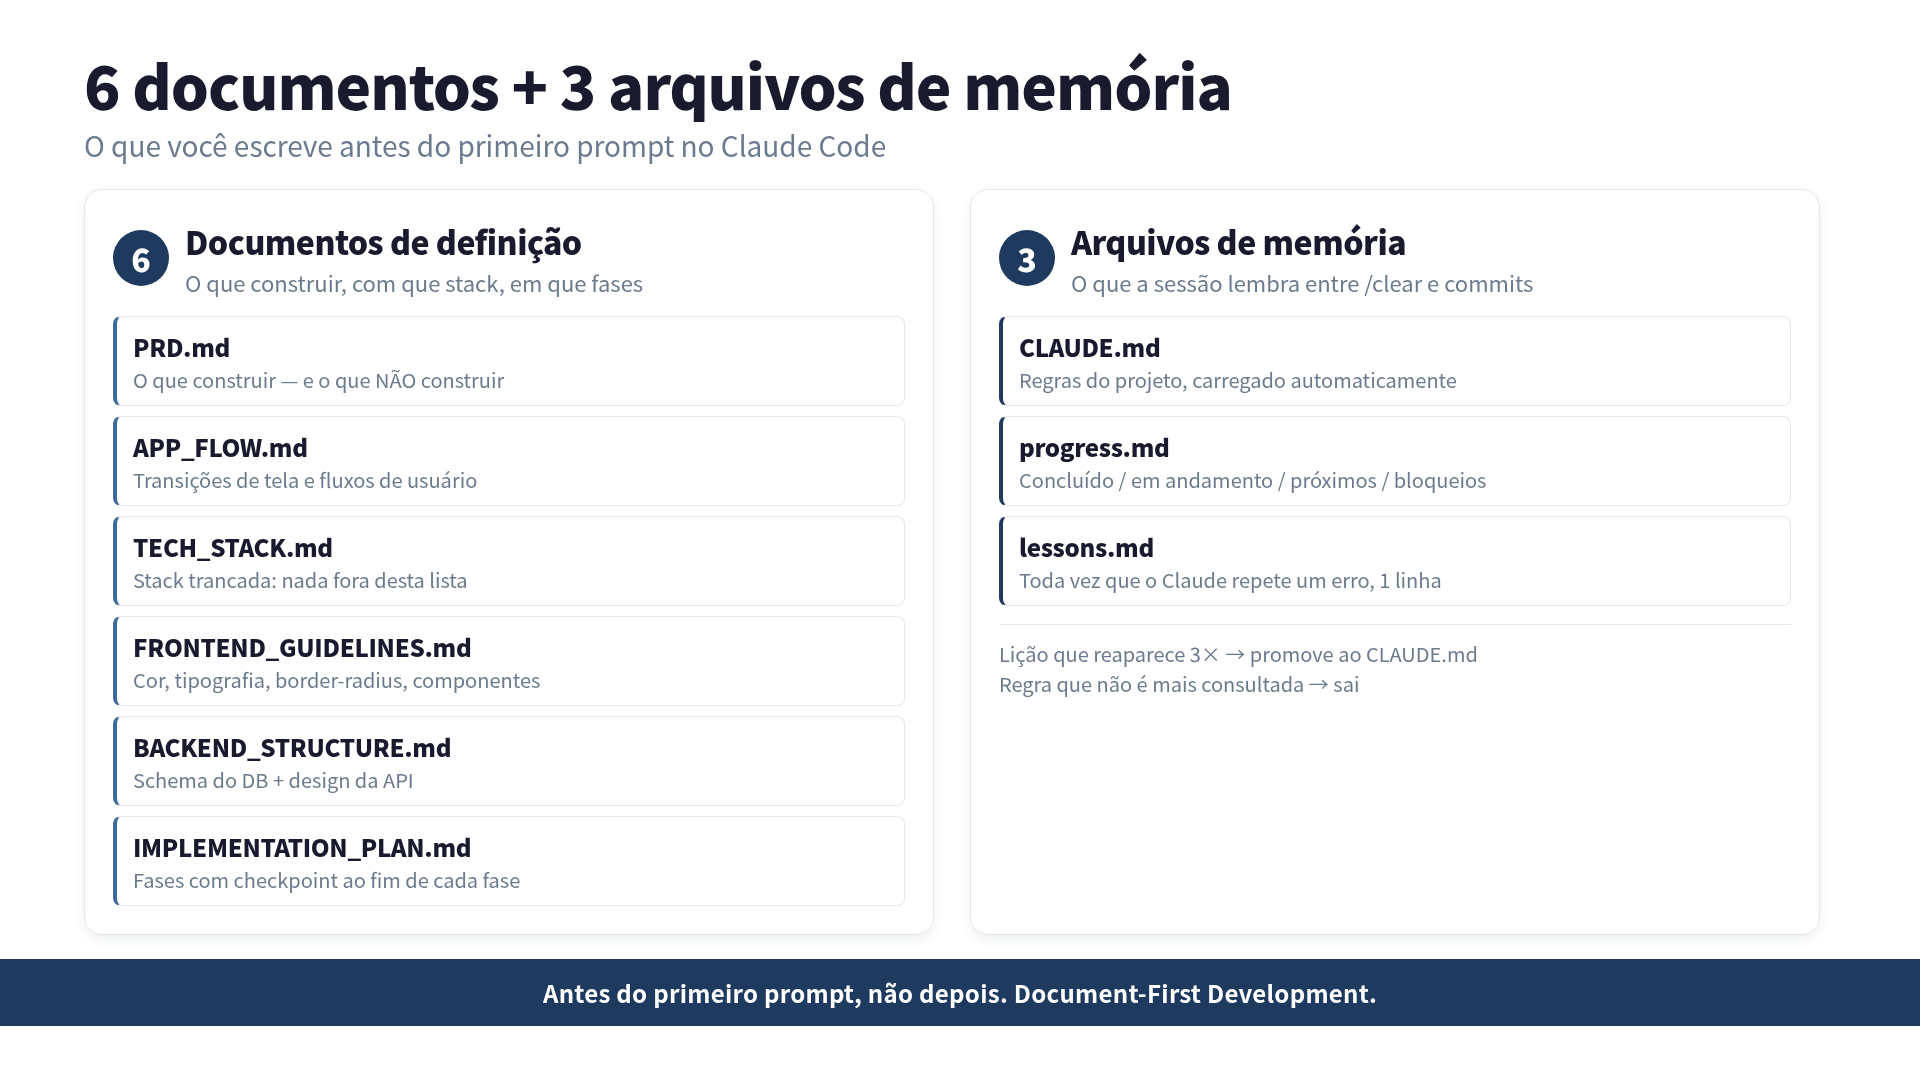
Antes do primeiro prompt: 6 documentos + 3 arquivos de memória
A ideia tem nome: Document-First Development. Em vez de empurrar “o que legal significa” para o modelo adivinhar, você escreve isso antes de abrir a sessão.
São seis documentos de definição:
- PRD.md — o que construir, e explicitamente o que não construir
- APP_FLOW.md — transições de tela e fluxos de usuário
- TECH_STACK.md — stack técnica, com uma linha “não adicionar bibliotecas fora desta lista”
- FRONTEND_GUIDELINES.md — sistema de design (cor, tipografia, border-radius)
- BACKEND_STRUCTURE.md — schema do DB + design da API
- IMPLEMENTATION_PLAN.md — plano em fases, com checkpoint de verificação ao fim de cada fase
E três arquivos de memória, que fazem a sessão não esquecer entre /clear:
- CLAUDE.md — regras do projeto, carregado automaticamente a cada sessão
- progress.md — “concluído / em andamento / próximos passos / bloqueios”
- lessons.md — toda vez que o Claude erra do mesmo jeito, uma linha nova aqui
Nove arquivos no total. Soa pesado. É menos trabalho do que a quinta tentativa de “deixa eu só te explicar de novo o que eu queria”.
Por que a quinta tentativa quebra
Pense no que o Claude Code vê. Ele recebe três coisas: a sua instrução imediata, o diff atual do repo, e qualquer coisa dentro de CLAUDE.md. Se “o que é legal” vive só na sua cabeça, nenhum desses três carrega essa informação. Então ele vai inferir “legal” com base nos padrões do código que já existe — que você veio reescrever justamente porque não estava legal.
Na primeira rodada o Claude chuta certo porque o espaço de possibilidades ainda é pequeno. Na quinta, cada chute anterior virou precedente dentro do mesmo repo. Agora o Claude está mimetizando as decisões ruins que você aceitou nas rodadas 1 a 4. Vibe Coding falha por acúmulo, e nenhum modelo mais capaz corrige esse acúmulo pelo usuário.
O PRD.md inverte isso. Antes de qualquer rodada, você escreveu “o que NÃO construir”. Quando o Claude propõe adicionar “funcionalidade de compartilhamento em time” porque “achou útil”, a sessão tem onde encostar: a seção Out of Scope do PRD. Você não precisa estar presente para o veto acontecer.
O documento 3 muda o jogo
Dos nove arquivos, se eu tivesse que escolher um para começar, não seria o PRD. Seria o TECH_STACK.md com aquela linha final: não adicionar bibliotecas fora desta lista.
A razão é concreta. Claude Code tende a sugerir uma biblioteca nova para resolver um problema que a stack atual já resolve, e sem uma trava isso faz as dependências crescerem sem controle. Com a linha “stack trancada, não adicionar” no TECH_STACK.md, o modelo passa a resolver o mesmo problema com o que a stack já suporta, em vez de trazer mais uma dependência para manter.
A diferença entre o PRD.md e o TECH_STACK.md é a camada onde o veto age. PRD veta features. TECH_STACK veta dependências. Dependências entram muito mais rápido do que features e são muito mais difíceis de remover depois. Comece pelo que apodrece mais rápido.
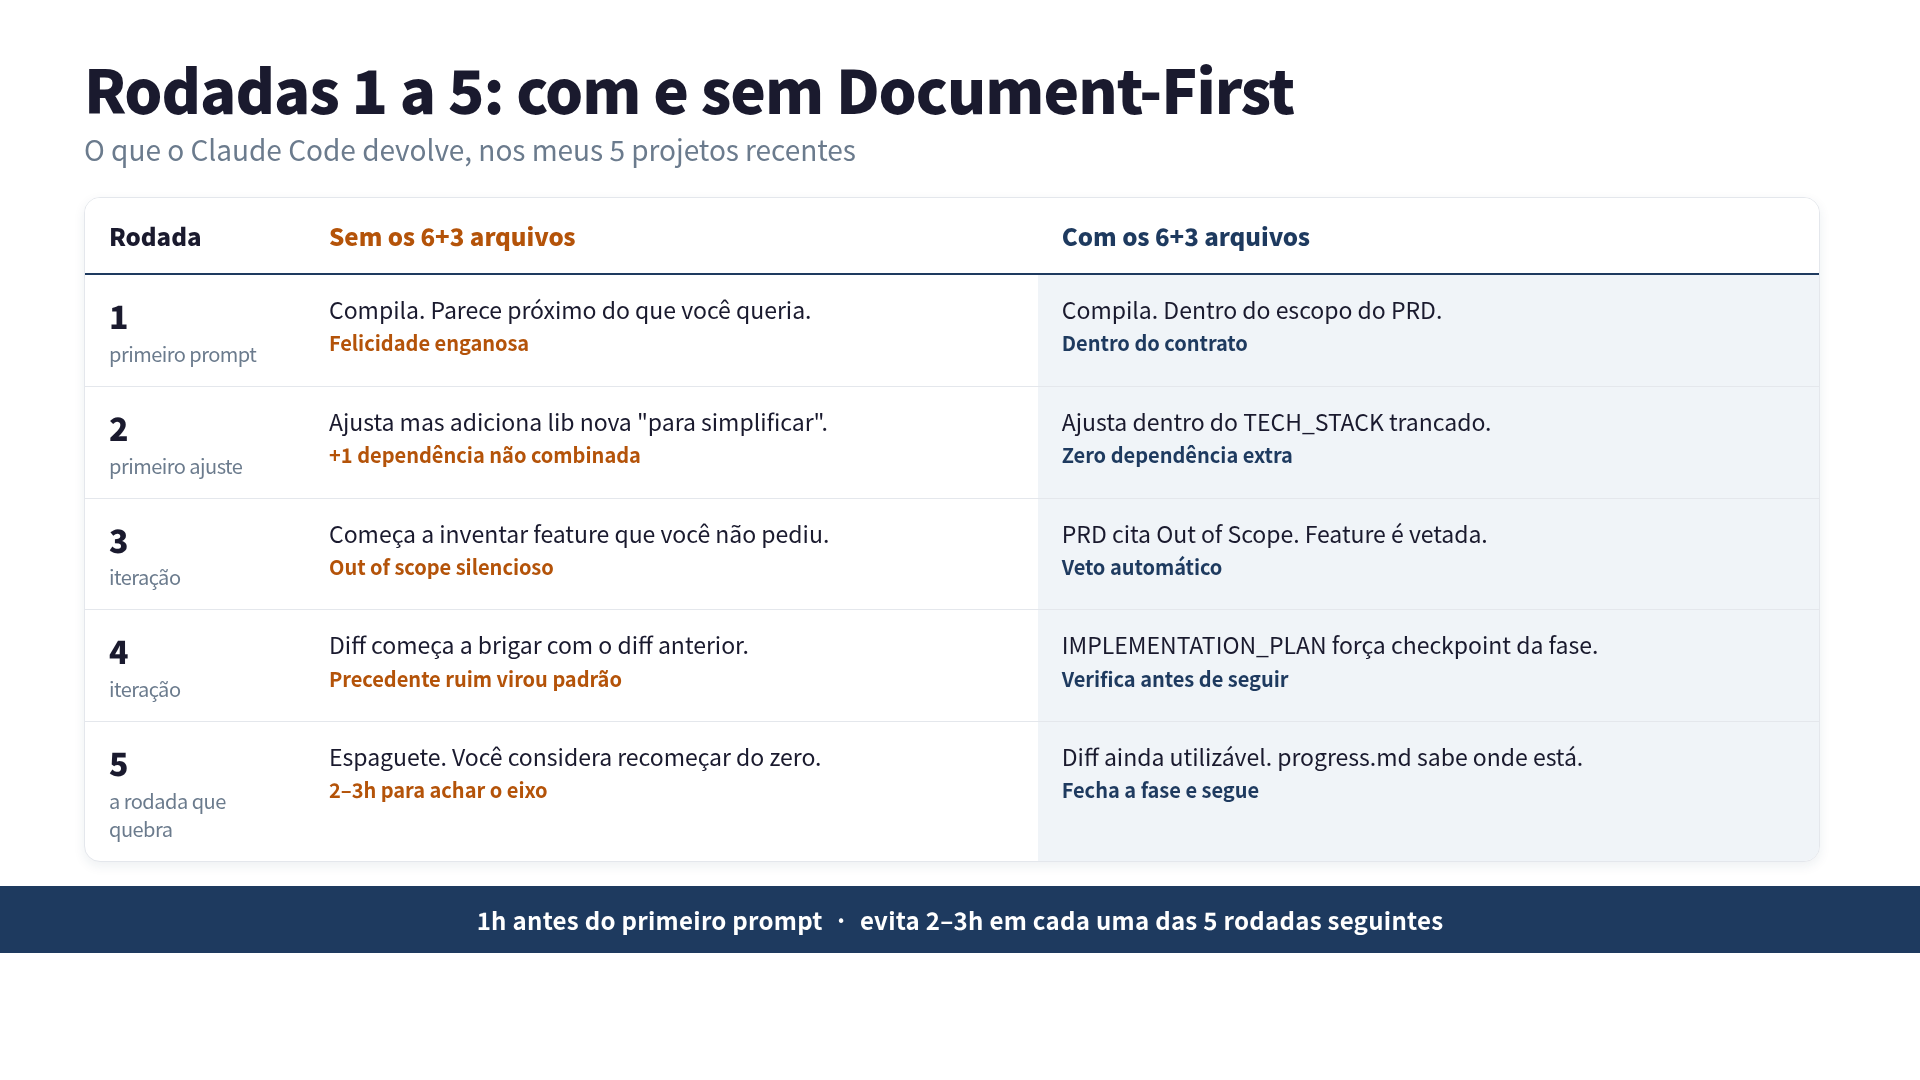
O que os 3 arquivos de memória resolvem
O CLAUDE.md da raiz é o único contexto que sobrevive ao /clear. Toda vez que o Claude repete o mesmo erro, você acrescenta uma linha. Mas se você só acrescenta, o arquivo incha e o modelo começa a ignorar instruções enterradas no meio. É um documento vivo, não um dump de regras.
O progress.md vive à parte justamente para absorver o churn. “Concluído / em andamento / próximos passos / bloqueios” muda toda sessão. CLAUDE.md muda toda semana no máximo.
E o lessons.md é onde você acumula o aprendizado antes de promover ao CLAUDE.md. Toda lição que reaparece 3 vezes ou mais vira regra. Toda regra que não é mais consultada sai. É assim que o CLAUDE.md fica abaixo de 300 linhas sem perder memória.
O custo real
Vou ser honesto: escrever a definição antes é chato. No começo eu também pensava “nos 30 minutos que passo escrevendo definição, já teria escrito o código”. Hoje penso o contrário. Os 30 minutos de definição são o prêmio de seguro que compra as 5 horas do quinto recomeço do zero. Como seguro, é barato demais.
Document-First Development funciona como uma inversão temporal. Você escreve a especificação primeiro porque é o momento em que a cabeça está mais clara sobre o que não quer. Depois do terceiro prompt, você já não lembra.
O que ler em seguida
Se quiser ver o CLAUDE.md pelo outro lado — por que a versão de 2 linhas do criador do Claude Code funciona enquanto a sua de 100 linhas falha — eu escrevi sobre isso em CLAUDE.md: 2 vs 100 linhas, quem erra?.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Practical Claude Code Tutorial de Claude Code | padrões de CLAUDE.md, design de Plan Mode e workflows de equipe Ver a página do livro →
Este artigo foi útil?