Context Engineering: 6 no livro, 2 na produção
Escrevi um capítulo sobre Engenharia de Contexto Completa com seis técnicas de produção. Semana passada resolvi fazer uma coisa que vinha adiando: abri o CLAUDE.md do meu próprio harness e marquei, uma por uma, quais das seis estavam lá.
Duas estavam. Uma delas pela metade. Das outras quatro, duas são a plataforma que faz por mim sem que eu precise escrever uma linha. As duas restantes nunca entraram, e eu nem tinha percebido.
A parte estranha é que isso bate exatamente com o que a bateria do próprio capítulo mediu: depois do RAG, as camadas extras somam no máximo +12% no Sonnet e regridem -14% no Haiku. Se o retorno marginal é esse, faz sentido que o cara que escreveu o capítulo não tenha implementado as seis.
As seis que o capítulo descreve
O capítulo 7 do meu livro em PT-BR lista estas seis técnicas de Engenharia de Contexto para produção:
- Recuperação seletiva — buscar só o que for mais relevante para a consulta, com threshold de similaridade e orçamento de tokens.
- Compressão de contexto — resumir e condensar documentos antes de injetar, em níveis hierárquicos (detalhe → ponto-chave → essência).
- Layout hierárquico — marcar informação com níveis de importância (PRIMARY / SUPPORTING / BACKGROUND) para o LLM priorizar.
- Seleção dinâmica de contexto — trocar o contexto conforme o estágio da conversa (problema → solução → implementação).
- Gestão de memória — curto prazo e longo prazo, pontuados por relevância, frescor e importância.
- Estruturação da saída de ferramentas — não jogar respostas de API/DB cruas no contexto; formatar e adicionar metadados.
É a bateria completa. Promete escalar bem em sistemas RAG grandes. E, como vou chegar daqui a pouco, custa caro de implementar.
O harness que eu realmente opero
O meu “sistema de produção” é um harness de automação de conteúdo que roda sobre Claude Code. O arquivo de contexto principal é o CLAUDE.md do repositório harness-ops: 128 linhas, nove seções. Pega aqui o esqueleto:
# CLAUDE.md — harness-ops

## Sobre o repositório
## Estrutura de diretórios
## Fluxo de operação (diário / semanal)
## Portão de aprovação de factcheck
## Procedimento para novo domínio
## Convenção de mensagens de commit
## Lint de shell scripts
## Evolver (self-evolving)
## Centralização do registro de calendário
Tem um irmão desse arquivo em outro repositório (iris-hub), 250 linhas, 10 seções, que registra skills e dependências. Nenhum dos dois é curto, nenhum dos dois é “três seções e pronto”. Era isso que eu assumia que escalava bem porque “estava funcionando”. Resolvi testar essa assunção.
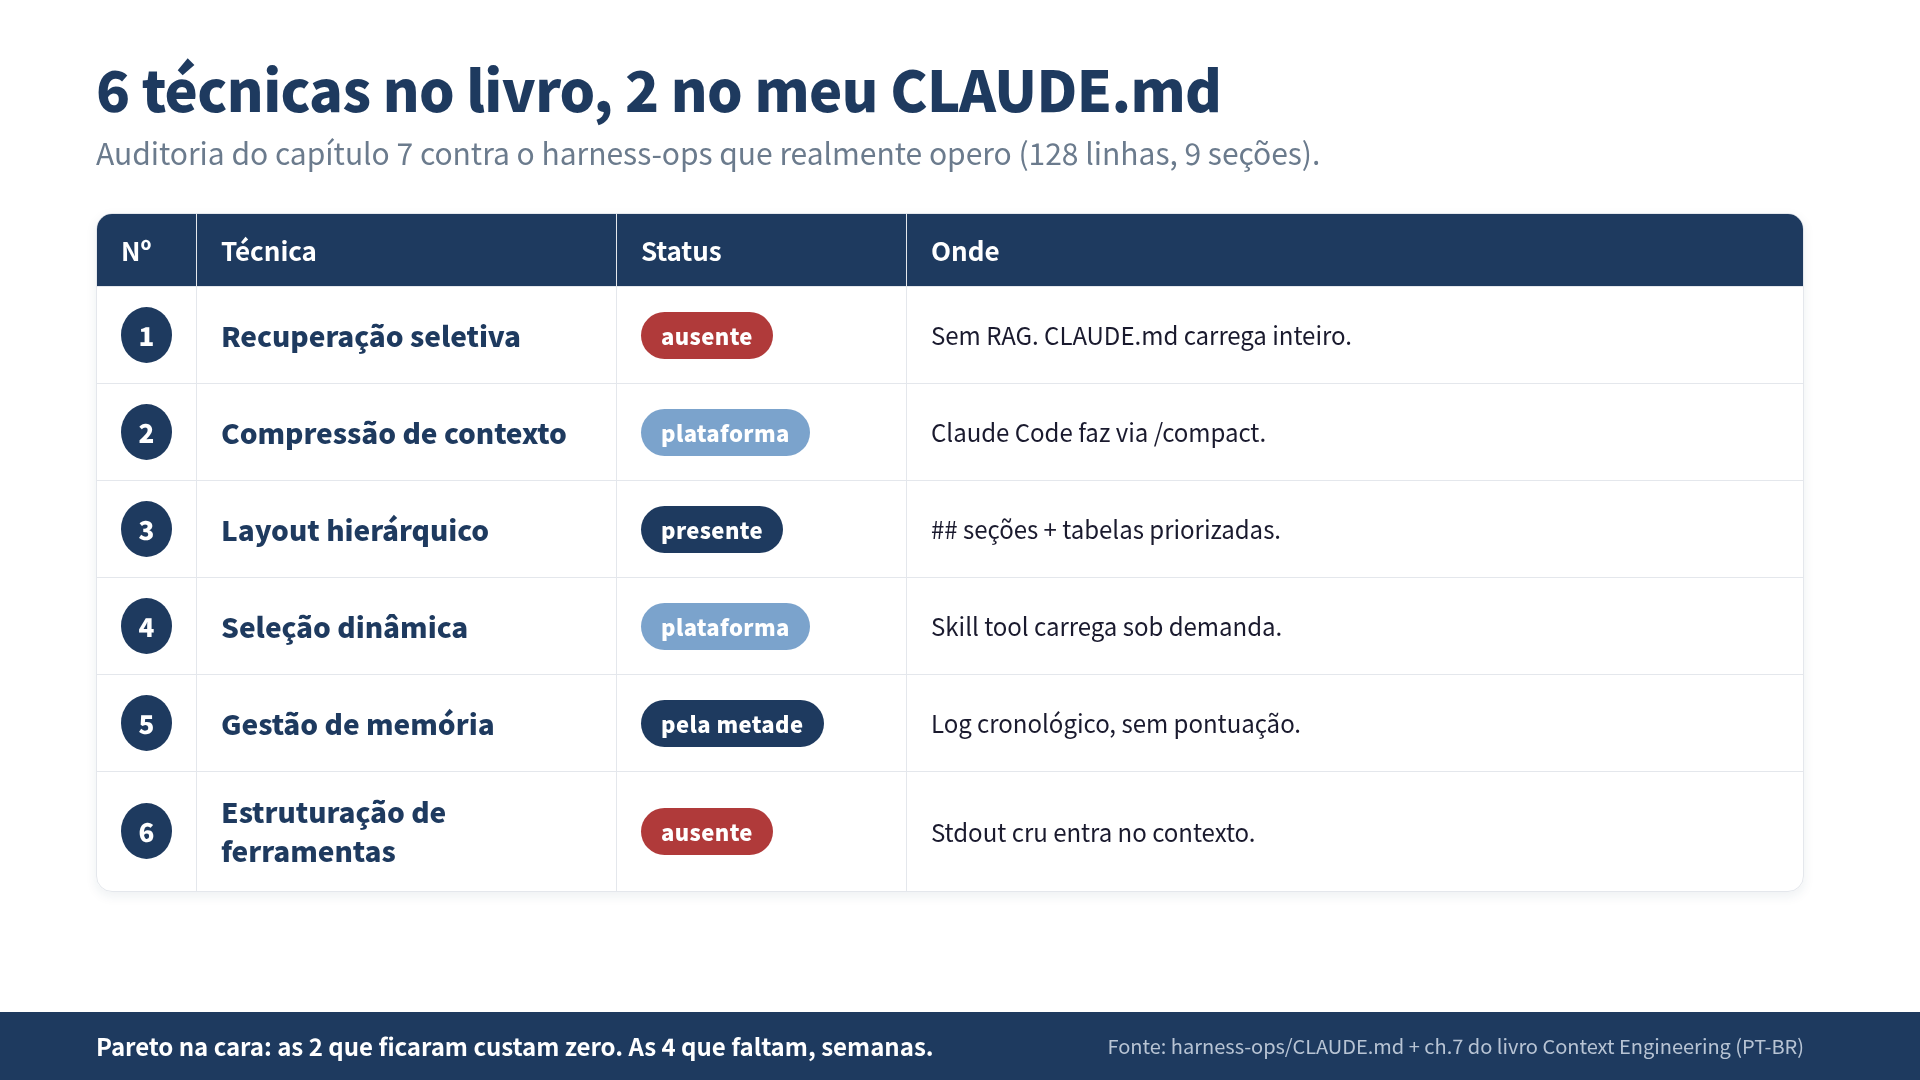
As duas que estão lá, concretamente
Layout hierárquico
Essa é a óbvia. Os cabeçalhos ## separam o papel do repositório, a estrutura, o fluxo e as regras rígidas (como o portão de factcheck). Dentro de uma mesma seção, tabelas com colunas de propriedade (por exemplo, “aprovador automático” versus “aprovador manual”) priorizam o que o modelo deve ler primeiro.
É quase um acidente do markdown bem escrito. Mas, do ponto de vista do capítulo, bate: há três níveis de importância sinalizados, e os níveis são consistentes entre documentos. O LLM, quando precisa decidir se um comando é bash de referência ou uma regra invariante, usa esse mesmo sinal.
Custo de implementação: zero adicional. Eu já ia escrever markdown de qualquer jeito.
Gestão de memória (pela metade)
O iris-hub reserva um diretório memory/YYYY-MM-DD.md para log de atividade diária. Isso é o que o capítulo chama de memória de longo prazo persistente: um lugar onde conhecimento sobrevive à conversa.
Mas aqui a honestidade dói: eu não pontuo nada. Não há decaimento temporal, não há score de relevância, não há combined_score = relevance * 0.5 + freshness * 0.3 + importance * 0.2. É um log cronológico que eu (ou o agente) leio quando preciso. É um tail -1 disfarçado de memória.
Então considero essa técnica “meio implementada”. A estrutura está lá; o algoritmo de recuperação, não.
As quatro que não estão — e por quê
Compressão de contexto: terceirizada para a plataforma
O capítulo descreve uma pipeline de três níveis (removedor de redundância → extrator de pontos-chave → merge de essência). Meu harness não tem nada disso.
Em compensação, o Claude Code tem um comando /compact que condensa a conversa quando ela se aproxima do limite da janela. Eu uso. Eu confio. Nunca escrevi uma linha para substituir. E, pela pesquisa de context rot da Chroma, a janela sofre degradação muito antes do limite nominal. Faz sentido o /compact existir no nível da plataforma e eu só aproveitar o resultado.
Fica a conta: a técnica existe no sistema, mas não vem de mim.
Seleção dinâmica de contexto: idem
Trocar contexto conforme o estágio da conversa, no meu caso, é o que o Skill tool do Claude Code faz quando carrega uma skill por nome em cima da hora. “Preciso rodar o code-review? Carrega o SKILL.md dele só nesse momento, zero carga antes disso.”
O capítulo descreve isso em termos de busca RAG com filtro de metadata por estágio. É o mesmo princípio: “só pague o contexto quando ele for útil”. A implementação é diferente (um registro estático de skills em vez de um orquestrador de conversa), mas o efeito é o mesmo.
Também não escrevi uma linha. Também não é meu.
Recuperação seletiva: ausente de verdade
Essa não tem desculpa.
O capítulo pressupõe que o seu sistema tem RAG, com vector DB e similarity search. O meu harness-ops não tem RAG. Tem um CLAUDE.md de 128 linhas que carrega inteiro, toda vez, independente do que o usuário pediu. Não há threshold. Não há k=20 candidates. Não há orçamento de tokens.
Para alguns dos meus skills, isso é problema: carregam um bloco de regras que não é relevante para a pergunta atual. Para outros, não é, porque o CLAUDE.md é tão pequeno que o custo em tokens não vale o custo em complexidade de implementar RAG.
Para o meu caso, essa técnica provavelmente nunca vai valer o custo.
Estruturação da saída de ferramentas: ausente, mas incomodando
Essa me incomoda mais que a seletiva.
O capítulo diz: “não jogue a saída de uma chamada de API ou de uma query de banco no contexto como está”. Formate, adicione metadata, marque o tipo.
Meu harness roda bash a torto e a direito, e o stdout cru entra no contexto. Quando o git log --oneline cospe 500 linhas, elas vão inteiras. Quando um curl retorna JSON de 20KB, eu confio no modelo para extrair o que importa.
Isso é um problema. O artigo da Chroma mostra que distratores topicamente relacionados derrubam a performance mesmo em contextos curtos, e stdout cru é o campeão de distratores. Essa é a técnica que, se eu for implementar alguma do capítulo nos próximos meses, vai ser esta.
Até lá, honestidade: zero implementado.
Por que isso bate com os +12% / -14%
Lembra do número do post irmão? Full CE acima de RAG rende +12% no Sonnet 4 e -14% no Haiku 3. A bateria do experimento, confesso lá, mediu só uma camada sobre o RAG: System Prompt estrito, saída estruturada, marcação hierárquica. Nenhuma das seis técnicas de produção foi medida de verdade.
Agora que auditei meu harness, dá para entender por que a bateria parou ali: as outras três técnicas (compressão, seleção dinâmica, memória pontuada) custam semanas de engenharia para render pontos decimais acima da linha de base RAG + layout. Em modelo pequeno, pioram. Em modelo grande, somam pouco. É Pareto na cara.
Meu harness, por acaso, segue exatamente essa lógica: implementou o que custava zero (layout) e o que já vinha de graça da plataforma (/compact, Skill tool). Deixou de fora o que custava caro.
Não foi genial. Foi preguiça virtuosa.
O que fazer segunda-feira de manhã
Se você está encarando o seu próprio CLAUDE.md (ou qualquer system prompt grande), três sugestões concretas:
Primeira: abra o arquivo e marque, em cima de cada seção, qual das seis técnicas ela implementa. Vai descobrir, como eu descobri, que a maior parte do que você tem é layout hierárquico com nome bonito.
Segunda: liste as técnicas que a sua plataforma faz por você. Claude Code tem /compact e Skill. ChatGPT com memória faz uma versão fraca de memória de longo prazo. LangGraph oferece seleção dinâmica. Marcar o que é da plataforma te libera para focar no que realmente falta.
Terceira: antes de implementar a técnica cara (recuperação seletiva, compressão própria), rode a bateria de 20 perguntas descrita no apêndice B do livro no seu caso. Se o salto for +12% no seu modelo, decida se duas semanas de engenharia valem +12%. Se for -14%, acabou de economizar duas semanas.
A conta não precisa fechar para todo mundo igual. Só precisa fechar para você.
Resumo
- O capítulo 7 do meu livro em PT-BR lista seis técnicas de Context Engineering para produção. Meu harness, auditado honestamente, implementa duas.
- As duas presentes: layout hierárquico (via estrutura de markdown) e gestão de memória pela metade (log cronológico sem pontuação).
- Duas são delegadas à plataforma Claude Code: compressão (via
/compact) e seleção dinâmica (viaSkilltool). - Duas estão ausentes: recuperação seletiva (meu harness não tem RAG) e estruturação de saída de ferramentas (stdout cru entra no contexto).
- Essa distribuição bate com os +12% / -14% medidos no post irmão: o retorno marginal das quatro técnicas pesadas é fino demais para pagar o custo de implementação em muitos casos.
- Antes de implementar o que falta, meça o salto no seu modelo e no seu produto. Pareto costuma manter a conta mesmo em contextos diferentes.
Leituras relacionadas
- Context Engineering: RAG é 80%, Full CE só +12% — a bateria que mostra o retorno marginal fino
- Context Rot — pesquisa da Chroma — por que a janela sofre bem antes do limite nominal, com 18 LLMs testados
- Haiku 3 + RAG (11,8) venceu Sonnet 4 puro (5,3) — o salto que vale 80% do efeito, medido no mesmo harness
- Context Engineering: por que trocar o prompt não resolve — a entrada da série, antes dos benchmarks
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Transformando LLMs de Mentirosos em Especialistas Engenharia de Contexto na Prática | RAG · MCP · CLAUDE.md · Agentic RAG, com benchmarks de ponta a ponta Ver a página do livro →
Este artigo foi útil?