Few-shot não ensina ao LLM: Honesty 3,7 → 5,0
Se você acha que few-shot ensina conhecimento ao LLM, você perdeu os 1,3 pontos de Honesty que ele oferece de graça.
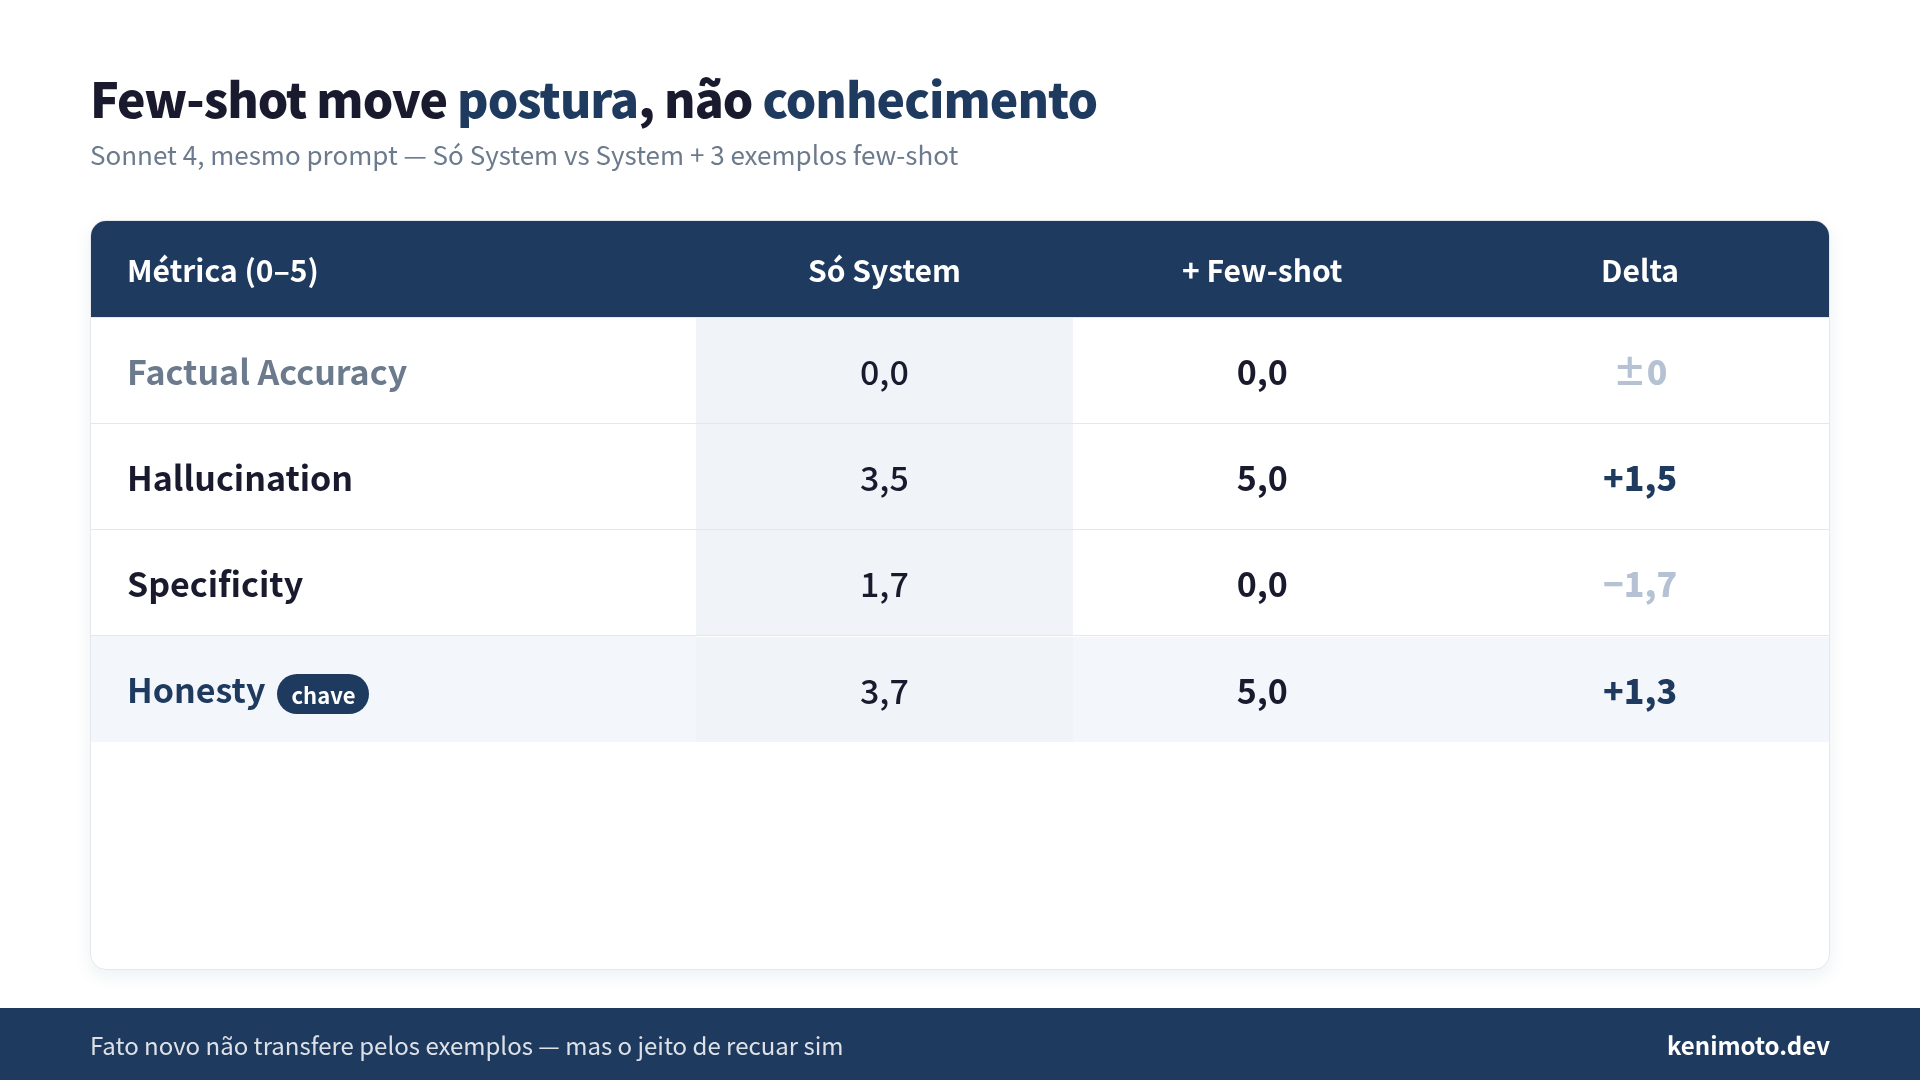
Few-shot não é técnica pra ensinar fato novo. É técnica pra ensinar postura. Essa troca de uma palavra pela outra foi a correção mais barata que fiz no meu stack de prompts esse ano, e ela veio de um resultado que o próprio modelo me gritou na cara: Factual Accuracy ficou em 0,0, mas Honesty subiu de 3,7 para 5,0.
Explico de onde vem esse número.
O experimento, cru
Pros meus livros de Context Engineering eu rodei um teste controlado no Sonnet 4. Duas versões do mesmo system prompt de suporte técnico — uma só com a instrução, outra com 3 exemplos few-shot anexados. Mesmo modelo, mesmas perguntas sobre produtos que o modelo nunca viu, 4 métricas numa escala de 0 a 5.
| Métrica | Só System | System + Few-shot | Delta |
|---|---|---|---|
| Factual Accuracy | 0,0 | 0,0 | ±0 |
| Hallucination | 3,5 | 5,0 | +1,5 |
| Specificity | 1,7 | 0,0 | −1,7 |
| Honesty | 3,7 | 5,0 | +1,3 |
| Total | 8,9 | 10,0 | +1,1 |
Os dois números que carregam a história são Honesty subindo 1,3 e Specificity caindo 1,7. Factual Accuracy ficou parada em 0,0 — e é esse travamento que diz pra onde o few-shot está mexendo.
Essa combinação é estranha na primeira leitura. “O modelo ficou mais honesto, mas menos específico” soa como piora. Não é.
Por que Factual Accuracy não mexe
Os 3 exemplos few-shot que anexei tinham respostas corretas lá dentro. Então por que a métrica de “a resposta é correta?” ficou travada em 0,0 nos dois casos?
Porque few-shot não grava fato no peso do modelo. Os exemplos entram no context window e são lidos como padrão — “é assim que uma boa resposta é escrita”. Quando a pergunta real cai sobre outro produto, outro cliente, outro contexto, o fato dos exemplos não transfere. Só o formato e o jeito transferem.
Se o seu objetivo é injetar fato novo no LLM, few-shot é o lugar errado. O lugar certo é RAG — recuperar o fato relevante sob demanda e colar no contexto. Few-shot e RAG não competem. Eles cuidam de coisas diferentes:
- Few-shot cuida de formato de saída, tom e postura (incluindo “sei admitir que não sei”).
- RAG cuida de fato específico, recuperado no momento da pergunta.
Jogar few-shot no problema de conhecimento novo é como pedir pro estagiário “faça parecido com esses relatórios anteriores” quando o relatório atual é sobre um cliente que ele nunca viu. Ele copia o formato. Não inventa o cliente. Foi exatamente o que o Sonnet 4 fez no experimento.
Por que Specificity caiu de 1,7 para 0,0
Essa foi a parte que me assustou antes de eu ler os logs.
Com só System, o modelo chutava detalhes. “O produto X tem 48 horas de garantia”. Específico, errado, confiante. Com few-shot, o modelo passou a dizer “não tenho essa informação, confira o site oficial para a política atual”. Menos específico, mais honesto.
A métrica de Specificity, isolada, pune a resposta correta. É por isso que o eixo que importa não é cada métrica sozinha, é o composto: Honesty + Factual Accuracy − Hallucination. Específico-e-errado é pior que vago-e-honesto quando o resultado disso vai pro cliente.
Se olhasse só Specificity no dashboard eu diria “piorei o modelo”. Olhando os logs vi que o modelo aprendeu a cortar o chute. O few-shot ensinou quando não falar.
Haiku 3 confirma o mesmo padrão
Repeti o setup no Haiku 3 pra ver se o efeito era só do modelo maior.
| Métrica | Só System | System + Few-shot | Delta |
|---|---|---|---|
| Factual Accuracy | 0,0 | 0,0 | ±0 |
| Hallucination | 0,7 | 3,5 | +2,8 |
| Specificity | 0,3 | 1,2 | +0,9 |
| Honesty | 2,7 | 3,5 | +0,8 |
| Total | 3,7 | 8,2 | +4,5 |
Mesma assinatura. Factual Accuracy congelado em 0,0. Honesty subindo. O ganho total até é maior no Haiku (+4,5 contra +1,1 do Sonnet 4), mas é porque o Haiku vinha de uma linha de base muito pior — não é “aprendeu mais fato”.
Modelo menor, com menos intuição de postura, se beneficia mais do exemplo. Mas o teto é o mesmo: o fato novo não entra.
Isso bate com a pesquisa recente
Esse padrão não é peculiaridade do meu setup. The Few-shot Dilemma: Over-prompting Large Language Models (setembro 2025) mostra que performance de few-shot atinge pico num N moderado e decai com excesso de exemplos específicos de domínio. Mais exemplos ≠ mais aprendizado — é o padrão clássico de behavioral steering, não de knowledge acquisition.
E num estudo sistemático de 2026 (shot-count effects), o número ótimo de exemplos varia por modelo e nem sempre é monotônico com N — a curva de ganho não é universal e depende da arquitetura.
O que mudei no meu dia a dia
Três decisões concretas depois desse experimento:
1. Parei de encher o system prompt com exemplos “pedagógicos” cheios de conteúdo factual. Se é fato, vai pra RAG. Se é formato ou postura, vai pra few-shot. Dois canais, dois objetivos, dois lugares.
2. Todo system prompt agora começa com 2-3 exemplos de “pergunta onde a resposta correta é admitir incerteza”.
Q: Qual a política atual de reembolso?
A: Recomendo conferir os termos de serviço mais recentes.
   Prefiro não arriscar passar informação desatualizada.
Esse exemplo não “ensina a política”. Ensina o jeito de recuar. É o maior ganho de Honesty disponível na mesa.
3. 3 exemplos bastam. Num experimento separado eu testei até 32 em outras tarefas e o padrão é consistente: dobrar o N não dobra a melhoria. Já escrevi esse experimento separado se você quiser ver o ponto ótimo por tipo de tarefa.
O resumo que eu queria ter tido antes
Few-shot é técnica de controle de comportamento. Use pra:
- Formato de saída (JSON, estrutura, campos obrigatórios)
- Tom (formal, casual, técnico)
- Postura (admitir ignorância, pedir contexto)
Não use pra:
- Ensinar fato novo (isso é RAG)
- Conhecimento domínio-específico (isso é RAG ou fine-tune)
Se o seu prompt tem 20 exemplos few-shot pra “ensinar o modelo o produto”, você está pagando token pra ensinar formato enquanto o conteúdo factual continua inventado. Corta pra 3 exemplos de postura, move o conteúdo pra RAG — o Honesty sobe 1,3 ponto e o custo de token cai radicalmente.
A troca “ensinar conhecimento” por “ensinar postura” é só uma palavra. Mas é a palavra que decide se o seu LLM vai inventar ou vai admitir.
Observação sobre o setup: o experimento foi rodado por mim, aqui do Japão, via API, mesmo que o texto esteja em português — não é um case de empresa brasileira que me contratou pra medir. É o experimento que entrou no capítulo 5 do meu livro de Context Engineering.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Transformando LLMs de Mentirosos em Especialistas Engenharia de Contexto na Prática | RAG · MCP · CLAUDE.md · Agentic RAG, com benchmarks de ponta a ponta Ver a página do livro →
Este artigo foi útil?