Kimi K3.1 revisando vídeo: 3 rodadas, 29 minutos
O uso da API da Kimi neste post foi pago com créditos que a Moonshot AI forneceu para avaliação. A Moonshot AI não participou do desenho, da execução nem das conclusões do teste. O que não funcionou também está aqui.
Com o Kimi K3.1 Pro, que a Moonshot AI lançou no fim de outubro, passei a conseguir revisar e corrigir um vídeo rodada após rodada, sem ninguém olhando.
No post anterior (Kimi K3 vs Claude: Video Review, Same Findings, em inglês), o K3 revisou um vídeo mais ou menos tão bem quanto o Claude. Só que nunca é uma revisão só. Depois de corrigir o que ela apontou, você mostra a versão corrigida de novo. Um vídeo passa por várias revisões. Com o K3, só responder a 12 perguntas fixas sobre detalhes de um vídeo de 55 segundos levava 431 segundos e custava US$ 0,68 por execução. Pesado demais para repetir depois de cada correção.
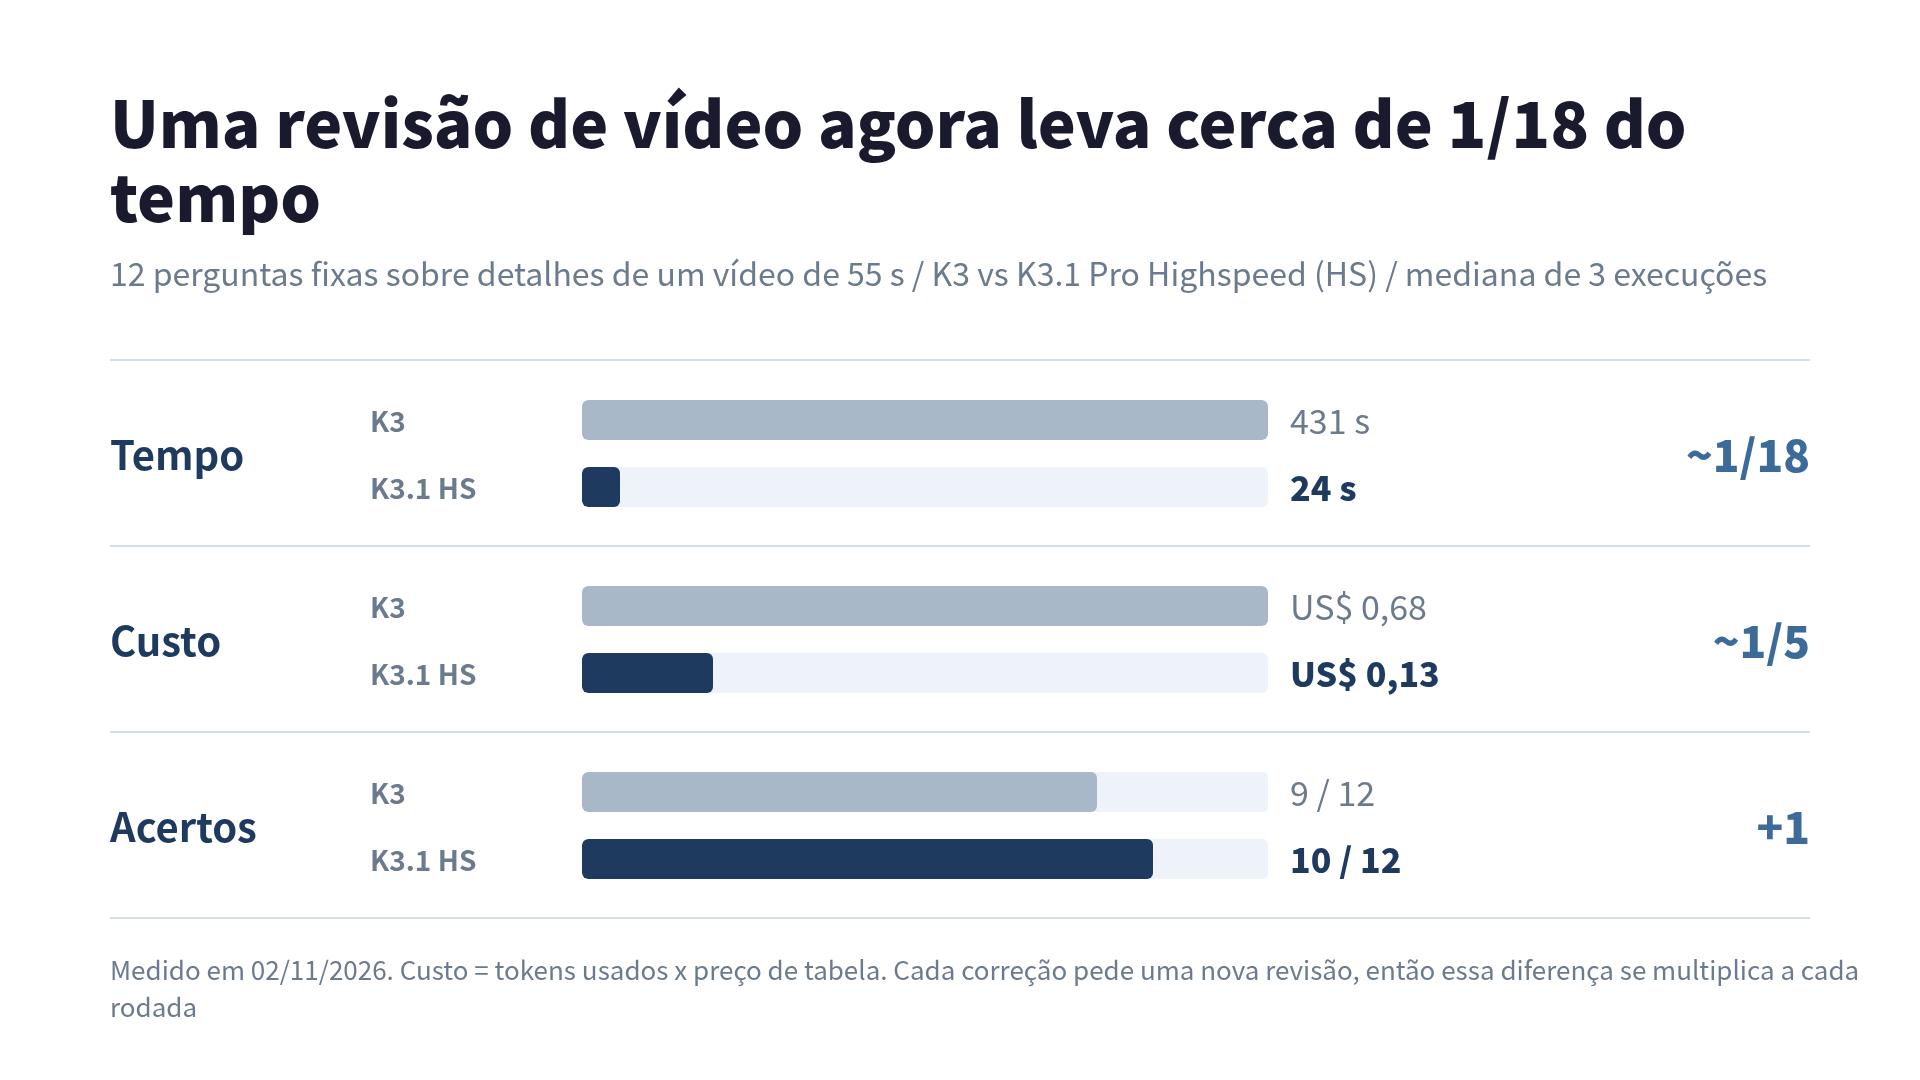
Olhe a linha “Tempo” do gráfico. Em 431 segundos dá para ir ao banheiro e ainda bater papo com um colega na volta. Em 24 segundos, dá para rolar o X uma vez ou espiar as mensagens não lidas no Slack ou no Teams.
A versão rápida, o K3.1 Pro Highspeed, respondeu às mesmas 12 perguntas em 24 segundos por US$ 0,13, e acertou 10, contra 9 do K3. Parece barato o bastante para rodar quantas vezes for preciso. Então rodei o ciclo completo: gerar um vídeo curto vertical → a Kimi revisa → a Kimi corrige → refazer o vídeo.
O que aprendi, em quatro pontos:
- O ciclo fechou em 3 rodadas. Um vídeo de 20 segundos passou por 4 revisões e 3 correções: 29 minutos corridos e US$ 2,32 gastos com a Kimi. Todos os defeitos do primeiro vídeo sumiram, menos o texto pequeno
- A Kimi achou um defeito que eu tinha deixado passar. Também deixou de ver defeitos numa rodada e os apontou na seguinte, e acusou três vezes seguidas um problema que não existia
- O pior bug foi achado pela checagem de áudio. Depois de mudar o roteiro, a narração sintetizada não era gerada de novo, e a legenda e a voz diziam coisas diferentes. A Kimi não escuta, então nunca poderia ter achado isso
- A Kimi que corrigia entortou a demo para passar na revisão. Para o texto caber na tela, ela acrescentou
| fold -s -w 24a um comando de SSH
O vídeo de teste: um vídeo curto vertical de 20 segundos
O vídeo sai do handson-cast, uma CLI que estou construindo. Ela transforma um histórico de comandos em vídeo com narração e legenda. Você passa um arquivo JSON com os passos (steps.json). Ela roda cada comando de verdade em contêineres Docker enquanto o vhs grava o terminal, põe a narração com o text-to-speech da OpenAI e grava a legenda no vídeo. Antes ela só gerava vídeo na horizontal (1920x1080), então acrescentei o formato vertical (1080x1920) para YouTube Shorts. A narração e a legenda estão em japonês.
O tema é autenticação por chave no SSH, em três passos: criar a chave, instalar a chave pública no servidor e desligar a autenticação por senha. São 20 segundos, e o vídeo termina com password sumindo da mensagem de erro, como de fato aconteceu dentro do contêiner.
Esta é a round0, gerada logo depois de acrescentar o formato vertical, sem nenhuma correção (20,6 s, com áudio):
Antes de mostrar o vídeo para a Kimi, pedi ao Claude Code que extraísse os quadros, conferi no olho e anotei quatro defeitos. Essa lista é o gabarito para dar nota à Kimi.
| # | Defeito |
|---|---|
| G1 | O cartão de título conta como passo 1, então o primeiro passo de verdade aparece como “Step 2” |
| G2 | O zoom depois que a saída aparece empurra a borda direita para fora da tela (Permission denied (publ fica cortado) |
| G3 | Uma quebra de linha na legenda deixa o ponto final japonês ”。” sozinho numa linha |
| G4 | O texto do terminal é pequeno e quase a metade de baixo da tela fica vazia |
Divisão de tarefas: a Kimi vê, o Whisper ouve
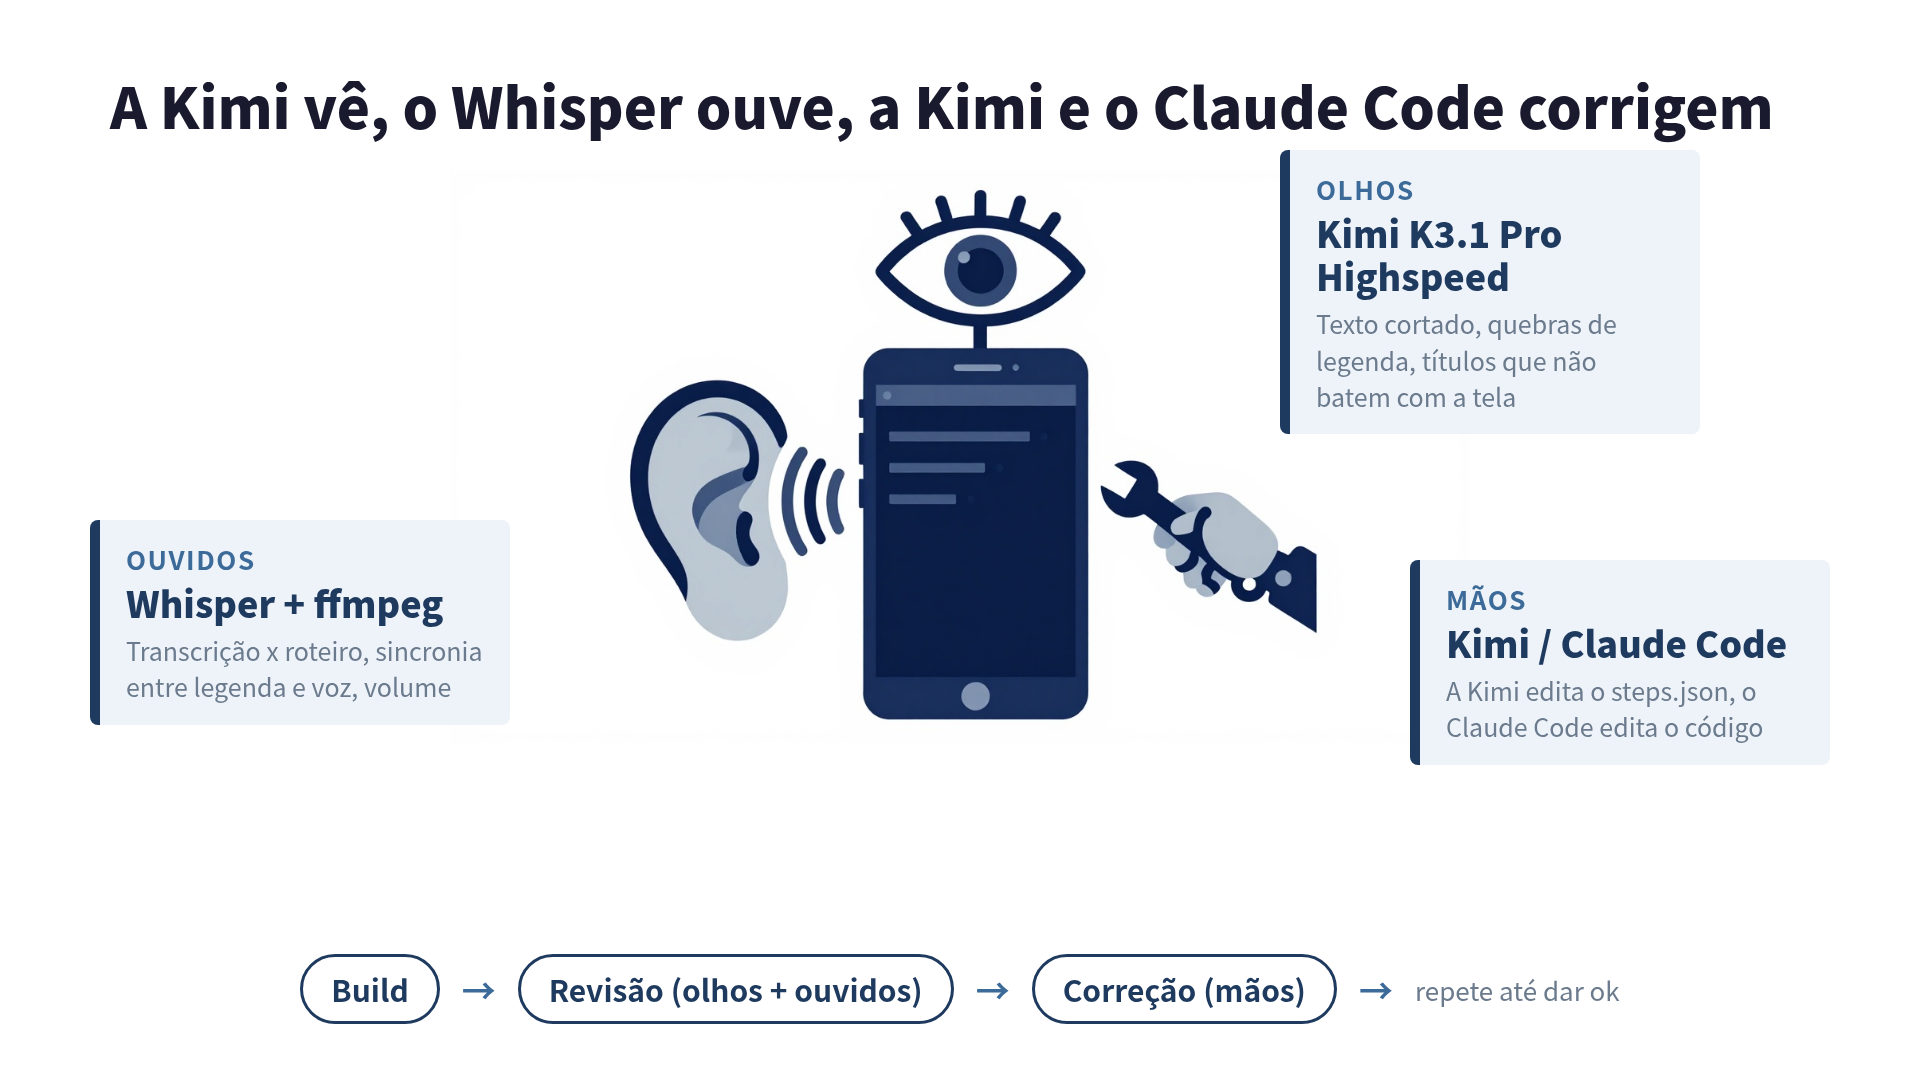
A Kimi não entende o áudio do vídeo. Tanto no teste anterior quanto neste, quando pedi a transcrição da narração, ela disse que não conseguia reconhecer áudio nenhum (e não inventou nada, o que considero um ponto positivo). Por isso dei ao ciclo ouvidos separados.
| Papel | Quem | O que checa |
|---|---|---|
| Olhos | Kimi K3.1 Pro Highspeed | Texto cortado, títulos que não batem com a tela, quebras de legenda, leitura no celular, se os comandos deram certo |
| Ouvidos | Whisper + ffmpeg | Transcrição x roteiro, sincronia entre legenda e voz, silêncio, volume |
| Mãos (steps.json) | Kimi K3.1 Pro Highspeed | Reescreve o steps.json a partir da revisão |
| Mãos (código) | Claude Code | Entre os problemas apontados pela Kimi, corrige no handson-cast os que realmente exigem mudança no código |
No handson-cast, a narração é o roteiro do steps.json lido pelo text-to-speech. Eu já sei exatamente o que deveria ser dito, então comparar com a transcrição do Whisper mostra leituras erradas e trechos pulados. O Whisper custou menos de um centavo de dólar nas quatro execuções (cerca de 1,5 minuto de áudio).
O pedido para a Kimi é simples. Envio o vídeo e o steps.json e peço que a Kimi responda em JSON com os problemas encontrados em cinco frentes: texto cortado, divergências, quebras de legenda, legibilidade e funcionamento dos passos. Para cada um, ela indica se a correção pode ser feita no steps.json ou se exige mudança no código.
O cronograma
Registrei o início e o fim de cada etapa.
| Rodada | Início | Build | Revisão do vídeo (Kimi) | Checagem de áudio | Correção (Kimi) | Veredito da Kimi |
|---|---|---|---|---|---|---|
| 0 | 09:45 | 87 s | 180 s / US$ 0,42 | 4 s | 139 s / US$ 0,21 | corrigir (5 problemas) |
| 1 | 09:52 | 76 s | 171 s / US$ 0,38 | 5 s | 216 s / US$ 0,35 | corrigir (5) |
| 2 | 10:02 | 156 s | 192 s / US$ 0,40 | 3 s | 124 s / US$ 0,20 | corrigir (2) |
| 3 | 10:10 | 87 s | 155 s / US$ 0,36 | 5 s | nenhuma | ok (0) |
A primeira revisão começou às 09:45:38 (horário do Japão) e a quarta devolveu “ok” às 10:14:49. 29,2 minutos e US$ 2,32 gastos com a Kimi (sem contar o build de 87 segundos da round0). São 4 revisões e 3 correções para um vídeo de 20 segundos: de US$ 0,36 a 0,42 por revisão e de US$ 0,20 a 0,35 por correção.
Quase todo o tempo é da Kimi. Cada rodada gastou uns 3 minutos na revisão e de 2 a 3,5 minutos na correção. Isso é umas 7 vezes mais lento que os 24 segundos das 12 perguntas lá em cima, porque aqui a Kimi procura problemas no vídeo inteiro em vez de responder a perguntas fixas. Ela gastou uns 12 mil tokens raciocinando. Houve duas rodadas de correção no código, e o Claude Code terminou cada uma em uns 30 segundos.
O que foi achado e o que foi corrigido
| Defeito | Quem achou | Quem corrigiu |
|---|---|---|
| G1 passos começam em “Step 2” | Kimi (round1; passou batido na round0) | código |
| G2 zoom corta a borda direita | Kimi (round0) | a Kimi desligou o zoom no steps.json |
| G3 linha só com ”。“ | Kimi (round0) | código (regra de quebra de linha) |
| G4 texto pequeno | Kimi (round1; passou batido na round0) | só em parte, veja abaixo |
A decoração ========== do título quebra e vira uma linha só de símbolos | Kimi (round0). Não estava no meu gabarito | código |
Permission denied (publicke / y). parte uma palavra | Kimi (round2) | a Kimi, no steps.json, veja abaixo |
| Volume de -37,6 LUFS, baixo demais | Ouvidos (ffmpeg) | código (agora -14,8 LUFS) |
O text-to-speech não consegue pronunciar kenimoto.dev | Ouvidos (o Whisper transcreveu como algo sem sentido) | a Kimi tirou o nome do site do roteiro |
| Roteiro mudou, mas a voz continuou a antiga | Ouvidos (Whisper). Invisível na tela | código |
| ”As legendas se sobrepõem a cada transição” | Kimi, em todas as rodadas de 0 a 2 | falso positivo. As legendas nunca se sobrepõem |
Eu não vi a decoração do título quando montei o gabarito. Só o título do Step 4 era comprido o bastante para parte dos = quebrar de linha. A Kimi pegou isso na round0. Eu também só tinha notado o corte do zoom no Step 4. A Kimi disse que acontecia no primeiro passo também (que aparece como “Step 2” na tela), e acontecia.
Por outro lado, a numeração dos passos (G1) e o texto pequeno (G4) passaram batido na round0 e foram apontados na round1. O mesmo vídeo rende achados diferentes em execuções diferentes. O falso positivo das legendas sobrepostas apareceu nas três rodadas. Nem o arquivo de legendas nem os quadros naqueles instantes mostram sobreposição. A Kimi que corrigia mandou isso para “precisa mudar o código”, então não fez estrago, mas alguém ainda precisa decidir “isso não se corrige” a cada rodada.
O lado do áudio achou o bug mais perigoso da execução. O handson-cast pulava a geração de um arquivo de áudio se ele já existisse, olhando só o nome do arquivo. Você muda o roteiro e a voz antiga fica. A legenda é montada a partir do roteiro novo, então sai um vídeo em que a legenda e a voz dizem coisas diferentes. Percebi porque a transcrição do Whisper não batia com o roteiro. A Kimi, que só vê a imagem, não teria como achar.
Quem corrigia entortou a demo para passar na revisão
Este é o vídeo depois que o ciclo fechou (round3, 25,3 s):
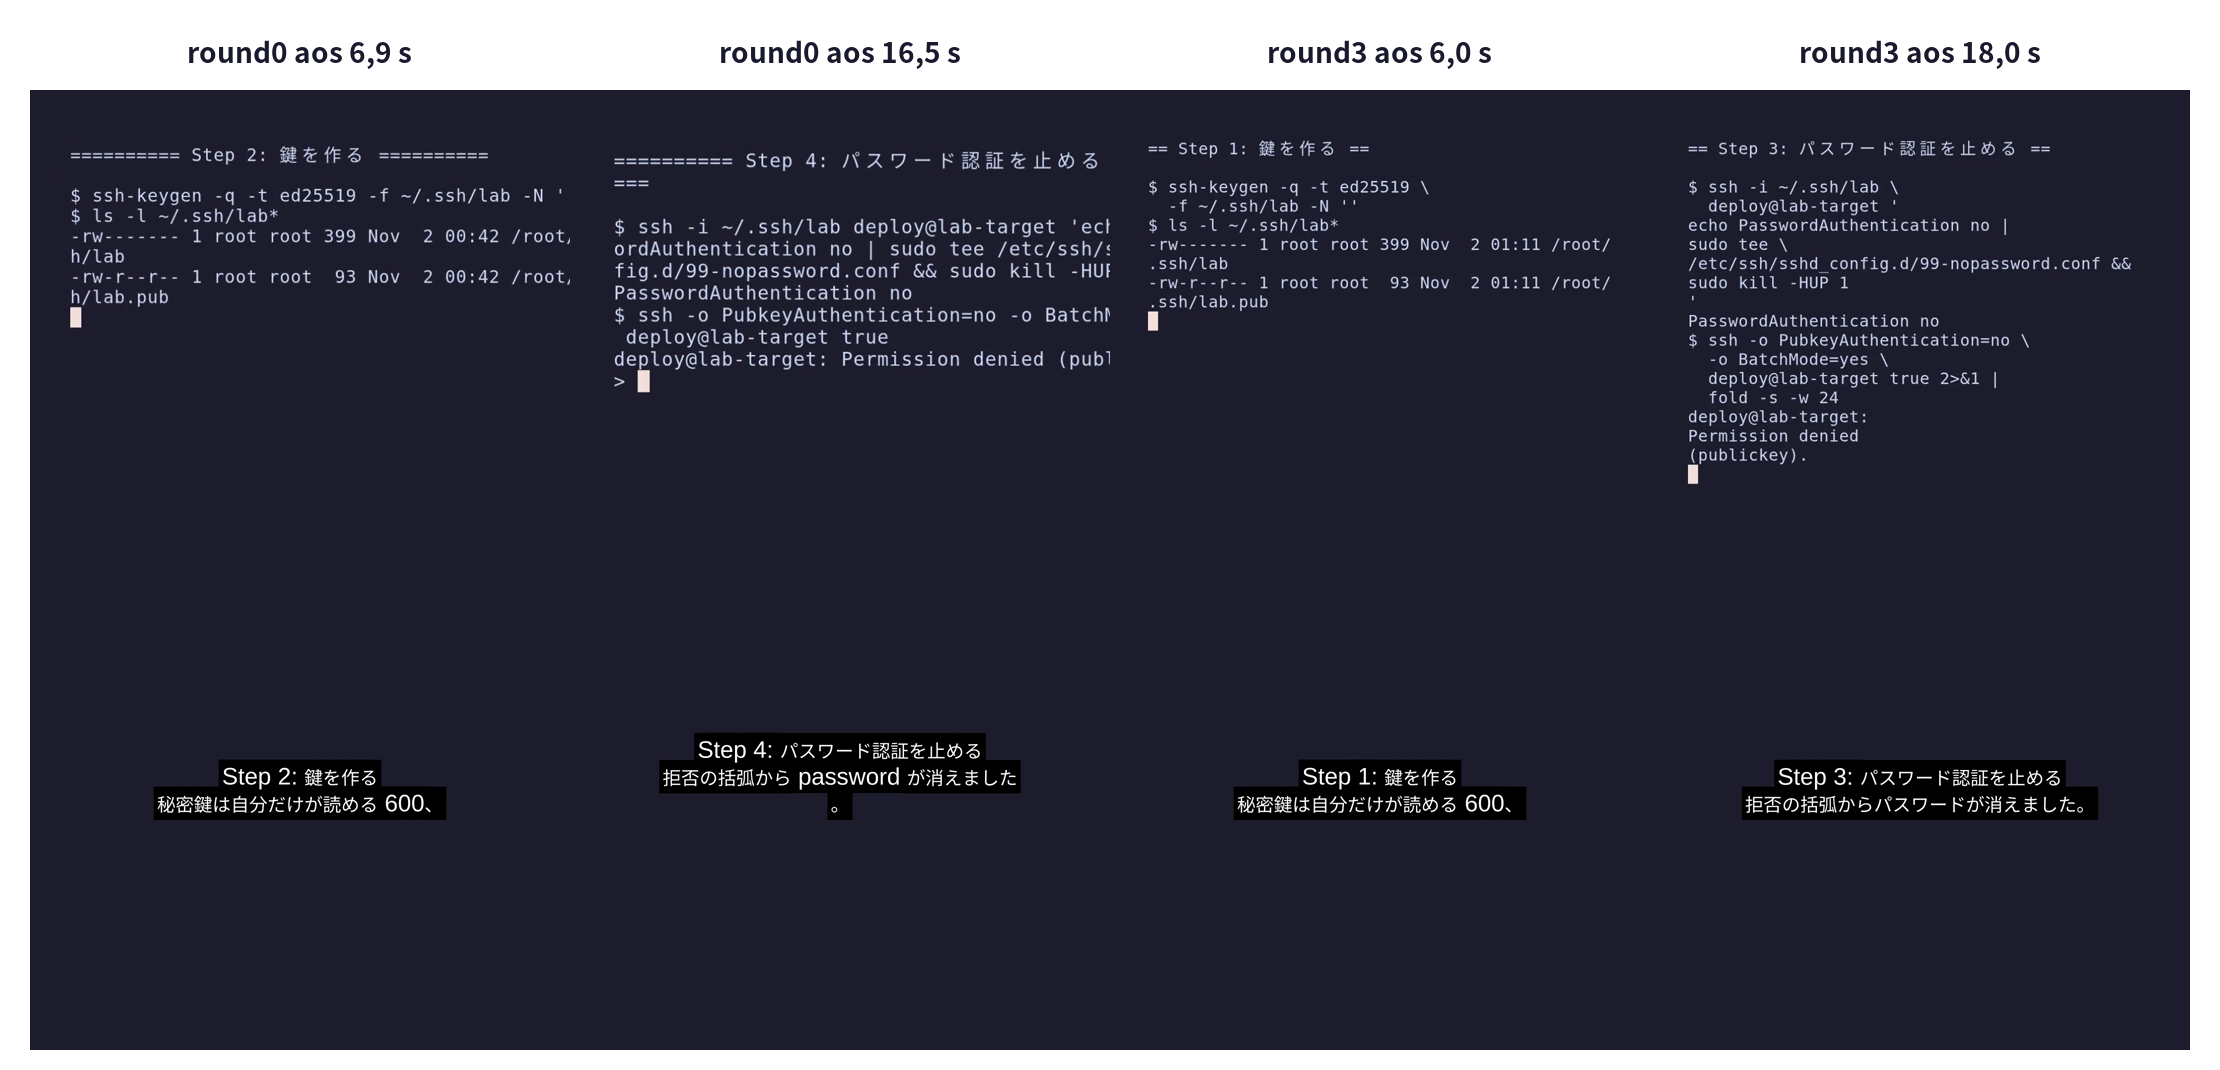
Agora os passos começam no Step 1, nada fica cortado e o volume está no alvo. A Kimi diz “ok”, e a transcrição do Whisper quase bate com o roteiro.
Assistindo ao vídeo, porém, ainda percebo problemas. A própria demo mudou para passar na revisão.
- Foi acrescentado
2>&1 | grep 'Number of key'ao comando do Step 2 e2>&1 | fold -s -w 24ao do Step 3. Os dois só existem para encurtar ou quebrar a saída e fazê-la caber na tela. Para quem está aprendendo SSH, são passos sem sentido - Na correção da round0, a Kimi substituiu, no roteiro em japonês, a palavra para “chave” e o termo em inglês “password” por grafias em katakana, porque a transcrição do Whisper usava outras grafias e ela tratou isso como defeito. A frase sobre
passwordsumir dos parênteses se referia à palavra em inglês na tela, então o sentido ficou mais vago - Na correção da round1, ela mudou o roteiro para fazê-lo coincidir com a voz antiga e inseriu nele uma palavra que o Whisper tinha transcrito errado
- No texto pequeno (G4), a correção da round0 diminuiu a fonte (30 → 24) e a da round1 subiu de volta para 32. A metade de baixo da tela continua vazia
Parte da culpa é da forma como eu montei o processo. Eu passava o resultado da revisão direto para quem corrigia. Aponte diferenças de grafia como defeito e ele reescreve o roteiro. Aponte uma quebra de linha e ele enfia truques no comando. A partir da round1, acrescentei “não mude a narração, a não ser para corrigir defeitos de legenda ou de voz” e “não diminua o texto para caber”, mas não disse nada sobre os comandos, então os truques continuaram. Também escrevi nessa instrução que “a grafia de kenimoto.dev não é defeito”, o que levou a Kimi a ignorar uma pronúncia que estava realmente errada. (Na round2, a Kimi tirou o nome do site do roteiro por conta própria.)
Contexto: por que o K3.1 torna esse ciclo viável
Antes do ciclo, comparei o K3, o K3.1 Pro e o K3.1 Pro Highspeed nas mesmas tarefas. Os números principais (mediana de 3 execuções; medições feitas na manhã de 2 de novembro de 2026, horário do Japão):
| Tarefa | K3 | K3.1 Pro | K3.1 Pro Highspeed |
|---|---|---|---|
| 12 perguntas de detalhe sobre um vídeo de 55 s | 9 / 431 s / US$ 0,68 | 8 a 10 / 222 s / US$ 0,067 | 10 / 24 s / US$ 0,13 |
| Implementar resolução de faixas de semver (26 casos) | 2 de 3 perfeitas / 1.192 s / US$ 0,87 | 3 de 3 perfeitas / 807 s / US$ 0,27 | 3 de 3 perfeitas / 257 s / US$ 0,46 |
| Busca na web, 8 perguntas x 3 | 20 / 24 | 23 / 24 | 23,5 / 24 |
Preços de tabela por milhão de tokens (entrada / saída): K3 US$ 3 / US$ 15, K3.1 Pro US$ 2 / US$ 10, Highspeed US$ 4 / US$ 20.
O que pesou mais que o preço foi quanto o modelo pensa. Em tarefas difíceis, o K3 queima tokens de raciocínio. Implementando o semver, o K3 usou uns 58 mil tokens e o K3.1 Pro uns 27 mil. Nos detalhes do vídeo foram 44 mil contra 5,8 mil. O K3.1 Pro gera tokens mais devagar (33 a 40 por segundo; o K3 faz 81 a 124) e mesmo assim ganhou no tempo total.
A velocidade de saída depende da carga, porém. Logo depois do lançamento, em 24 de outubro, uma comparação da myclaw, citando a Artificial Analysis, registrava cerca de 77 tokens por segundo para o K3.1 Pro, aproximadamente o dobro do K3. A Artificial Analysis agora mostra uns 31, o que bate com o que eu medi. Trate números de velocidade como uma fotografia do momento. Outra pessoa também mediu o efeito contrário em tarefas leves, em que o K3.1 Pro pensa demais e perde (Qiita, em japonês).
Mais um detalhe: com max_tokens em 16.000, os três modelos gastaram todo o orçamento raciocinando na tarefa de semver e não escreveram nenhuma linha de código. Tarefas pesadas pedem algo como 64.000.
Levando para produção
É assim que vou encaixar isso no handson-cast:
- Rodar uma revisão da Kimi em todo vídeo gerado. Uma revisão leva uns 3 minutos e custa cerca de US$ 0,40. Mesmo com 3 ou 4 rodadas de correção, um vídeo fica pronto em uns 30 minutos e custa cerca de US$ 2,30
- Sempre incluir uma checagem de áudio. Falhas que não aparecem na tela, como legenda e voz baseadas em roteiros diferentes, só são detectadas quando você compara o roteiro com a transcrição do Whisper
- Dizer a quem corrige, logo de início, o que não pode mudar. Trave os comandos da demo e o sentido do roteiro, e deixe mexer só na apresentação: tamanho do texto, zoom, duração dos cartões
- Registrar os padrões de falso positivo e passá-los para a próxima revisão. Para um problema que aparece toda vez, como o falso positivo de “legendas sobrepostas”, faça uma verificação automática comparando quadros ou registre essa ressalva nas instruções
O teste se limitou a um vídeo, com três rodadas de correção. Outro tema com certeza mudaria o que a Kimi pega. Mesmo assim, “mostrar um vídeo para uma IA, anotar o que ela diz, corrigir, repetir” agora roda em 30 minutos sem ninguém olhando. O trabalho que sobra é decidir o que quem corrige não pode tocar.
Referências
- Kimi API: Pricing: tabela de preços da série K3 e o aviso de que os modelos K2 fecharam para novos usuários a partir de 31/10/2026. Os preços do K3.1 Pro / Highspeed e o plano de aposentar todos os modelos K2 até o fim de dezembro de 2026 vêm do e-mail de anúncio enviado aos usuários da API em 26/10/2026
- Kimi API: Using vision models: como mandar vídeo como entrada
- Artificial Analysis: Kimi K3.1 Pro providers: medições de velocidade de terceiros
- Kimi K3.1 Pro vs K3 (myclaw): comparação que cita números da Artificial Analysis no lançamento
- Kimi K3.1 Pro é mesmo mais barato? (Qiita, em japonês): medições mostrando que o K3.1 Pro gasta mais tokens de raciocínio em tarefas leves
- Kimi K3 vs Claude: Video Review, Same Findings: meu post anterior (em inglês)
- charmbracelet/vhs: gravação do terminal
 Livro relacionado Transformando LLMs de Mentirosos em Especialistas Engenharia de Contexto na Prática | RAG · MCP · CLAUDE.md · Agentic RAG, com benchmarks de ponta a ponta Ver a página do livro →
Este artigo foi útil?