Skill vs Hook vs MCP: 3 formas, 3 tokens/mês
Passei meses tratando Skill, Hook e MCP como três sabores do mesmo mecanismo de extensão do Claude Code. Ia adicionando o que parecia mais barato para cada caso, como quem escolhe iogurte pelo preço no mercado.
Errado. Eles não dividem a mesma prateleira. Skill cobra aluguel por turno. MCP cobra matrícula no início da sessão. Hook nem entra na conta — é despesa que corre por fora do Claude. No plano Max o boleto do fim do mês não muda com nada disso (é flat, $100 ou $200), mas a janela de contexto de 200k mora com você o tempo todo, e quem pagar por token via API vai ver os três aparecerem em lugares diferentes da fatura.
Este post é sobre onde cada um dos três aparece. Não sobre “qual é o mais barato” — essa pergunta é a que estava me confundindo.
Onde exatamente cada mecanismo cobra token
A documentação da Anthropic é clara sobre isso, mas fica dispersa entre a página de Skills, a de MCP e a de Hooks. Junto num quadro só:
| Mecanismo | Onde entra no contexto | Frequência do custo | Se nunca disparar |
|---|---|---|---|
| Skill | name + description do frontmatter | A cada turno da sessão | Ainda paga aluguel |
| MCP server | Lista completa de tools + schemas | Uma vez no handshake da sessão | Paga a matrícula uma vez |
| Hook | Nada. Roda como subprocesso externo | Zero no configuração; só se o hook devolver texto | Zero |
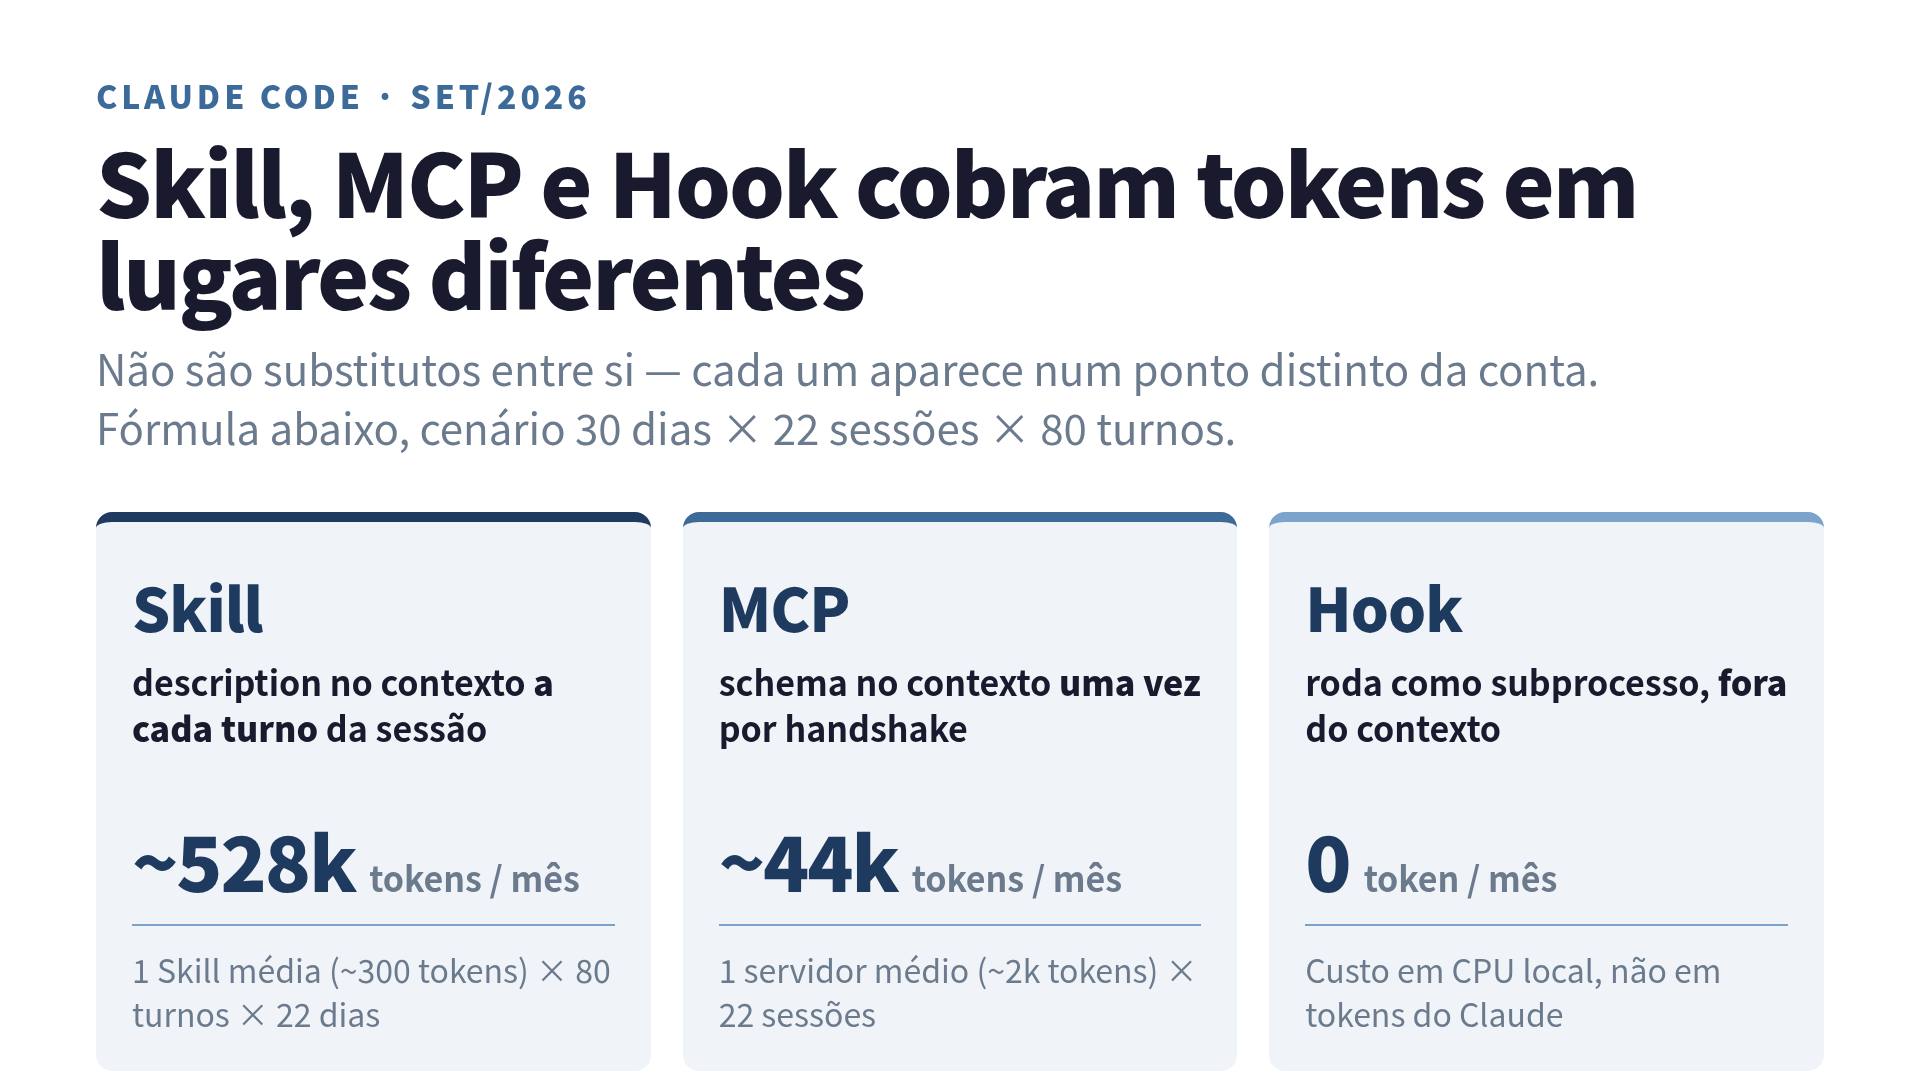
Skill e MCP compartilham uma característica que eu não tinha entendido: eles precisam se apresentar antes que o modelo decida usá-los. O description da Skill é justamente o material que o Claude olha para decidir se ela casa com o seu prompt. O schema do MCP é justamente o cardápio que o Claude olha para decidir qual tool chamar. Nos dois casos, “estar disponível” é o custo — não “ser usado”.
Hook é diferente porque ele não precisa se apresentar ao modelo. Ele é acionado pelo processo do Claude Code (pre-tool, post-tool, session-end, etc.) em resposta a eventos fora do prompt. O modelo não decide chamar um Hook. O harness chama.
Skill: aluguel por turno
Isso já é assunto de um post anterior aqui, Skills carregadas ≠ ativas ≠ pagas só quando usam, onde medi 5 Skills num dia de trabalho de 7 horas. Três delas nunca dispararam, mesmo assim as descriptions somaram ~231k tokens ao longo da sessão. Onze por cento do total do dia, para três arquivos de texto que ficaram sentados no contexto.
O ponto que quero recuperar aqui é o mecanismo, não o número. Cada mensagem trocada na sessão inclui, no system prompt, o name + description de toda Skill em escopo. Se você tem uma Skill com description de ~300 tokens carregada, cada turno paga 300 tokens só para o Claude lembrar que ela existe. Numa sessão de 80 turnos, é 24k tokens no total só para essa Skill.
Isso não é falha de design. É consequência: se o description não estivesse no prompt, o modelo não teria como decidir disparar a Skill. É o preço de ter um “menu” navegável.
O que me pegou é que eu tratava Skill como import de biblioteca — custo zero até ser chamada. Não é. É mais como um pôster no escritório: ele está ali te lembrando toda hora, mesmo quando você não precisa dele.
MCP: matrícula da sessão
Escrevi antes sobre isso também: 4 servidores MCP me custaram 27 mil tokens só de handshake. Um detalhe que preciso ajustar do meu texto original: daqueles 27k, ~18k é overhead base do Claude Code (system prompt + tools nativas) e existiria mesmo sem MCP nenhum plugado. Os ~9k que sobram foram os 4 servidores que eu tinha. O 27k não é aluguel de MCP; é o Claude Code inteiro se apresentando, e MCP entra dentro desse total.
O padrão continua importante: cada servidor MCP plugado, na abertura da sessão, roda 4 chamadas (initialize, list_tools, list_resources, list_prompts). O resultado — nome, descrição, input schema, output schema de cada tool — vira contexto de input. Servidor com 24 tools verbosas custa mais que servidor com 3 tools enxutas.
O que eu tenho plugado hoje é diferente do texto anterior. São três servidores próprios: excalidraw (diagramas), marketing-ops (KPIs de campanhas) e price-dial (cálculo de preço KDP). Todos leves. Não passa perto de 27k. Mas o formato do custo é o mesmo: matrícula única no começo da sessão, depois nada.
MCP é caro quando você pluga o que não usa. Quando o servidor entrega valor, ele se paga rápido — o post MCP me custou 27k para dizer oi. Knowledge Graph cortou 150k para 18k no code review mostra exatamente esse ganho invertido: MCP + KG num code review reduziu o contexto necessário em 8,3x. Mesma tecnologia, direção oposta na balança.
Hook: fora da conta
Hook é o que menos entendi na primeira leitura da documentação. A configuração fica em settings.json, algo assim:
{
  "hooks": {
    "PostToolUse": [
      {
        "matcher": "Write",
        "hooks": [
          {
            "type": "command",
            "command": "eslint --fix $CLAUDE_FILE_PATH"
          }
        ]
      }
    ]
  }
}
Esse bloco não entra em nenhum prompt. Ele é lido pelo processo do Claude Code (o cliente de linha de comando ou desktop), que dispara o comando quando o evento acontece. O modelo não sabe que esse Hook existe. Ele só vê a saída do comando se o Hook explicitamente devolver texto que precisa entrar no contexto.
O meu ~/.claude/settings.json hoje tem 4 Hooks registrados — UserPromptSubmit, Stop, StopFailure, SessionEnd. Todos apontam para o mesmo script (agent-observer-interactive-hook), que loga uso para minha própria observabilidade. Nenhum devolve texto para o Claude. Custo em tokens: zero. Se um dia esse script quebrar, o Claude nem fica sabendo — ele continua a sessão sem tokens de erro nem nada. É fail-open por design, e isso é uma escolha que também importa (Hook falhando não gera comentário; se você conta com o Hook para bloquear algo, tem que garantir que ele bloqueie mesmo quando falha).
Se você quer bloquear .env de virar commit, Hook PreCommit chamando um grep é a forma mais barata do mundo. Zero tokens no orçamento do Claude Code. O custo real é CPU local, o tempo do subprocesso, e a disciplina de manter o script vivo.
Onde os tokens somem, plano por plano
Colocando os três lado a lado numa conta de 30 dias, sessão de trabalho típica (~80 turnos por sessão, ~1 sessão por dia útil, ~22 dias úteis):
| Mecanismo | Fórmula do custo (input tokens) | Por 30 dias |
|---|---|---|
Skill (1 unidade, description ~300 tokens) | 300 × 80 turnos × 22 dias | ~528k tokens |
| MCP (1 servidor médio, ~2k tokens de schema) | 2.000 × 22 sessões | ~44k tokens |
| Hook (comando externo, sem devolver texto) | 0 | 0 |
Isso é aritmética, não medição de sessão minha. Um mês real vai variar com quantas Skills carregadas, quantos MCPs plugados, quantos turnos por sessão, quanto o prompt caching consegue amortizar. Mas a ordem de grandeza que sai da fórmula é o que importa: Skill escala por turno, MCP escala por sessão, Hook não escala.
Traduzindo para dinheiro na fatura da API, com Sonnet 4.6 a USD 3,00 por milhão de input tokens e câmbio de setembro de 2026 rodando em torno de R$ 5,14/USD (Banco Central), o cenário fica assim:
- Skill 1 unidade / 30 dias: 528k input → USD 1,58 → R$ 8,10
- MCP 1 servidor / 30 dias: 44k input → USD 0,13 → R$ 0,68
- Hook 1 evento / 30 dias: R$ 0,00
Não é dinheiro que te tira o sono. Mas quem carrega 5 Skills sem revisar chega em R$ 40/mês fácil, só de descrição encostada. E aí o “small talk” das Skills começa a competir com o consumo útil da janela de contexto — que continua sendo 200k tokens, plano Max ou não.
No plano Max, isso não aparece no boleto (é flat $100 ou $200/mês). Aparece no espaço que sobra na janela: menos tokens de descrição = mais espaço para o código real. Na API metered, aparece direto na conta.
Como escolher (não é por preço)
Depois de mapear os três, o meu framework interno virou este:
- Use Skill quando o objetivo é “codificar um prompt que eu repetiria sempre”. Preço: descrição no contexto por turno. Corolário: mantenha o número de Skills carregadas baixo. 4 é o meu limite atual; se quero adicionar a 5ª, decido primeiro qual das 4 sai
- Use MCP quando o objetivo é “adaptador com schema tipado para um sistema externo”. Preço: schema no contexto por sessão. Corolário: não pluga MCP para ferramenta usada menos que 3x por semana — a regra que já saiu no post do handshake continua valendo
- Use Hook quando o objetivo é “checagem determinística amarrada a um evento” (formatter, linter, detector de segredo). Preço: zero de token, mas o script tem que ser confiável, e fail-open por default significa que uma falha silenciosa não bloqueia nada
Os três não são substitutos. Você não “escolhe o mais barato” porque não estão competindo pela mesma vaga. Skill não faz o que Hook faz (Hook chama um comando determinístico; Skill guia o raciocínio do modelo). MCP não faz o que Skill faz (MCP entrega tools; Skill entrega procedimento). Trocar um pelo outro por causa de preço é como comprar martelo pelo peso: parece coerente até você precisar bater o prego.
O quadro que fixei no monitor
O trecho que resume tudo, do jeito que eu queria ter lido antes de encher meu setup:
Skill cobra por turno. MCP cobra por sessão. Hook não cobra do Claude — cobra do seu servidor.
Se você está no Max, o boleto do fim do mês continua sendo o mesmo $100 ou $200. Mas a janela de contexto de 200k é o recurso escasso que sempre te olha de volta, e Skill em excesso é o mecanismo que mais come dela sem barulho. Na API metered, o mesmo movimento vira dinheiro direto no cartão.
Não é sobre gastar menos. É sobre saber onde o token está indo — para que na hora de adicionar uma extensão nova, você faça a pergunta certa (qual mecanismo?) em vez da errada (qual é o mais barato?).
O detalhamento por mecanismo e as regras de operação do dia a dia estão em Practical Claude Code — o capítulo de Skills / MCP / Hooks é o que mais releio antes de mexer no meu ~/.claude/settings.json.
Aliás, para o leitor que já acompanha de longe, esse é o ponto de virada em que aquele conjunto de “vs” (Claude Code vs ChatGPT Codex, agente vs modelo) muda de forma: o comparativo Claude Code vs ChatGPT Codex Official Agents mostra que a diferença entre agentes não está tanto no modelo, e sim na camada de extensões que cada um deixa você configurar. Este post é a próxima escala dessa mesma conversa, um nível abaixo.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Practical Claude Code Tutorial de Claude Code | padrões de CLAUDE.md, design de Plan Mode e workflows de equipe Ver a página do livro →
Este artigo foi útil?