音声AIを体感350msに縮める7つの知覚ハック
物理の壁は 750ms のままで、体感だけ 350ms になる。
音声AIの応答を 300ms 以内に落とすのが理想とは分かっていても、STT・LLM・TTS を直列に積んだ瞬間に 500ms を切るのが難しくなる。GPU を足しても、モデルを小さくしても、どこかで止まる。そこで諦める前に、別の方向から 1 本線を引けないか。マジシャンが物体を消すわけではなく「消えたように見せる」のと同じ発想です。書籍『音声AI 300ms UX』の第 8 章で、物語の中のユウとミサキが辿り着いた値は「物理 750ms のまま、体感 350ms」でした。
テスターの人数も評価の揃え方もラフなので、どの環境でも同じ幅で縮む保証はありません。
それでも、この章で扱った 7 手法を 3 グループに分け、効き方の違いを対比するだけで「物理を縮めなくても手が残っている」ことが見えてきます。
「物理を縮める」と「感じ方を変える」は別の問題
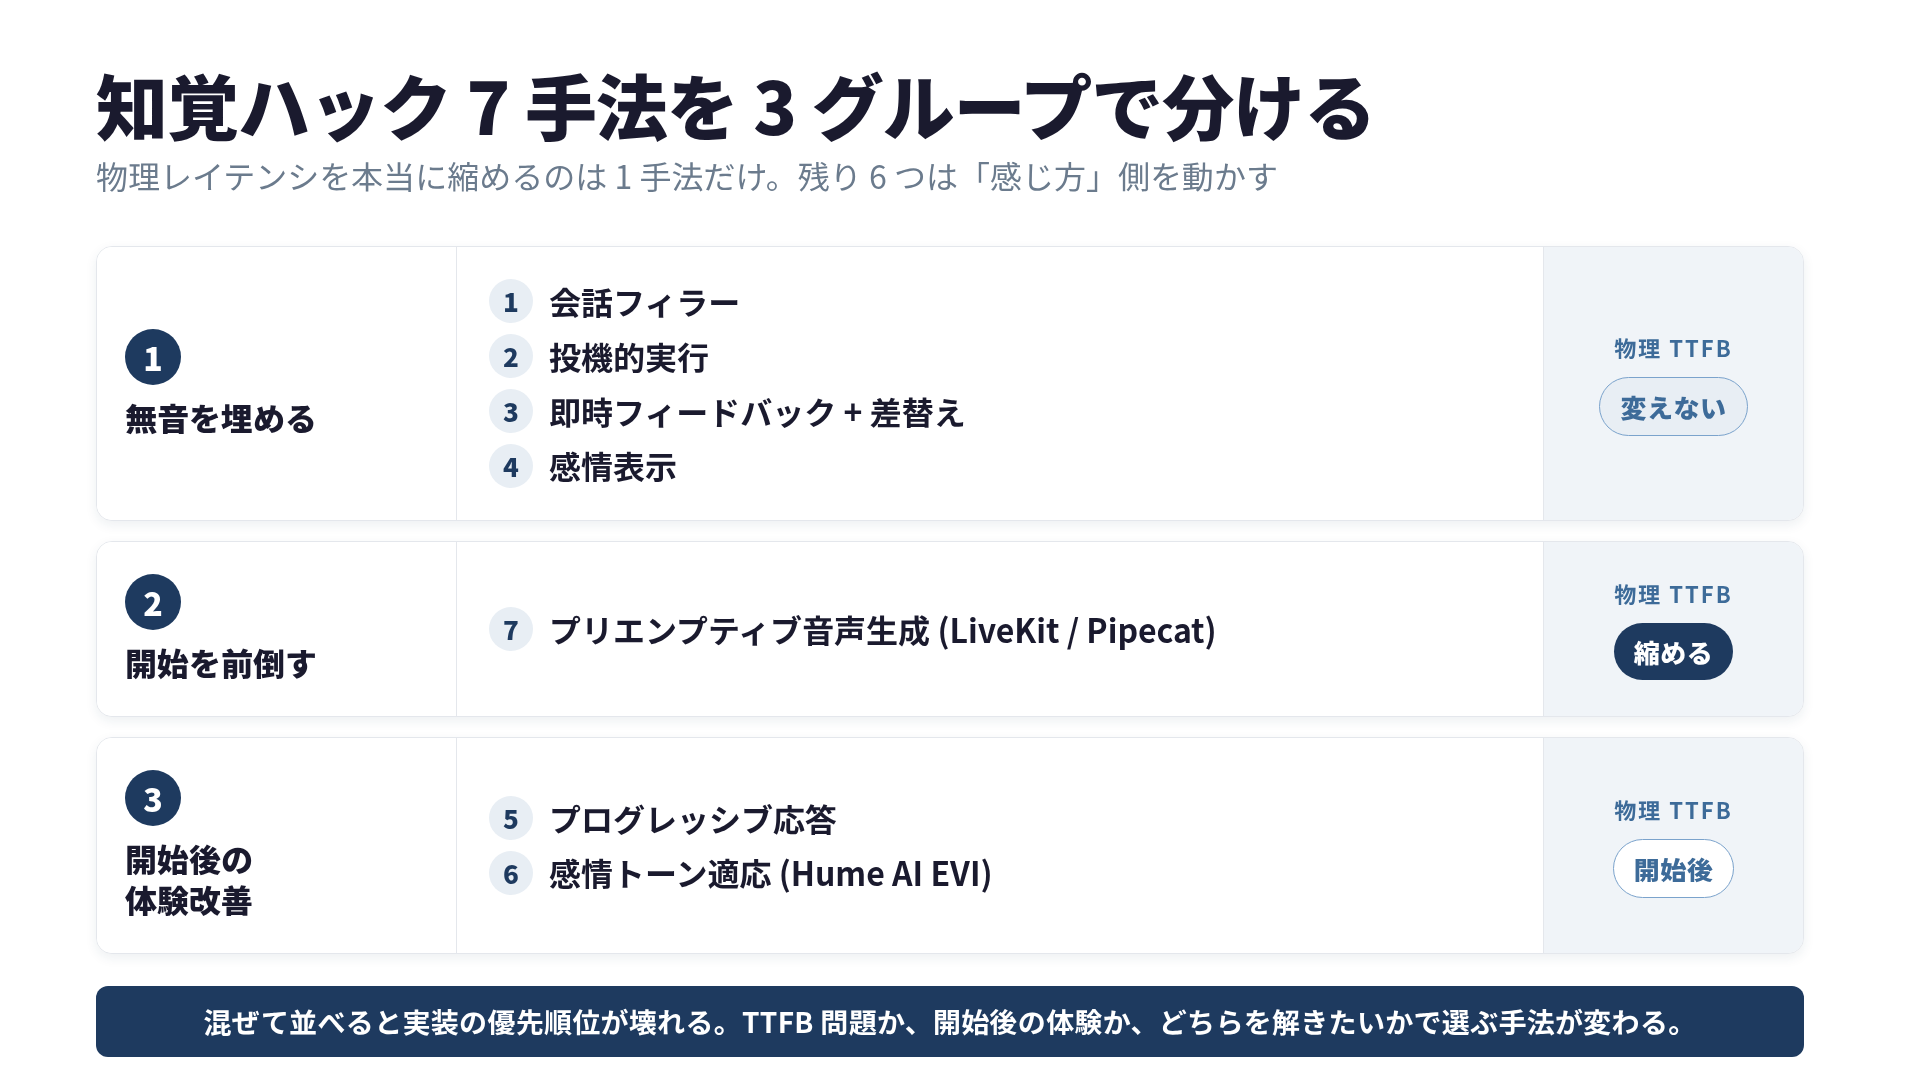
まず、7 手法のうち 物理レイテンシ (最初の音が出るまでの時間) を本当に縮めるものは 1 つだけです。
残りの 6 つは、物理の数字を 1ms も変えません。
- 物理を縮める: プリエンプティブ音声生成 (7)
- 無音を埋める: 会話フィラー (1)・投機的実行 (2)・即時フィードバック (3)・感情表示 (4)
- 開始後の体験改善: プログレッシブ応答 (5)・感情トーン適応 (6)
ここを混ぜて並べると「全部で 7 個の時短テク」に見えますが、それをやると実装の優先順位が壊れます。TTFB (Time To First Byte) を縮めたいのに、応答が始まってからの話し方だけを直して「速くなりました」と言い張る音声AIを、私は何度か見てきました。
グループ1: 無音を埋める (4 手法)
1. 会話フィラー
「えーと」「ちょっと待ってくださいね」「調べてみますね」。
人間同士の会話で自然に挟まる言葉を音声AIにも挟ませる、だけの発想です。沈黙を消す目的なので、再生中にユーザーの体感時計が止まるわけではありません。ただ、空白のまま 2 秒を待たせるのと、「ちょっと待ってくださいね」を 1 秒再生してから 1 秒待たせるのでは、後者のほうが「無視された」という感触がだいぶ薄い。研究の側では ACM CUI 2025 の Maslych らの実験があります。VR 空間の LLM エージェントとの自由会話で、応答遅延を 1.5 秒・4.0 秒・6.5 秒に設定し、身ぶりと言葉のフィラーを比較しました。
自然なフィラーが「応答が速い」という印象を有意に改善したのは 4.0 秒と 6.5 秒の条件で、1.5 秒の条件では有意差がついていません。
秒単位の遅延を対象にした実験で、数百 ms の領域にそのまま持ち込めるかは別途確かめる必要があります。
2. 投機的実行
GetStream の設計記事が「speculative tool calling」として整理しているパターン。質問が予測しやすいとき (天気、残高、カレンダー参照など)、フィラーを再生している裏でツール呼び出しを先に走らせます。
ただし、先行実行していいのは 読み取り専用のツールだけ。送金、投稿、削除といった状態を変える操作は、予測が外れたときに取り消せません。実装では次の 3 点を決めておきます。
- 捨てる手順: 予測が外れた結果は会話履歴に残さない
- 隔離: 先行実行の結果は、ユーザーの発話が確定するまで LLM に渡さない
- コストの上限: 外れても料金が発生する API は対象から外すか、回数を絞る
GetStream の記事は「TTS がフィラーを 1.5-2 秒読み上げている間にツールを実行する」という例を示しています。ベンダーの設計上の見積もりで、独立に測った値ではありません。
3. 即時フィードバック + 差替え
音声入力の文字起こしで広く使われているパターン。ASR の結果を整形前にそのまま表示 (グレー文字)、整形が終わったら差し替える、という 2 段構成です。ユーザーは入力が反映されていることを即座に確認でき、整形を待つ時間がほぼ気にならなくなります。
効果を数値で測った研究は見つけていないので、ここは実装パターンとしての提案に留まります。
4. 感情表示による遅延緩和
東北大学の Jolibois・伊藤・能勢らによる研究 (Applied Sciences, 2025) は、美術館の学芸員役を演じる、顔を持つ対話エージェントを対象にしました。表情を出さないエージェントでは、応答遅延が長くなるほど「応答が速い」という印象が下がりましたが、感情に応じて表情を変えるエージェントでは、この印象が改善しました。対象は画面上に顔があるエージェントで、評価したのは応答の速さの印象です。被験者は東北大学の留学生 25 名、会話は英語。
顔のない音声だけの AI にそのまま当てはめられるかは、この研究では言えません。
グループ2: 開始を前倒す (1 手法)
7. プリエンプティブ音声生成
ここだけが物理レイテンシを縮めます。
従来のフローは 発話中 → VAD が終了を確定 → LLM 推論 → TTS 生成 → 再生 の順に直列です。プリエンプティブ生成は、発話終了が確定する前に 手元の認識結果で LLM 推論を先に始めます。
予測が外れたら捨てる。
当たったら、確定を待っていた時間の分だけ応答が早く始まります。
LiveKit Agents はこれを preemptive_generation として実装していて、既定では LLM だけを先行させ、TTS はターン終了が確定してから走り出します。TTS まで先行させる preemptive_tts もありますが、ユーザーが話し続けた場合に捨てる計算量が増えます。Pipecat の側は、同様の機能を求める GitHub Issue #3321 が 2025 年 12 月に出ており、その時点では「VAD が発話終了を検出してから応答生成を始める」設計でした。短縮幅は、認識結果が届いてから発話終了が確定するまでの待ち時間で決まります。
固定値はありません。
計算コストが増える、途中の認識結果の揺れを扱わないといけない、ツール呼び出しの取り消しが必要になる、といった実装の面倒さと引き換えです。
グループ3: 開始後の体験改善 (2 手法)
このグループは、最初の音が出るまでの時間を一切縮めません。応答が始まってからの体験を良くする手法なので、「体感 TTFB」の数字を直す目的で使うと期待外れになります。
5. プログレッシブ応答
「3 つのポイントがあります。1 つ目は…」のように、最初に全体像を示してから詳細を段階的に展開する構成です。ユーザーは最初の数秒で「何について返してくれるのか」を把握でき、残りの時間を情報の受け取りに集中できます。本書の提案で、効果を測った研究は確認していません。
6. 感情トーン適応 (Hume AI EVI アプローチ)
Hume AI の Empathic Voice Interface は、声の韻律 (ピッチ、リズム、エネルギー) を入力に扱う対話 API です。公式ドキュメントで確認できる機能は 2 つで、ユーザーの声から発話の終わりを判定する、ユーザーの様子に合わせて応答のトーンを変える。例として Hume は「苛立ちには謝罪のトーンで、悲しみには共感を込めて」応じると説明しています。ここから先は本書の提案になります。検出した感情を声のトーンだけでなく 応答の長さ にも使います。
焦りや不満の声質なら短く、落ち着いていれば説明を足す。
優れたバーテンダーが客の表情を見てドリンクの出し方を変えるのと同じで、同じ 30 秒でも「お待たせしました」の声色で体験が変わる、という原理です。
ただし声から推定する感情は、言語・文化・体調・話し方の癖に左右されます。推定が外れる相手が偏って出ることがあるので、次の 3 点は設計に入れておきます。
- 同意: 声から感情を推定する旨を利用者に知らせ、使うかを選べるようにする
- 止める手段: 推定に基づく切り替えを、設定か一言で無効にできるようにする
- 外れても害が小さい使い方: 推定はトーンと長さの調整にとどめ、サービス内容の変更には使わない
「全部入れれば 400ms 縮む」はたぶん嘘
7 手法を単純に足し算して効果を予想するのは、たぶん間違いです。
- 無音を埋めるグループは、互いに同じ時間を奪い合います。フィラーを 1 秒再生している間に、投機的実行と即時フィードバックと感情表示が全部走っていても、ユーザーの体感時計はほぼ 1 秒分しか進みません
- プリエンプティブ生成だけは物理の数字を縮めますが、短縮幅は予測の当たり率に強く依存します。外れが続くと「捨てた計算のコスト」だけが残ります
- 開始後の体験改善は、応答の始まりまでの時間には何も効きません
実装の優先順位は、構成によって変わります。TTFB の中で「発話終了の確定待ち」が長いなら 7 を優先、応答生成そのものが長いなら 1-4 を優先、応答の長さが問題なら 5-6 で削る。
どれが長いかを測ってから選ぶのが先です。
参考までに barge-in (発話の途中割り込み) を入れたときの精度トレードオフは、別の記事 音声AIの barge-in 実装で認識精度 22% 減 にまとめています。VAD の閾値を 4 段階で振ったときの実測で、ここも「体感を良くするために物理を壊す」罠がある箇所です。
まとめ
- 物理レイテンシを本当に縮める知覚ハックは、7 手法のうちプリエンプティブ音声生成の 1 つだけ
- 残り 6 つは、無音を埋める (4) か、応答が始まってからの体験を直す (2)
- 全部を足し算で「400ms 縮む」と予想するのは危険。手法ごとに効く場所が違う
書籍 音声AI 300ms UX では、この 7 手法の背景にあるレイテンシの解剖から、Pipecat・LiveKit・Hume AI の設計差、barge-in やターンテイキングの落とし穴までを 12 章で扱っています。
 関連書籍 音声AIの300ms 音声AI レイテンシ 設計 | 話し終えてから最初の音までを縮める 書籍ページを見る →
この記事は役に立ちましたか?