ハーネスエンジニアリング4フィードバックループ
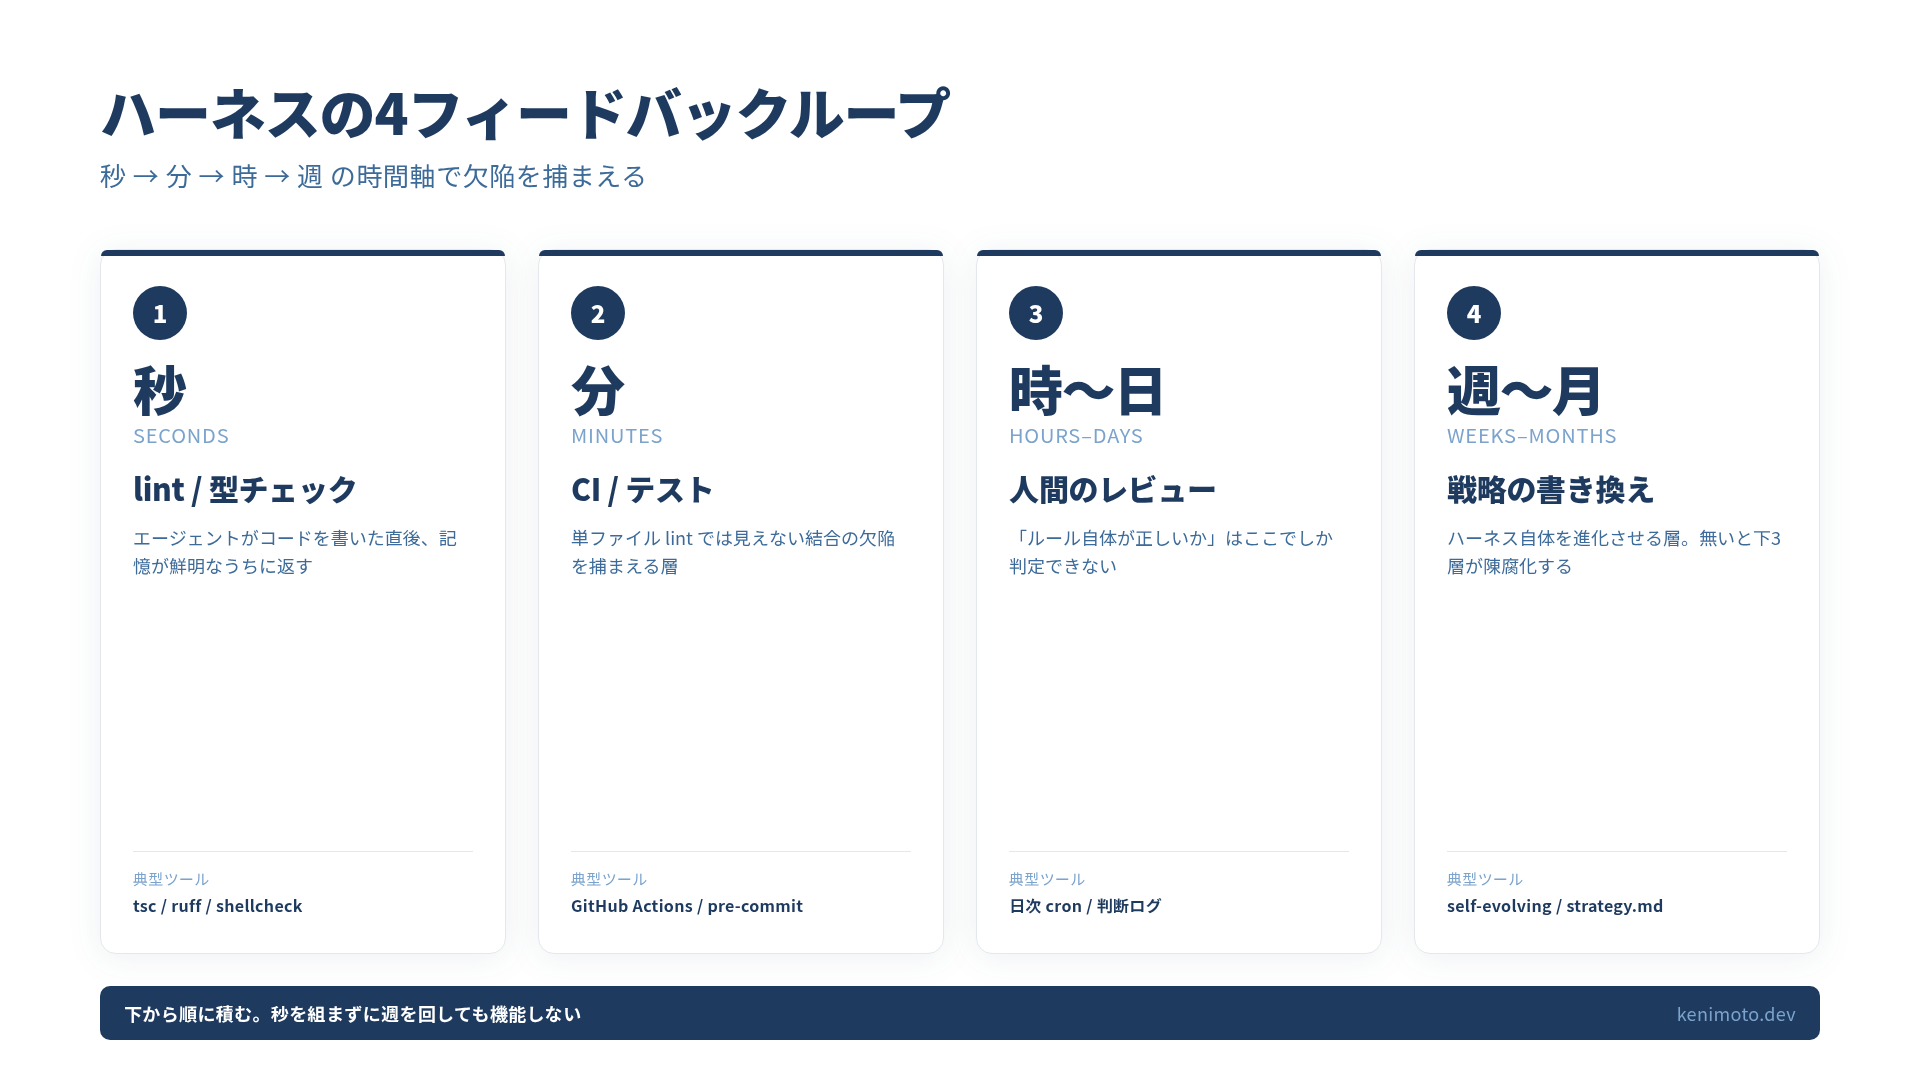
ハーネスエンジニアリングの品質は、フィードバックループの設計で決まります。プロンプトをいくら磨いても、エージェントが自分の失敗を秒単位で知る仕組みがなければ、同じ間違いを週単位で繰り返します。
私が自分の運用リポジトリ (harness-ops) を4つのループに分けて組み直してから、エージェントの「忘れる」事故が目に見えて減りました。順番があります。短い方から長い方へ、秒→分→時→週で積み上げるのがコツです。
お願いは 90%、制約は 100%
SmartScope の記事にハーネス設計の核心を1行で書いた一節があります。
CLAUDE.md に「リンターを実行せよ」と書くことと、Hook でリンターを強制実行するのは、「ほぼ毎回」と「例外なく毎回」の差がある。
ソフト制約 (CLAUDE.md / AGENTS.md に書いた指示) はエージェントが忘れることがあります。体感 9 割は効きますが、忘れる 1 割がプロダクションを壊します。ハード制約 (hook) は 100%。例外がない。
「手を洗ってね」と注意書きを貼るか、蛇口の前にセンサーを付けるか。センサーの方が確実です。ハーネスの4ループは、全部このセンサー側に寄せる話です。
ループ1: 秒単位(lint と型チェック)
一番短いループは、エージェントがコードを書いた直後に lint や型チェッカーがエラーを返す層です。私の harness-ops では scripts/lint-shellcheck.sh が SC1009 のような構文エラーを拾う役割を担っています。現状は CLAUDE.md のソフト制約と pre-commit / 手動実行の push ゲートで運用していて、本来は編集直後の hook に寄せたい層です。
このループが効く理由は単純で、エージェントは直前に書いた行の記憶が最も鮮明だからです。10 分後に CI が落ちると「何をしていたセッションだっけ」から始まりますが、3 秒後に lint が返せば直すコストは数倍安く済みます。
秒単位ループで拾うもの:
- 構文エラー (
tsc --noEmit,shellcheck,ruff) - フォーマット崩れ (
prettier,black) - 型ミスマッチ
Claude Code の PostToolUse hook に lint を仕込むだけで、このループは組めます。私自身は 2026-05-11 にヒアドキュメント内の ```markdown が command substitution として誤評価される SC1009 を踏んで本番 cron が止まり (5/11-13 の Zenn 公開分がカレンダーから漏れました)、その事件を受けて lint-shellcheck.sh を事後に組み込んだのが実際の経緯です。秒単位ループで拾えていれば、本番まで滑らせずに済んだ欠陥でした。
ループ2: 分単位(CI とテストスイート)
次のループはタスクの完了直後に CI が走る層です。GitHub Actions / pre-commit hook / 自前のテストランナーが該当します。
ここで拾うのは、単ファイル lint では見えない結合の欠陥です。関数単体は型が合っていても、実データで呼ぶと落ちます。この種の間違いは秒単位ループでは検出できません。
私の harness-ops では core/factcheck-gate.sh が記事公開の直前にファクトチェックを走らせ、CRITICAL が 0 でなければ各ドメインの marketer スクリプト (<domain>-marketer.sh) が後続の公開処理を打ち切る設計にしています。「書き方」の検査 (AI Slop / rhythm / 書式) だけに依存せず、内容が事実かを見る最終ゲートとして機能します。
分単位ループで注意するのは、「うるさすぎる hook」を作らないことです。週 100 回以上 fire している hook は、だいたい無視されるか回避されます。信号対雑音比を監視する指標にしています。
ループ3: 時〜日単位(人間のレビュー)
ここからエージェントだけでは閉じないループに入ります。私の運用では、日次 cron がドメインごとの判断ログ (strategist の選定理由やmarketerの公開結果) を data/ に残し、Telegram で私に通知します。
私はそれを読み、「この基準はおかしい」と思ったら strategy.md を書き換えます。翌日のエージェントは改訂されたルールで動きます。
時間単位ループで拾うのは、「ルール自体が間違っている」系の欠陥です。lint と CI は「ルールに沿って動いているか」を見ますが、ルール自体の妥当性は見ません。ここは人間の判断が入らないと閉じない。
ただし、人間が判断するタイミングを「毎日」か「週1」か「随時」かで決めておかないと、このループは腐ります。私は日次通知を「ざっと目を通す」、週1 を「腰を据えて読む」に分けています。
ループ4: 週〜月単位(戦略レベル)
最後が、ハーネスそのものを書き換えるループです。私は harness-ops に harness-evolve という self-evolving スキルを置き、現状は Dev.to ドメイン向けに毎週土曜 09:00 の cron で起動させています (kenimoto.dev ドメインは data/evolution/ の整備がまだで、同じ cron はこれから展開するところです)。前週の判断ログと記事パフォーマンスを読み、strategy.md や記事テンプレートの改訂案を提案し、Telegram で私の承認を待ちます。
週単位ループで変えるのは:
- 戦略ルール (何を書くか、何を書かないか)
- ハーネス構造自体 (hook の追加 / 削除、スキルの再編)
- 評価基準 (KPI の切り替え、CTR 曲線の引き直し)
この層がないと、下の3層は数ヶ月で陳腐化します。実際、私が8月に組んだ CTR 改題ルールは、10 月の実測で前提が崩れていて書き直しました。週単位ループがなければ、古い前提のまま動き続けていたはずです。
4ループは順番に積む
この4ループは下から順に積まないと機能しません。
週単位でハーネスを進化させても、秒単位の lint がなければ毎回同じバグを踏みます。逆に秒単位の lint だけあっても、週単位の見直しがなければルール自体が陳腐化します。
ハーネスエンジニアリング実践ガイド でも各章で繰り返し出てくる原則なのですが、hook (ループ1-2) は Fowler がいう「暗黙のハーネス」の明示化で、人間レビュー (ループ3) は Anthropic のコンテキストリセットパターンに対応し、週次の書き換え (ループ4) は self-evolving の起点になります。
一度に4つ組もうとせず、まず秒単位から順に塗り固めます。私が3ヶ月で学んだのはそこです。
まとめ
ハーネスエンジニアリングの肝は、エージェントの「忘れる」を複数の時間軸で捕まえることでした。要はセンサーを増やす設計です。
- ループ1 (秒): lint / 型 / フォーマッタで即時フィードバック
- ループ2 (分): CI / テスト / factcheck で結合の欠陥
- ループ3 (時〜日): 人間レビューでルールの妥当性
- ループ4 (週〜月): ハーネス自体の進化
4ループが揃うと、「お願い」 90% が「制約」 100% に置き換わります。設計と呼べるのはそこからです。
 関連書籍 ハーネス・エンジニアリング ハーネスエンジニアリング 入門 | AGENTS.md 設計・hooks 実装・AIエージェント運用の体系書 書籍ページを見る →
この記事は役に立ちましたか?