GraphRAGがJEMHopQA 120問で負け
GraphRAG は「マルチホップで強い」とされます。文書をまたぐ推論はベクトル検索の弱点だから、グラフでつなぐと取れる、というのが前提。私もそう思っていました。
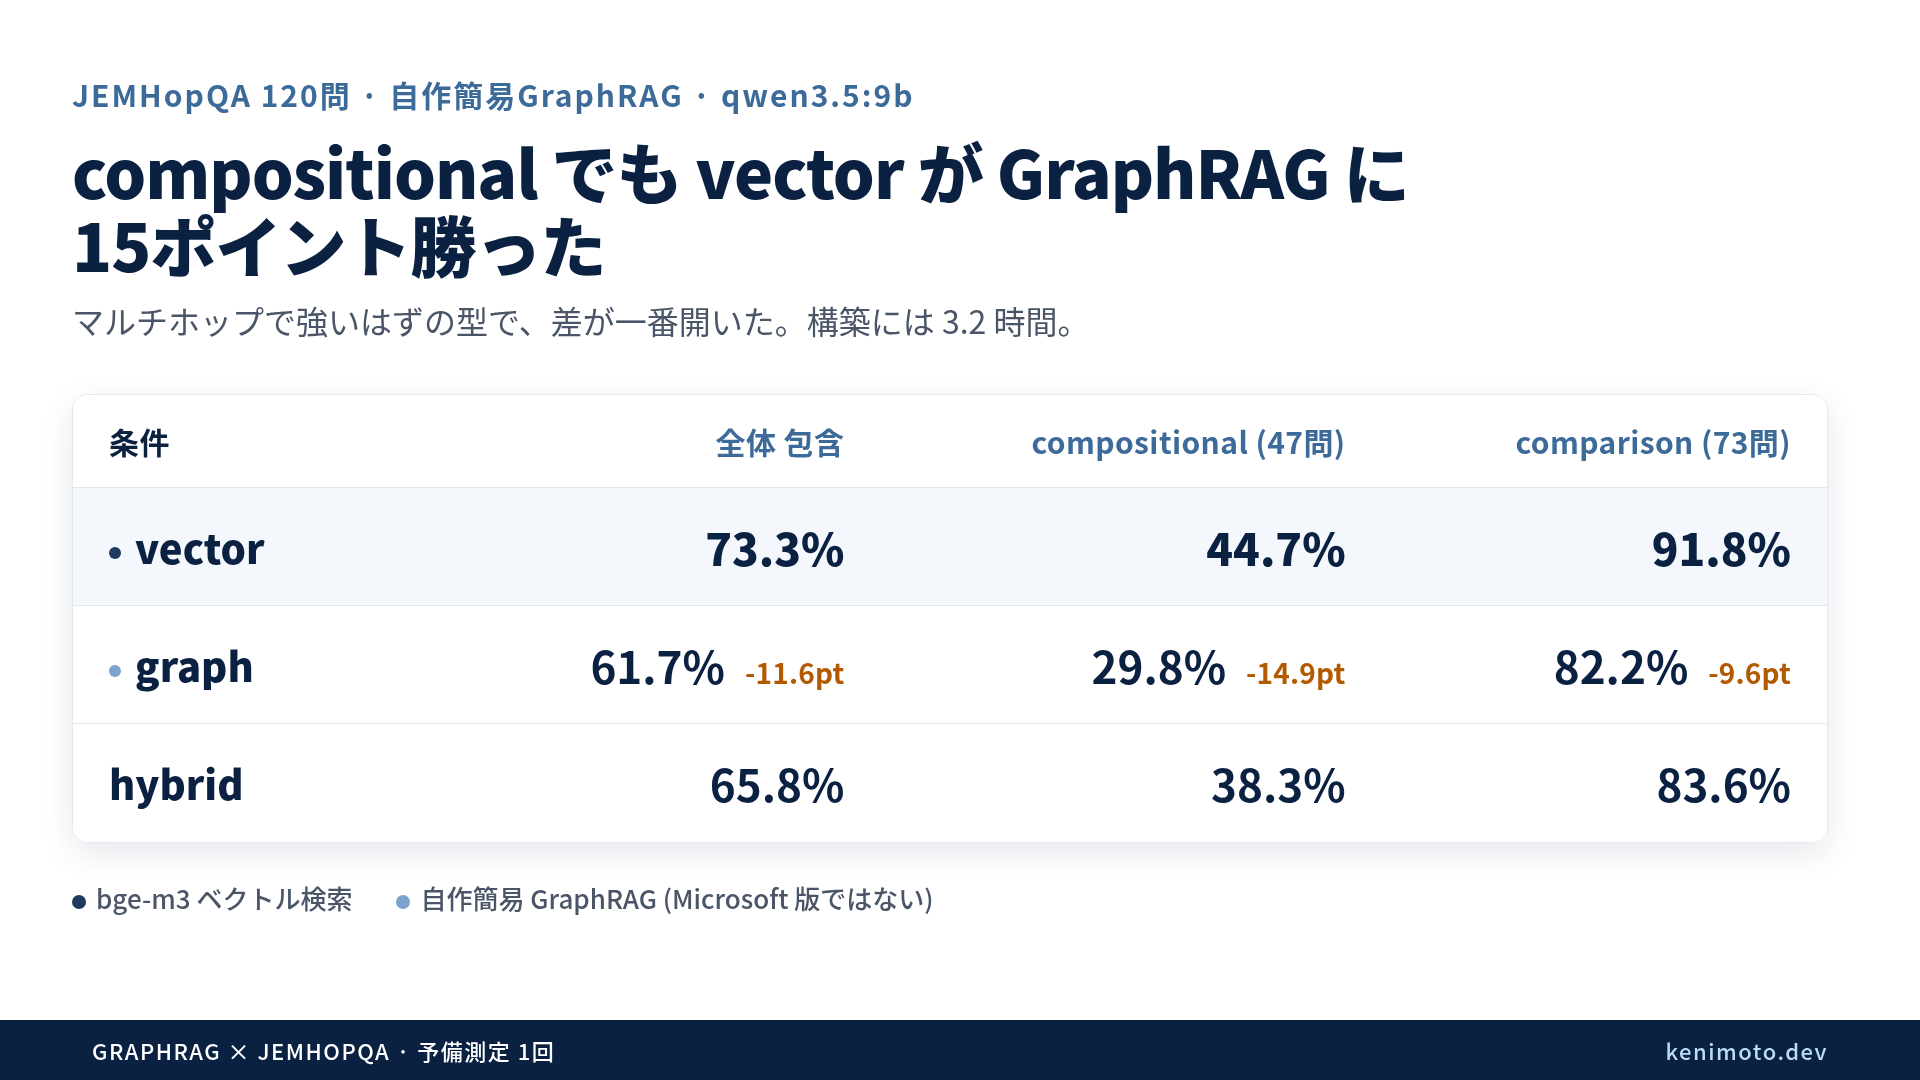
日本語マルチホップQA のベンチマーク JEMHopQA dev 120問 (compositional 47 / comparison 73) を、自作の簡易 GraphRAG と bge-m3 ベクトル検索で通したところ、結果は逆でした。
| 条件 | 包含正解 | compositional 包含 | comparison 包含 |
|---|---|---|---|
| vector | 73.3% | 44.7% (21/47) | 91.8% (67/73) |
| graph | 61.7% | 29.8% (14/47) | 82.2% (60/73) |
| hybrid | 65.8% | 38.3% (18/47) | 83.6% (61/73) |
全体で 11.6 ポイント差。GraphRAG が得意とされるはずの compositional で、差が 15 ポイントに開きました。 comparison は YES/NO が多くて何もせずでも 60% 当たる型なので、ここは差が付きにくい。差が付いたのは compositional のほうで、負けたのも compositional のほうです。
この記事は、1回・1ベンチマーク・自作の簡易 GraphRAG での予備測定です。Microsoft GraphRAG の数字ではありません。限界は最後の節に全部書いてあるので、その前提で読んでください。
compositional でこそ 15ポイント負けた
compositional は「東條英機が死没した施設は、何という戦争の後に設置されましたか?」のような問です。
東條英機の記事から「死没した施設 = 巣鴨拘置所」を取り、巣鴨拘置所の記事から「設置の経緯 = 極東国際軍事裁判 (太平洋戦争後)」を取って、2つをつなぐ必要があります。1記事だけ読んで答えが出ることはありません。
ここは GraphRAG が本来、強いとされる型です。トリプル (主語, 関係, 目的語) で2記事をつなげば、ベクトル検索が苦手な「離れた点どうし」を結べる、というのが Microsoft Research の論文の売りでした。
実測で vector 44.7% / graph 29.8%。自作 GraphRAG は、本来強いはずの型で一番負けました。
vector だけ正解の問が graph の 2.4倍
包含正解の内訳を vector と graph で突き合わせると、こうなります。
| 区分 | 件数 |
|---|---|
| 両方正解 | 64 |
| vector だけ正解 | 24 |
| graph だけ正解 | 10 |
| 両方誤り | 22 |
graph だけが拾えた 10問も、ゼロではありません。ただし vector だけが拾えた 24問の方が 2.4倍 あります。「GraphRAG で拾い直せる問」より「GraphRAG で落ちる問」が多い状態で、全体が11.6ポイント負けました。
3つの失敗型
分かる範囲で失敗を数えました。
1. 2記事目のチャンクが入らない
compositional で「問の関連2記事ともチャンクがコンテキストに入った問」は、graph 19/47、vector 27/47。graph のほうが少ないです。
graph は質問中のエンティティ (多くは記事タイトル) をシードにして近傍トリプルを取りますが、シードに直接つながるトリプル行がコンテキスト予算 (1,000文字ぶん) を埋めてしまい、2ホップ目 (橋渡し先の記事) に届きません。実測では、graph のコンテキスト中のトリプル行の 97.1% がシードの1ホップでした。
東條英機の例だと、近傍候補は 309 件あり、入った 33 行はすべて東條英機の行。巣鴨拘置所の記事に手が届く前に予算が切れています。
2. 表記寄せが粗くノードがつながらない
同じ問で、東條英機の死没地は「日本・東京都豊島区西巣鴨一丁目(巣鴨拘置所)」という1つの長いノードとして抽出されました。一方、巣鴨拘置所の記事側では「巣鴨拘置所」ノードが立っています。この2つは、文字正規化 (NFKC + 記号除去) ではつながりません。
本来は同一エンティティ解決が要るところですが、自作 GraphRAG にはそれが入っていません。Microsoft GraphRAG はコミュニティ検出とエンティティ解決をやるので、同じ落とし穴は多分踏みにくい。私はそれを実装していません、というだけの話です。
3. 並べ替えは効かない
「シードに直接つながる行で予算が埋まるなら、並べ替えて多様性を出せば効くかも」と思って、質問との文字バイグラム重なりでトリプル行を並べ替える変種 (graph_rk) を追加しました。
結果:
- シードに直接つながる行の比率: 97.1% → 92.3% (多様性は少し出た)
- 包含正解: 61.7% → 59.2% (下がった)
- 比較問題で2記事ともチャンクが入った問: 66/73 → 50/73 (大幅に下がった)
並べ替えで入れ替わった行が、答えに必要なキーのある行を押し出したと読めます。「もっと賢く並べ替える」余地はありますが、この予備測定のレベルでは、並べ替えは効きませんでした。
構築コストも 3.2時間
ついでに書くと、構築コストはこうでした。
| 項目 | 値 |
|---|---|
| トリプル抽出の LLM 呼び出し | 2,382 回 |
| 抽出の所要時間 | 11,478.7 秒 (約 3.2 時間) |
| 抽出されたユニークトリプル | 33,124 本 |
| JSON パース失敗 (打ち切り) | 11 回 |
autocrew-pc (RTX 4070 12GB) で qwen3.5:9b を動かした実測です。vector 側の bge-m3 埋め込みは 43.3 秒。ベクトル検索の構築時間の約 265倍 かけて、精度は 11.6ポイント下。
この結果が示さないこと
限界は多いので、実務判断に使う前に全部読んでください。
- 自作の簡易 GraphRAG です。Microsoft GraphRAG / LightRAG などの実装ではありません。コミュニティ要約・エンティティ解決・関係の正規化を入れていません
- 1ベンチマーク・各1回。条件間の差について検定はしていません。数問の差は誤差の範囲でありえます
- qwen3.5:9b 1種類。トリプル抽出も回答も同じ 9B。大きいモデルに変えたら抽出の質が上がり、結果が変わる可能性があります
- Wikipedia の版違い。JEMHopQA は Wikipedia 2021 想定、本測定は 2026-10-24 時点の現行版。記事の改訂で答えの根拠が消えた問があるかもしれません
- コンテキスト上限は 3,000 文字。もっと広くすれば graph 側の 2 ホップ目が入るかもしれません
- 採点は文字列のみ (JEMHopQA 公式の類義語辞書は使っていません)
この測定が言えるのは「自作の簡易 GraphRAG は、JEMHopQA dev 120 問で、同条件のベクトル検索を上回らなかった」までです。「GraphRAG はダメだ」でもなければ、「GraphRAG はマルチホップで弱い」でもありません。
実装前に自分のベンチマークで測る
教訓はひとつだけです。
「マルチホップには GraphRAG」という前提を、自分の実装と自分のベンチマークで確かめる前に本番コードに入れない。
GraphRAG の論文は、Microsoft が VIINA データセットなどで測った結果です。あなたのデータ・あなたのクエリ・あなたの実装で、同じ結果になるとは限りません。少なくとも私の自作簡易 GraphRAG と JEMHopQA の組み合わせでは、ベクトル検索の方が強かった。構築に 3.2 時間かけた上で、です。
JEMHopQA のような公開マルチホップQA ベンチマークを 1 本通せば、2〜3 時間で「自分の実装が vector を超えられるか」の目安が出ます。先に測りましょう。
References
- 実測データ: iris-lab/experiments/048-graphrag-vs-vector-jemhopqa (全条件6種の数値は
results/summary.md、個別回答はresults/answers_*.json) - JEMHopQA dev ver1.2 (120問、CC BY-SA 4.0)
- Microsoft Research GraphRAG 論文 (2024)
- 関連記事: GraphRAG の RDF vs プロパティグラフ、3つの問い
同じ題材で、自作 GraphRAG の構築手順とハマりどころを書籍にまとめています: ナレッジグラフ活用大全
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?