ローカルLLMへ依頼ごとは0/100 手順で分ける
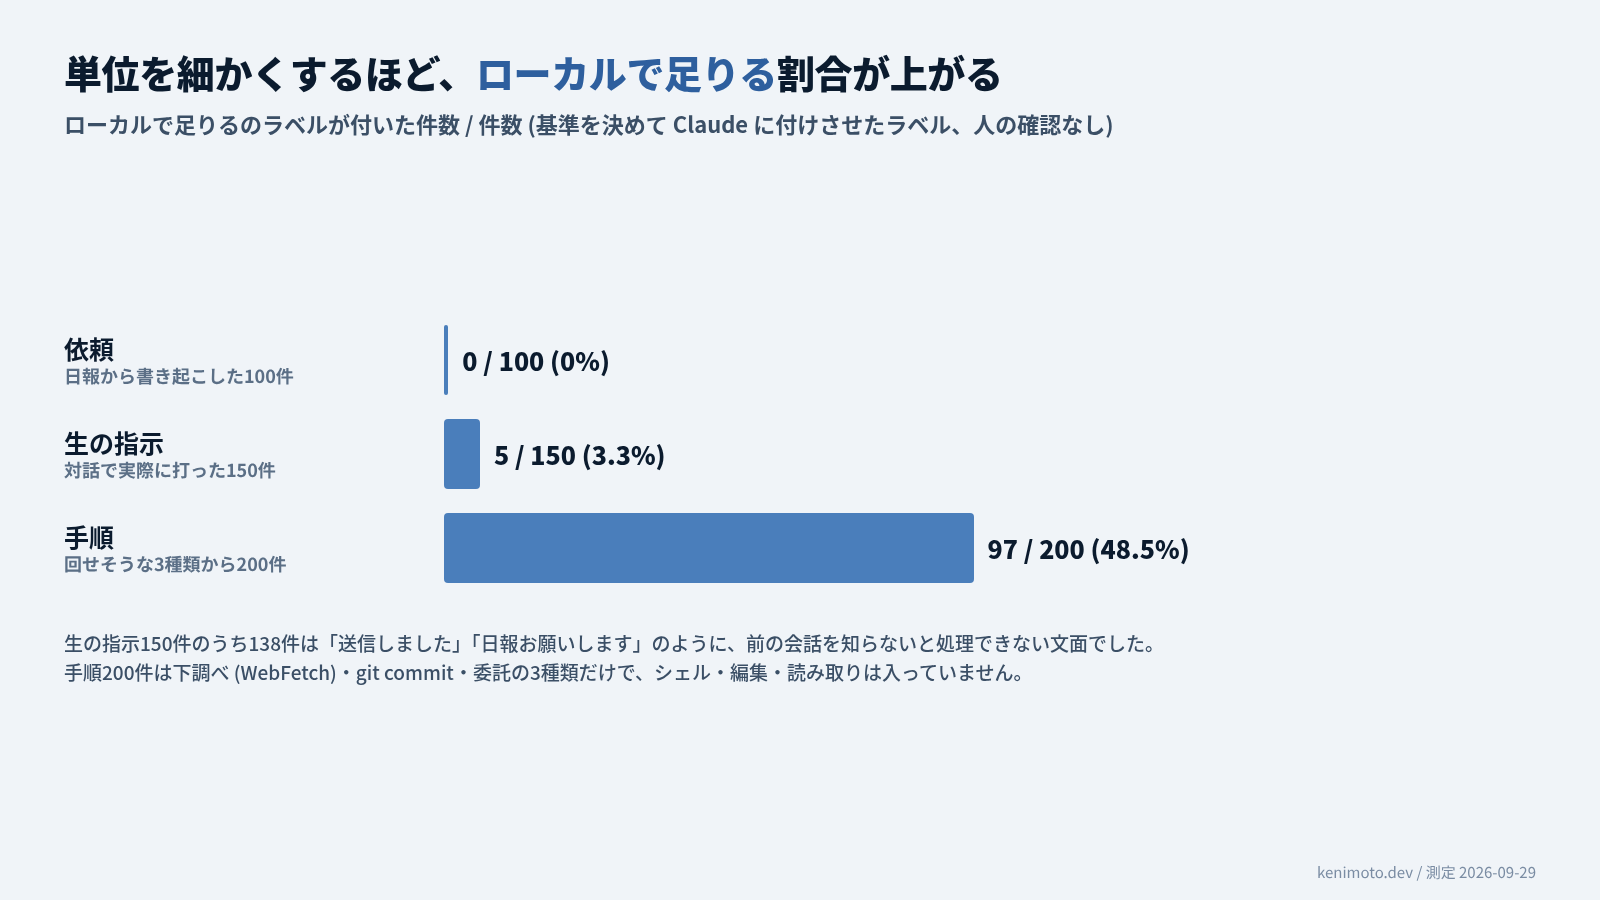
Claude Code に頼んでいる仕事を、手元の GPU で動くローカルLLM に移せないか。日報から書き起こした依頼100件を振り分けてみると、ローカルで足りるものは0件でした。
依頼まるごとでは、ほぼ移せません。依頼の中の1回1回のツール呼び出し (手順) まで分けると、Web ページを読んで答えを抜く下調べや、diff から書く commit メッセージのように、材料の揃った手順が出てきます。そういう回せそうな種類から抜いた200件では、約半分がローカルで足りるというラベルになりました。
ただし、その種類はもともと少数派です。
私の Claude Code の30日分のログでは、ツール呼び出し 52,651回のうち回せそうな種類は 6.5〜17.2% で、料金 ($4,571、API 単価で換算) で見ても 4.3〜11.6% でした。残りは、シェルを叩く・ファイルを編集する・読む・最終回答を書く、といった「次に何をするかを決める」応答です。1回あたりの料金はどの種類もあまり変わらないので、回数の多いそちらに料金も集まります。
依頼と手順
このシリーズでは言葉を2つに分けます。
- 依頼: 人が Claude Code に頼む単位。「この記事の画像を作り直して」「日報お願いします」
- 手順: 依頼の中で起きる1回のツール呼び出しや下請け。下調べ (Web ページを取得して読む手順、Claude Code の WebFetch)、commit メッセージを書く、サブエージェントに調べ物を任せる (委託)
振り分け先は3つです。ローカルで足りる (手元の 9B〜35B のモデルで品質が落ちない)、クラウドに残す (Claude Code のまま)、機密でローカル必須 (外に出せない材料を含む)。
依頼ごとでは0/100
依頼100件の内訳は、クラウドに残す 96件、機密でローカル必須 4件、ローカルで足りる 0件でした。74件は複数のツールを渡り歩くエージェント型の作業で、残りも文章を書く (10件) とコードを書く (9件) が中心です。Claude Code にわざわざ頼む仕事は、最初から重いものが選ばれて来ています。
日報からの書き起こしは、実際の指示より整いすぎています。そこで対話セッションで実際に打った指示 (生の指示) 1,028件からも150件を抜くと、こちらもクラウドに残すが 143件で、138件は前の会話の流れを知らないと処理できない文面でした。
「送信しました」。「日報お願いします」。これだけでは、ローカルのモデルに渡す材料がありません。
回せそうな手順なら約半分
単位を下ろして、会話ログからローカルに回せそうなツール呼び出しを3種類抜きました。下調べ 90件、git commit 50件、サブエージェントへの委託 60件の計200件です。
| 手順の種類 | 抜いた件数 | ローカルで足りる | 機密でローカル必須 | クラウドに残す |
|---|---|---|---|---|
| 下調べ (WebFetch) | 90 | 86 | 0 | 4 |
| git commit | 50 | 10 | 4 | 36 |
| サブエージェントへの委託 | 60 | 1 | 0 | 59 |
| 計 | 200 | 97 (48.5%) | 4 | 99 |
種類で割合がはっきり割れます。下調べはページ本文さえ渡せば中から答えを抜くだけなので、ほぼ全部がローカルで足ります。commit は diff の要約で済むものもある一方、多くは会話の中で決めた変更の意図を書くことになり、ローカル扱いは5件に1件でした。委託は60件中1件です。調べる範囲と返す中身の判断を含むからです。
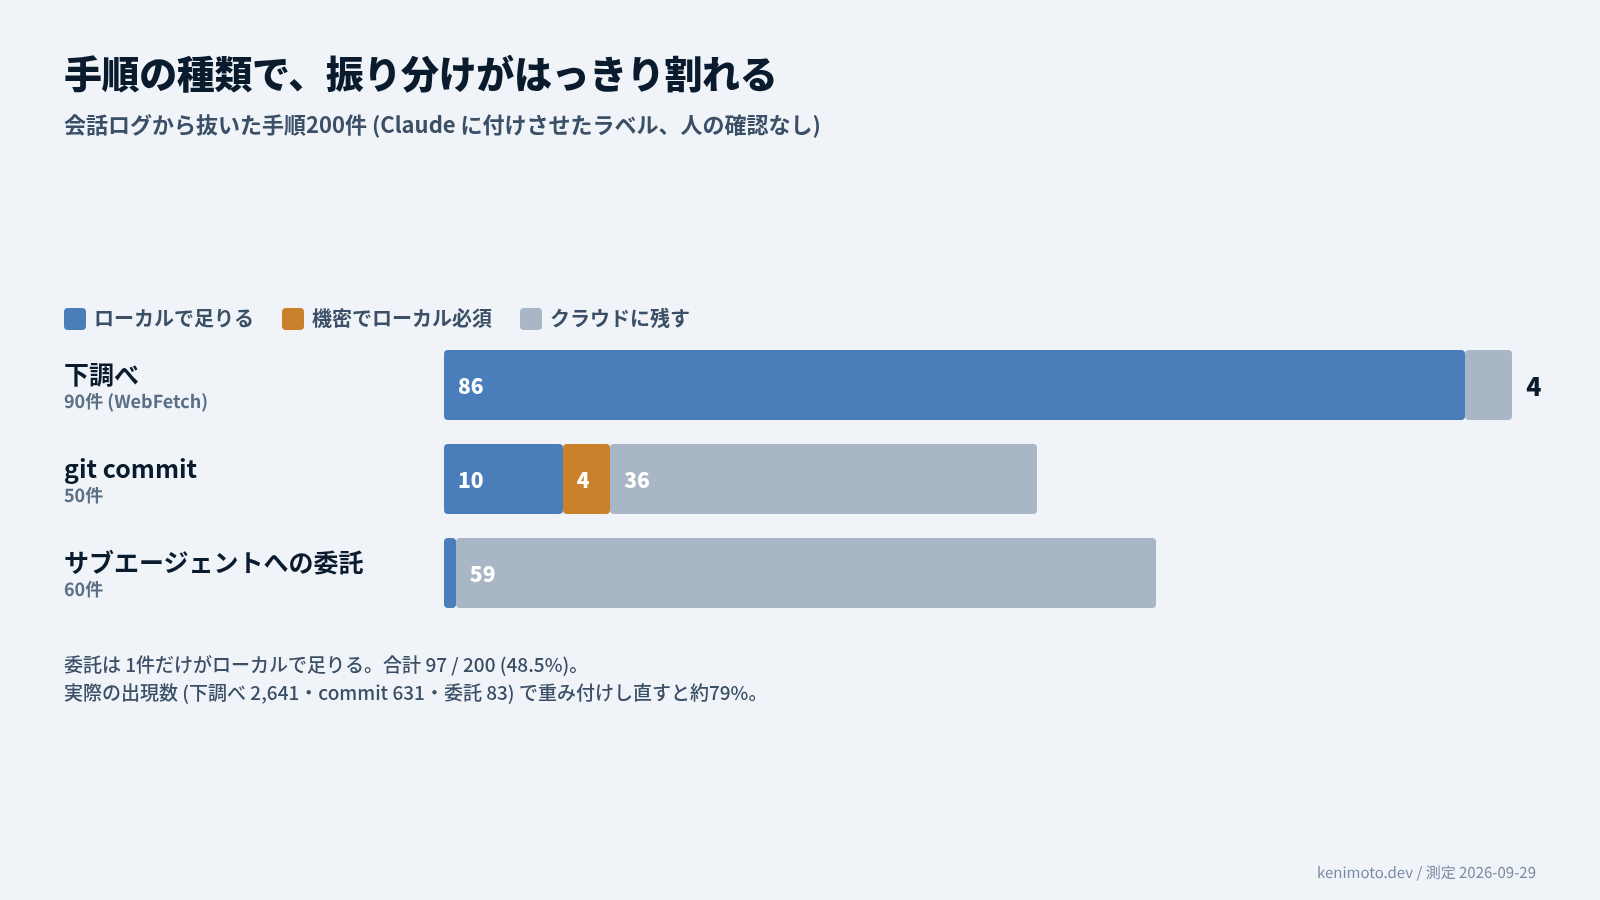
48.5% には条件が2つ付きます。1つは抜き方で、種類ごとに件数を決めて抜いたので、実際の出現数 (下調べ 2,641・commit 631・委託 83) で重み付けし直すと約79%になります。
もう1つのほうが大きく、この200件は最初から回せそうな3種類だけです。シェルの実行やファイルの編集・読み取りは入っていません。
全体で見ると6〜17%
同じ物差しを、30日分のログ全体に当てました。ツール呼び出しは 52,651回あります。
上の表の割合で数える厳しめの線では、ローカルで足りるのは下調べ 3,271回・commit 144回・委託 3回の計 6.5% です。Web 検索 (WebSearch) まで足して、下調べ・Web 検索・commit を全部ローカル扱いにする甘い線でも 17.2% にしかなりません。料金 ($4,571) で数えても 4.3% ($196)〜11.6% ($530) で、回数とほぼ同じ割合でした。
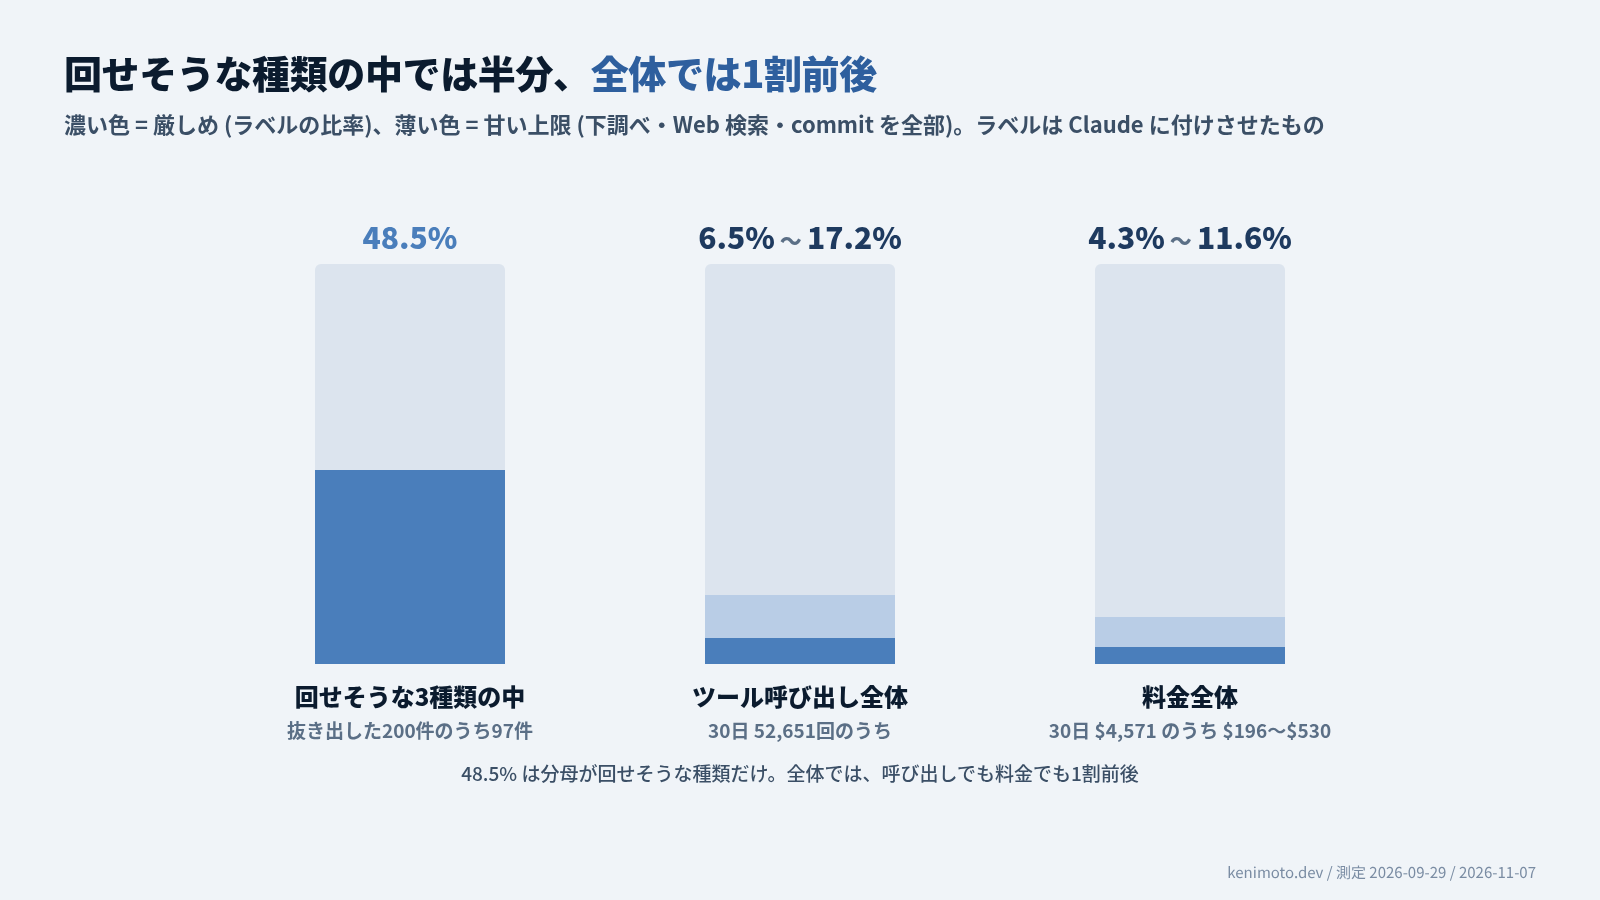
料金のほうも、回数の分け方とそろっています。金額の 36.4% はシェルの実行、16.2% はファイルの編集・書き込み、13.6% はファイルの読み取り、9.9% はツールを呼ばない最終回答の応答に付いていて、どれも会話の全文を抱えたモデルが「次に何をするか」を決める応答です。1回あたりは下調べ $0.056、読み取り $0.081、編集 $0.118 と大差がなく、回数の多い種類に料金が集まっています。
下調べをローカルに回しても、どのページを取るか決める応答と、結果を読んで次を決める応答は Claude Code に残ります。
私の使い方と、読む人の使い方
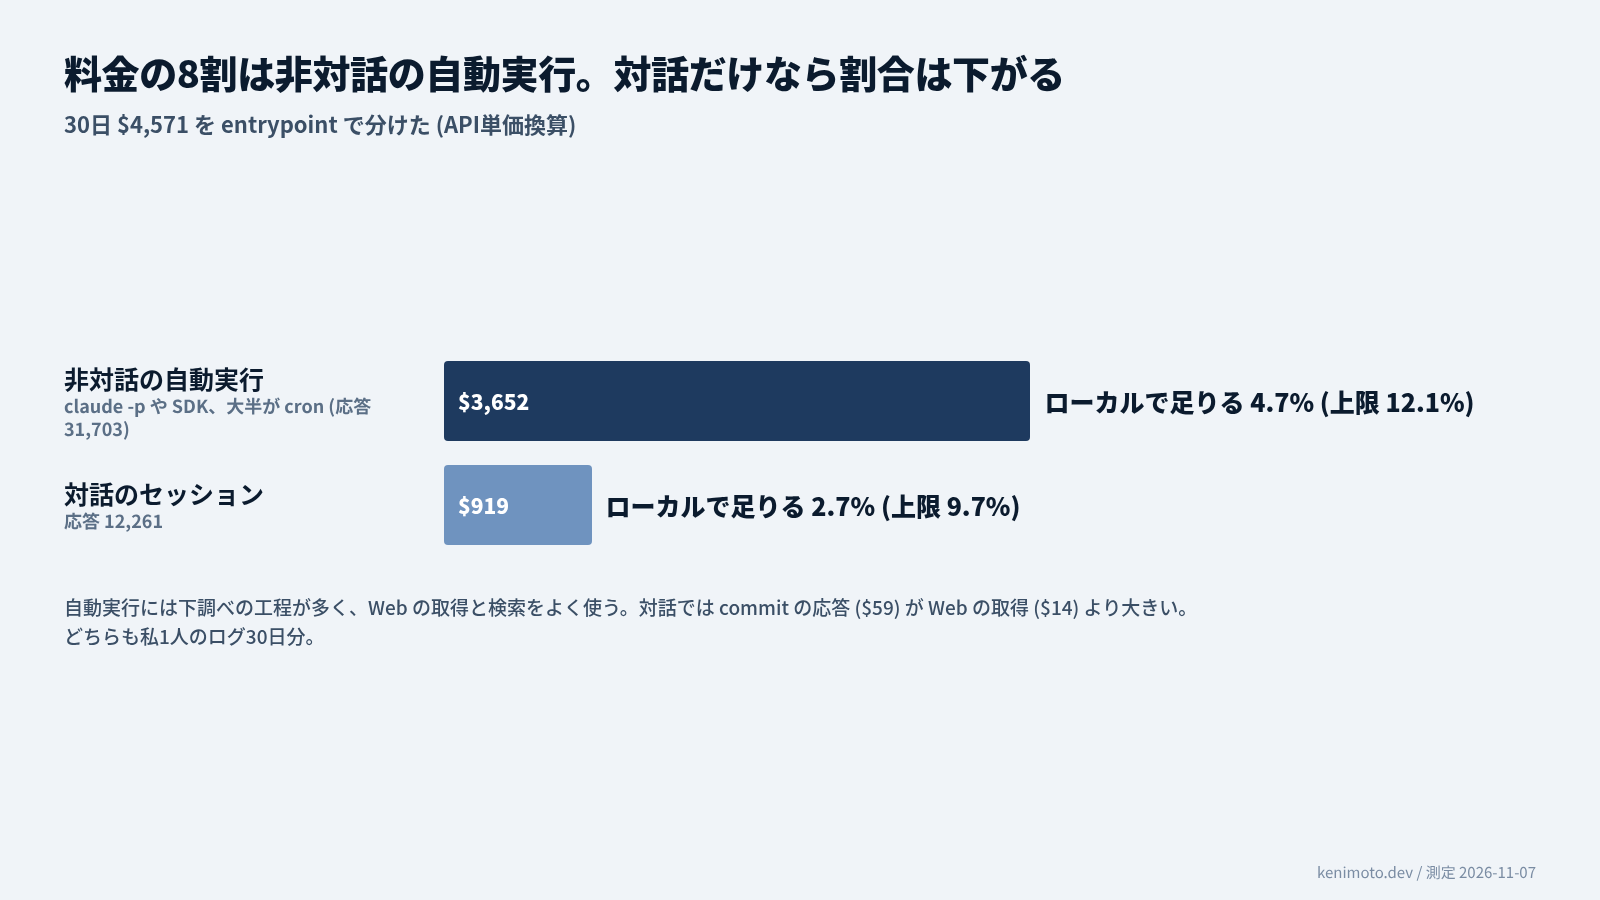
$4,571 のうち $3,652 は、非対話の自動実行 (claude -p や SDK) の分で、その大半 ($3,336) は私が cron で回している処理です。自動実行には下調べの工程が多く、Web の取得と検索をよく使います。対話のセッションだけで数えると、ローカルで足りる手順の割合 (料金) は 2.7% (甘く数えて 9.7%) でした。
対話が中心なら割合は私の数字より低いほうに寄り、調べ物を大量に回すなら上がるはずです。私のログ1人分、30日の数字です。
手順のうちどれが本当にローカルで足りるのかを、9B・35B・Claude に同じ入力を渡して採点したのが ローカルLLMで足りる手順 9Bで要約10/10 です。お金の話を先に読みたい場合は Claude Code料金 ローカルで減るか実測 に進んでください。
 関連書籍 ローカルLLMで足りる仕事、Claude Codeに任せる仕事 依頼の96%はローカルに回せなかった。1ステップずつに下ろすと、半分が回せた 書籍ページを見る →
この記事は役に立ちましたか?