ローカルLLMで足りる手順 9Bで要約10/10
本文と質問を渡して答えを抜く下調べ (Web ページを取得して読む手順、Claude Code の WebFetch) と、文書を渡して要約させる手順は、9B のローカルLLM でも Claude と同じ合格数でした。下調べは3つとも 15/15。要約は3つとも 10/10。commit メッセージは 35B が 10/10 で、9B は 5/10 でしたが、落ちた理由は件名の長さなどの形式だけです。
共通しているのは、材料が渡されていて、何を返すかが決まっていることです。
どのページを取りに行くか、どこまで調べるかはこの手順の外にあり、そちらはクラウドに残ります。ローカルLLMへ依頼ごとは0/100 手順で分ける では、回せそうな手順の約半分に「ローカルで足りる」というラベルが付きました。そのラベルが品質として本当か、9B・35B・Claude に実際に解かせて確かめました。
そろえた条件
3つのモデルに同じ入力を渡し、決めた基準で機械的に採点しました。
| 手順の種類 | 件数 | 渡したもの | 合格の基準 |
|---|---|---|---|
| 下調べ (WebFetch 相当) | 15 | Wikipedia の本文 + 質問 | 本文から正規表現で抜いた正解 (日付・数値・固有名詞) を全部含む |
| 要約 | 10 | Wikipedia の本文 (英語5・日本語5) | 必須の事実6個中4個以上を含み、原文に無い数字を出さない |
| commit メッセージ | 10 | 公開リポジトリの実際の diff | 件名72字以内 + 空行の形式、変更したファイルか識別子に触れる |
| 分類 | 12 | 会話ログの手順 | 依頼ごとは0/100の章 で Claude に付けさせた作業の種類 (9択) と一致 |
下調べの正解を人が書かず本文から正規表現で抜いたのは、採点者の主観を挟まないためです。たとえば Linux の最初の公式版を聞く問いでは、本文の文から「5 October 1991」と「0.02」を取り出し、回答に両方があれば合格にしました。
下調べと要約は3つとも満点
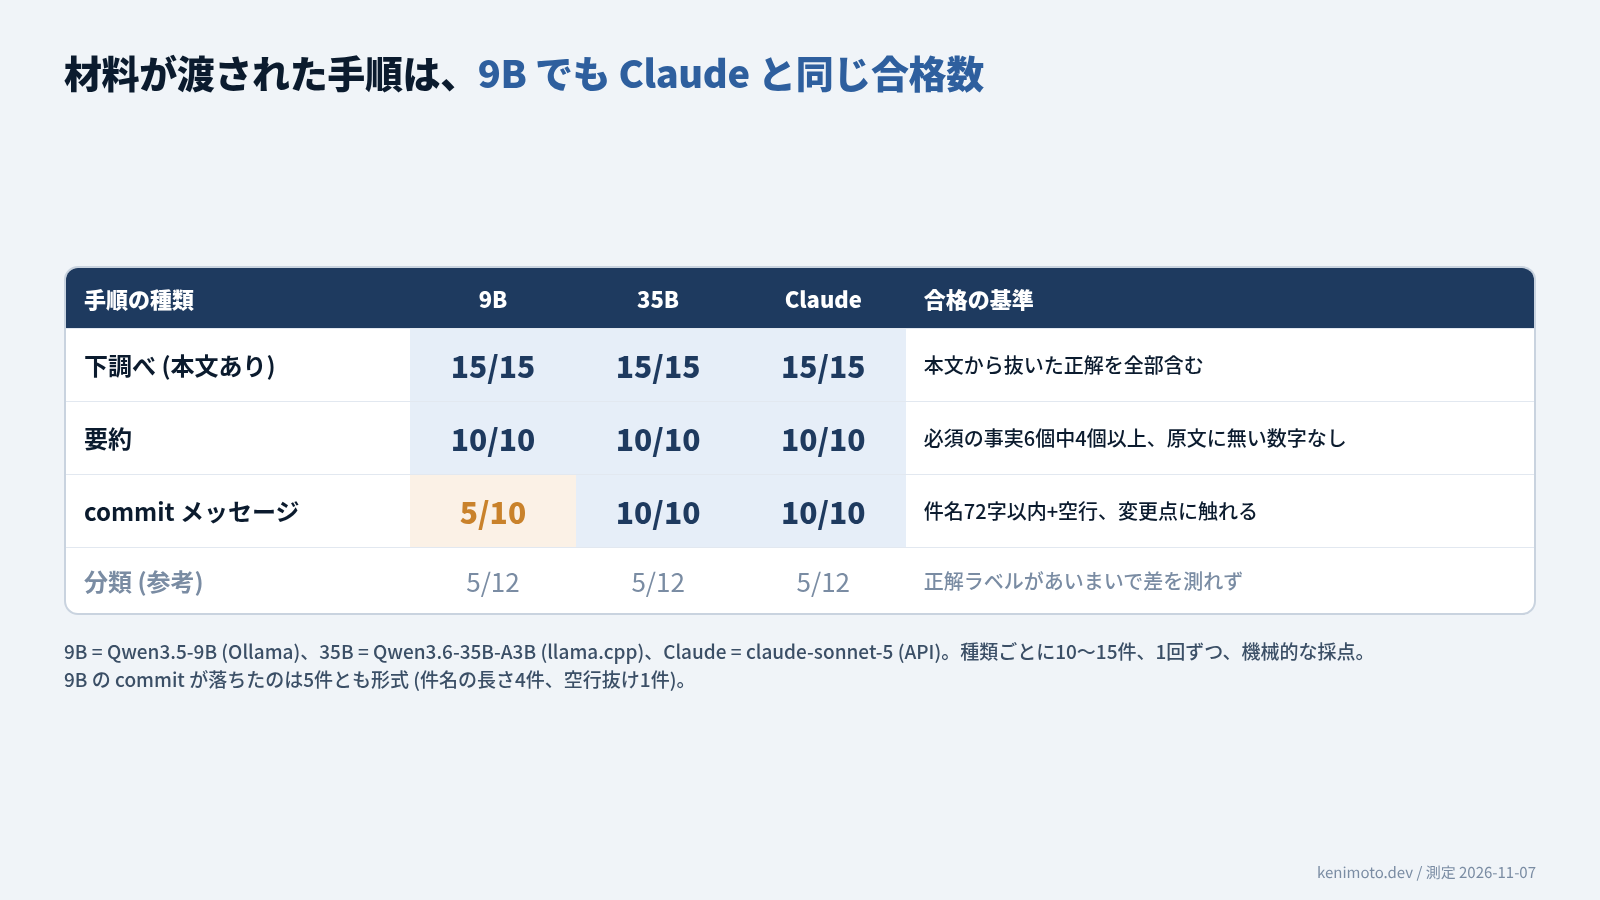
下調べで抜く部品は15問で28個あり、3つとも28個すべてを含みました。要約は必須の事実の含有率が 9B 0.83、35B 0.97、Claude 0.95 で、3つとも原文に無い数字を1件も出していません。
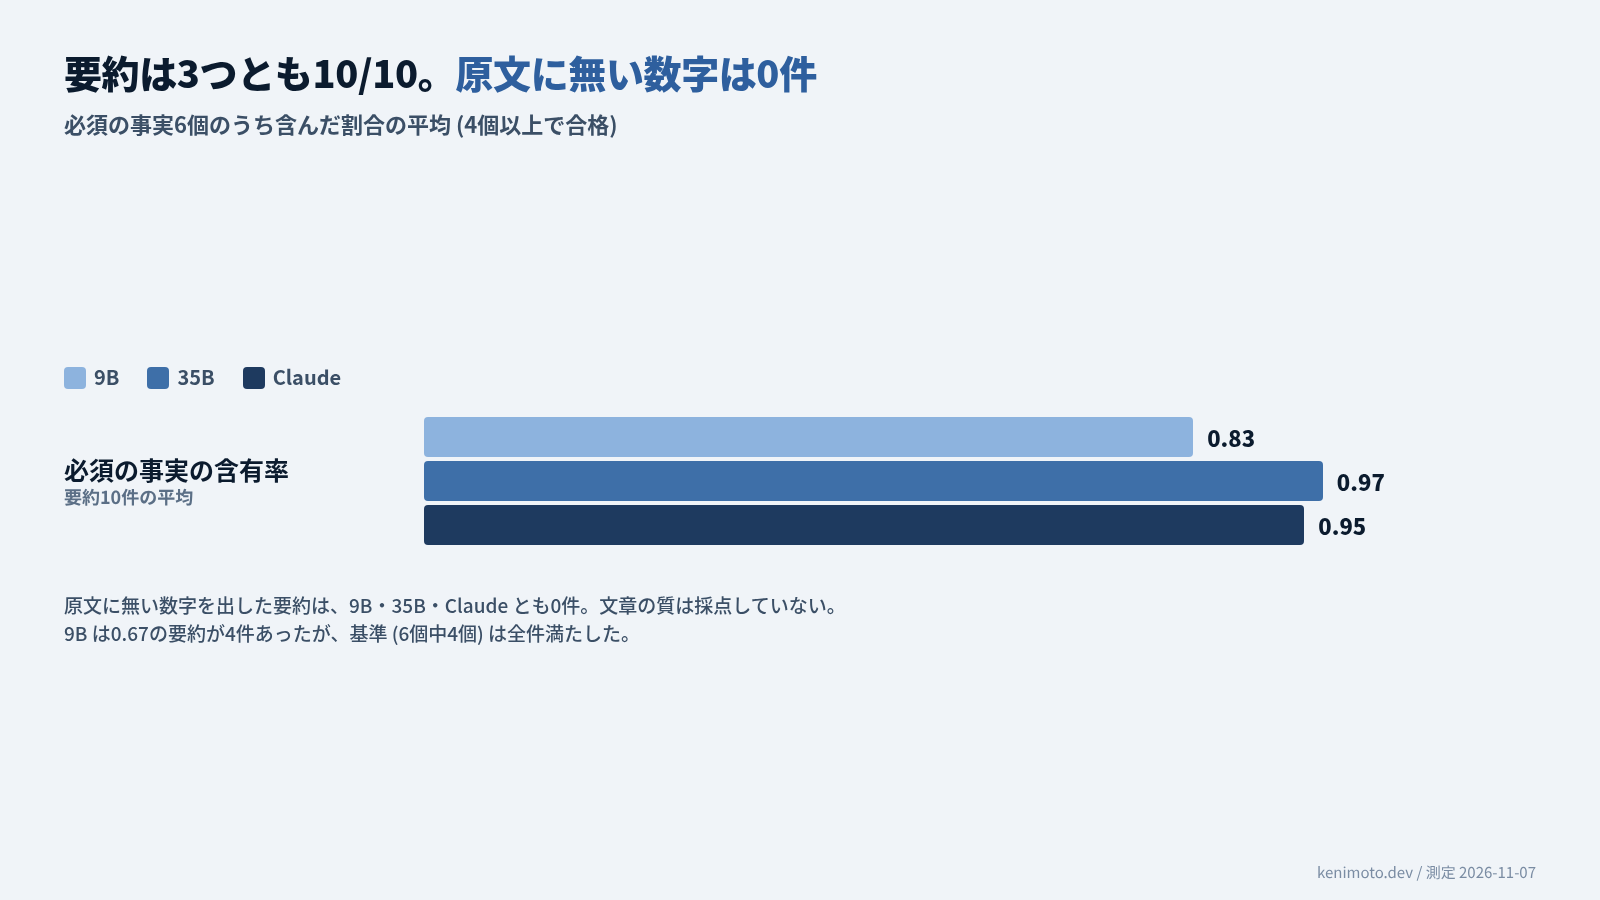
満点がそろったからといって、能力が同じとは限りません。この難しさの課題では全員が上限に届いた、というのが正確なところで、言えるのは本文が渡され抜く項目が決まっていれば 9B で足りる、までです。複数の文書を突き合わせるような難しい要約は測っていません。
commit メッセージは 9B だけ形式で落ちる
9B が落とした5件は、件名が73〜76字だったものが4件、件名のあとの空行が抜けたものが1件でした。変更したファイルや識別子への言及は5件とも基準を満たしています。中身はできていました。
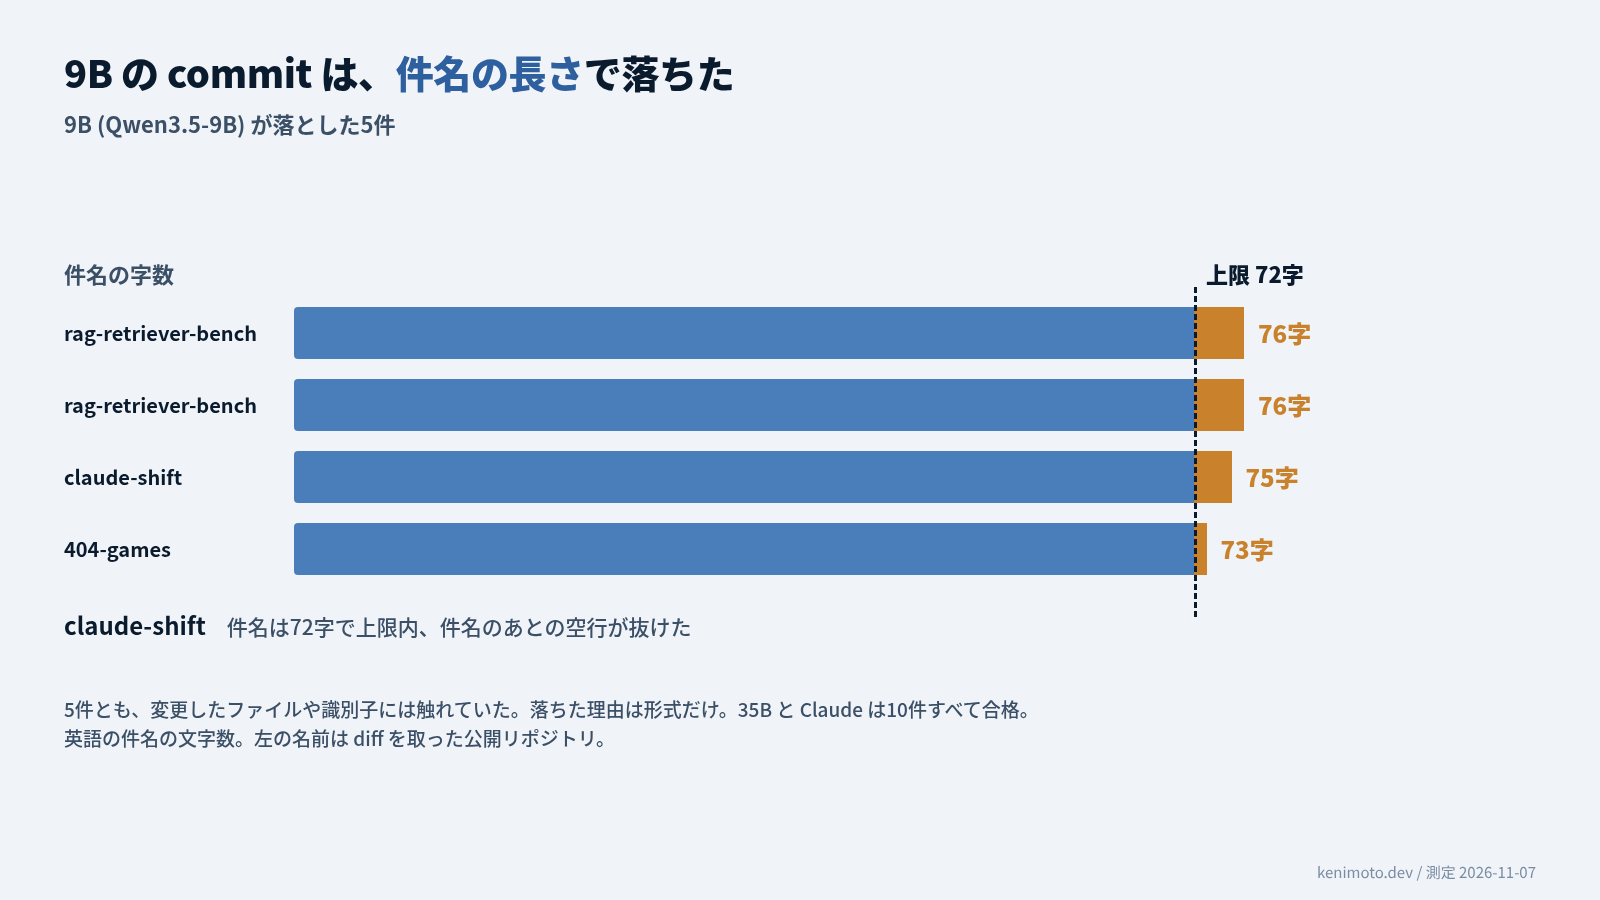
この種類の失敗は、指示に字数を書いたり、出力後に字数を数えて切り直したりすれば防げそうに見えますが、私は直して測り直してはいません。35B は何もしなくても10件すべて形式を守りました。commit を任せるなら 35B が手堅い、と言えるのは形式の面だけです。変更したファイル名に触れた割合は 9B 0.63、35B 0.54、Claude 0.68 で、中身の言及では 9B のほうが多いくらいでした。
分類は測れなかった
分類は3つとも 5/12 でした。12件中4件で3つのモデルが同じ別のラベルを出していて (文章を書く → コードを書く、など)、正解ラベルのほうがあいまいでした。この課題ではモデルの差を測れていないので、結論には使いません。
速さは 9B が Claude と並ぶ
1件あたりの所要時間 (中央値) は、9B が Claude に近い値でした。35B は遅く、下調べで差が開きます。経路は違い、ローカルは手元の PC から Tailscale 経由で GPU の PC へ、Claude はインターネット越しの API です。
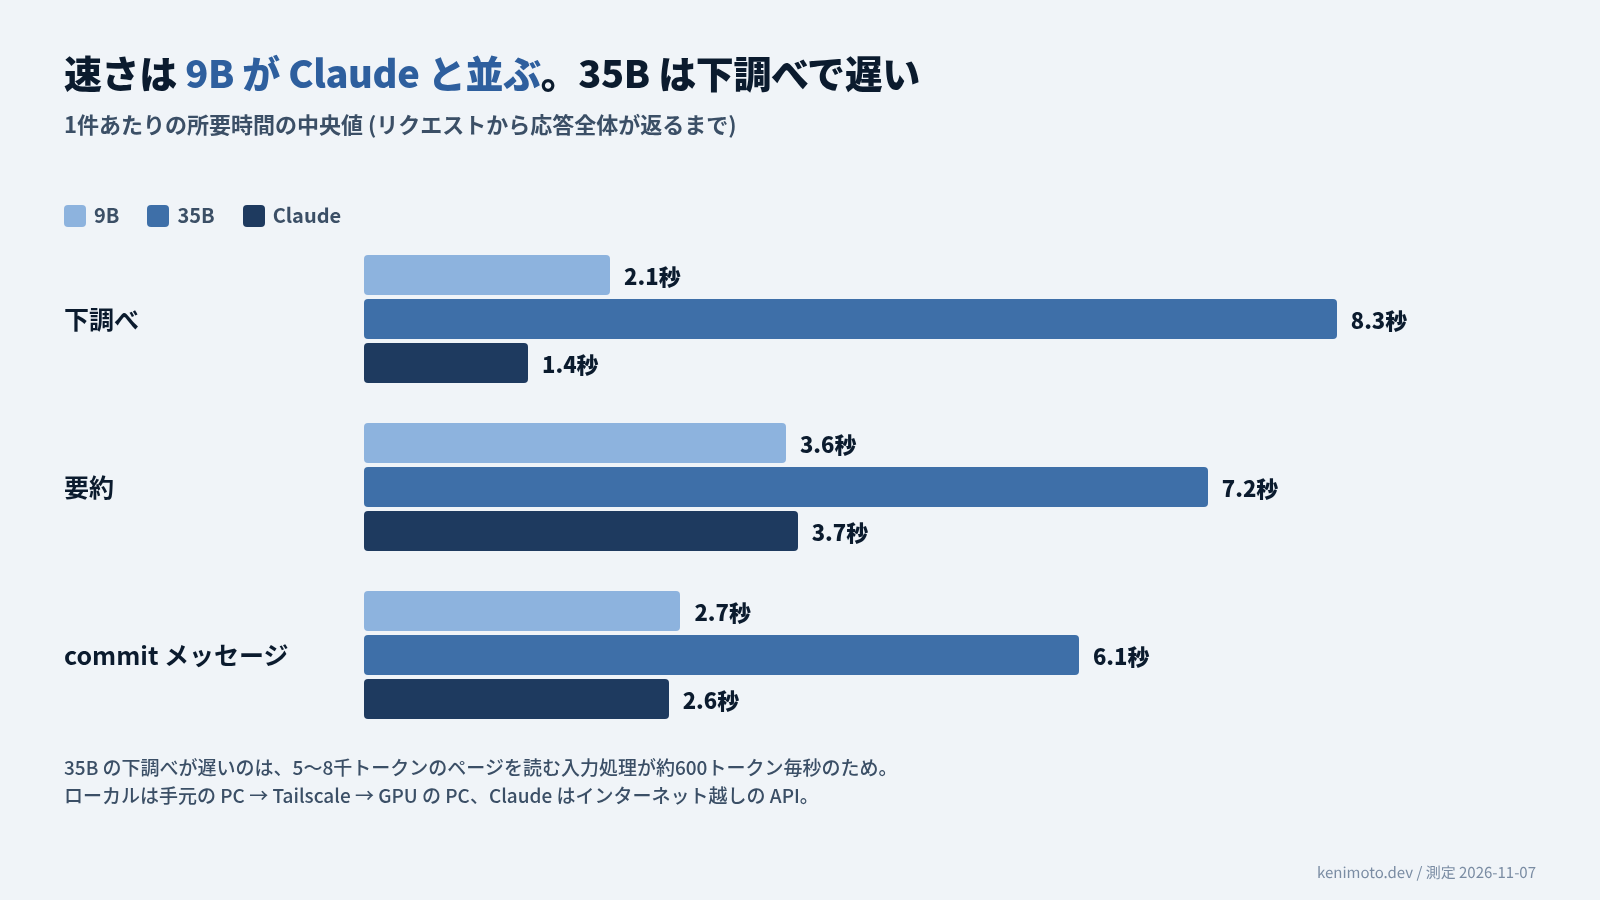
35B の下調べが遅いのは、5〜8千トークンあるページを読む入力処理が約600トークン毎秒しか出ないためです。合格数は同じです。材料が長い手順は 9B に回すほうが速く済みます。35B の速さを上げる設定は ローカルLLMが遅いとき 設定で8→55tok/s にまとめました。
| 手順 | 9B | 35B | 回すなら |
|---|---|---|---|
| 下調べ (本文あり) | 15/15・2.1秒 | 15/15・8.3秒 | 9B |
| 要約 (本文あり) | 10/10・3.6秒 | 10/10・7.2秒 | 9B |
| commit メッセージ | 5/10 (形式) | 10/10 | 35B |
中身の面で差が出た手順は、コード修正だけでした。そちらは ローカルLLMで外れる手順 難しいコード1/3 で扱います。
 関連書籍 ローカルLLMで足りる仕事、Claude Codeに任せる仕事 依頼の96%はローカルに回せなかった。1ステップずつに下ろすと、半分が回せた 書籍ページを見る →
この記事は役に立ちましたか?