スピーカーの声を聞き取りやすく 誤り76→20%
騒がしい場所でスピーカーから話しかける声は、総音量を上げなくても聞き取りやすくできます。 声の総量 (RMS。マスキング効果は帯域で決まるでも使った、音の量の物差し) をそろえたまま、聞き分けに効く高さ (1.5〜4kHz。話し声の帯域の上のほうで、子音の聞き分けに効く) を持ち上げる EQ と、声の小さい部分を持ち上げる圧縮 (コンプレッサー) を両方かけて音声認識に聞かせると、話し声の形をした雑音 (話し声と同じ帯域配分を持つ、言葉を含まない「ザー」という音) の中で、雑音が声の約1.8倍 (S/N 比 -5dB) のときの文字の誤り率 (書き起こしで間違えた文字の割合) は 76.0% から 19.6% に下がりました。元の声を 5dB 大きくしたとき (34.2%) よりも低い値です。
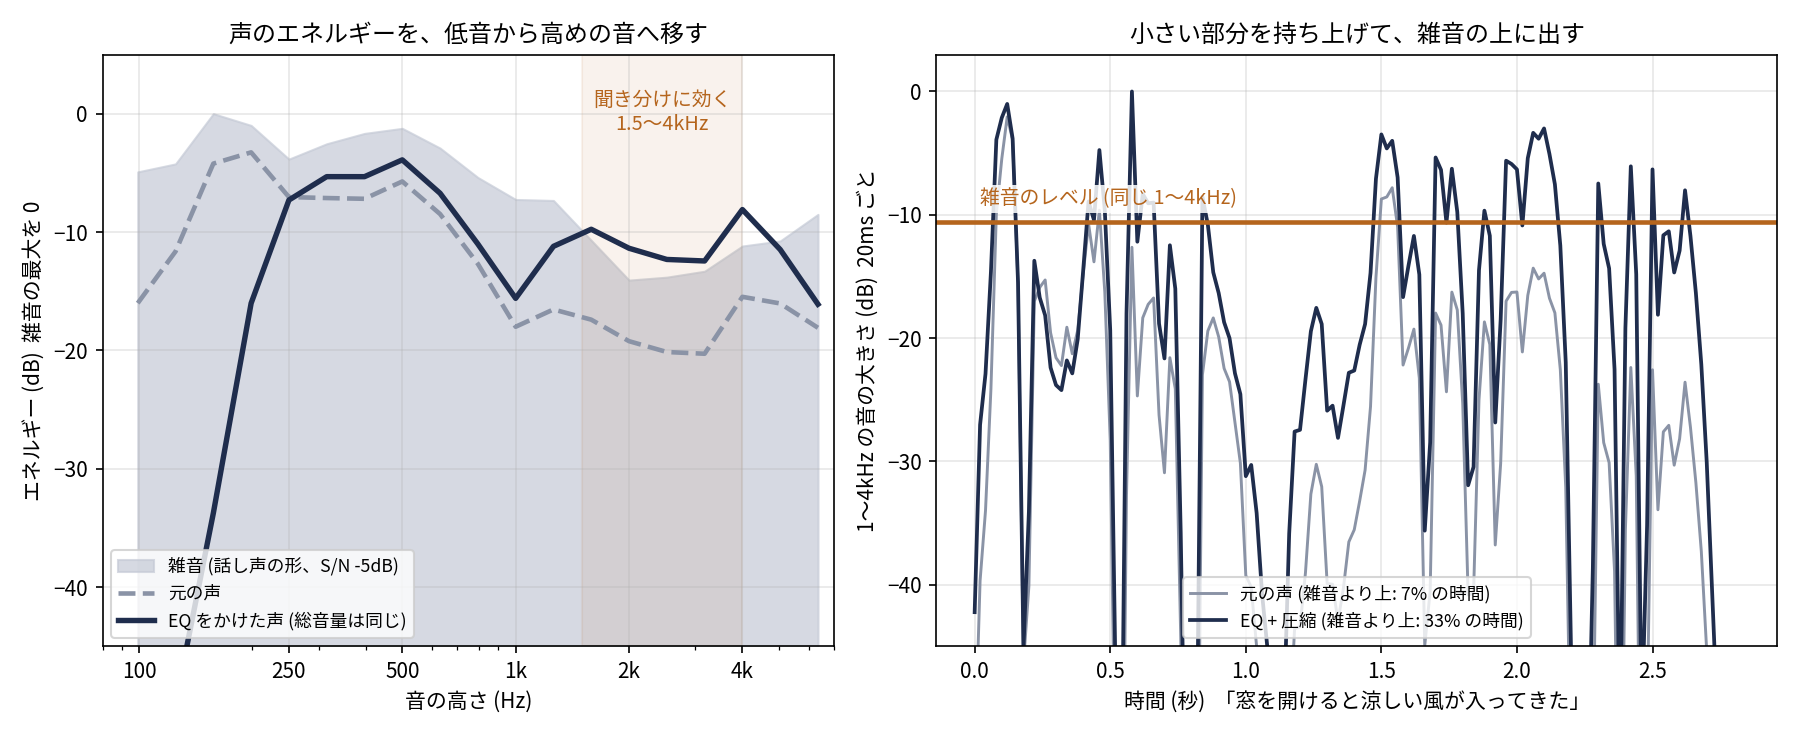
(総量 (RMS) はどれも元の声と同じで、雑音は S/N 比 -5dB、左の EQ をかけた声は 1.5〜4kHz で元の声より平均 7.7dB 大きくなっています)
効いている理由は2つです。雑音と重なりやすい低い音を減らして話し声の帯域に音を回したこと。そして、子音や語尾のように声の中で小さい部分を持ち上げて、雑音に埋もれる前に届くようにしたこと。逆に、ゆっくり話すのはこの測定では逆効果でした。
0.8倍速で読んだ声は、静かなところでは最も正確に書き起こされたのに、4人のざわめきの中では誤り率が 74.1% から 91.7% に悪化しています。
音量を上げずに、何を変えるか
構内放送や店内のアナウンス、スマートスピーカーの呼びかけは、周りがうるさいと埋もれます。まず思いつくのは音量を上げることですが、上げすぎると割れたり、近くの人にはうるさすぎたりします。そこで、音量はそのままで声の形を変える方法を4つ試しました。
| 条件 | やったこと | 現場でいうと |
|---|---|---|
| 元の声 | 何もしない | |
| 聞き分けに効く高さを立てる (EQ) | 250Hz 未満を切り、1.5〜4kHz を 6dB 持ち上げる | 放送用のイコライザー |
| 小さい部分を持ち上げる (圧縮) | 大きい部分がしきい値を超えた分 (dB) を 4分の1 に縮めて、全体をならす | コンプレッサー |
| EQ + 圧縮 | 上の2つを両方 | |
| ゆっくり話す | 同じ文を 0.8倍速で読む | 話し方を変える |
EQ の考え方は、マスキング効果は帯域で決まるで見た「効き目を決めるのは話し声の帯域 (300〜3400Hz) に入る量」の裏返しです。雑音に覆われないためには、声のほうのエネルギーをその帯域に集めればよいはずです。読み上げた声は、エネルギーの半分以上を 300Hz 未満に置いていました。ここを削って、そのぶんを言葉の聞き分けに効く高さに回します。
圧縮で持ち上げたいのは、声の中の小さい部分です。「さ」「た」の子音や文の終わりは、母音よりずっと小さい音です。雑音があると、ここから先に消えていきます。声の大きい部分を縮めてから全体の音量を戻すと、小さい部分が相対的に大きくなります。10ms ごとの音の大きさのばらつき (上位5% と中央の差) は、元の声の 9.4dB から 4.8dB に縮みました。
結果
| 条件 | 邪魔な音なし | 定常ノイズ 0dB | 定常ノイズ -5dB | ざわめき 0dB | ざわめき -5dB |
|---|---|---|---|---|---|
| 元の声 | 4.9 | 34.2 | 76.0 | 74.1 | 91.3 |
| 聞き分けに効く高さを立てる (EQ) | 7.0 | 15.1 | 51.8 | 47.2 | 87.3 |
| 小さい部分を持ち上げる (圧縮) | 4.5 | 13.6 | 50.5 | 46.5 | 88.8 |
| EQ + 圧縮 | 4.4 | 9.6 | 19.6 | 28.9 | 77.2 |
| ゆっくり話す | 3.4 | 46.9 | 80.0 | 91.7 | 97.8 |
(文字の誤り率 %、20 文の平均。「定常ノイズ」は話し声の形の定常ノイズ、「ざわめき」は4人。S/N 比 -10dB はどの条件も 80% を超えたので表から省いています)
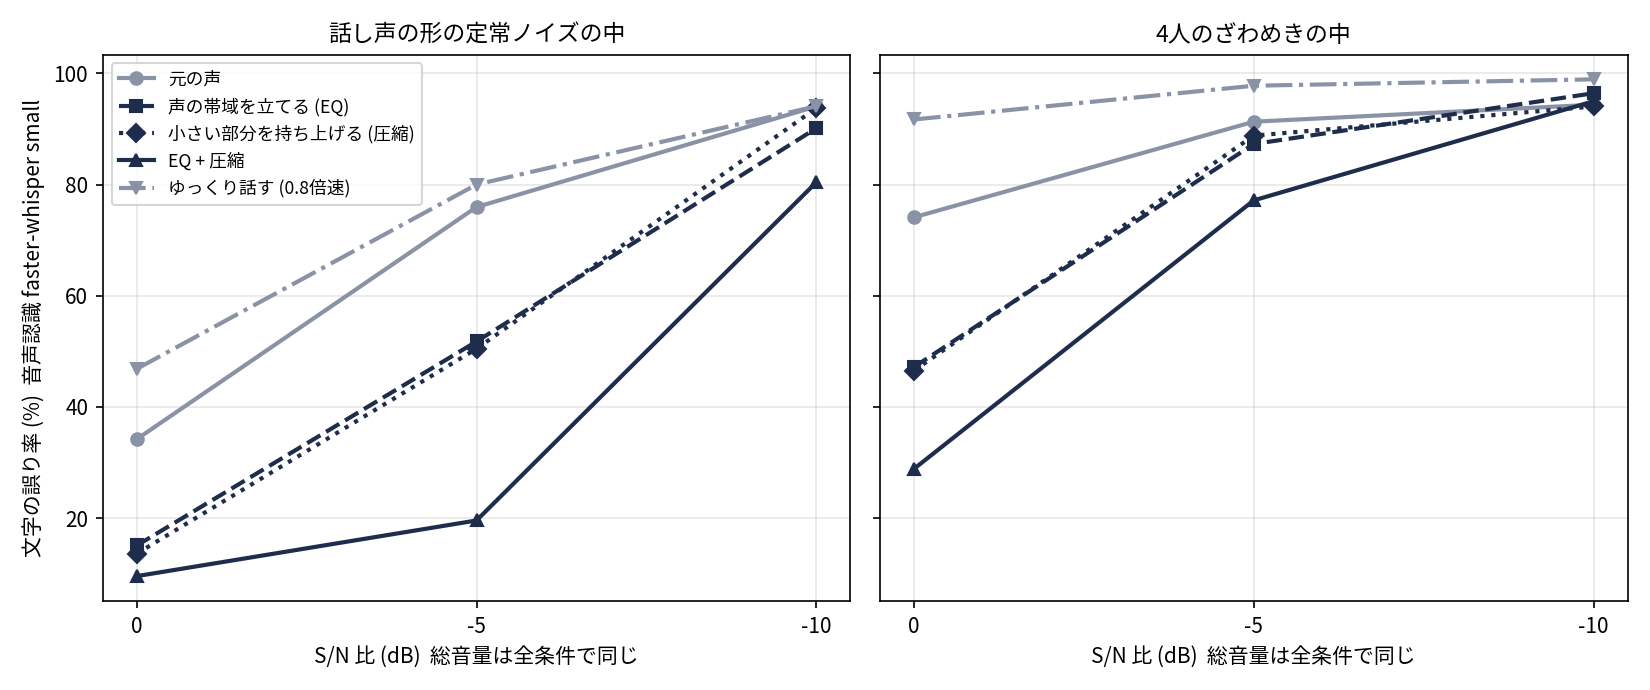
(図は音声認識に聞かせて測った結果です。聞き手は人ではありません)
EQ だけ、圧縮だけでも、定常ノイズ 0dB での誤り率は半分以下になりました。
2つを重ねると、さらに下がります。定常ノイズ -5dB の 19.6% は、元の声を 5dB 大きくしたとき (0dB で 34.2%) より低い値です。定常ノイズの中では、音量を 5dB 上げる以上の効き目が、総音量を上げずに出ています。 騒音計の A 特性で見ても、加工で大きく出る分は約 3.3dB なので、5dB の音量アップより小さい変化で上回ったことになります。
1つの文で追うとこうなります。「窓を開けると涼しい風が入ってきた」を、4人のざわめきの中 (0dB) で流した書き起こしです。
| 声 | 書き起こし |
|---|---|
| 元の声 | まぼう、ラケットはサイク、シーカーザーが入ってきた |
| EQ + 圧縮 | 窓を開けると涼しい風が入ってきた |
| ゆっくり話す | (何も書き起こされなかった) |
ざわめきの中では効き目が小さくなり、-5dB では EQ + 圧縮でも 77.2% でした。周りの話し声は同じ帯域に音を持っているので、帯域を寄せるだけでは逃げ切れません。
ざわめきの中では、カクテルパーティー効果 声の違いで誤り58→29%で見た「周りと違う声で話す」ことが、もう1つの手がかりになるはずです。ただしそこで測ったのは、邪魔な声が1人の場合です。大勢のざわめきの中で効くかは推論です。
ゆっくり話すのは、この測定では逆効果
ゆっくり話した声は、静かなところでは誤り率 3.4% と5つの中で最もよかったのに、雑音の中ではどれよりも悪くなりました。4人のざわめき 0dB では、20 文のうち5文で書き起こしが空になっています (元の声では1文)。
人の研究でも、話す速さだけを落とした声は、定常的な雑音の中では聞き取りやすくならなかったと報告されています (Cooke & Aubanel 2017)。ただし同じ研究で、音量が上下する雑音の中では改善していました。この測定でざわめきの中で大きく悪化したのは、人とは違う、音声認識の側の性質かもしれません。また、読み上げの速さを変えると声の質も少し変わるので、「ゆっくりだから悪くなった」と言い切ることもできません。
言えるのは、ゆっくり話すことは、帯域や圧縮のような確かな効き目を持っていなかったということです。はっきり話した声が聞き取りやすいのは、ゆっくりになるからだけではない、という人の研究の結論とも矛盾しません。
この章では測っていない技術
ここからは、この章の測定では確かめていない方法です。論文と規格から引いていて、STI の基準値だけは測定器メーカーの技術資料 (二次資料) によります。
音を相手の方向だけに届ける。 指向性スピーカー (パラメトリックスピーカー) は、声で振幅を変えた超音波を出し、空気の中で超音波が可聴音に戻る性質を使って、ごく狭い範囲にだけ音を届けます (Westervelt 1963 が原理、Yoneyama ら 1983 が可聴音のスピーカーとして実現)。周りの人には聞こえにくいまま狙った場所に音を集められるので、声を大きくする代わりに、届け先を絞って S/N 比を稼ぐ方法です。
(イメージ図です。画像生成 AI で作りました。実際の指向性スピーカーの音の束は目に見えません)
最初に相手の名前を呼ぶ。 自分の名前は、ほかの話に注意を向けているときでも気づきやすい音です。Moray (1959) は、無視している側の耳から入った話の中で、気づかれたのは本人の名前だけだったと報告しています。ただし気づいた人の割合は高くなく、Wood & Cowan (1995) の追試では 34.6%、事前登録した追試 (Röer & Cowan 2021) では 29% でした。名前を呼べば必ず気づく、とは言えません。
毎回同じ声、同じ前置きで始める。 カクテルパーティー効果 声の違いで誤り58→29%で見たとおり、人はどの声を聞くかが先に分かっていると聞き取りが上がります。これはカクテルパーティー効果の章の結果から私が引いた推論で、放送の声をそろえた効果を測った研究までは確かめていません。
明瞭度を測る。 放送の聞き取りやすさには STI (音声伝送指数) という 0〜1 の指標があり、IEC 60268-16 が測り方を定めています (Steeneken & Houtgast 1980 が元になった研究)。規格そのものは合否の線を定めていませんが、非常放送の規格 ISO 7240-19 では平均 0.50 以上、最低 0.45 が求められていると、測定器メーカーの技術資料 (NTi Audio) は説明しています。
話しかける前に見るところ
| やること | この章の測定での効き目 | 根拠 |
|---|---|---|
| 低音を切り、1.5〜4kHz を持ち上げる | 定常ノイズ 0dB で誤り率 34% → 15% | 測定、人のロンバード効果の研究 |
| 圧縮で小さい部分を持ち上げる | 定常ノイズ 0dB で 34% → 14% | 測定、Hurricane Challenge |
| 両方かける | 定常ノイズ -5dB で 76% → 20%。定常ノイズでは音量を 5dB 上げるより効く | 測定 |
| 周りの話し声と違う声を選ぶ | 邪魔な声が1人なら、同じ声より誤り率が約半分 (カクテルパーティー効果の章) | 測定、Brungart 2001 |
| ゆっくり話す | 雑音の中では逆効果 | 測定 |
| 相手の方向だけに届ける | (測っていない) | 論文 |
| 名前を呼ぶ | (測っていない) 気づくのは約3割 | 論文 |
最初に手を付けるなら EQ と圧縮で、音量のつまみは後回しにします。EQ もコンプレッサーも音声用のミキサーによくある機能で、総音量を上げずに試せます。
この章が言えないこと
聞き手は音声認識 (faster-whisper small) です。人を聞き手にした研究とは向きがそろっている部分もありますが、この章の数字をそのまま人に当てはめることはできません。とくにゆっくり話す条件は、人と音声認識で結果が分かれる可能性があります。
声は雑音のない読み上げ音声で、スピーカーから出して部屋で響いた音は測っていません。反響の多い駅や体育館では、圧縮で持ち上げた小さい部分が反響に埋もれることもあり、効き目は変わります。EQ と圧縮の設定は1通りしか試していません。EQ をかけた声は、邪魔な音のないところでは誤り率が 4.9% から 7.0% に少し上がりました。低い音を大きく削った声は、静かな場所ではかえって不自然に聞こえる場合があります。
この章で分かったこと
| 元の声 | EQ | 圧縮 | EQ + 圧縮 | ゆっくり話す | |
|---|---|---|---|---|---|
| 邪魔な音なし | 4.9% | 7.0% | 4.5% | 4.4% | 3.4% |
| 定常ノイズ 0dB | 34.2% | 15.1% | 13.6% | 9.6% | 46.9% |
| 定常ノイズ -5dB | 76.0% | 51.8% | 50.5% | 19.6% | 80.0% |
| 4人のざわめき 0dB | 74.1% | 47.2% | 46.5% | 28.9% | 91.7% |
スピーカーから話しかける声を埋もれさせないために、まず変えるのは声の形です。雑音と重なる低い音を減らして話し声の帯域に寄せ、小さい部分を持ち上げると、総音量は同じまま、定常ノイズの中では音量を 5dB 上げるより聞き取りやすくなりました。 周りが人の話し声なら、周りと違う声を選ぶことも試す価値があります。
この記事は役に立ちましたか?