カクテルパーティー効果 声の違いで誤り58→29%
カクテルパーティー効果は、大勢が同時に話している中で、聞きたい1人の声を選んで聞き取れる人の能力です。手がかりは声の来る方向、口の動き、声の違い、話の筋とされていて、このうち声の違いだけを取り出して音声認識に聞かせました。聞かせたい声に別の声を同じ大きさで重ねると、邪魔な声が別の人の声なら文字の誤り率 (書き起こしで間違えた文字の割合) は 28.7%、同じ人の声なら 58.3% です。声が違うだけで、誤りは約半分になりました。
一方で、音声認識はどちらの声を聞くかを選べません。 邪魔な別の声を約1.8倍 (5dB) 大きくすると、音声認識は 20 文すべてで邪魔な側の文を書き起こしました。人を聞き手にした実験では、聞き手はどちらが聞くべき文かを分かったうえで聞いていて、邪魔な声のほうが大きくなっても成績はおおむね横ばいでした。聞きたい1人を選ぶ力は、声を区別する力とは別のところにあるようです。
カクテルパーティー効果とは
パーティー会場のように大勢が同時に話している中でも、人は目の前の1人の話を追えますが、これを最初に実験の問題として立てたのが E. C. Cherry の 1953 年の論文で、「カクテルパーティー」という呼び名もここから来ています。
how do we recognize what one person is saying when others are speaking at the same time (the “cocktail party problem”)?
(ほかの人が同時に話しているときに、1人の話していることをどうやって聞き取っているのか。これを「カクテルパーティー問題」と呼ぶ)
— E. C. Cherry, “Some Experiments on the Recognition of Speech, with One and with Two Ears”, J. Acoust. Soc. Am. 25(5), 975-979 (1953)
Cherry は聞き分けの手がかりになりそうなものとして、声の来る方向、口の動きや身振り、声の違い (平均の高さ、話す速さ、男女)、訛り、話の筋のつながりを挙げています。そのうえで、同じ話者が読んだ2つの文を1本のテープに重ねて聞かせるという、方向も声の違いも使えない実験をしました。結果は「バベルの塔のような」混ざった音でしたが、それでも聞き手はテープを何度も聞き直しながら2つの文を分けられました。残っていた手がかりは話の筋だけです。
方向と口の動きは1本の音声ファイルを耳も目も持たずに聞く音声認識には最初から届かないので、この章では手がかりのうち声の違いだけを取り出して測ります。
マスキング効果は帯域で決まるとブラウンノイズで測ったのは、同じ高さの音で話し声を塗りつぶすマスキングでした。邪魔な音が言葉になると、音としては聞こえているのに、どれが聞きたい声か分からなくなるという、もう1種類のマスキングが加わります (後半のコラムで説明します)。
6種類の邪魔な音
聞かせたい声 (声 alloy が読む 20 文) に、次の6種類を重ねました。
| 条件 | 中身 |
|---|---|
| 話し声の形の定常ノイズ | 邪魔な側の話し声と同じ高さの配分を持つ「ザー」という雑音。言葉は含まない |
| 別の声 1人 | 別の声 (onyx) が別の文を読む |
| 同じ声 1人 | 聞かせたい声と同じ alloy が別の文を読む |
| ざわめき 2人 / 4人 / 8人 | 別の声の人たちが、それぞれ別の文を同時に読む |
邪魔な側の文は「来週の火曜日に歯医者の予約を入れました」「庭のトマトがようやく赤くなってきた」のような、聞かせたい文と無関係な日常の文 20 本です。定常ノイズは、マスキング効果は帯域で決まるで見た「話し声の帯域にどれだけ入るか」を話し声とそろえるために、話し声から作っています。
結果
| S/N 比 | +10 | +5 | 0 | -5 | -10 |
|---|---|---|---|---|---|
| 話し声の形の定常ノイズ | 6.3 | 15.2 | 37.2 | 75.6 | 94.1 |
| 別の声 1人 | 5.4 | 10.0 | 28.7 | 96.3 | 97.1 |
| 同じ声 1人 | 5.4 | 27.6 | 58.3 | 81.0 | 91.1 |
| ざわめき 2人 | 8.3 | 20.4 | 65.9 | 92.2 | 95.6 |
| ざわめき 4人 | 8.6 | 31.7 | 74.9 | 94.0 | 93.5 |
| ざわめき 8人 | 12.5 | 18.2 | 78.7 | 96.3 | 95.5 |
(文字の誤り率 %、20 文の平均。邪魔な音なしは 4.9%。S/N 比 0dB は聞かせたい声と邪魔な音が同じ大きさ、-5dB は邪魔な音が約1.8倍)
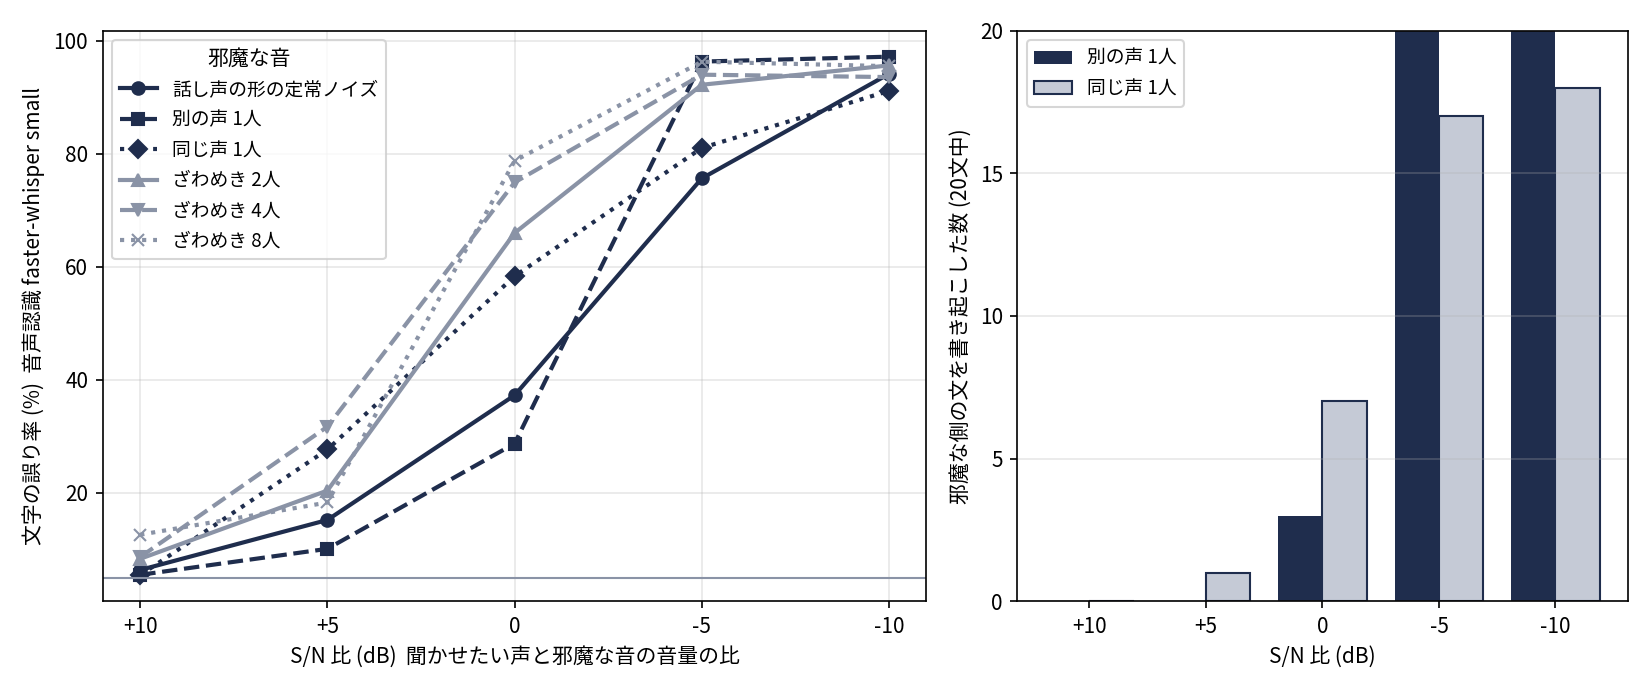
(図は音声認識に聞かせて測った結果です。聞き手は人ではありません)
読み取れることは3つあります。
声が違うと、誤りは半分になる
同じ大きさ (S/N 比 0dB) で重ねたときの誤り率は、別の声で 28.7%、同じ声で 58.3% です。聞かせたい声のほうが少し大きい +5dB でも 10.0% と 27.6% で、差は同じ向きに開いています。
1つの文で追うとこうなります。「窓を開けると涼しい風が入ってきた」に、邪魔な声を同じ大きさ (0dB) で重ねた書き起こしです。
| 邪魔な声 | 書き起こし |
|---|---|
| 別の声 1人 | 窓を開けると涼しい風が入ってきた |
| 同じ声 1人 | 窓を開けると、ギターの練習が入ってきた |
同じ声だと、邪魔な側の文「弟は最近ギターの練習に夢中になっている」の一部が、聞かせたい文の途中に入り込んでいます。声で区別できないので、誰の言葉かの境目が崩れました。
人を聞き手にした実験でも同じ向きの結果が出ていて、Brungart (2001) は聞かせたい声と邪魔な声を1人ずつ重ねて声の組み合わせを変えながら聞き取りを測りました。男女が違う声の組み合わせが最も聞き取りやすく、同じ話者どうしが最も聞き取りにくい結果です。
音声認識は、小さいほうの声を選べない
右の図は邪魔な側の文のほうを書き起こしてしまった数です (邪魔な側の文に対する誤り率のほうが低かった文を数えました)。
| S/N 比 | +10 | +5 | 0 | -5 | -10 |
|---|---|---|---|---|---|
| 別の声 1人 | 0 | 0 | 3 | 20 | 20 |
| 同じ声 1人 | 0 | 1 | 7 | 17 | 18 |
(20 文中)
邪魔な声が約1.8倍 (-5dB) になった時点で、別の声では 20 文すべてで音声認識は邪魔な側の文を書き起こしました。崩れたのではありません。大きいほうの声に乗り換えています。 先ほどの文では書き起こしが「庭のトマトがようやく開く風が入ってきた」になり、邪魔な側の「庭のトマトがようやく赤くなってきた」の頭に聞かせたい文の後半がつながっていました。
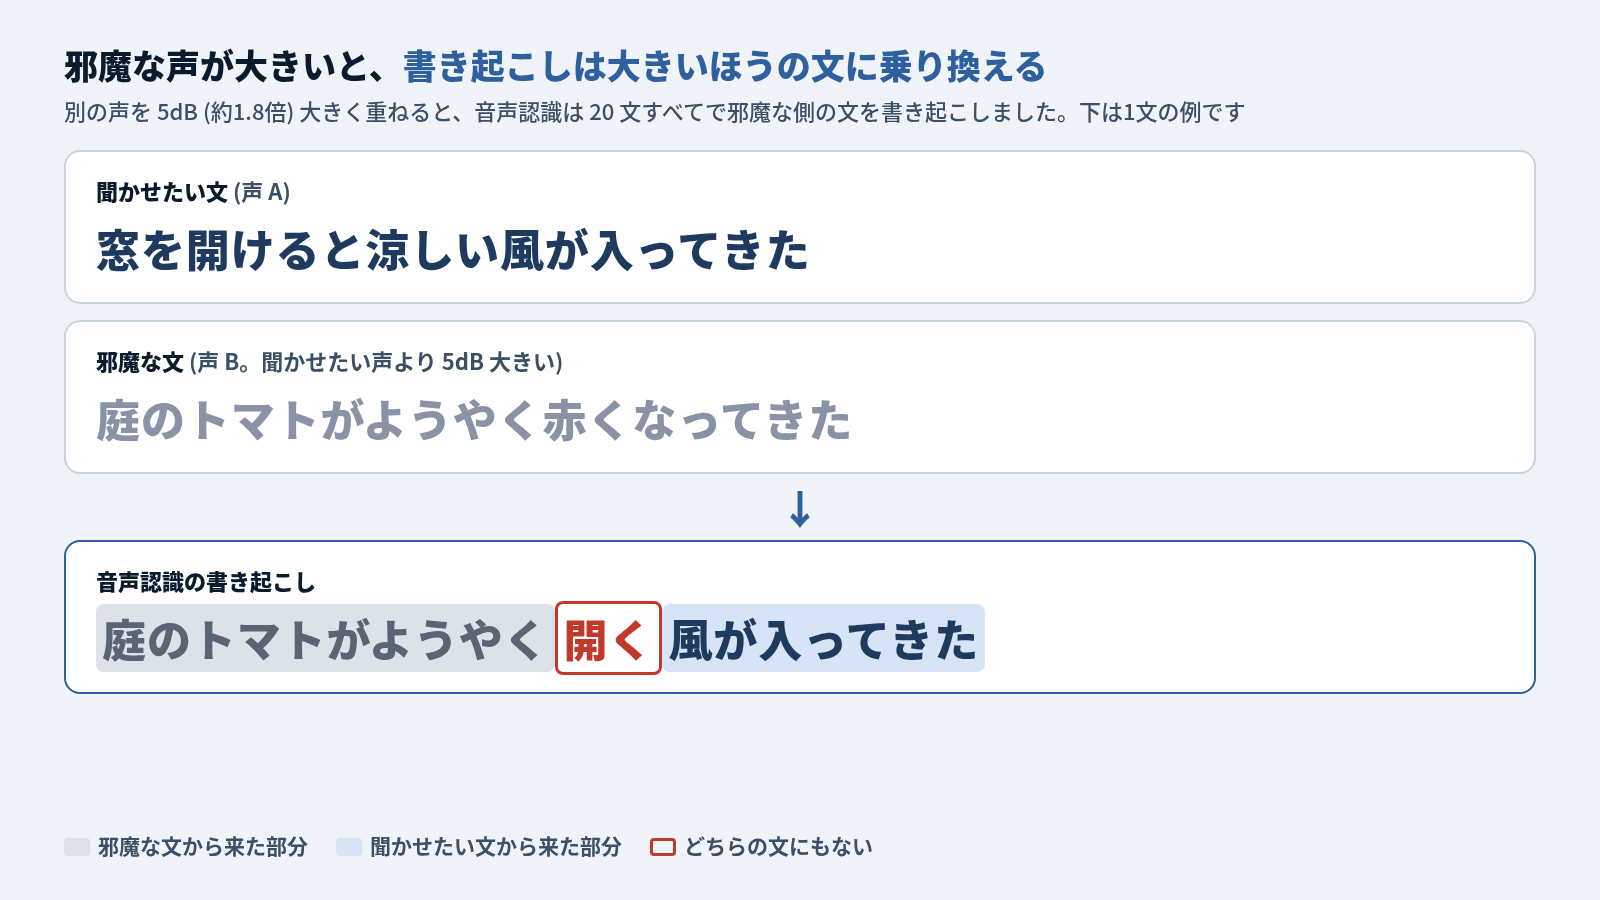
表の誤り率で別の声が -5dB から急に 96% に跳ね上がっているのも、この乗り換えのためです。同じ声のほうが誤り率が低く見えるのは、2つの文が混ざって聞かせたい文の文字が少し残るからです。聞き分けてはいません。
人を聞き手にした実験では、ここで成績が下がりきりませんでした。Brungart (2001) の抄録はこう書いています。
Intelligibility generally plateaued at SNRs below 0 dB and, in some cases, intensity differences between the target and masking voices produced substantial improvements in performance with decreasing SNR.
(聞き取りの成績は S/N 比 0dB を下回るとおおむね横ばいになり、条件によっては、2つの声の音量の差によって、S/N 比が下がるほど成績が大きく上がった)
— D. S. Brungart, “Informational and energetic masking effects in the perception of two simultaneous talkers”, J. Acoust. Soc. Am. 109(3), 1101-1109 (2001)
この実験は2つの文のうち「目標の文」を答えさせる課題で、聞き手はどちらを聞くべきかを分かっているので、邪魔な声のほうが大きくなると小さいほうが聞くべき声だという手がかりにもなると考えられます。音声認識にはこの前提がありません。聞こえた中で一番それらしい文を1本書くように作られていて、どちらの声を聞くかを伝える手段を持たないので、大きいほうに引っぱられます。人と音声認識の差には、聞き分ける力の差だけでなく、この条件の差も入っています。
ざわめきは、音声認識には定常ノイズより悪い
もう1つ、目立った結果があります。S/N 比 0dB でのざわめきの誤り率は 2人 65.9%、4人 74.9%、8人 78.7% で、人数が増えるほど崩れ、話し声の形の定常ノイズ (37.2%) よりずっと悪い結果でした。
4人のざわめきを 0dB で重ねた書き起こしは「まぼう、ラケットはサイク、シーカーザーが入ってきた」でした。最後の「入ってきた」だけが聞かせたい文の一部で残りはどの人の文でもないので、音声認識はざわめきの中の言葉の断片まで拾って文にしようとして崩れているのだと考えられます。人でざわめきと定常ノイズを比べた研究はこの章では引いていないので、人でも同じになるかは分かりません。
別の声1人は +5dB と 0dB では定常ノイズより誤りが少なく (10.0% と 15.2%、28.7% と 37.2%)、ここは人と同じ向きです。ただ同じ誤り率になる S/N 比で比べると、別の声1人の有利さは誤り率 10〜30% のあたりで 1〜3dB 分、誤り率 50% の点ではほぼゼロでした。人の 6〜8dB は、文の半分を聞き取れる点 (誤り率でいえば 50% 付近) で測った差なので、同じ基準で比べると音声認識の有利さはずっと小さいことになります。
話しかける側に使えること
この結果をスピーカーから人に話しかける側から読むと、打てる手が2つあります。
1つは、周りの話し声と違う声で話すことです。この測定では邪魔な声が1人のとき同じ声か違う声かだけで同じ音量での誤り率が倍違い、人の実験でも男女が違う声が最も聞き取りやすい結果です (Brungart 2001)。案内放送なら、その場で多く聞こえている話し声と高さや性別の違う声を選ぶ使い方になります。ただし周りが大勢のざわめきのときは、全員が違う声でも誤り率は 66〜79% まで上がっていました。声を変えるだけでは足りません。
よく「声を高くしたほうが通る」と言われます。電話に出るときや接客のとき、自然と声が一段高くなる人も多いと思います。反対に、低く落ち着いた声は「イケボ」と呼ばれて、聞き心地のよさでほめられます。この章の結果から読むと、聞き取りやすさに効いているのは声の高さそのものより、周りの声との違いです。低い声の男性ばかりが話している会議室なら高めの声が、甲高い歓声が飛び交う場所なら低めの声が浮き上がるはずです (これは私の推論で、測ってはいません)。実際、騒音の中で話した声の変化を1つずつ取り出して調べた研究では、声が高くなること自体は、話し声の形をした雑音の中での聞き取りやすさに有意には効いていませんでした (Lu & Cooke 2009)。高い声が通ると感じる場面の多くは、周りと違う高さだったから、と考えるほうが結果に合います。
もう1つは、自分の声を聞き手に選んでもらう手がかりを先に渡すことです。人は大勢の中から聞きたい声を選べますが、選ぶ前に「どの声を聞くか」が分かっていると、多くの条件で成績が上がることも、話者が3〜4人の実験で分かっています (Brungart ら 2001)。放送を毎回同じ声で始めれば、聞き手はその声を覚えて、どの声を追えばいいかを先に知ることができます。ただしこれは、この実験から私が引いた応用です。放送の声をそろえた効果を測った研究までは確かめていません。
声の帯域を立てたり話し方を変えたりして声そのものを埋もれにくくする加工は、スピーカーの声を聞き取りやすく 誤り76→20%で測っています。
この章が言えないこと
聞き手は音声認識 (faster-whisper small) で、人は方向や口の動きも手がかりにできるので、同じ S/N 比でも聞き取れる量はこの測定と違います。人についての記述は論文の結果を引いたものです。私は人に聞かせて測っていません。
邪魔な声は読み上げ音声で声の組み合わせも限られていて、「別の声」は onyx の1種類だけなので、男女の違いと声の個性の違いを分けて測ってはいません。音声は1本に混ぜていて、左右の耳の違い (方向) は入っていません。
この章で分かったこと
| 別の声 1人 | 同じ声 1人 | ざわめき 2〜8人 | 話し声の形の定常ノイズ | |
|---|---|---|---|---|
| S/N 比 0dB の誤り率 | 28.7% | 58.3% | 65.9〜78.7% | 37.2% |
| 邪魔な側の文を書き起こした数 (-5dB) | 20 / 20 | 17 / 20 | (数えていない) | (該当なし) |
| 人の実験との向き | 同じ (声が違うほど易しい) | 同じ (最も難しい) | (人の研究を引いていない) |
声が違うと聞き分けやすいという点は、音声認識でも人の実験と同じ向きに出ました。違ったのは、邪魔な声が大きくなったときです。音声認識は大きいほうの声に乗り換えました。人の実験では、聞くべき文を分かっている聞き手の成績は下がりきりませんでした。声の違いを手がかりにする仕組みは音声認識にもありましたが、どちらの声を聞くかを決める仕組みは持っていませんでした。
この記事は役に立ちましたか?