Agentic RAG 2026: 4 search APIs, 1 escolha
Em um projeto de Agentic RAG, o detalhe que mais trava o cronograma costuma passar batido: qual search API o agente vai usar. Antes de comparar as quatro grandes de 2026, tem um achado que muito time engole mal: no final de 2025, segundo Boris Cherny, o Claude Code testou RAG com busca vetorial e o Agentic Search baseado em grep/glob venceu por ampla margem.
RAG não morreu com isso. O teste indica que RAG precisa de uma razão explícita para existir no seu sistema. Para código, grep basta. Para web e docs externos, aí sim entra uma search API, e é nesse espaço que Tavily, Exa, Perplexity e Brave Search estão em disputa.
Por que o Claude Code abandonou RAG (e o que isso ensina)
O relato do Cherny é curto: sem índice vetorial, sem vector DB, sem embedding para manter. O LLM planeja a busca e dispara grep, find, ls, cat direto no filesystem. Três razões apareceram no comparativo.
- Precisão. “Erros de autenticação” via busca semântica traz
email_validation.pycomo falso positivo.grep -r 'AuthenticationError' src/não. - Operação. Vector DB precisa reindexar, revalidar, reconstruir quando o modelo de embedding muda. Filesystem não precisa.
- Segurança. Código fora de um vector DB externo é código que não saiu da sua infra.
A lição é desconfortável para quem vendeu RAG como padrão: “complexo” não vira sinônimo de “melhor”. A pergunta vem antes da escolha da search API: grep/glob resolve? Se resolve, não existe API no mundo que compense o custo operacional de RAG. Se não resolve, aí você cai no espaço em que essas quatro brigam.
As quatro search APIs em 2026
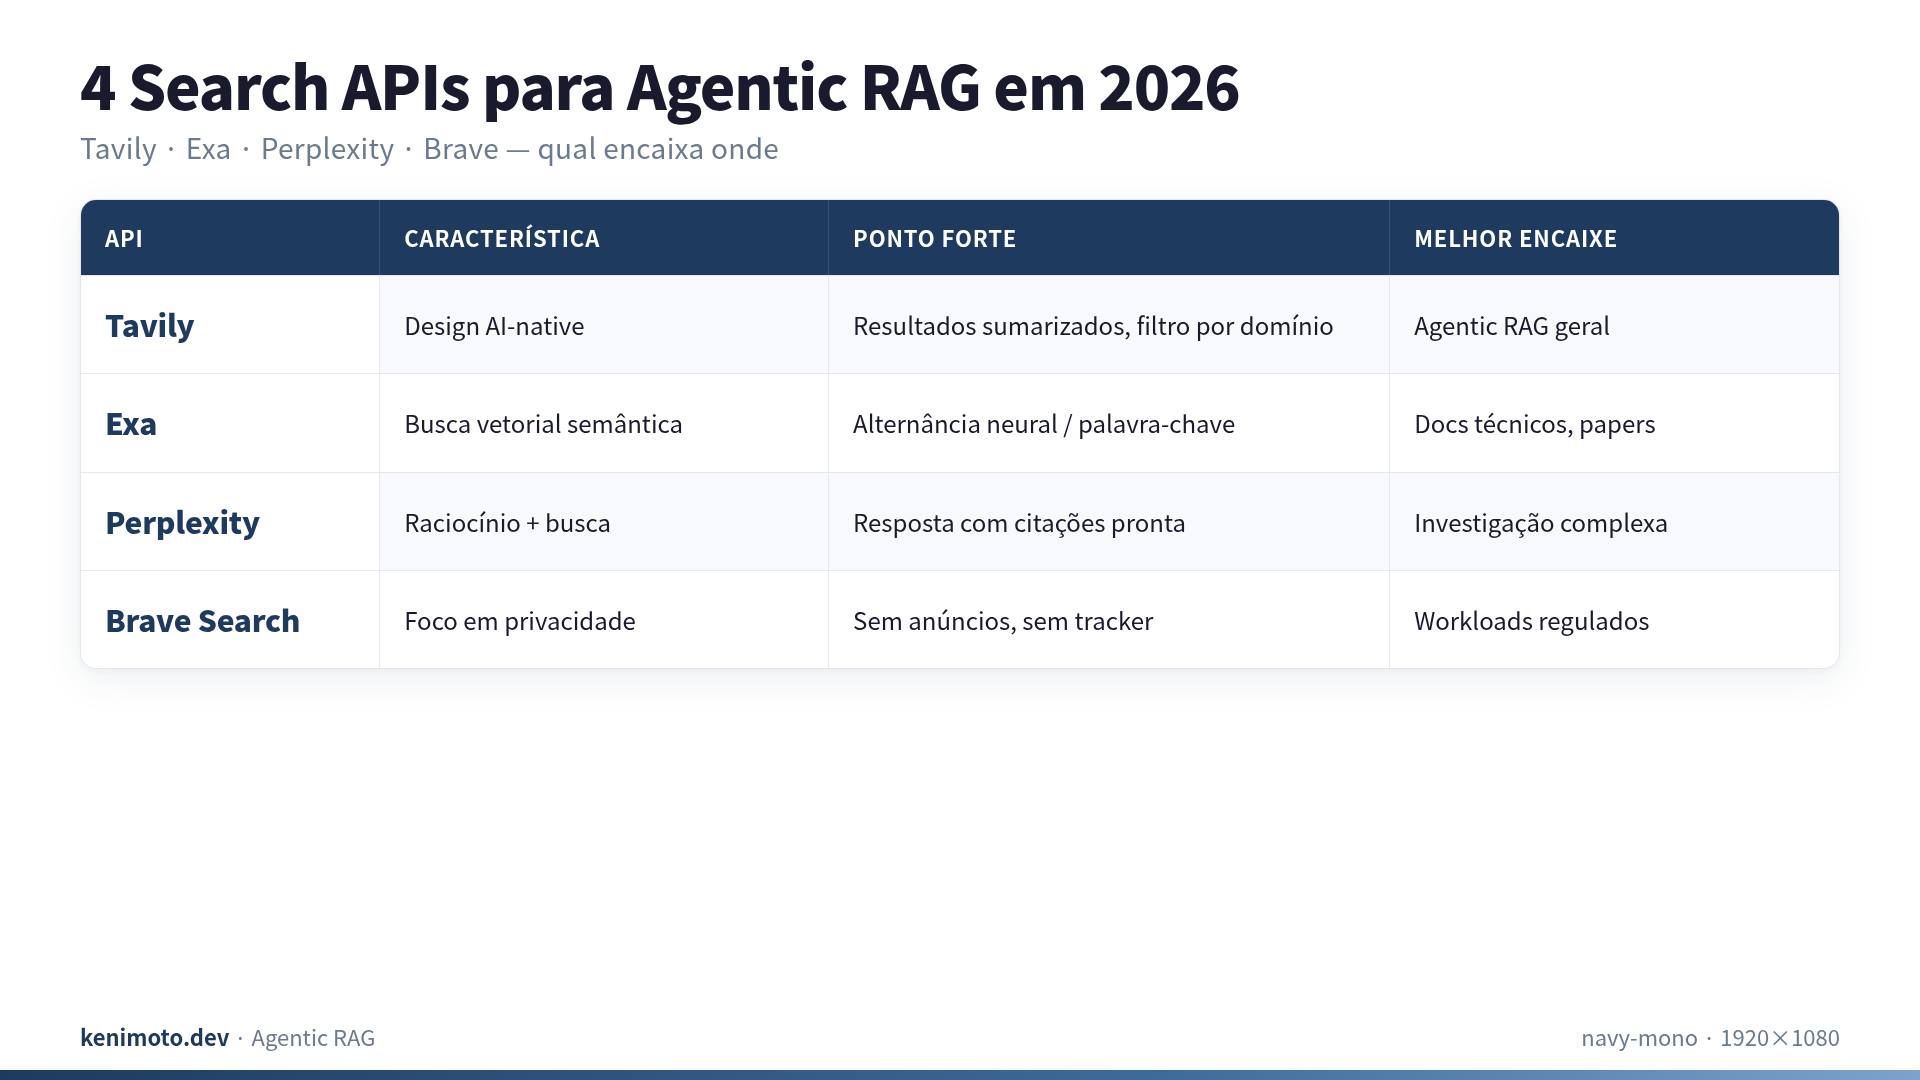
A tabela a seguir sintetiza o comparativo do capítulo 11 do meu livro de Context Engineering.
| API | Característica | Ponto forte | Melhor encaixe |
|---|---|---|---|
| Tavily | Design AI-native | Resultados sumarizados, filtro por domínio | Agentic RAG geral |
| Exa | Busca vetorial semântica | Alta precisão, alterna neural/palavra-chave | Docs técnicos, papers |
| Perplexity | Raciocínio + busca | Resposta com citações já pronta | Investigação complexa |
| Brave Search | Foco em privacidade | Sem anúncios, sem tracker | Workloads com privacidade obrigatória |
As quatro aceitam uma query e devolvem resultados. O que diferencia cada uma é o que fazem antes de devolver.
Tavily — o default razoável
A Tavily foi desenhada para ser consumida por um LLM. A chamada é curta:
from tavily import TavilyClient
client = TavilyClient(api_key=TAVILY_KEY)
response = client.search(
    query="otimização de Claude Code CLAUDE.md",
    search_depth="advanced",
    include_domains=["anthropic.com", "github.com"],
    max_results=10,
)
O include_domains resolve um problema real em Agentic RAG: o agente precisa confiar em uma vizinhança fechada de fontes. A web inteira é grande demais. Para começar um projeto, Tavily é o atalho honesto.
Exa — quando a semântica é o que importa
Exa troca a busca por palavra-chave por embeddings. Se sua query é “papers que tratam de atenção causal como se fosse convolução”, Tavily até pode falhar. Exa encontra. O custo vem na entrada: a query precisa ser pensada antes de ser enviada. Exa é um motor de busca que te pergunta se você sabe o que está pedindo.
Perplexity — já vem com resposta
Perplexity vai além dos resultados brutos e já devolve uma resposta sintetizada com citações. Para um agente que precisa de um briefing de três parágrafos antes de decidir o próximo passo, isso elimina uma camada de síntese. Para um agente que precisa dos resultados crus para re-ranquear, vira desperdício: você está pagando por um trabalho que vai jogar fora.
Brave Search — a opção de privacidade
Brave Search é a resposta para a pergunta: “e se eu não puder mandar a query do usuário para um serviço que grava logs comercialmente?” Sem anúncios, sem rastreador, com suporte a japonês (relevante se seu produto também atende Ásia). É a escolha quase óbvia em workloads regulados.
O eixo que normalmente fica fora da conversa
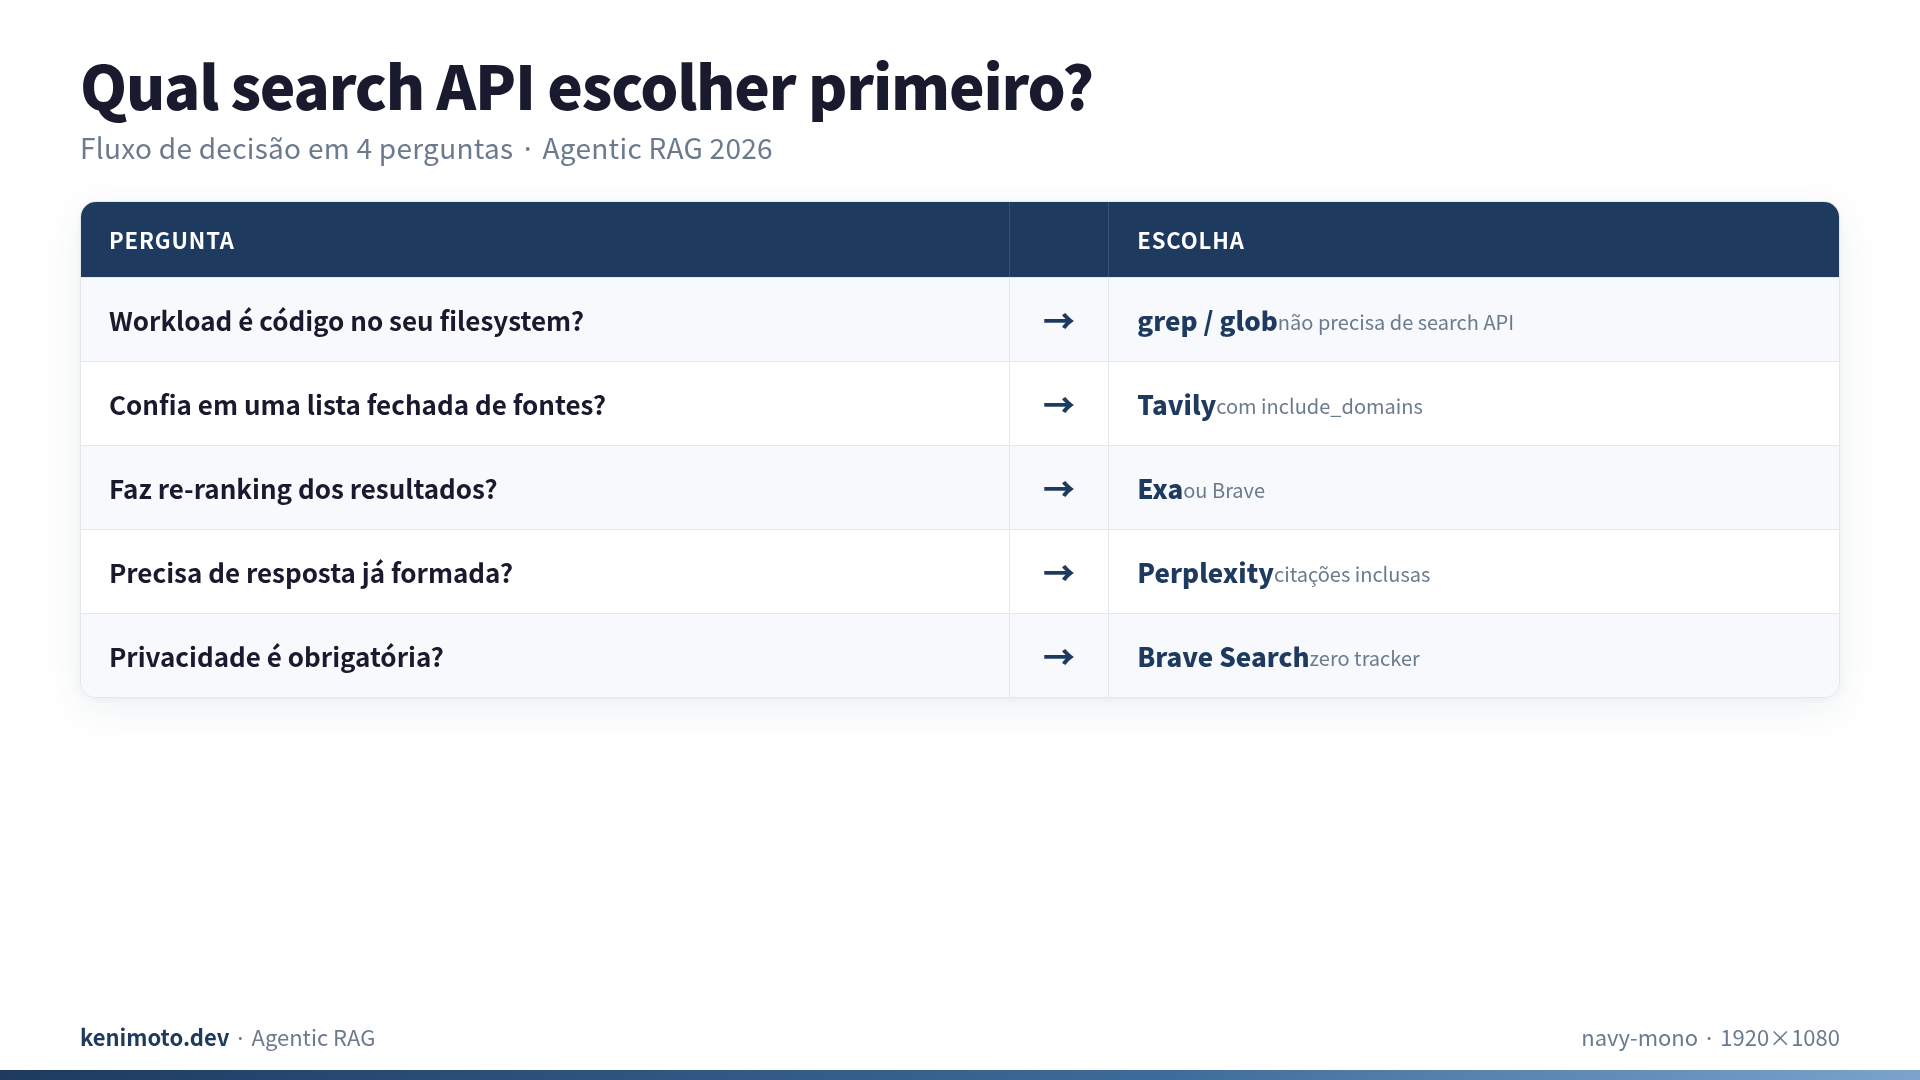
A escolha entre as quatro passa por outro eixo: como seu agente vai reagir aos resultados. Isso importa mais do que latência ou preço por 1k queries. Quatro perguntas fazem mais diferença do que a tabela de preço:
- O agente precisa confiar em uma lista fechada de fontes? → Tavily com
include_domains - O agente faz re-ranking sobre os resultados? → Exa (resultados crus com score vetorial) ou Brave
- O agente precisa de uma resposta já formada para encadear a próxima ação? → Perplexity
- A query carrega dado sensível que não pode sair da sua infra? → Brave Search
Perguntar isso antes de olhar preço evita que você escolha a API mais barata e descubra, duas semanas depois, que ela não entrega o formato de dados que o agente espera. Trocar search API num agente em produção dá trabalho: toda a lógica de parsing, re-ranking e fallback foi desenhada ao redor do schema da API antiga.
Como eu começaria hoje
Se precisasse começar hoje um Agentic RAG sobre documentação técnica, começaria com Tavily para validar o loop do agente, depois mediria se os falsos positivos justificam trocar por Exa. Quando o workload tocar dados de usuário sensíveis, pularia direto para Brave. Perplexity eu guardaria para o passo de síntese, longe da busca em si: ele é bom demais em responder, e isso esconde erros do agente que precisam aparecer.
“Depende” é a resposta chata, e é a que o estudo das quatro APIs me devolve.
O erro recorrente antes do erro da API
O achado do Claude Code volta no final. Antes de contratar qualquer uma das quatro APIs, pergunte o óbvio: grep/glob resolve? Em workloads de código dentro do seu filesystem, provavelmente sim. Em workloads que tocam a web ou docs externos, você passa para a comparação acima.
Agentic RAG tem seu nicho: problemas que grep não resolve. Escolher a search API certa é só a última decisão de uma série que começa em “preciso disso de verdade?”.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Transformando LLMs de Mentirosos em Especialistas Engenharia de Contexto na Prática | RAG · MCP · CLAUDE.md · Agentic RAG, com benchmarks de ponta a ponta Ver a página do livro →
Este artigo foi útil?