Claude Code vs Qwen 35B: empate em 3 de 5 testes
Eu estava gastando crédito de Claude em tarefa que um modelo local resolveria. Então parei de assumir e medi: cinco tipos de tarefa, três modelos, mesmo prompt, mesma rubrica.
O Claude ganhou em um. Empatou em três. E em um a família inteira perdeu junto, e aí o problema não era o modelo.
O setup
Três modelos sob a mesma vara:
- Qwen3.5-9B — Ollama Q4_K_M, cabe inteiro numa RTX 4070 12GB
- Qwen3.6-35B-A3B — llama.cpp UD-Q4_K_M, MoE com 3B ativos. Mora na mesma RTX 4070 com CPU offload (
--n-cpu-moe 24) - Claude Sonnet 5 — API, thinking desligado
Os dois Qwen rodam na minha autocrew-pc atrás de Tailscale. Do lado do PC de trabalho é só um endpoint HTTP, como se fosse Ollama local. Se você mora no Brasil e não quer encarar RTX 4070 em moeda forte, o mesmo arranjo roda em qualquer máquina com Docker e uma GPU 12GB; a parte Tailscale é só pra eu ficar longe do barulho do ventilador.
Context 32768, thinking off, temperatura 0. Rubrica e corretor automáticos, não eu dando nota. Tudo em iris-lab/experiments/049-local-vs-claude-code-split.
Os cinco tipos de tarefa
Peguei o que eu realmente faço durante o dia e cortei em cinco grupos.
- Pesquisa (WebFetch) — a página já foi baixada, o modelo tem que extrair número, data ou nome próprio corretos. 15 casos.
- Resumo — artigo real da Wikipedia, resumir cobrindo os fatos essenciais sem inventar número. 10 casos, 5 em inglês e 5 em japonês.
- Mensagem de commit — dado o diff, escrever título em até 72 caracteres + linha em branco + corpo que cita arquivo ou identificador tocado. 10 casos.
- Classificação — olhar um pedaço de pedido e colar numa das 9 etiquetas (extract, summarize, code, write, check, agent, question, classify, research). 12 casos.
- Correção de código — pytest escondido. Passa ou falha. 10 casos (3 fáceis, 4 médios, 3 difíceis).
A tabela
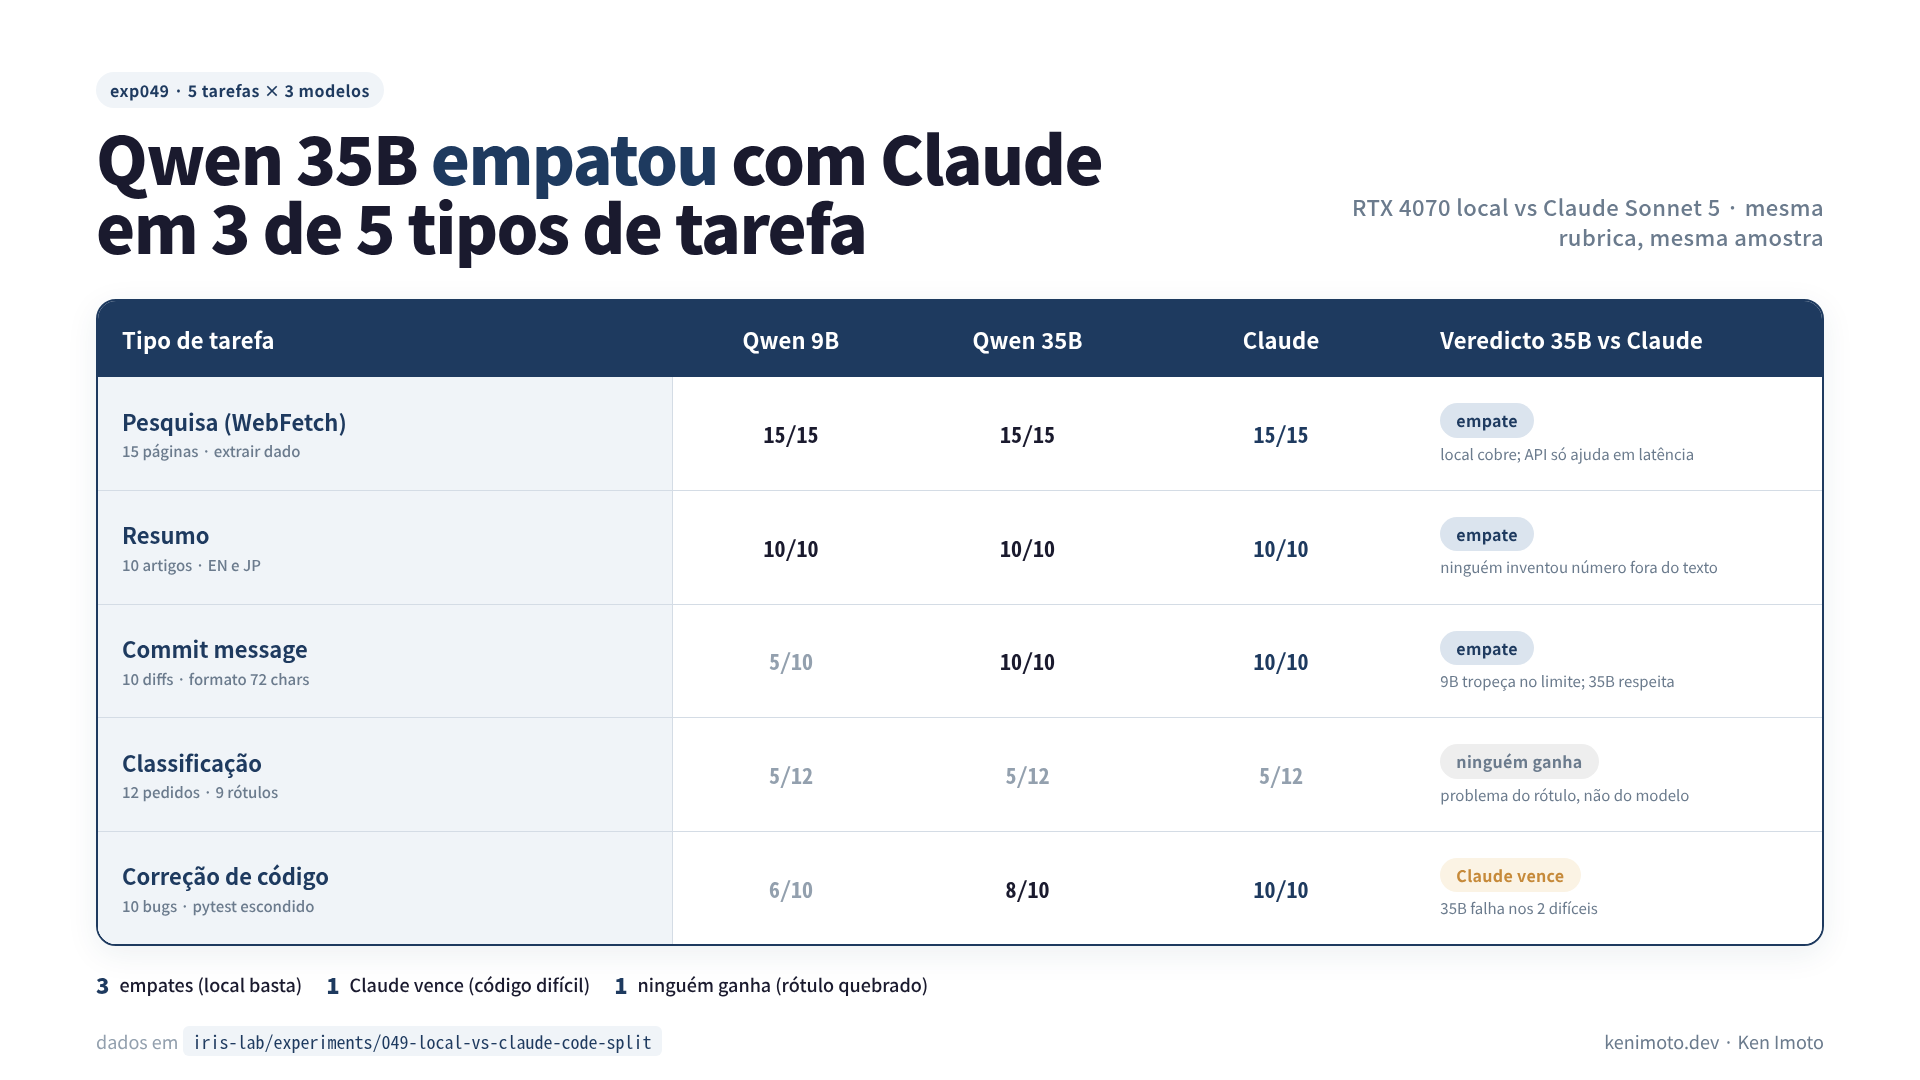
| Tipo | 9B | 35B | Claude |
|---|---|---|---|
| Pesquisa (WebFetch) | 15/15 | 15/15 | 15/15 |
| Resumo | 10/10 | 10/10 | 10/10 |
| Commit | 5/10 | 10/10 | 10/10 |
| Classificação | 5/12 | 5/12 | 5/12 |
| Correção de código | 6/10 | 8/10 | 10/10 |
Três linhas em que o 35B empatou com o Claude: pesquisa, resumo, commit. Uma linha em que os três ficaram no mesmo buraco: classificação. Uma linha em que o Claude venceu: correção de código.
Onde o local basta (3 de 5)
Pesquisa: 15 de 15 para todo mundo. O gargalo é estar lendo a página direito, não o tamanho do modelo. O 35B demorou 8,3s de mediana contra 1,4s do Claude, porque meu --n-cpu-moe 24 paga pedágio no input de 5 a 8 mil tokens. Em qualidade: zero diferença. Se a sua pipeline extrai dado de HTML já baixado, não tem razão econômica para gastar cota de API aqui.
Resumo: 10 de 10 para todo mundo. O 9B ficou em 0,83 de cobertura média de fatos essenciais, o 35B em 0,97, o Claude em 0,95. Todos acima da linha de 4-de-6 que era o critério. Mais importante: nenhum dos três inventou número que não estava no texto. Essa era a parte que eu temia no 9B, e ele se comportou.
Commit: 10 de 10 para o 35B, empatando com Claude. O 9B perdeu 5 casos puramente de formato: título com 73 a 76 caracteres em 4 casos, linha em branco faltando em 1. O conteúdo estava correto. O 35B chegou nos 72 caracteres sem gritar e o Claude também. Se você automatiza mensagem de commit num hook, a diferença não está em modelo grande frente a modelo pequeno. Está em um modelo que respeita formato frente a um que tropeça no limite.
Já dá para dividir: as três tarefas em que o Qwen 35B empatou representam a maior parte do que eu peço num dia de desenvolvimento. Se eu rotear essas três para o local, a conta de API cai sem perder resultado.
Onde o Claude vence (1 de 5)
Correção de código: 10 de 10 para o Claude. O 35B pegou 8 de 10, o 9B pegou 6 de 10. A diferença aparece no nível difícil: 9B zerou em 0/3, 35B passou 1 de 3, Claude 3 de 3. Dos dois casos que o 35B errou: em um ele gastou os 4096 tokens de saída explicando o problema antes de começar o código; em outro, corrigiu metade do que a spec pedia.
Isso é consistente com a filosofia de “modelo pequeno + bom contexto” que o livro trata no capítulo 13: um Qwen bem contextualizado bate muita coisa, mas na extremidade difícil ainda existe uma diferença de capacidade bruta que RAG não repõe. É nessa extremidade que faz sentido pagar Claude.
Onde o tamanho do modelo não mudou nada (1 de 5)
Classificação: 5 de 12 para todo mundo. Os três modelos acertaram 5 e erraram 7, e em 4 dos 7 erros os três votaram a mesma coisa errada (write → code duas vezes, summarize → code, classify → agent). Quando os três convergem no mesmo erro, o problema sai do modelo e vai parar no rótulo.
Cortei esse resultado do caderno das conclusões: ampliar o modelo não ia resolver. O que precisa acontecer é melhorar a definição das 9 etiquetas ou aceitar uma taxa de erro estrutural. Gastar Claude aqui é jogar dinheiro fora.
Quando o 35B custa muito tempo
Honestidade: o 35B não é grátis em latência. No WebFetch ele leva mediana 8,3s por entrada longa, enquanto o Claude termina em 1,4s. Se o seu loop é humano esperando a resposta, Claude ainda ganha percepção. Se o seu loop é batch (gerador de commit noturno, resumo de changelog pela manhã), 8s é invisível.
O 9B compensa em latência (2,1s no WebFetch) e consome menos energia, mas perde formato no commit e perde qualidade no código. É a opção certa para hook muito frequente onde formato não importa, e a opção errada para tudo que vai para o repositório.
O roteamento que eu rodo agora
Depois desse teste:
- Qwen 35B → WebFetch, resumo, commit automático
- Claude Sonnet 5 → correção de código, qualquer passo que acabe em
git commitpor minhas mãos - Qualquer um deles → classificação (porque nenhum vai acertar muito mais)
Isso não significa “trocar Claude por local”. O plano é mandar 3 em 5 para o local e deixar o Claude fazer o que o Claude faz bem.
A ideia por trás desse roteamento, de que modelo pequeno com contexto certo bate modelo grande sozinho, é o que fez eu abrir essa planilha em vez de assumir que Claude era o padrão. É a tese central do livro que escrevi sobre engenharia de contexto; capítulo 13 fala exatamente disso.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Transformando LLMs de Mentirosos em Especialistas Engenharia de Contexto na Prática | RAG · MCP · CLAUDE.md · Agentic RAG, com benchmarks de ponta a ponta Ver a página do livro →
Este artigo foi útil?