Static Call Graphs perdem 61%: 4 táticas
Seu code review com IA diz blast radius = 0. Está mentindo em 61% dos casos.
Esse é o artigo todo em uma frase. O resto é o porquê, e o que juntei pra consertar isso dentro da própria harness, sem precisar brigar com o parser.
Os 61% que ninguém consegue ver
Monta um call graph só com análise estática e você vai perder mais coisa do que imagina. O paper ISSTA 2024 sobre análise estática em Android comparou 13 ferramentas populares contra execução em dispositivo real e achou o seguinte: em média, 61% dos métodos executados dinamicamente não foram capturados por análise estática. Python parece um pouco melhor no papel. O PyCG (ICSE 2021) reporta 69,9% de recall no benchmark próprio. O que soa aceitável, até você perceber que seus piores incidentes estão exatamente nos 30% que ele perdeu.
O knowledge graph de código funciona como camada de retrieval do code review com IA. Cada PR vira a mesma pergunta: “o que depende dos símbolos que esse diff mexeu?”. Se o grafo não diz nada, o revisor fica mudo. Essa é a falha. Reflection, getattr, injeção de dependência, event handlers: o parser não vê nenhum deles, então o grafo carrega um buraco silencioso bem onde estão os callers mais arriscados.
Em vez de empurrar o lado estático mais pra cima na curva de recall, somei três táticas a ele.
Os seis formatos de dispatch dinâmico
Antes de escolher tática, ajuda nomear o que você tá caçando. Dispatch dinâmico não é uma coisa só:
| Padrão | Exemplo | O que análise estática enxerga |
|---|---|---|
| Acesso por atributo | getattr(obj, name)(), obj[key]() | Nada, a não ser que name seja literal |
| Import dinâmico | importlib.import_module(name) | Só se name for constante |
| Reflection | Java Method.invoke(), C# MethodInfo.Invoke() | Nada |
| Injeção de dependência | Spring @Autowired, FastAPI Depends() | Parcial, se também ler o config |
| Eventos e callbacks | EventEmitter do Node.js, eventos DOM | Parcial, por pattern matching |
| Metaprogramação | Metaclass do Python, Ruby method_missing | Nada |
Cada linha é um buraco diferente, e cada buraco quer o próprio remendo. Tratar como um problema só é o motivo de “é só melhorar o analisador estático” nunca funcionar.
Tática 1: pattern matching nos literais que dão pra ver
O remendo mais barato é um conjunto de regras AST para as formas em que o nome do alvo tá escrito na fonte. Não ajuda quando alguém guarda o nome do método numa variável, mas pega a fruta no chão.
# tree-sitter-ish pseudocódigo
# Casa: getattr(<x>, "<literal>")(...)
def detect_static_getattr(node):
    if node.type == "call" and node.children[0].type == "call":
        outer = node.children[0]
        if (outer.children[0].text == b"getattr"
            and outer.arguments[1].type == "string"):
            method_name = outer.arguments[1].text.decode().strip('"')
            return ("dynamic_call", method_name)
Quanto isso recupera depende de quão frequentemente o segundo argumento é string literal, então vale contar no próprio repo antes de adotar. Esse número depende inteiramente de como a base foi escrita. Melhor medir do que supor. O custo de implementação é um fim de semana, e medir já é o ponto todo.
O PyCG faz uma versão mais esperta disso rastreando atribuição simples de variável (m = "save"; getattr(obj, m)). Mesmo teto, ~70% de recall. Vale ler o paper porque eles são honestos sobre onde o recall para de subir.
Tática 2: traces de runtime enxertados no grafo
Tudo que é estático trava no mesmo teto na hora de lidar com dispatch que só existe em runtime. O movimento óbvio depois é observar o runtime e realimentar o que você viu no grafo.
Três fontes práticas:
sys.settracedurante rodadas depytest. Cada entrada em função vira uma aresta candidata.- Grep de log de produção por logs estruturados estilo
method=<name>. Nunca faça grep do corpo do log pra extrair argumento. Só o alvo da chamada. Senão você arrasta PII pra dentro do grafo. - Dados intermediários do
coverage.py. Ele já tem que hookar cada chamada pra calcular cobertura. O subproduto é uma lista de “quem chamou quem” que sai de graça.
Esses vão pro grafo como um tipo de aresta separado, CALLS_DYNAMIC, com confiança 0,9–1,0. A chamada foi de fato observada, e o revisor trata isso como evidência bem mais forte do que “o parser acha que pode acontecer”. É a confiança que permite a ele enunciar os warnings de forma honesta, sem igualar tudo no mesmo tom.
O DyPyBench (2024) vale citar aqui. Montaram um benchmark executável de 681K-LOC com 50 pacotes Python, e uma das aplicações que exploram é medir quanto tracing dinâmico recupera a mais sobre a análise estática. Resposta curta: muito, e o gap é maior em bibliotecas que se apoiam em framework.
Os detalhes feios também são reais:
- Teste que você não roda não aparece. Se seu dispatch dinâmico só é exercitado por uma suíte de integração semanal, o grafo atualiza semanalmente.
sys.settraceé lento. Rodar isso no CI a cada PR dói. Rodar à noite emmainé ok.- Log de produção também não é de graça. PII e cardinalidade são preocupações reais, então eu só puxo a coluna
method.
A montagem prática é um job noturno em main que roda a suíte completa sob coverage.py, extrai os pares de chamada e faz upsert no grafo. O CI fica rápido. O grafo fica honesto.
Tática 3: inferência de LLM para as formas que mais nada pega
Tática 1 falha quando o nome do alvo é variável. Tática 2 falha quando o caminho não é exercitado. O que sobra é pedir pra um modelo chutar, dado o código ao redor e o tipo do receiver.
prompt = f"""
Given this code, list up to 3 methods likely called by
`{dynamic_call_source}`. Return a JSON array of {{method, confidence}}.

Context:
{code_snippet}

Methods available on the receiver (from the graph):
{method_list_from_kg}
"""
A jogada principal é alimentar o modelo com a lista de métodos do receiver, direto do grafo. Sem isso, ele alucina nomes plausíveis que não existem. Com isso, os chutes ficam presos à superfície de API real, e os números de confiança se tornam úteis.
O estudo EMSE 2025 de LLMs pra análise de tipo e call graph avaliou 24 modelos em Python e JS. A divisão interessante é a seguinte: LLMs vencem ferramentas tradicionais em inferência de tipo, mas em construção de call graph os analisadores estáticos clássicos (PyCG, Jelly) ainda ganham. A conclusão prática é não usar o LLM como construtor primário de call graph. Deixa ele pra preencher os buracos que o construtor primário já marcou.
Esses vão pro grafo como CALLS_INFERRED com confiança 0,3–0,7. O revisor lê isso como “pista, vale olhar o código ao redor”. Nunca como garantia de que a chamada acontece.
Tática 4: arquivo de configuração como fonte de verdade
Injeção de dependência parece dinâmica até você notar que a resposta já está escrita: num @Configuration do Spring, numa cadeia de Depends() do FastAPI, num módulo NestJS. Se o framework te conta qual implementação liga em qual interface, parseia o framework.
# Estilo Spring: lê métodos @Bean e liga nas implementações
for cls in classes_with_annotation("@Configuration"):
    for method in cls.methods:
        if method.has_annotation("@Bean"):
            bean_type = method.return_type
            for impl in find_implementations(bean_type):
                add_edge(method, impl, type="INJECTS", confidence=0.95)
Confiança 0,95 porque o config é a fonte de verdade do sistema rodando. O único jeito disso estar errado é se o runtime sobrescrever o config, e isso é um bug que você quer que o grafo te ajude a achar de qualquer forma.
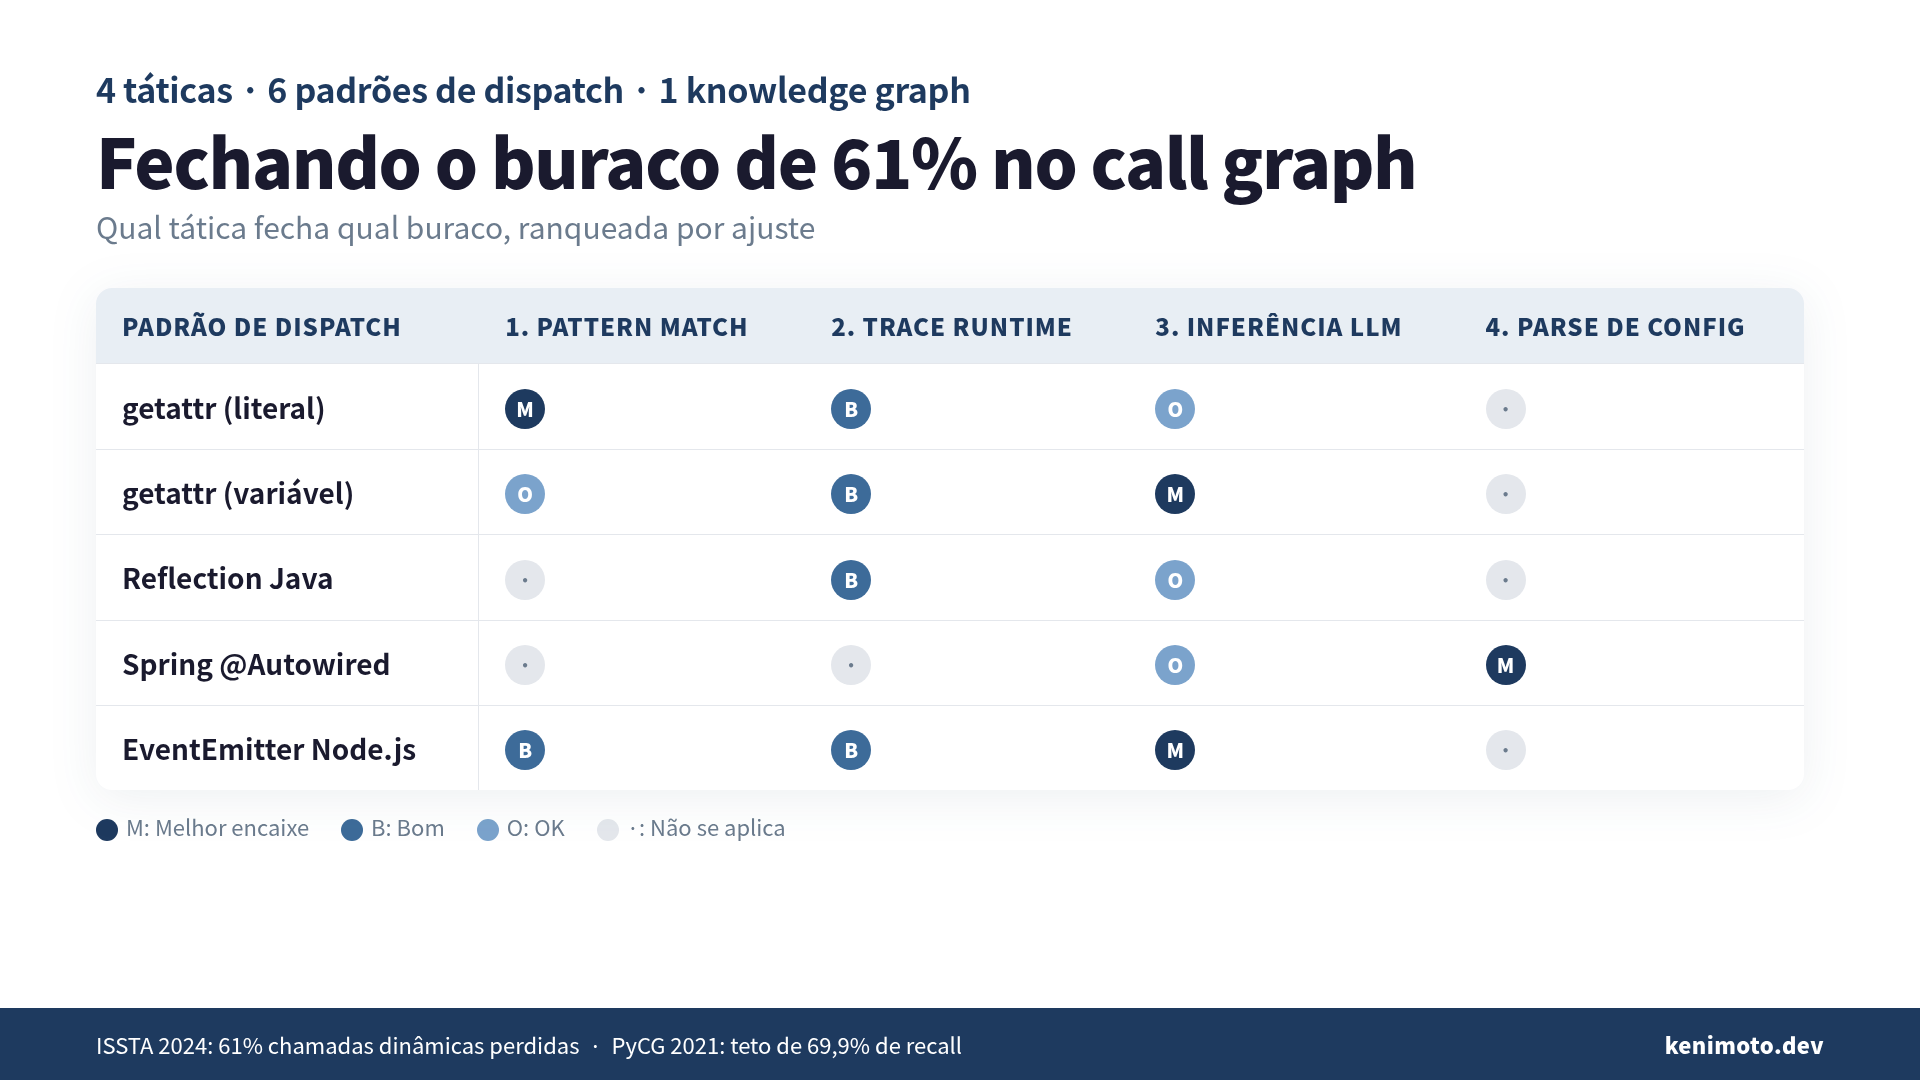
Quando usar o quê
| Padrão | Tát. 1 | Tát. 2 | Tát. 3 | Tát. 4 |
|---|---|---|---|---|
getattr (literal) | Melhor | Bom | OK | — |
getattr (variável) | Fraco | Bom | Melhor | — |
| Reflection Java | — | Bom | OK | — |
Spring @Autowired | — | — | OK | Melhor |
EventEmitter Node.js | Bom | Bom | Melhor | — |
| Metaclass Python | — | — | OK | — |
| DSL custom | — | Fraco | Melhor | — |
Tática 1 é barata, roda em todo lugar. Tática 4 é exata, roda onde um framework que você usa tem config. Tática 2 é o sinal mais forte mas tem custo de CI, roda à noite. Tática 3 é último recurso pro que as outras três não alcançaram.
O FSE 2025 chegou pra ajudar
O FSE 2025 “Do you have 5 min?” propõe uma coisa simples: extrair entry points do dynamic call graph em 5 minutos, e usar no construtor estático. Recall sobe de forma mensurável sem precisar rodar runtime completo.
Isso casa bem com a estrutura de 4 táticas. Você não precisa escolher entre “estático barato” e “dinâmico caro”. Dá pra rodar só a parte dinâmica que decide o entry point, e deixar o restante do grafo ser construído em velocidade estática.
Os buracos que você não fecha: marque e siga
Mesmo com as quatro táticas, algum dispatch continua sem resolver. Reflection do Java sozinho tem um paper TOSEM 2019 inteiro sobre por que resiste a análise sound. Essa parte não foi resolvida. Você também não vai resolver.
O que importa é o que você faz com o resíduo. Coloca uma flag UNKNOWN_DYNAMIC em qualquer nó onde dispatch é conhecido mas o alvo não dá pra resolver. Quando o revisor com IA calcula blast radius perto de um nó marcado, a saída dele deixa de ser “safe, nenhum caller” e passa a ser “análise estática não enxerga depois desse ponto; os sites de reflection dentro de N hops estão listados abaixo”. Essa mudança sozinha é o que remove o falso conforto do “blast radius = 0”.
Uma aresta não resolvida é uma verruga no grafo. Um zero silencioso é relatório de incidente esperando pra acontecer. A verruga compensa.
Por que code review com IA deveria se importar
O pitch de venda de revisor com IA costuma ser “a gente lê o diff, a gente te conta o que está errado”. O pitch das 3 da manhã costuma ser “a gente te disse que tava ok e não tava”. Um knowledge graph de código é o que transforma revisão só-diff em revisão por blast radius, mas só quando o grafo conta pro revisor onde a visão dele acaba.
Grafo só estático deixa o revisor parecer tranquilo sobre coisa que ele nunca checou. Dá três vocabulários pra ele: CALLS_DYNAMIC em 0,9, CALLS_INFERRED em 0,3–0,7, UNKNOWN_DYNAMIC como flag seca. Aí o relatório finalmente mapeia pra três níveis diferentes de certeza. A engenheira que lê o relatório consegue pesar.
O conserto do falso positivo “blast radius = 0” é menos esperto do que parece. Matemática melhor no lado estático não fez nada. O que parou o falso conforto foi um grafo que admite por escrito quando está cego.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev · TabNews
 Livro relacionado Manual completo de Knowledge Graph Manual completo de Knowledge Graph | GraphRAG · Neo4j · RDF · Tree-sitter · revisão de código por IA Ver a página do livro →
Este artigo foi útil?