Blast Radiusでレビューを63倍減らす
Claude Codeに「このPRをレビューして」と頼むと、素直な設定ではリポジトリの大半を読み込みます。差分が数十行でも、関係ないファイルまで毎回全部読ませてしまうので、tokenが二桁分余計に出ていきます。
直すべきはコンテキストの渡し方で、モデルの賢さではありません。差分の周辺2 hopsだけを渡す「blast radius」という古典的な考え方を入れると、同じモデルでtokenが桁で落ちます。
「全部読ませる」の何が高いのか
AIコードレビューの既定設計は、おおむね2通りに分かれます。
1つ目はリポジトリをまるごと渡すパターンです。lazy defaultで、300kLOCのレポなら差分と関係のないファイル読み込みに大半のtokenが消えます。utils/format_date.tsを何百回も読ませる。3年前のテストフィクスチャも読ませる。同じ情報を毎回ロードし直すだけでは、「context engineering」ではなく「bulk loading」です。
2つ目はベクタ検索(RAG)に丸投げです。こちらは少しましですが、埋め込みは「関数Aが関数Bを呼ぶ」という関係を知りません。UserServiceに関係する断片を、クエリにuserが含まれるという理由で持ってきます。すぐ隣にいる実際のcaller関数は、変数名がuだったりすると見落とします。
両方に共通する誤りは、コードをテキストの袋として扱うことです。コードは袋ではなく、グラフです。
Blast radiusが指しているもの
「blast radius」はセキュリティ用語の借用で、「攻撃が成立したとき、どこまで被害が広がるか」を指します。コードレビュー文脈では、「関数Fを変えたとき、挙動が変わりうる関数はどれか」です。
これはコールグラフ上のBFS(幅優先探索)で答えが出ます。
def blast_radius(graph, start, max_hops=2):
    visited = {start}
    by_hop = {0: {start}}
    frontier = {start}
    for hop in range(1, max_hops + 1):
        callers = set()
        for node in frontier:
            callers |= graph.callers_of(node) - visited
        if not callers:
            break
        visited |= callers
        by_hop[hop] = callers
        frontier = callers
    return by_hop
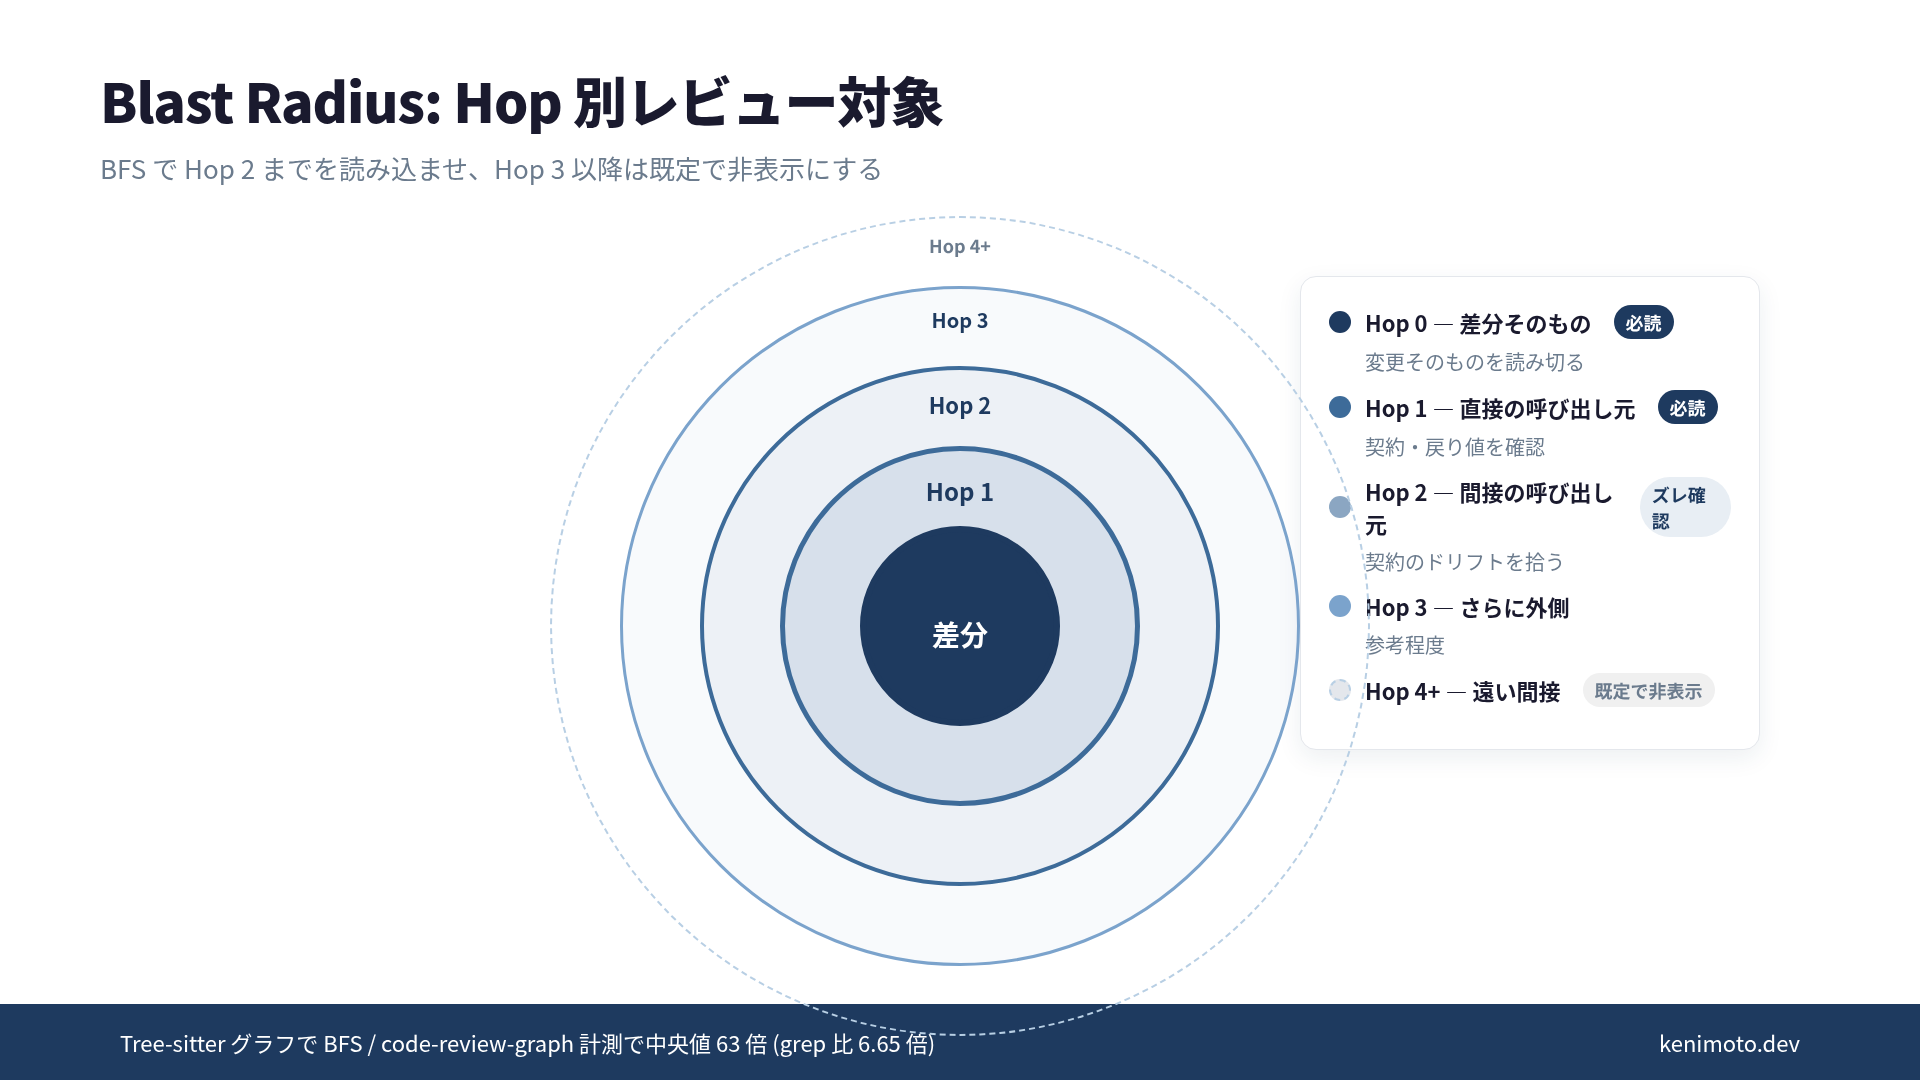
差分から呼び出し元を1 hopずつ辿っていき、Hop 2で止めます。
Hop 2で切るのは、どこかで引かないと到達可能ノードが急速に膨らみ、「全部読ませる」に逆戻りするからです。拙著ナレッジグラフ活用大全の第8章では、Hop別に色分けしたblast radiusの可視化を載せています。経験的に、差分そのもの(Hop 0)と直接の呼び出し元(Hop 1)は必読、Hop 2は契約ドリフト確認、Hop 3は参考扱い、Hop 4以降は既定で非表示、という切り方が実装に落ちやすいです。
Tree-sitterで一度だけグラフを作る
BFSを回すには、呼び出しグラフが要ります。グラフを得るには、コードを構文木に落とす必要があります。言語ごとに別のパーサを書きたくないので、Tree-sitterを使います。PyPIパッケージのtree-sitter-languagesなら、Python/TypeScript/Go等を同じAPIで扱えます。コードKGツール自体の比較軸や各ツールの得意分野についてはGraphRAGでコードレビューを7段階に分解で書きました。
必要なノードタイプはfunction_definition、call_expression、import_statementとクラス相当のものだけです。ファイルを一度走査して、関数・クラスのノードと、呼び出し・importのエッジを吐き出します。保存先はSQLiteで十分です。
差分が入ったらハッシュを見て、変わったファイルだけを再解析します。実装の詳細は書籍第8-9章で扱っていますが、ポイントは「LLMは使わず、Tree-sitterだけでAST抽出が完結する」ことです。ファイル内容を外に送らないので、機密コードベースでも前処理に乗せられます。
code-review-graphが報告している数字
この設計で実測を公開している実装のひとつがcode-review-graphです。Tree-sitter + SQLite + MCPサーバーで、Claude Codeからblast_radiusツールを呼び出せます。
READMEにある6リポジトリ横断のベンチマーク (2026-08-02 captureの数値) は次の通りです。
| リポジトリ | 全文読み込みtoken | グラフクエリtoken | 比率 |
|---|---|---|---|
| fastapi | 948,793 | 2,653 | 357.6倍 |
| code-review-graph | 208,821 | 3,190 | 65.5倍 |
| flask | 143,594 | 2,196 | 65.4倍 |
| gin | 166,868 | 2,766 | 60.3倍 |
| httpx | 142,356 | 2,661 | 53.5倍 |
| express | 136,052 | 3,936 | 34.6倍 |
中央値は63倍、最大はfastapiの358倍です。
ただしこの比較は「モデルが全ファイルを読む」ことを上限と仮定した数字なので、現実の運用と差が出ます。より現実的なベースラインとして、READMEはgrep風の検索で同じ質問に答えた場合との比較も並記しています。18質問を6リポジトリで回した結果、中央値6.65倍、平均14.8倍、レンジは4.2倍から72.6倍でした。
数字の意味を整理すると、こうです。
- 全文読み込み比で63倍: 「とりあえず全部読ませる」設計からの移行効果の上限
- grep比で6.65倍: 現実的なベースラインに対する、「構造を知っている検索」の付加価値
どちらも「知識グラフを噛ませた分だけ、同じ質問に少ないtokenで答えられている」という同じ事実の、別な見方です。
「届く」と「挙動が変わる」は違う
BFSで求まるのは、変更から到達可能(reached)な関数の集合です。これは「挙動が変わる(behavior-changed)」とは別物です。
UserService.createの内部実装だけを直して、シグネチャも戻り値の形も例外も変えなかったとします。callerたちから見ると契約は変わっていません。コールグラフはそのcallerを「reached」に入れますが、彼らの挙動は変わりません。
一方で、同じ関数の返り値型をUserからUser | nullに変えると、呼び出し側は全員レビュー対象です。call graph上は同じ「1 hop先のcaller」でも、重みが違います。
私の実装方針としては、出力を2つのスコアに分けます。
- reach blast radius: BFSで機械的に出る集合
- behavior-change blast radius: 差分の性質(シグネチャ変更、例外追加、副作用変化)を見てLLMが推定する集合
レビューUIでは2つを別ラベルで見せ、どちらに注意を払うかを人間に委ねます。モデルを賢くするよりも、ハーネス(モデルに何を見せるか)側に投資するほうが安く、効きます。
Blast radiusが狭いと嘘になる場面
ここは私自身の運用上の留保で、書籍の記述ではありません。次のような変更ではblast radiusを狭く絞ると実在するリスクを隠します。
- クロスカッティングな関心事(ロギング、認証、フィーチャーフラグ): 変更が広く波及する種類のコードで、BFSが届かない所に影響が出ます。該当モジュールを明示的にタグ付けし、BFSの既定を上書きする運用で逃げます
- 設定ファイルやレジストリ経由の動的ディスパッチ: 静的なコールグラフが動的呼び出しのエッジを落とすので、構造上見えなくなります。動的呼び出しの補完(ランタイムログや呼び出しトレース)を2段目のパスとして足す必要があります
- 新規リポジトリの初回レビュー: モデルにコードベースの概観ができていないので、最初の数PRは広めに読ませて、学習が済んだらHopを締める、くらいの温度がよさそうです
これらは「blast radiusが万能ではない」という留保で、個別の閾値(どこから”utility function”扱いにするか、継承をどこで止めるか)は書籍にもcode-review-graphREADMEにも機械的な正解は書かれていません。自社の運用で可観測な数字を取りながら決めることになります。
明日から試す最小構成
1つのリポジトリで試すなら、5行で足ります。
- 言語を1つに絞る: PythonかTypeScriptが摩擦が最小です
- Tree-sitterで一度グラフを作る: 関数/クラスをノード、呼び出し/importをエッジに。SQLiteに吐く
- MCPサーバーで包む (またはCLIをagentにシェルアウトさせる): 変更ファイルのリストを受け取り、Hop 2集合を返す
- 動的ディスパッチと設定駆動のモジュールだけは例外として、明示的に広めに読ませる経路を残す
- 30日分のtoken請求を、前30日と並べて比較する: ベースライン次第ですが、中央値で6-7倍、全文読み込みを上限とすれば数十倍の差が出る想定です
AIにリポジトリを全部読ませる前に、「変更の2 hops分」でちゃんと答えが返るかを確かめる。それだけで、請求書の桁が1つ減ります。レビュー品質も、ノイズが減ることでむしろ上がる印象があります。
本記事で触れたblast radius分析の実装・MCP統合・落とし穴の詳細は、拙著ナレッジグラフ活用大全の第8-10章で、サンプルコードと一緒に書いています。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?