4社のAI検索を実測、仕組みも精度もばらばら
この記事の Kimi API の利用分は、Moonshot AI から評価用に提供されたクレジットを使っています。評価の設計・実行・結論に Moonshot AI は関わっていません。
5 か月前、SEOが壊れる日 という記事で、私の AI エージェントが Google ではなく Brave Search で調べていたことを書きました。そのときは、各社のウェブ検索を「どの検索エンジンを使っているか」で整理しています。ChatGPT は Bing、Claude は Brave、Gemini は Google、という具合です。
今回、Claude・Codex・Kimi K3・Qwen のウェブ検索を比べるために公式ドキュメントを読み直して、その整理の軸がもう合わないことに気づきました。4 社とも、検索エンジンの名前を公表していません。OpenAI は自社が維持する索引を Codex の既定にしていて、Kimi は検索そのものを単体の API として売り始めています。問いは「どの検索エンジンか」から、「検索がどこで動き、誰が呼ぶか」に移っていました。5 か月でここまで変わるとは思っていませんでした。
仕組みが変われば、結果も変わるはずです。測る前の私は、新しい情報を調べさせるならキャッシュより live の検索のほうが強いと思っていました。
Codex CLI のウェブ検索は、既定では live ではありません。OpenAI が持っている索引を引く「キャッシュ」モードで動きます。公式ドキュメントは理由を「プロンプトインジェクションのリスクを下げるため」と書いています (Codex: Web search)。安全のために、鮮度を少し諦めた設定だと私は読んでいました。
実際に測ると、逆でした。Claude、Codex (live / キャッシュ)、Kimi K3、ローカルの Qwen の 5 条件に同じ 8 問を 3 回ずつ聞いたところ、全問正解したのはキャッシュだけでした。しかも、公開から数時間しか経っていない記事のタイトルまで、キャッシュで取れています。
もう 1 つ意外だったのは、同じ検索 API を使っても、モデルで正解数が 21 と 9 に分かれたことです。Kimi K3 とローカルの Qwen に、Kimi の検索 API を同じ形で渡しました。検索結果は同じでも、それをどう読むかで答えが変わります。
4社のウェブ検索は「どこで動くか」が違う
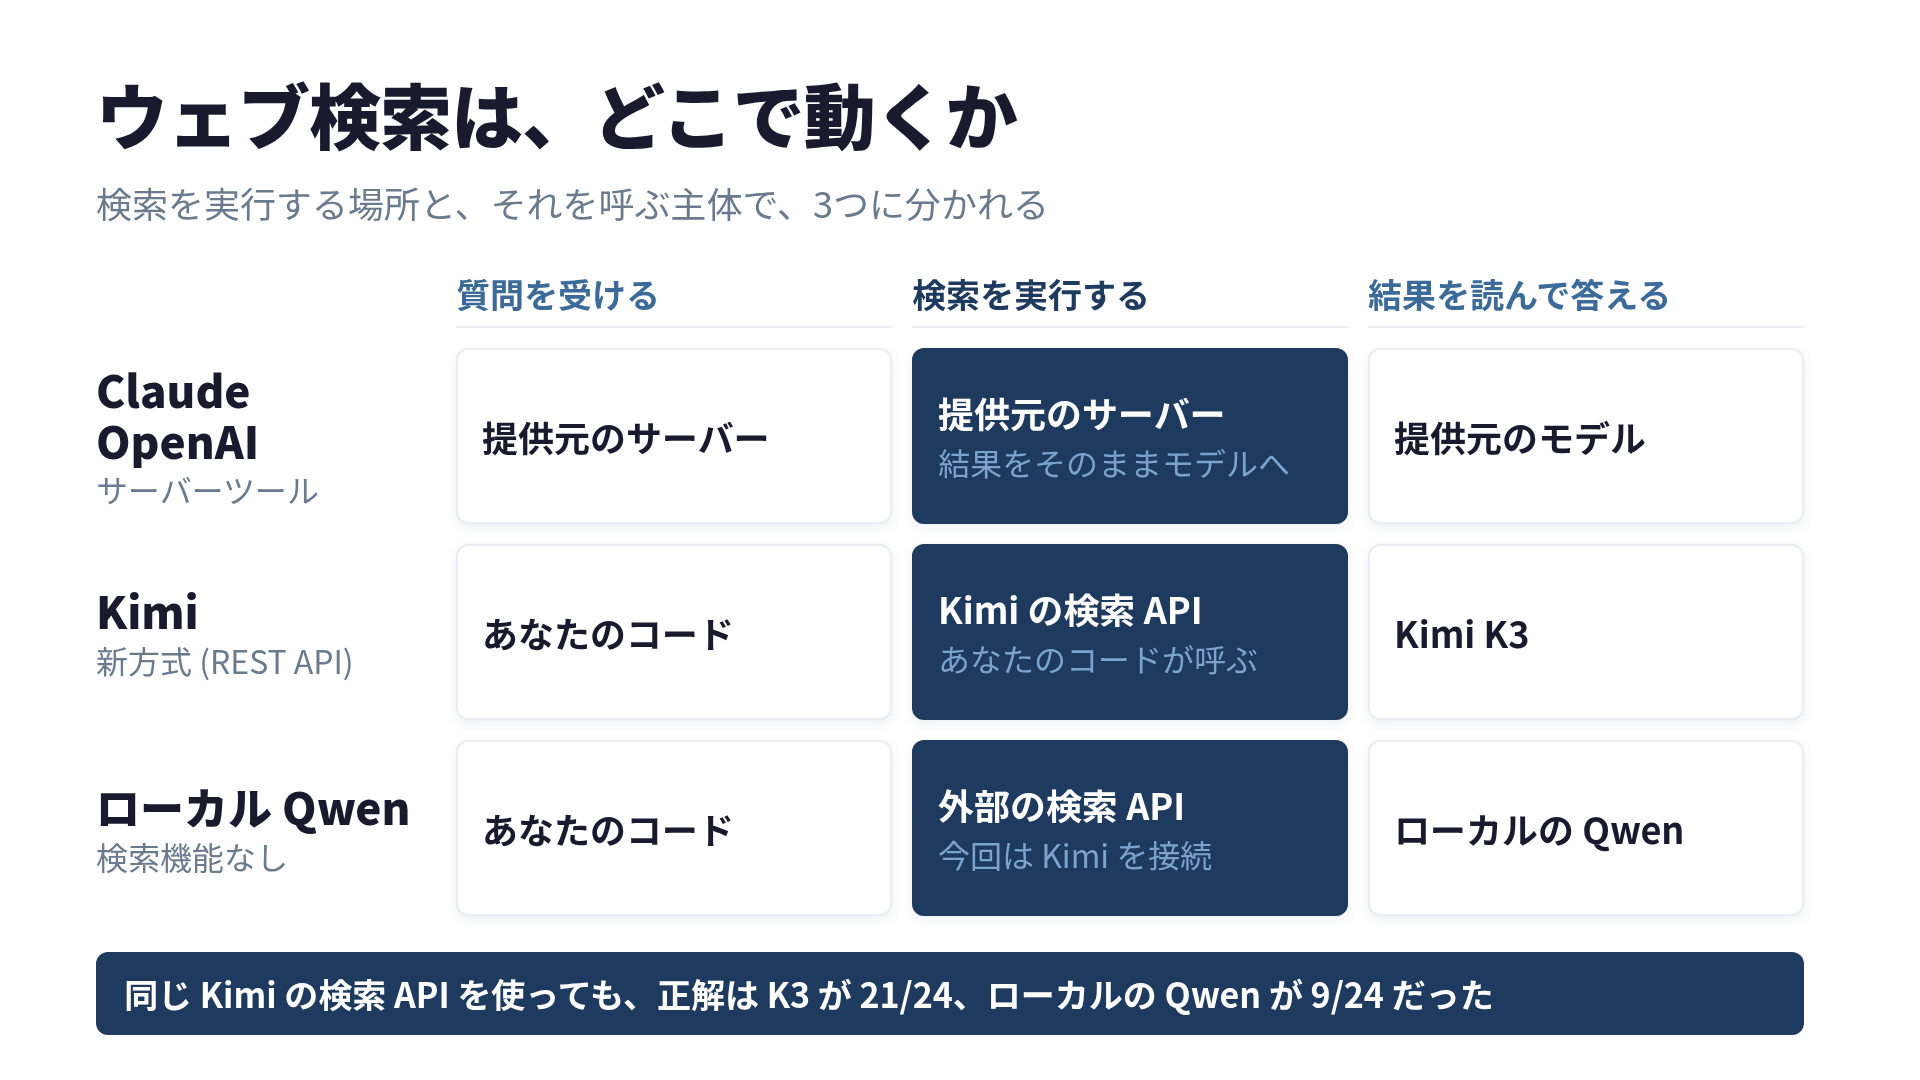
比べる前に、仕組みを公開資料で確かめました。一番大きな違いは、検索がどこで実行されるかです。
| Claude | Codex / OpenAI | Kimi (Moonshot AI) | Qwen | |
|---|---|---|---|---|
| 検索が動く場所 | Anthropic 側 (サーバーツール) | OpenAI 側 (ホスト型ツール) | 新方式は開発者が API を呼んでモデルに渡す | Alibaba 側 (DashScope)。ローカルの Qwen は検索なし |
| 鮮度の扱い | 指定なし | Codex は既定がキャッシュ、--search で live | Pro 検索に期間指定あり | 7〜365 日の期間指定あり |
| 検索 1 回の料金 | $0.01 | $0.01 | $0.002〜0.003 | リージョンで異なる |
| 検索エンジン | 非公表 | 非公表 (「OpenAI が維持する索引」) | 非公表 | 非公表 |
検索エンジン名は 4 社とも公式には出していません。Claude については、2025 年 3 月に Anthropic の委託先一覧へ Brave Search が加わったと報じられています (Simon Willison)。ただ、今の公式ドキュメントは「Anthropic の検索バックエンド」と書くだけで、名前を出していません。
Claude と OpenAI は、検索を自社のサーバーで回し、結果をモデルに渡すところまで面倒を見ます。Claude の場合、検索結果は暗号化された形で返り、会話を続けるときはそれをそのまま送り返す決まりです (Claude: Web search tool)。
Kimi は今、方式を切り替えている最中です。組み込みの $web_search は 2026-10-20 に廃止され、検索・ページ取得の単体 REST API (/v1/tools/search など) に移ります (Kimi API: Web Search)。新方式では、いつ・何回検索するかは開発者が決めます。料金は他社の 1/3〜1/5 で、成功して結果が返ったときだけ課金されます (Kimi: 料金)。
Qwen のモデルそのものには、検索機能がありません。Alibaba Cloud の API には検索がありますが、ローカルで動かす Qwen は、外部の検索をツールとしてつながない限り何も調べられません。
公開資料にあった、知らないと困る仕様
- Claude Code の WebSearch は、タイトルと URL しか返さない。 ページ本文は取りにいかず、読むときは WebFetch を使います。その WebFetch は、ページを別のモデルで要約してから渡す仕組みで、ドキュメント自身が「lossy by design (情報が落ちる設計)」と書いています (Claude Code: Tools reference)
- Qwen (Alibaba Cloud) の検索は、秒間 15 回を超えると黙ってスキップされる。 エラーにはならず、検索だけが実行されません。英語の質問では検索が発動しにくいので、中国語で聞くか検索を強制するよう、FAQ で案内しています。どちらも中国語版のドキュメントにだけ書かれています (阿里云: 联网搜索)
WebFetch の「情報が落ちる」は、この記事の下調べ中に私自身が踏みました。Qwen のドキュメントを Claude Code の WebFetch で読ませたら、「15 RPS の記述も英語の FAQ も見つからない」と返ってきました。生の HTML (約 460KB) を grep すると、両方ありました。要約を挟む以上、「書いていない」という答えは「要約に残らなかった」かもしれない、ということです。
測り方
5 条件に同じ 8 問を投げ、各 3 回、計 120 回の回答を採点しました (2026-10-14 夜)。
| 条件 | 中身 |
|---|---|
| Claude | Claude Code (claude -p) の WebSearch / WebFetch、Opus 5.5 |
| OpenAI live | Responses API の web_search、gpt-5.6-terra (手元の Codex CLI の既定モデル) |
| OpenAI キャッシュ | 同上 + external_web_access: false |
| Kimi K3 | kimi-k3 + 自作の search 関数 (中身は Kimi の /v1/tools/search) |
| Qwen ローカル | Ollama の qwen3.5:35b-a3b + 同じ search 関数 |
Codex は、CLI が内部で使っている API を直接呼びました。Codex のソースコードでは、キャッシュモードが external_web_access=false、live が true に変換されています (codex hosted_spec.rs)。同じ条件を API で再現した形です。
質問はこの 8 つです。正解は、私が一次資料や自分のサイトで確かめられるものに限りました。
| # | 質問 | 正解 | 見たいこと |
|---|---|---|---|
| q1 | Kimi K3 の API 公開日 | 2026-07-16 | 学習データより後のニュース |
| q2 | Kimi K3 の重みの公開日 (英語で「release date」) | 2026-07-27 | 「date」の罠 |
| q3 | 『MCP実践セキュリティ』(インプレス) の発売日 | 2026-10-16 | 日本語の情報源 |
| q4 | 当日 kenimoto.dev に出た Kimi K3 の記事のタイトル | Kimi K3の動画レビュー、Claudeと互角 | 公開から数時間の鮮度 |
| q5 | MCP 仕様 2026-07-28 版のリリース候補が出た日 | 2026-05-21 | 日付の事実 |
| q6 | Kimi の $web_search の廃止日 | 2026-10-20 | ドキュメントの細部 |
| q7 | Kimi K3 の総パラメータ数と activated の数 | 2.8T / 104B | 数値 |
| q8 | Kimi K4 のリリース日 | 未発表 | 存在しないものを作らないか |
q3 は私の本、q4 は私の記事です。答えを確実に知っている題材として選びました。そのぶん、題材の選び方に私の都合が入っていることは書いておきます。
結果
| 条件 | 正解 (24 問中) | 部分正解 | 誤り・回答なし | 所要時間 (中央値) | 検索回数 (平均) |
|---|---|---|---|---|---|
| Claude | 21 | 1 | 2 | 22.0 秒 | 3.5 |
| OpenAI live | 22 | 1 | 1 | 5.7 秒 | 2.3 |
| OpenAI キャッシュ | 24 | 0 | 0 | 6.2 秒 | 2.7 |
| Kimi K3 | 21 | 0 | 3 | 25.9 秒 | 4.0 |
| Qwen ローカル | 9 | 2 | 13 | 31.1 秒 | 1.7 |
問題ごとの正解回数 (3 回中) はこうなりました。
| 条件 | q1 | q2 | q3 | q4 | q5 | q6 | q7 | q8 |
|---|---|---|---|---|---|---|---|---|
| Claude | 3 | 2 | 1 | 3 | 3 | 3 | 3 | 3 |
| OpenAI live | 3 | 2 | 2 | 3 | 3 | 3 | 3 | 3 |
| OpenAI キャッシュ | 3 | 3 | 3 | 3 | 3 | 3 | 3 | 3 |
| Kimi K3 | 3 | 3 | 3 | 0 | 3 | 3 | 3 | 3 |
| Qwen ローカル | 0 | 2 | 0 | 0 | 0 | 2 | 3 | 2 |
存在しない Kimi K4 (q8) については、全条件が「未発表」と答えました。ただし Qwen は 1 回、「2027 年以降の計画として言及されている」と、出典のない話を付け足しています。
発見1: キャッシュは古くなかった
キャッシュは 24 問すべて正解でした。q4 の記事は当日 17 時過ぎに公開したもので、測ったのはその約 3 時間後です。それでもキャッシュは 3 回ともタイトルを答えています。正直、驚きました。「OpenAI が維持する索引」は、少なくとも私のサイトについては、数時間で更新されていました。
出典の質も、キャッシュのほうが良い場面がありました。q6 ($web_search の廃止日) で、キャッシュは Kimi の公式ドキュメントを出典にしています。live は、正解は同じでも、非公式のまとめサイトを出典に挙げた回がありました。live は検索できる範囲が広いぶん、公式でないページも拾います。
live が落としたのは q3 (日本語の書籍) の 1 回で、「その書名の本は確認できない」と答えました。
発見2: 検索結果が同じでも、モデルで答えが変わる
Kimi K3 とローカルの Qwen には、まったく同じ検索 API を同じ形で渡しています。それでも正解は 21 と 9 に分かれました。倍以上の差です。
Qwen の誤りには、繰り返し出てくる型がありました。
- 「今は 2024 年」という思い込みが、検索結果に勝つ。 q4 では「現時点 (2024年5月) では、2026年10月14日の記事は存在しない。未来の日付です」と答えました。q1 でも、検索で 7/16 という日付を見つけながら、「2025年現在では未公開」と結論しています
- 出典と答えが食い違う。 q5 では 3 回とも、リリース候補の告知ページ (5/21 付) を出典に挙げながら、正式版の日付 (7/28) を答えました
- 出典を作る。 q3 では、存在しないインプレスのニュースリリースの URL (404) を出典に、誤った発売日を答えました。3 回とも違う誤った日付でした
- あまり検索しない。 検索回数の平均は 1.7 回で、K3 (4.0 回) の半分以下です
モデルの大きさの差もあるので、Qwen というモデル全体の評価ではありません。言えるのは、ウェブ検索の精度は検索 API だけでは決まらないということです。
発見3: Kimi の検索 API には穴が2つある
K3 の失点は 3 回とも q4 でした。言い回しを変えて 12 回検索しても、当日の記事は見つかりませんでした。Kimi の検索の索引に、まだ入っていなかったようです。原因はモデルにはありません。索引の鮮度です。
もう 1 つは、site: 演算子を含むクエリで HTTP 502 が返ることです。K3 も Qwen も、特定のサイトを探すときに site:kenimoto.dev を使おうとしました。そのたびに検索 API が JSON ではないエラーページを返し、最初の実行では私のスクリプトごと落ちました。今は失敗をモデルに伝え、別の言い回しで探し直せるようにしています。
検索 API を直接叩いて試したときには、言葉の選び方で結果が大きく変わることも分かりました。「Kimi K3 release date Moonshot AI」で検索すると、「date」に引っ張られて、時刻のサイトや JavaScript の Date の解説ばかりが返ってきます。「Kimi K3」だけなら、公式サイト・論文・GitHub が上位に来ます。ただ、本番の比較ではこの罠を踏んだモデルはいませんでした。K3 も Qwen も、自分でクエリを言い換えて回避しています。
ちなみに、廃止予定の組み込み $web_search は、K3 では動きませんでした。検索結果を返す 2 回目の呼び出しが、毎回 400 tokenization failed になります。今回のように通常の function calling で検索を渡す形なら、K3 でも問題なく動きます (詳しくは Kimi K3の動画レビュー、Claudeと互角 に書きました)。
Claude は日本語の書籍に弱かった
Claude は q3 で 3 回中 2 回、「その書籍は見つからない。出ていない可能性がある」と答えました。実際には、インプレス NextPublishing の書籍ページや楽天ブックスなどに、発売日つきで載っています。
一方で、粘り強さはありました。q4 で WebSearch に記事が出てこなかった回には、サイトマップから記事を探し、ページ本体を開いてタイトルと公開日を確かめています。WebSearch がタイトルと URL しか返さないぶん、必要ならページを取りにいく設計が効いた形です。回答に「二次情報しか確認していない」と注記する回も多く、断定を避ける書きぶりでした。
所要時間の中央値 22 秒は、Claude Code のエージェントとしての処理込みの数字です。API で検索ツールを直接呼べば、もっと短くなるはずです。
どう使い分けるか
今回の結果から、私はこう使い分けることにしました。
- 調べ物の既定は、キャッシュのままでいい。 Codex を使うなら、
--searchを常時付ける必要はありませんでした。安全側の設定が、精度でも負けていません - 日本語の書籍や国内の情報は、答えを鵜呑みにしない。 「見つからない」は「存在しない」ではありません。Claude がそう答えたら、別の手段で確かめます
- 検索を自分でつなぐなら、モデル選びのほうが効く。 同じ検索 API でも、K3 と Qwen で正解が倍以上違いました。安い検索 API を選ぶより先に、検索結果を読めるモデルを選びます
- 自前の検索ツールは、失敗を返せるように作る。 Kimi の検索 API は
site:で 502 を返します。例外で落とさず、モデルに失敗を伝えれば言い換えて探し直します
限界
- 8 問 × 3 回の小さな比較です。題材は Kimi K3 と MCP に偏っていて、q3 と q4 は私自身の本と記事です
- Claude は Claude Code 経由、Codex は CLI が内部で使う API を直接呼んだ結果です
- Qwen はローカルの 35B モデルに Kimi の検索をつないだもので、Qwen の公式の検索ではありません
- 所要時間は条件ごとに仕組みが違うので、単純には比べられません。費用はこの比較では集計していません
次は、Claude を API の検索ツールで直接呼び、Qwen を Alibaba Cloud の公式検索で試して、今回の条件の差を埋めるつもりです。
References
- Claude: Web search tool: 料金、引用、暗号化された結果、版
- Claude Code: Tools reference: WebSearch と WebFetch の挙動
- Codex: Web search: キャッシュ / live のモード
- OpenAI: Web search tool:
external_web_access - openai/codex hosted_spec.rs: モードと
external_web_accessの対応 - Kimi API: Web Search / 検索のベストプラクティス / 料金
- 阿里云 百炼: 联网搜索 (中国語版。15 RPS と英語の質問の FAQ はこちらにのみ記載)
 関連書籍 ローカルLLMで足りる仕事、Claude Codeに任せる仕事 依頼の96%はローカルに回せなかった。1ステップずつに下ろすと、半分が回せた 書籍ページを見る →
この記事は役に立ちましたか?