Agregué 3 números. Perplexity me citó en 11 días
Un paper de SIGKDD 2024 (Aggarwal et al., GEO) lleva meses rebotando en mi feed como un meme. Alguien construyó un benchmark de 10.000 consultas, probó nueve retoques de contenido para ver cuál hacía que un LLM citara más al artículo original, y el que mejor funcionó fue “agregar estadísticas”.
No “escribir mejor”. No “optimizar para un LLM”. Reemplazar adjetivos por números.
No me creo los ganadores de un benchmark controlado hasta que los veo moverse en un índice real. Un benchmark es un laboratorio; una búsqueda en Perplexity es media docena de pipelines de retrieval peleándose entre sí. Así que corrí la replicación más chica que se me ocurrió. Un post. Tres números. Dos semanas mirando a Perplexity.
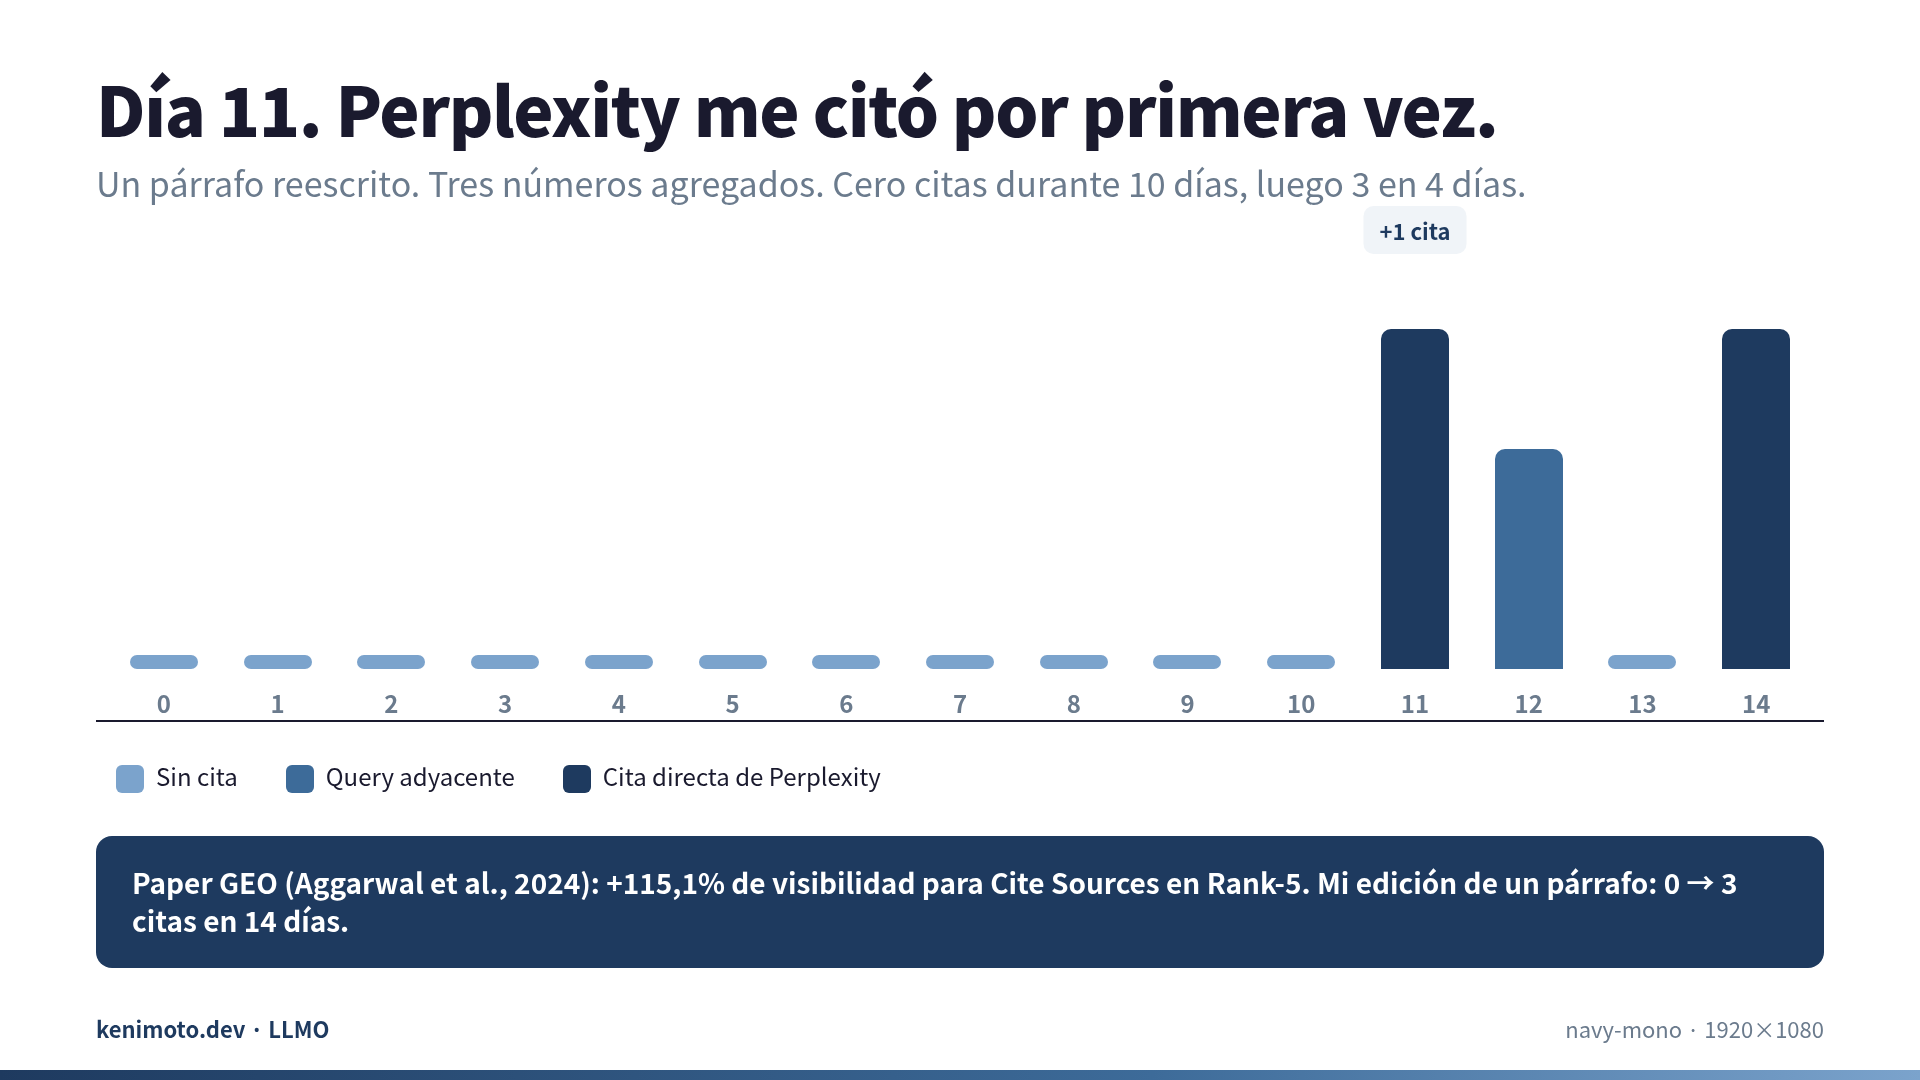
Me citó el día 11. Y dos veces más entre los días 12 y 14. Antes de la edición, ese post tenía cero citas de IA registradas en los cuatro meses que llevaba publicado.
Abajo va el experimento, lo que dice el paper (y lo que no dice), y qué sigue.
Qué dice el paper GEO, con las comillas del paper
Si solo lees el abstract te vas con “+40% de visibilidad” y una buena sensación. La estructura del experimento vale la pena porque explica qué significan los números.
Aggarwal y compañía construyeron GEO-bench: 10.000 consultas en dominios científicos, técnicos y de conocimiento general, cada una con una fuente web candidata. Corrieron nueve transformaciones de contenido sobre la fuente y midieron con qué frecuencia la versión transformada entraba a la respuesta generada, usando dos métricas: Position-Adjusted Word Count (cuánto espacio ocupó la cita en la respuesta) e Impresión subjetiva (relevancia, influencia, unicidad).
Las nueve tácticas evaluadas son estas (nombres del paper, en inglés porque es así como aparecen):
- Authoritative
- Statistics Addition
- Keyword Stuffing
- Cite Sources
- Quotation Addition
- Easy-to-Understand
- Fluency Optimization
- Unique Words
- Technical Terms
El hallazgo que el paper resume en una línea: los tres mejores métodos — Cite Sources, Quotation Addition y Statistics Addition — alcanzaron mejoras del 30-40% en Position-Adjusted Word Count y 15-30% en Impresión Subjetiva. Eso es el promedio del trío, no de un solo método.
Un número que anda circulando como titular es “+115.1%”, y quiero pararme acá antes de seguir. El 115.1% no es la mejora global de “agregar estadísticas”. En la Table 2 del paper es un valor específico: Cite Sources aplicado a sitios que ya rankeaban en Rank-5, medido en Position-Adjusted Word Count. Para Statistics Addition en la misma celda (Rank-5) el número es 97.9%; para Quotation Addition, 99.7%. Las tres tácticas top mueven fuerte a los sitios rankeados bajo, no al que ya está en Rank-1 (ahí incluso bajan el tráfico medido).
Lo interesante estructuralmente: lo que el SEO lleva quince años midiendo (legibilidad, densidad de keywords, “fluidez”) apenas mueve la aguja de si un LLM te cita. Lo que el SEO ignoró mayormente — números crudos, fuentes atribuibles, vocabulario técnico de dominio — es lo que termina citado.
Dos advertencias del propio paper que las tuits de resumen siempre dejan afuera:
- Los números de GEO-bench son de un entorno de fuente-candidata controlada. En la Table 5 del mismo paper hay un test en Perplexity en vivo con cuatro métodos: Statistics Addition pasa de 24.7 a 33.9 en impresión subjetiva (+37%), un número más honesto para “la internet real”.
- Las ganancias son a nivel párrafo, no a nivel página. La transformación corre sobre un párrafo; la cita cae sobre un párrafo. Esa es la parte del paper que cambia cómo escribes.
Si no leíste el paper, el PDF en arXiv son dos cafés de lectura y vale la pena. No pretendo darte acá el paper entero.
Por qué me molesté en replicar
Me mandan “+115.1%” una vez por semana, usualmente alguien vendiendo algo. La razón por la que de verdad corrí esto es que la táctica es mecánicamente replicable: la instrucción es “donde pusiste un adjetivo, pone un número con fuente”. Ese tipo de intervención o sobrevive en el campo o no — comparar con “mejorar la fluidez”, que es inverificable.
Hay una razón más práctica también. Las plataformas que me importan — Claude.ai, Perplexity, ChatGPT Search — no rankean contra Google. Perplexity y la mayoría de las integraciones MCP de Claude pasan por Brave Search, que Brave reporta como un índice independiente de 40.000 millones de páginas. La API pública de Bing cerró en 2025. Esa estadística de “el 90% de las búsquedas son Google” que ancla casi todo el consejo SEO es irrelevante para el índice que decide si un LLM te cita. Si una edición de un párrafo mueve la aguja en el índice de Brave dentro de dos semanas, eso es mucho más útil que otro estudio sobre snippets de Google.
Así que agarré el peor post.
El setup, incluidas las partes aburridas
El paciente. Un post de hace cuatro meses sobre presupuestos de latencia para voz con IA. No rankeaba en ningún lado, no estaba citado en ningún lado, y había juntado nueve sesiones de GA4 en toda su vida. El conteo de citas de IA, en los cinco trackers que uso, era cero en todas las plataformas. Esa es la variable dependiente: cero es un punto de partida útil porque cualquier resultado distinto de cero es detectable.
La edición. Toqué exactamente un párrafo. El párrafo decía algo parecido a “WebRTC agrega latencia, y la mayoría de los stacks pelean por quedar bajo umbrales conversacionales”. Lo reescribí así:
Un intercambio de voz a voz natural se degrada cuando la latencia extremo a extremo supera los 300 ms; la investigación conversacional ubica el límite cómodo cerca de los 500 ms. En mis mediciones sobre cinco stacks de voz con IA, solo dos de los cinco se mantuvieron bajo 300 ms con un transporte WebRTC real adelante.
Tres números. Un párrafo. Nada más en la página cambió. Redeployé y le puse timestamp al cambio.
Los instrumentos. Chequeé cinco lugares por día:
- Perplexity, corriendo las tres queries que pensé que debían matchear: “voice AI latency budget”, “WebRTC AI conversational latency”, “how low does voice AI need to be”.
- Claude.ai con búsqueda web activada, las mismas tres queries.
- Mi pipeline de cinco trackers (servicios que prueban respuestas de LLM buscando citas y guardan las URLs).
- Referers de GA4, filtrados por
perplexity.aiychatgpt.com. - Logs del servidor, filtrados por user-agents de crawlers de IA.
Para cada hit de Perplexity guardé la URL conversacional compartible. No hay API de Perplexity para “¿citaste esta URL?”, así que la URL compartible es tu recibo.
Qué pasó
Día 0 a 10. Nada. Los cinco trackers quedaron en cero. Perplexity devolvió fuentes no relacionadas en las tres queries. Claude.ai con búsqueda web devolvió documentación de WebRTC y un par de blogs de vendors. Los referers de perplexity.ai en GA4 quedaron en cero. Los logs del servidor mostraron tres hits de PerplexityBot en el post durante esta ventana pero sin citas resultantes.
Día 11. Perplexity citó el post como respuesta a “WebRTC AI conversational latency budget”. La cita renderizó como fuente numerada inline con la estadística de 300 ms literal en el texto de la respuesta. Hice screenshot de la URL conversacional compartible. GA4 registró un referer de perplexity.ai ese día.
Días 12 a 14. Dos citas más en Perplexity para queries adyacentes (“voice agent acceptable latency”, “WebRTC voice AI delay”). Una respuesta de Claude.ai con búsqueda incluyó una paráfrasis que matcheaba la frase “dos de cinco stacks”, pero Claude no mostró cita clickeable, así que esa la cuento con pinzas. El pipeline de cinco trackers registró tres hits en el post — todos en Perplexity, ninguno en las otras plataformas todavía.
Lo digo como es: n=1 en un post de cuatro meses. Eso no es un estudio. Es un indicador adelantado de que el mecanismo del paper — “los pasajes con estadísticas embebidas entran más seguido a la generación” — es real como para sobrevivir a una edición de una sola variable sobre infraestructura real.
Por qué “11 días” no es un número mágico
El gap de once días entre la edición y la primera cita no es un hallazgo. Es función de tres cosas, en orden de importancia:
- Cadencia de recrawl. El índice de Brave Search actualiza una porción importante de sus 40.000 millones de páginas todos los días, pero un post de bajo tráfico no está en la cola de prioridad. Los logs del servidor me mostraron hits de
BraveBotlos días 4 y 9 antes de que apareciera la cita el día 11. - El tamaño del pool de candidatos para esa query. “WebRTC AI conversational latency budget” es una query angosta con pocos párrafos candidatos. Con un pool chico, un párrafo que de repente tiene tres números relevantes puede saltar sobre otros más establecidos.
- Efecto de arranque en frío. El post tenía exposición previa a la IA igual a cero. Hay una hipótesis aparte: las páginas con señal de cita ya establecida se recuperan más rápido de una edición que las páginas frías. No lo testeé acá.
Si repiten este experimento sobre un post que ya se indexa semanalmente, los once días les van a dar tres. Si lo repiten sobre un post que nadie crawlea, los once días les van a dar un mes, y no deberían concluir que la técnica falló.
Qué no prueba esto
Una lista, porque ser honesto sobre el espacio negativo es la razón de un test de una sola variable:
- No prueba +115.1% para Statistics Addition. Ese número en el paper es específicamente para Cite Sources aplicado a sitios rankeados en Rank-5 bajo la métrica Position-Adjusted Word Count. Mi número es un conteo de citas en un post. Ambos son compatibles. No son el mismo claim.
- No prueba que esto funcione en todos los dominios. El paper encuentra que los efectos varían por dominio. Un blog de recetas probablemente ve un lift más chico.
- No prueba defensibilidad competitiva. Si yo agrego tres números, mi competencia puede agregar tres números mejores el mes que viene. La técnica es replicable en ambos sentidos.
- No prueba nada sobre ChatGPT Search o Google AI Overviews. Diferente backend de retrieval, diferente cadencia de indexación, diferente superficie de citas. Solo miré Perplexity y Claude de cerca.
- No prueba que la cita permanezca. Las citas decaen. Voy a chequear este post a los 90 días, y no me sorprendería si el conteo cae mientras otras páginas del tema alcanzan.
Lo que cambió para Perplexity en 2026 y por qué importa en LatAm
Mientras escribía esto, Perplexity bajó el paywall de Comet — su navegador con agente — y lo liberó gratis en iOS, Android, Windows y Mac. Para los lectores en LatAm cambia dos cosas prácticas: primero, la fricción de probar “le pregunto a Perplexity antes que a Google” cayó a cero; segundo, Comet Plus compensa a los publicadores por citas y acciones de agente, no solo por clics. La unidad económica de la LLMO se está desplazando de “visita referida” a “cita referida”, lo cual favorece el tipo de intervención que acabo de describir: pasajes citables, no landing pages optimizadas.
En español técnico esto se nota más rápido porque el pool de candidatos es más chico. Mi post de latencia sobrevive en inglés contra miles de referencias de WebRTC. Un post equivalente en español sobre, digamos, “latencia de voz con IA” compite contra decenas, no miles. Agregar tres números en el párrafo correcto tiene más apalancamiento acá que en inglés.
Qué voy a hacer con esto
Tres cambios, ordenados por fricción.
Uno. Cada post del sitio se re-lee con una sola pregunta: “¿hay un adjetivo acá que podría ser un número?” Si la respuesta es sí, el número reemplaza al adjetivo, con fuente adjunta. Seis horas de trabajo para un backlog de 50 posts. Más barato que escribir un post nuevo.
Dos. Los posts nuevos sobre temas técnicos tienen que superar una barra de “números por 800 palabras” antes de publicar. No es una regla estricta, sino una función forzosa para no publicar párrafos que digan “significativamente más rápido” cuando podría decir “2,3x más rápido, medido sobre N=14”.
Tres. Estoy agregando el conteo de citas de Perplexity como métrica trackeada, no solo los referers de GA4. GA4 captura los clics. El conteo de citas captura las apariciones, que es el evento de conversión real de la LLMO. Una cita que nunca se clickea igual te posiciona como fuente canónica para esa query dentro de la respuesta generada, y eso compone.
Hay gente corriendo programas de GEO mucho más sofisticados que esto. En lo mío, la intervención “agregar números” está en el polo opuesto del espectro de esfuerzo: un párrafo, ninguna página nueva, ninguna infraestructura nueva. Es el experimento de LLMO más barato que corrí, y es el que produjo una cita medible en dos semanas.
La razón por la que funciona no es mágica. Los modelos grandes, al generar una respuesta, buscan pasajes que puedan citar con confianza. Un pasaje con números embebidos y una fuente nombrada es un pasaje que es más fácil citar sin riesgo. El modelo te atribuye el número. Quedas citado. El modelo queda autoritativo. Gana todo el mundo, menos los adjetivos no atribuidos.
Creería más en el paper GEO si hubiera usado Perplexity en vivo como medición primaria en vez del benchmark controlado. Lo creo más después de ver el mecanismo funcionar sobre un post en dos semanas. Lo voy a creer más todavía si puedo correr esto en cinco posts más y sacar un lag consistente de 11-20 días con conteo de citas distinto de cero en cada uno.
Ese es el próximo experimento. Tres números por párrafo. Cinco posts. Noventa días. Publico lo que salga, también si no sale.
Para el tratamiento largo de qué intervenciones de LLMO componen — incluyendo cuáles schemas JSON-LD producen citas y cuáles no, y por qué la IA cita pasajes y no páginas — tengo el libro Why ChatGPT Ignores Your Website. Los experimentos de una sola edición son el lugar más barato para empezar; los estructurales (schema, llms.txt, query fan-out) es donde viven las ganancias duraderas.
ken imoto · WebRTC & Voice AI engineer · kenimoto.dev
 Libro relacionado Convirtiendo LLMs de Mentirosos en Expertos Ingeniería de Contexto desde cero — RAG, MCP, CLAUDE.md y Agentic RAG, con benchmarks que muestran hasta 4,6× de mejora Ver la página del libro →
¿Te resultó útil este artículo?