Few-shotは誠実さを3.7→5.0に上げる
拙著『コンテキストエンジニアリング』第5章の実験に当たったとき、Few-shotに対する私の理解がひとつずれていたことに気づきました。例を見せて知識を補う技術、としてずっと扱ってきたことです。Few-shotで Factual Accuracy は動かなかったのです。
0.0のまま。
動いたのは Honesty、「知らないことを知らないと認める」という態度の指標でした。
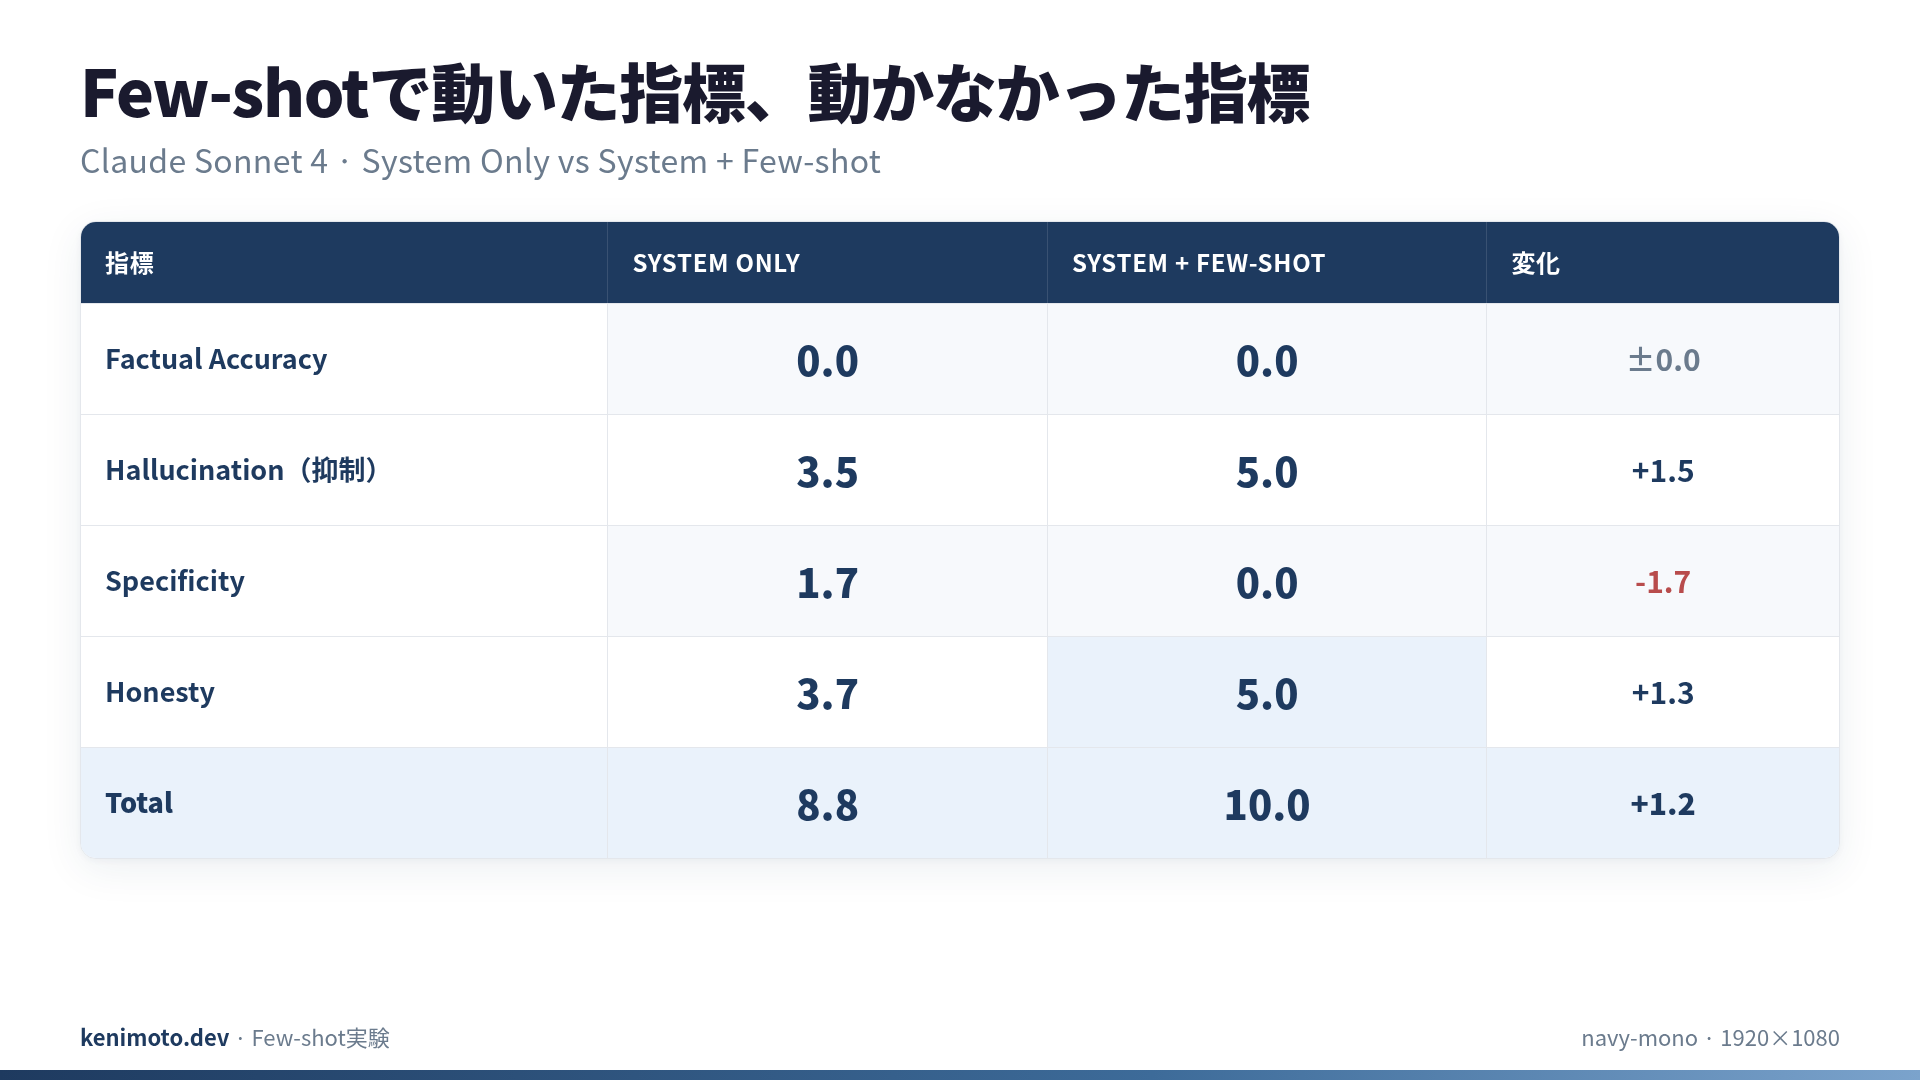
実験で動いた指標、動かなかった指標
本書第5章では、Claude Sonnet 4 と Haiku 3 に対し、System Prompt のみのプロンプトと、System + Few-shot examples のプロンプトを比較しました。
Sonnet 4 の結果は次のとおりです。
| 指標 | System Only | System + Few-shot | 変化 |
|---|---|---|---|
| Factual Accuracy | 0.0 | 0.0 | +0.0 |
| Hallucination(抑制) | 3.5 | 5.0 | +1.5 |
| Specificity | 1.7 | 0.0 | -1.7 |
| Honesty | 3.7 | 5.0 | +1.3 |
| Total | 8.8 | 10.0 | +1.2 |
「Few-shot で知識を注入した」という仮説で読むと、Factual Accuracy が 0.0 → 0.0 のまま動かないのが説明できません。一方で、Honesty は 3.7 から 5.0 まで上がっています。「知らないときにそれを認めるかどうか」を測る指標です。Specificity が 1.7 から 0.0 に下がっているのも、同じ説明で見えてきます。知らないことに具体的な推測を書かなくなった副作用です。
モデルに教わっているのは知識ではない。
「知らないときに知らないと言う」という態度のほうだったわけです。
誠実さを教えるとは、具体的に何か
Few-shot example の中身をのぞくと、理屈が見えてきます。本書ではカスタマーサポートの応答に、こういう3つの例を置いています。
- 「返金ポリシーについては最新の利用規約をご確認ください」(知らない時は認める)
- 「アプリのクラッシュは以下の手順をお試しください」(手順は具体的に書く)
- 「新機能の具体的なリリース予定についてはお答えできかねます」(未確定情報は曖昧化しない)
モデルがユーザーに「わかりません」と答えるのは、プロンプト内で「わからないと言っていい」という例を2回見せられているからです。学習データの統計から来ている話ではありません。
RAGやfine-tuningの仕事とは重ならない領域です。RAGは外から事実を持ち込む。fine-tuningはモデルの振る舞いを恒久的に書き換える。Few-shotがやっているのは、その場かぎりで「このケースではこういう態度で答えてね」と頼むことです。
Haiku 3 でも効くが、カーブは浅い
Haiku 3 の結果は Sonnet とは少し違いました。
| 指標 | System Only | System + Few-shot | 変化 |
|---|---|---|---|
| Factual Accuracy | 0.0 | 0.0 | +0.0 |
| Hallucination(抑制) | 0.7 | 3.5 | +2.8 |
| Specificity | 0.3 | 1.2 | +0.9 |
| Honesty | 2.7 | 3.5 | +0.8 |
| Total | 3.7 | 8.2 | +4.5 |
Honesty の改善幅は、Sonnet が +1.3 で Haiku は +0.8。モデルサイズが小さいほど Few-shot の学習キャパシティが狭いという、素直な結果です。Totalで見るとHaikuのほうが+4.5と大きく伸びています。ここは注意が要ります。HaikuはSystem Only時点の総合点が低い(3.7)ところから出発しているので、「HaikuのほうがFew-shotが効く」というより「HaikuはFew-shotなしだと土台が弱い」と読むのが実態に合っています。
変えられるものと、変えられないもの
本書の実験で見えてきたFew-shotの役割を、ひとまず3つに分けておきます。
- フォーマット制御: 出力の構造を揃える (JSON形式での返答など)
- トーン調整: 口調や丁寧さを揃える
- 態度指導: 知らない時にどう振る舞うかを揃える
逆に、Few-shotで変えられないものがあります。事実精度(Factual Accuracy) です。実験で指標が 0.0 → 0.0、まったく動いていません。
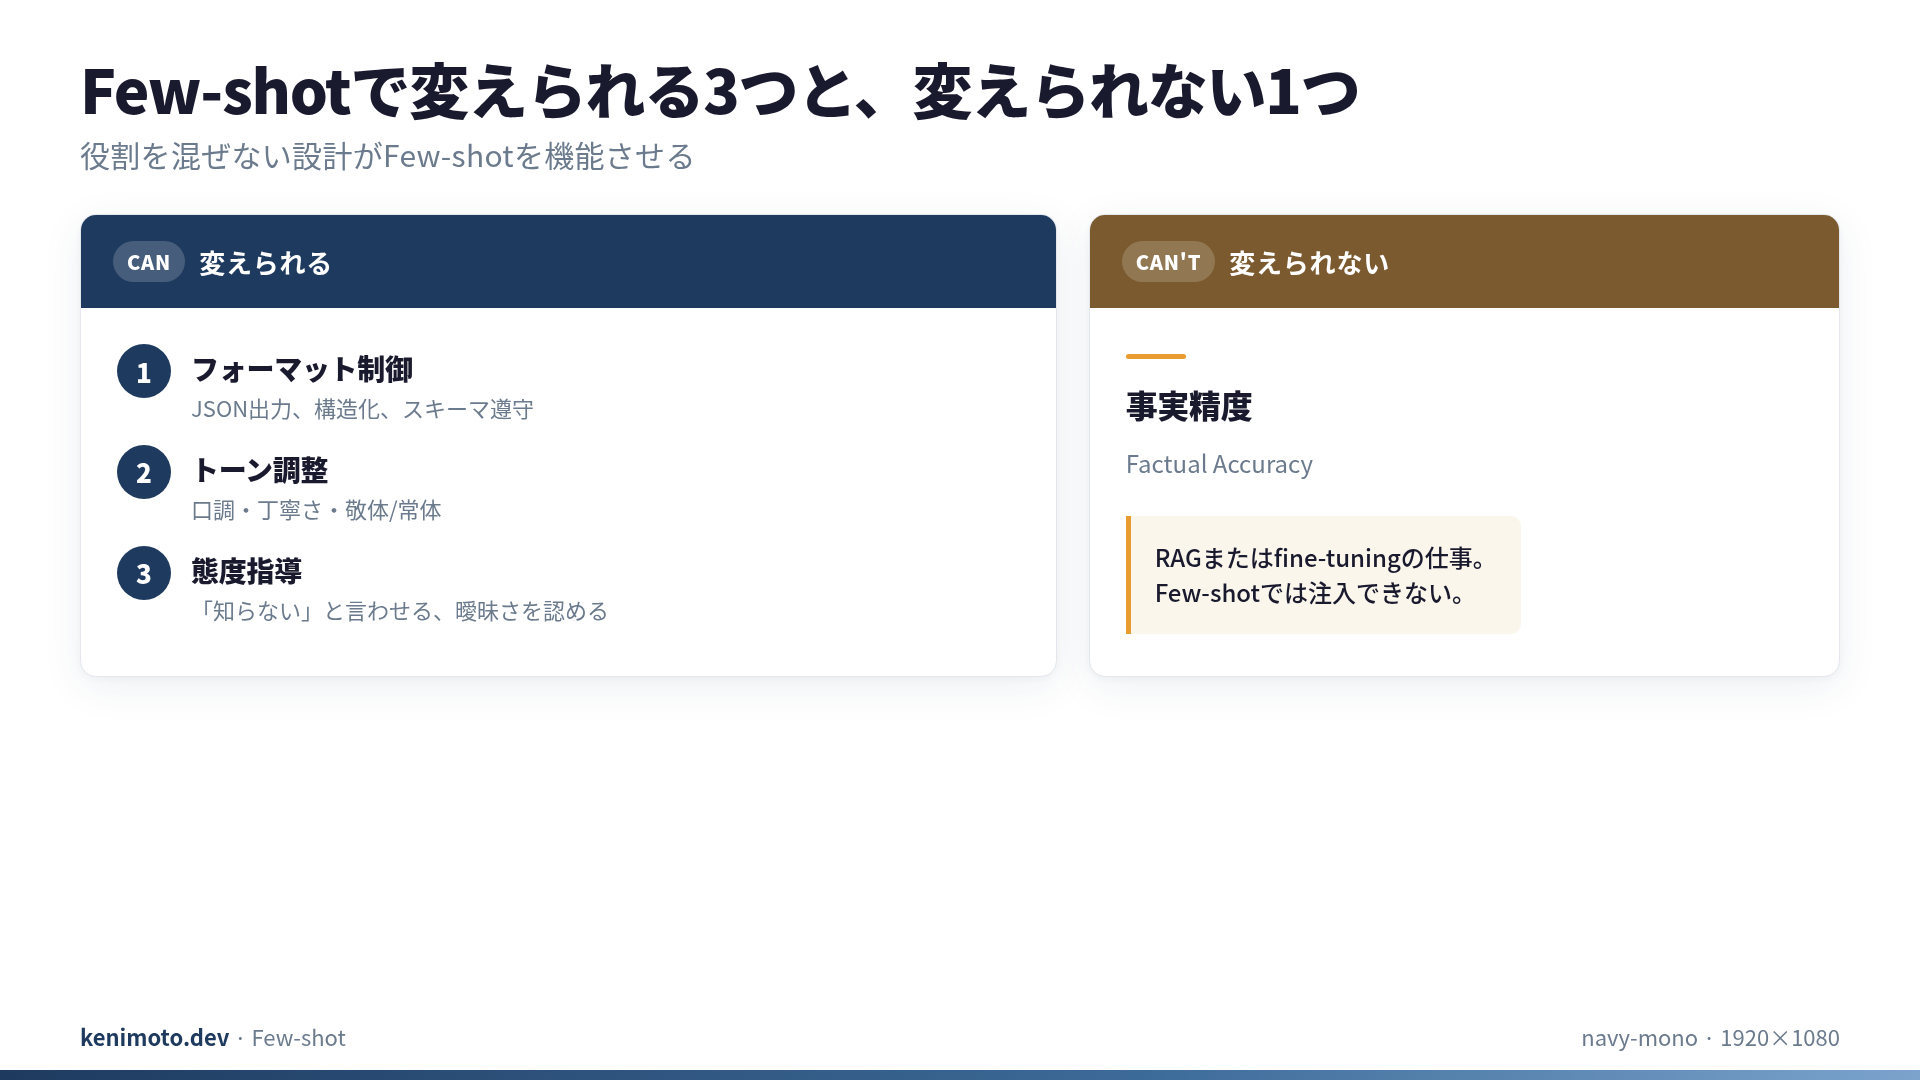
ここを読み違えると、プロンプトにいくら「正しい情報」を例として積んでも Factual Accuracy は上がらない、という時間の使い方をしがちです。知識を足したいならRAG、振る舞いを恒久的に変えたいなら fine-tuning、その場の態度を揃えたいなら Few-shot。それぞれ担当を分けて使います。
例の数は1〜3で止める
本書で示されているもう一つの実用的な判断があります。「Few-shot example は多ければ良いわけではない」。
- 1-shot: フォーマットが決まっている場合に最短。JSON出力など
- 3-shot: 正常ケース・エラーケース・境界ケースを揃える用途。多様性と効率のバランス
- 5-shot: コンテキスト肥大のコストが効くので、基本的には避ける
私は実務で3-shotを上限にしています。5つ目のexampleを書きたくなるようなときは、だいたい System Prompt側のルールが曖昧になっているサインです。
使うときにやっていること
Few-shotの設計で私が守っている3点を書いておきます。
- 「知らない」の例を必ず入れる (でないと Honesty は動かない)
- 悪い回答の例を書かない (コンテキスト汚染の典型。参照されて品質が下がる)
- exampleを書いたら、exampleの数字と最新の仕様が食い違っていないかを月1回見直す
Few-shotは軽い技術です。「何を揃える技術で、何を揃えない技術か」を取り違えると、投入したトークンが遊びます。
本書第5章の実験結果 (Honesty 3.7→5.0 / Factual Accuracy 0→0) は、その境界を数字で見せてくれるケースでした。
参考
- 拙著『コンテキストエンジニアリング実践入門』第5章「Few-shot Examples: AIにお手本を見せる」 — 本記事の実験データ出典
- Claude Sonnet 4 / Haiku 3 — 実験対象モデル
Few-shotと RAG、Context Window 管理、エージェント設計まで通した設計論は『コンテキストエンジニアリング実践入門』にまとまっています。
 関連書籍 LLMを「嘘つき」から「専門家」に変える技術 Context Engineering 実践入門 | RAG・MCP・CLAUDE.md・Agentic RAG をベンチマークで体系化 書籍ページを見る →
この記事は役に立ちましたか?