RAG評価はFaithfulnessを50%に
RAGの評価方法を調べると、だいたい同じレシピに行き着きます。Faithfulness(忠実性)、Relevancy(関連性)、Correctness(正確性)の3軸を、同じ重みで見る。左右対称で収まりがよく、社内で使うRAGにそのまま持ち込むと危ないレシピです。
社内でRAGが動き始めると、問題は「答えられるか」から「嘘をつくか」に変わります。社内での嘘は、RAGへの信頼を削り、毎回の裏取りという無駄な工数を利用者に強制します。少し的外れな回答なら聞き直せば済むのに、両者を同じ重みで採点しています。
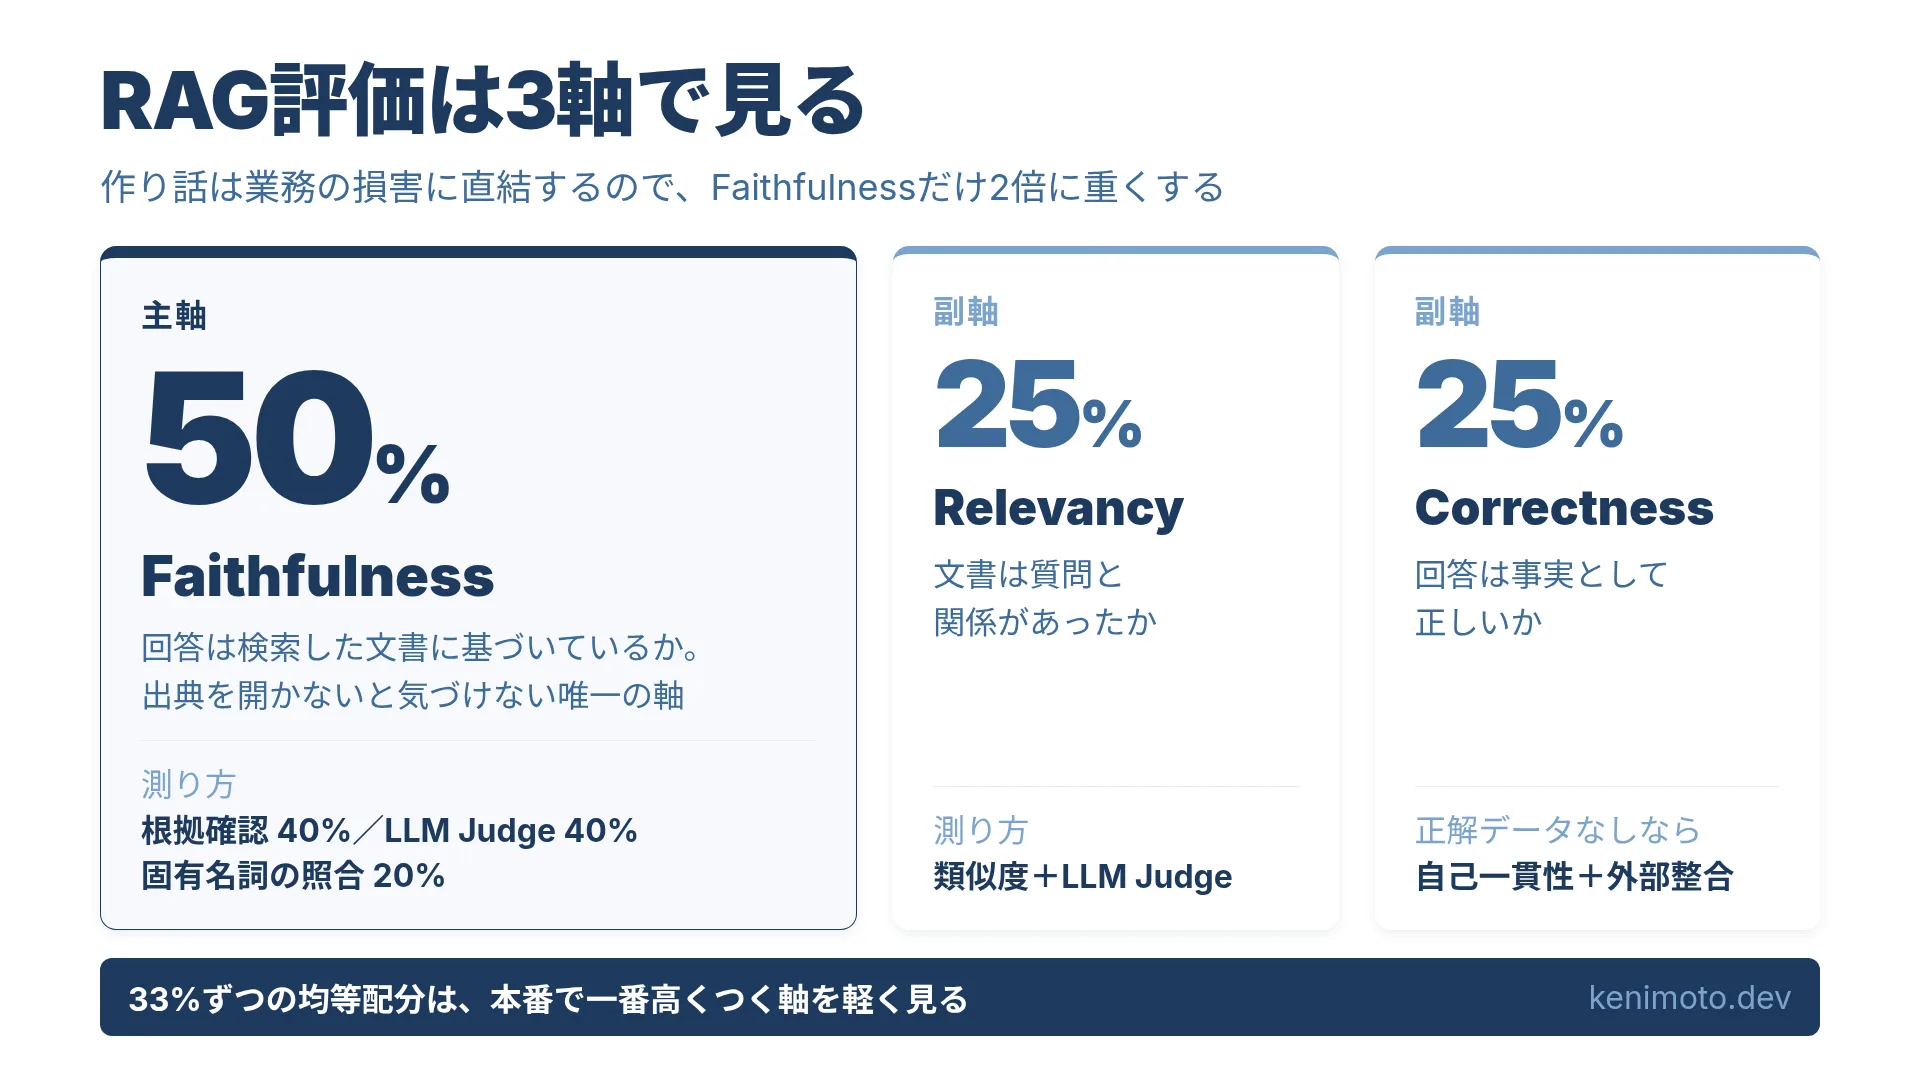
私は自分の本『LLMを「嘘つき」から「専門家」に変える技術 — Context Engineering 実践入門』で、3軸の重みを Faithfulness 50% / Relevancy 25% / Correctness 25% にするよう勧めています。本では「忠実性を最重視」と書いていて、数字にするとFaithfulnessだけ2倍です。正解データがなくても測れる形にしてあります。
3軸を1行ずつ
- Faithfulness: 回答は検索してきた文書に基づいているか。それとも作ったか
- Relevancy: 検索してきた文書は、そもそも質問と関係があったか
- Correctness: 回答は現実の事実として正しいか
3つとも要りますし、どれも他の軸の代わりにはなりません。ただ社内のRAGでは、作り話がそのまま業務の損害になります。存在しない契約条件、でっち上げた売上の数字、どこにも書いていない復旧手順。どれも会社が負うリスクです。
33%ずつにしない理由
それぞれの軸が崩れたときの最悪のケースを並べます。
| 崩れた軸 | 本番での最悪のケース |
|---|---|
| Faithfulnessが低い | 数字をでっち上げ、利用者がそれを信じて動く |
| Relevancyが低い | 「見つかりませんでした」と返る。不便だが正直 |
| Correctnessが低い | 古い文書を信じて答える |
Relevancyの失敗は、読めば分かります。「聞いたのはそこじゃない」と気づけるからです。Correctnessの失敗は、後から追えます。出典は存在していて、中身が古いだけだからです。
Faithfulnessの失敗だけは、見えません。もっともらしい文章で返ってくるので、利用者が気づくには、出典を開いて確かめるしかありません。その手間をなくすためにRAGを入れたはずなのに、です。
見えない失敗だから、重みを2倍にします。
Faithfulnessの測り方: 3つを混ぜる
1つの手法だけだと穴が残ります。3つを混ぜます。
Faithfulness = 1文ごとの根拠確認 × 0.4
             + LLM Judge の全体評価 × 0.4
             + 固有名詞の一致率   × 0.2
1文ごとの根拠確認(40%)
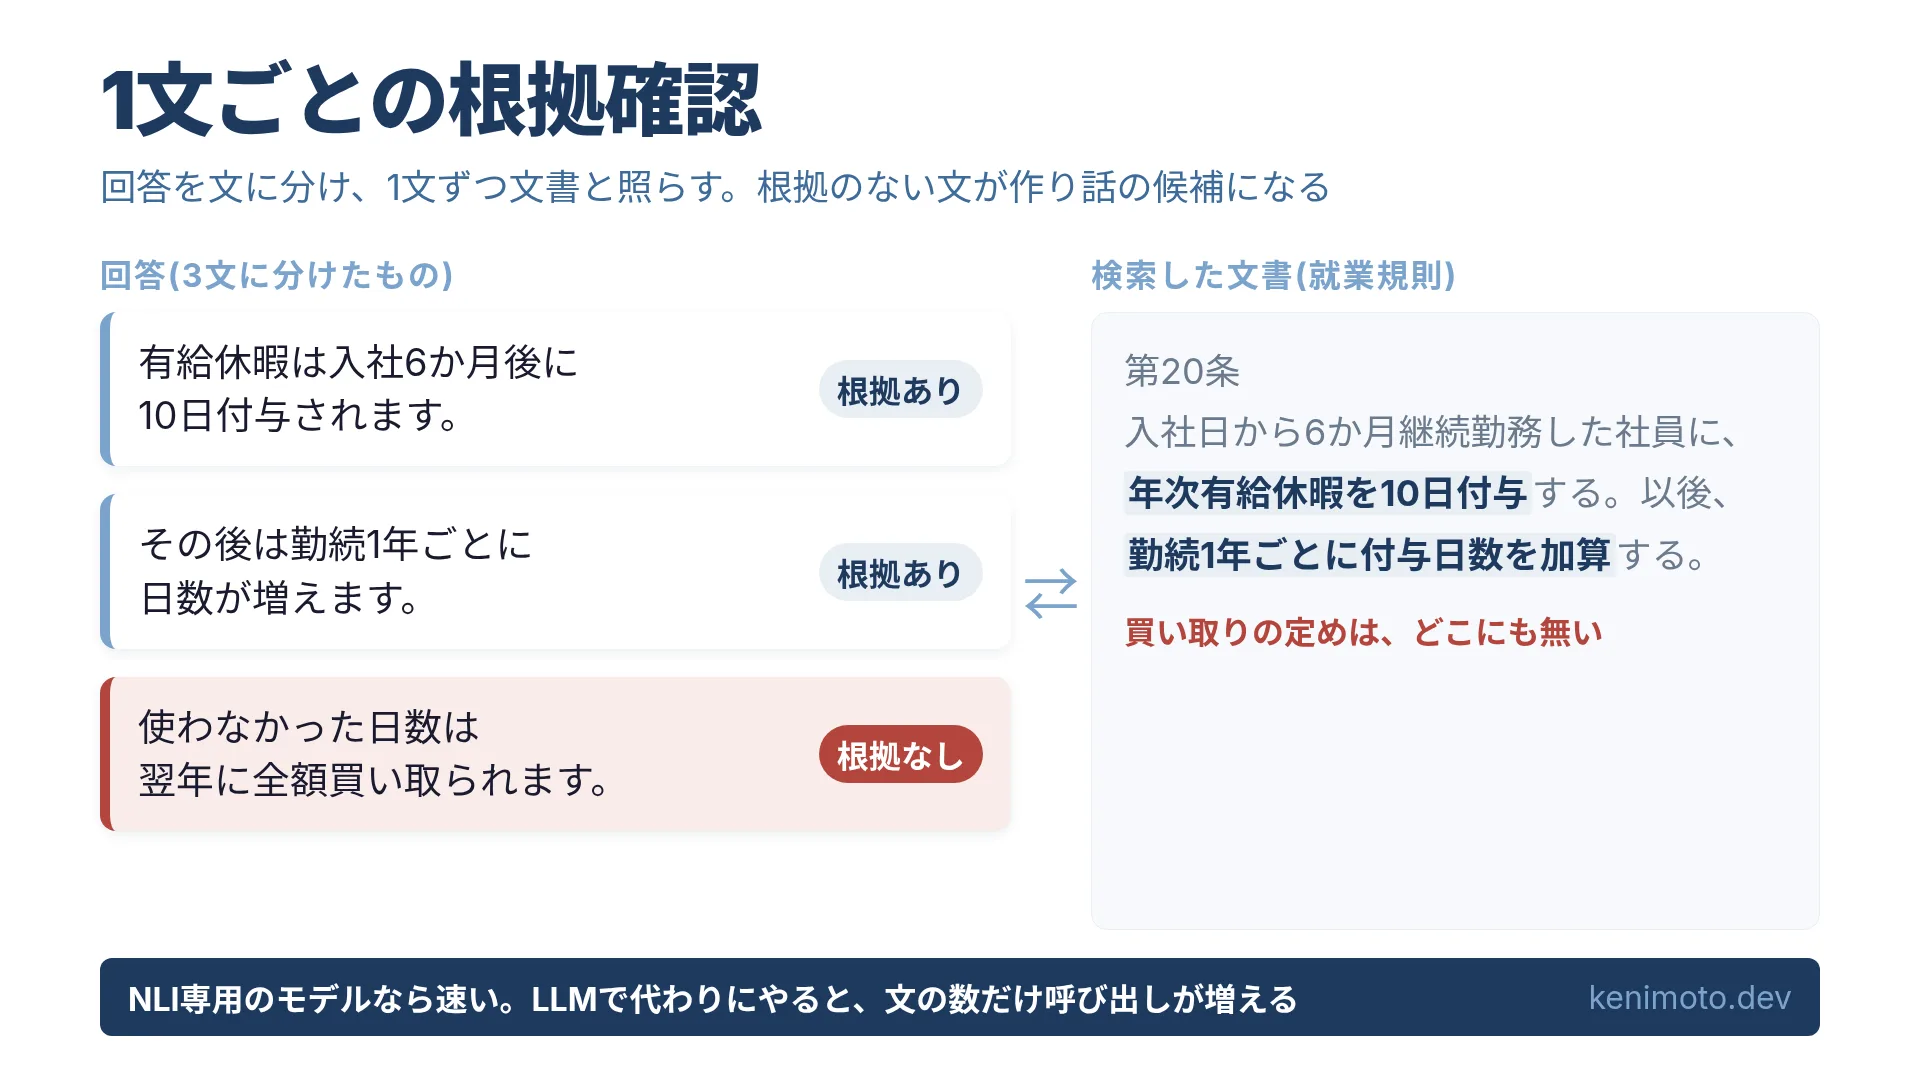
回答を文に分け、1文ずつ「検索した文書から言えるか」を確かめます。NLI(含意関係の判定)のモデルなら速く回せます。LLMでも代わりになりますが、文の数だけ呼び出すので費用は重くなります。
根拠の見つからない文が、作り話の候補です。
LLM Judge(40%)
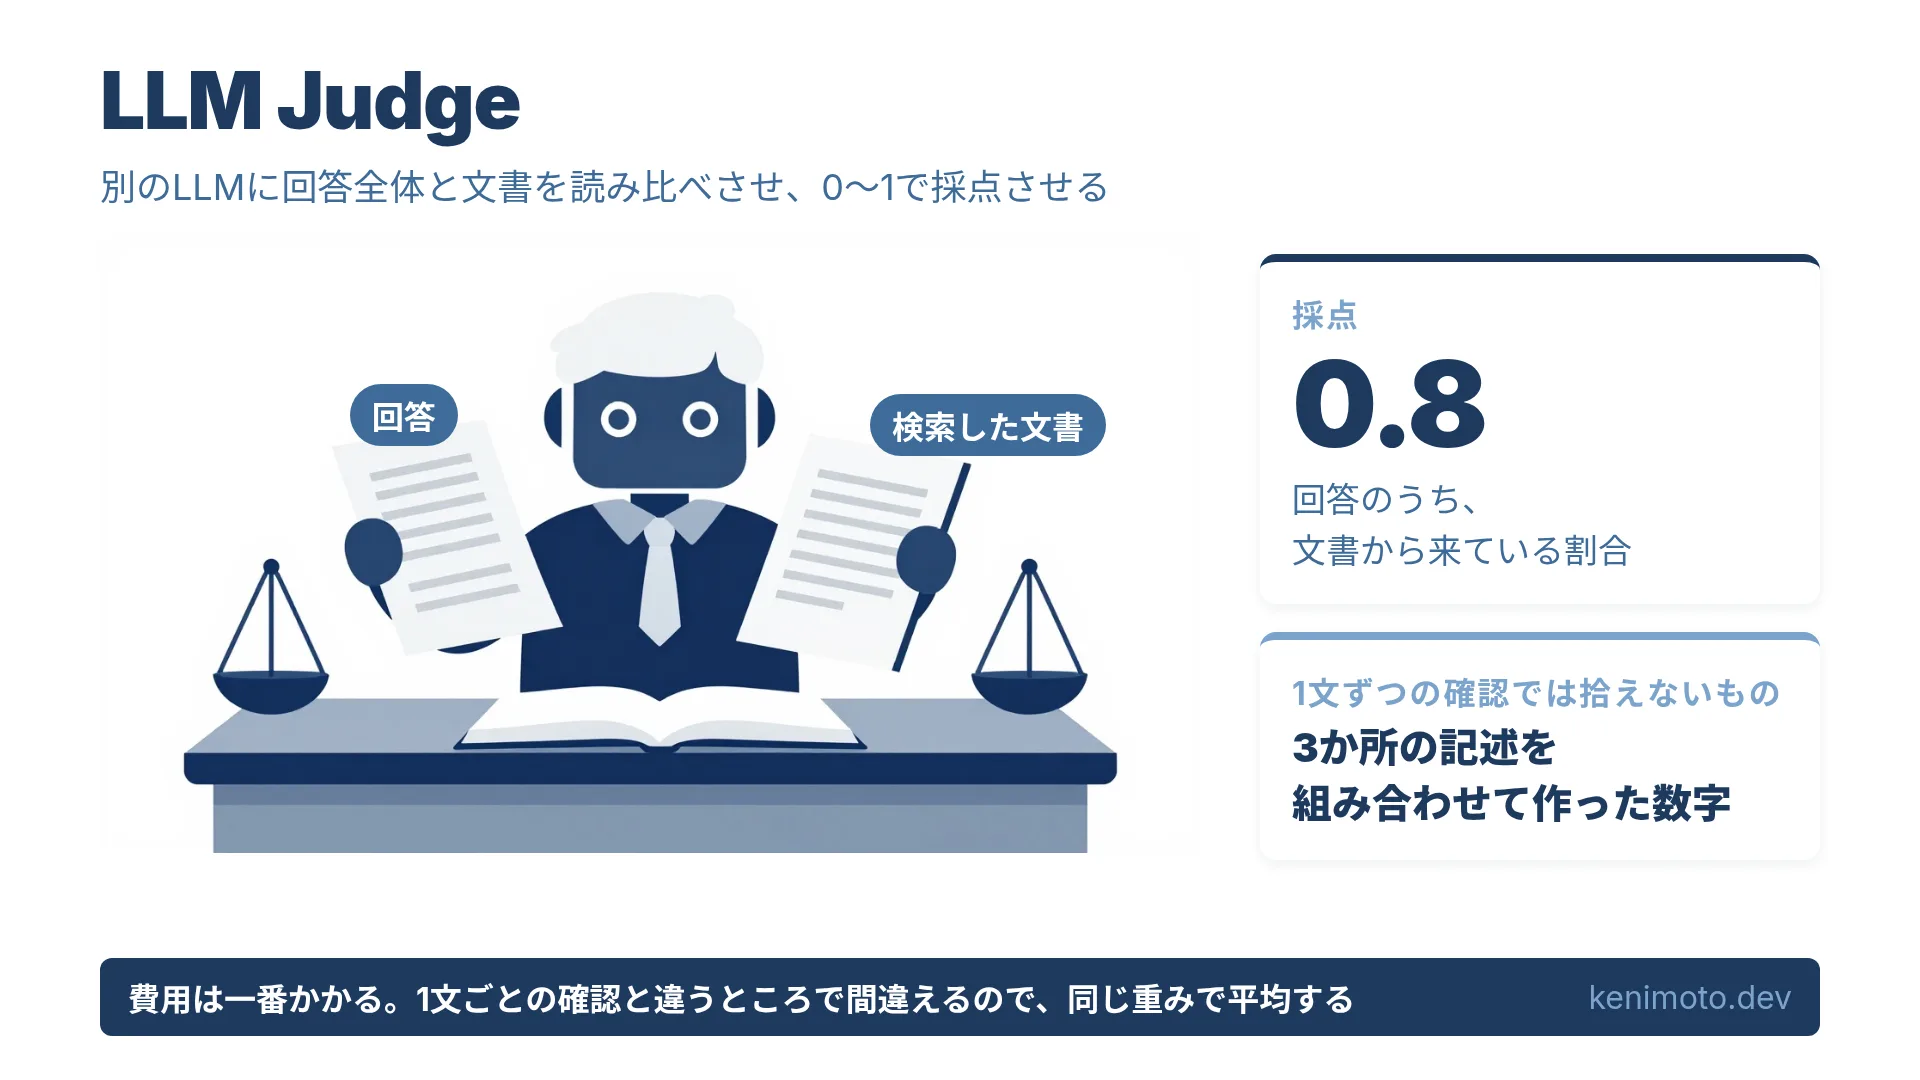
別のLLMに回答全体と文書を読ませ、「回答のどれだけが文書から来ているか」を0〜1で採点させます。費用は一番かかりますが、1文ずつの確認では拾えないものを拾えます。たとえば、3か所の記述を組み合わせて数字を作っているような回答です。
1文ごとの確認と同じ重みにしているのは、2つが違うところで間違えるからです。平均を取ると結果が安定します。
固有名詞の一致率(20%)
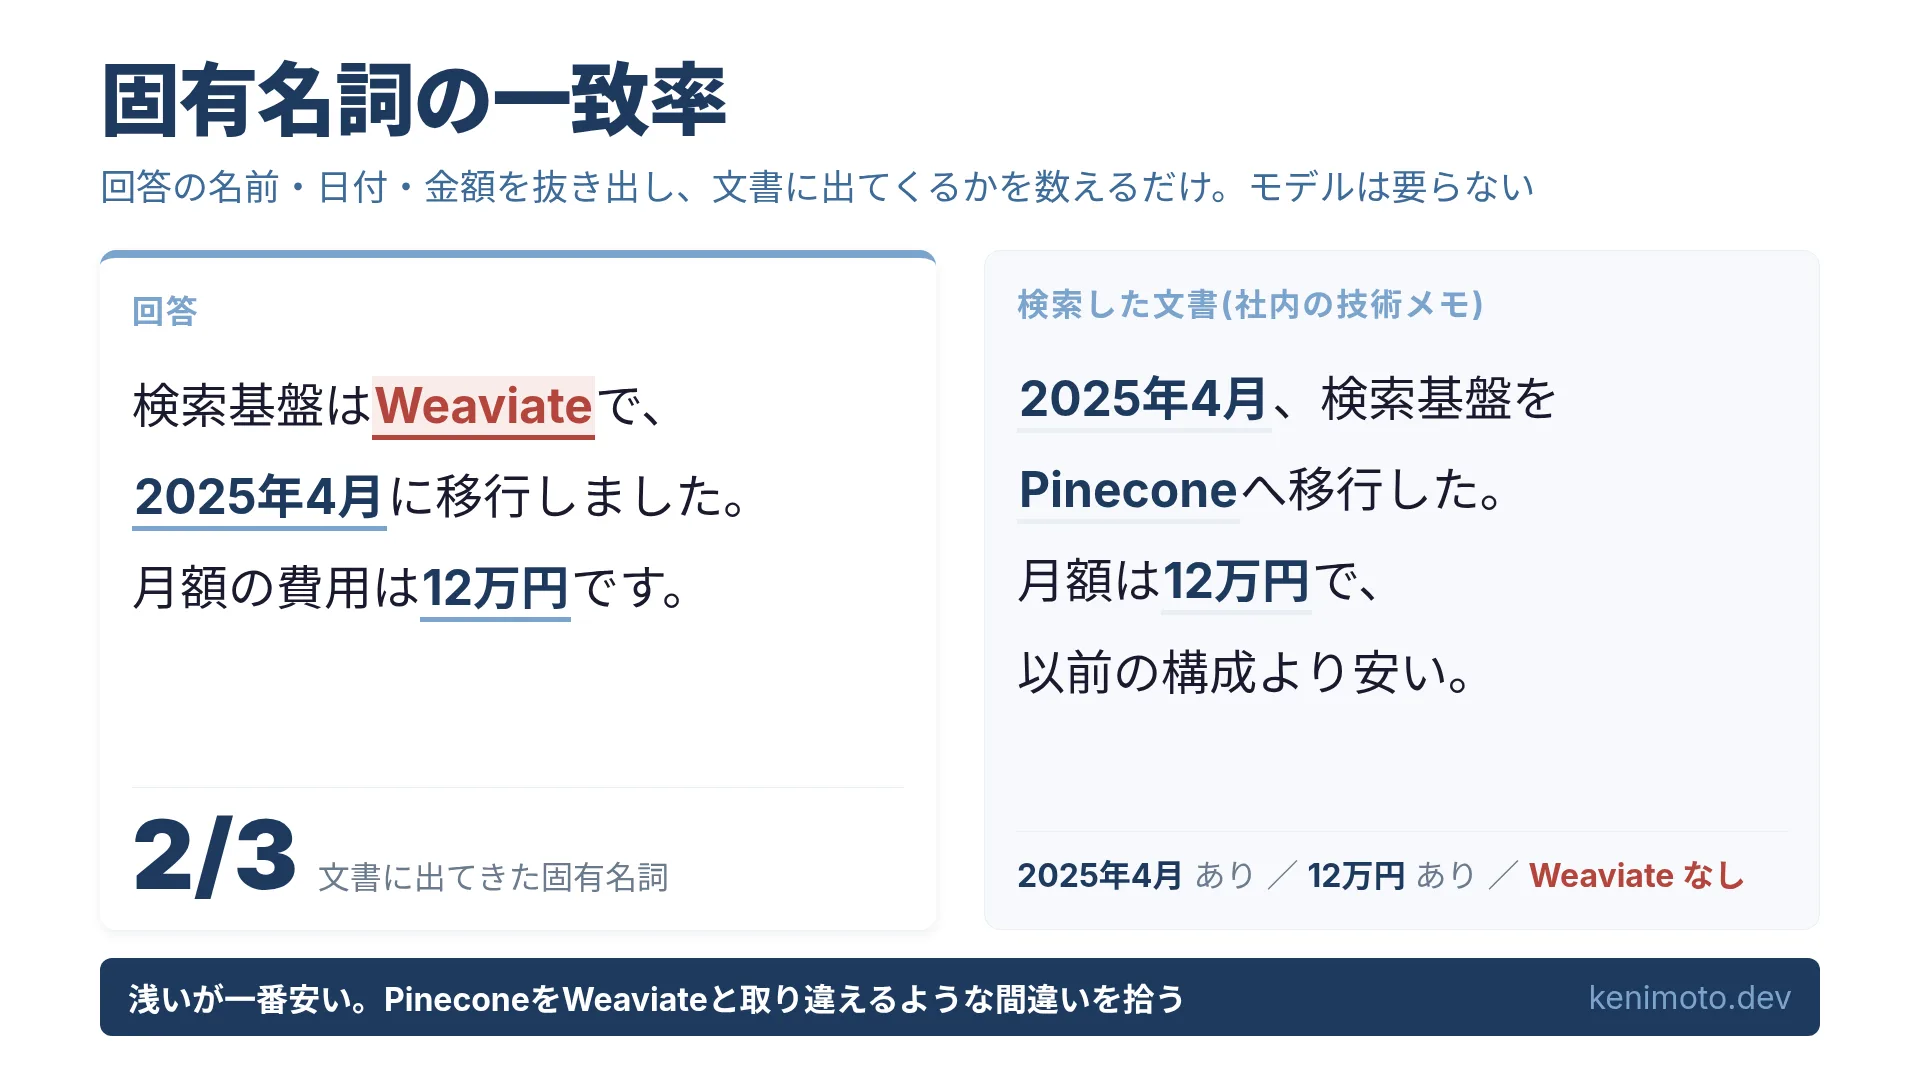
回答に出てくる製品名・日付・金額・人名を抜き出し、文書に出てくるかを確かめます。浅い確認ですが、モデルが要らないので一番安く、「PineconeをWeaviateと取り違えた」のような固有名詞の取り違えを拾えます。
浅いぶん重みは小さくしています。代わりに、上の2つがときどき見逃す種類の間違いを拾ってくれます。
本当の問題: 正解データがない
社内のRAGで、「人が正解を付けた質問セット」が用意されていることはまずありません。なので、正解と突き合わせるCorrectnessの測り方は、最初から使えません。
代わりに、間接的な4つの指標を使います。ここも重みは均等にしません。
| 代わりの指標 | 測るもの | 重み |
|---|---|---|
| 自己一貫性 | 同じ質問をN回投げて、答えのばらつきを見る | 30% |
| 網羅性 | 質問の意図をどこまでカバーしているか(LLM Judge) | 25% |
| 外部整合性 | 分かっている事実と矛盾しないか | 25% |
| 明確さ | 回答の構成と読みやすさ | 20% |
自己一貫性を一番重くしているのは、システムだけで計算できる唯一の指標だからです。同じ質問を5回して5通りの答えが返ってきたら、正解データがなくても何かがおかしいと分かります。
外部整合性には、社内の「確かな事実」のリストを使います。全部の正解を用意する必要はなく、確実に正しいと分かっている50〜100件で十分です。それと矛盾した回答は、即アウトにします。
最小限のパイプライン
- テストの質問を3種類用意する: 事実を聞く易しい質問、複数の文書が要る質問、答えのない質問
- 並列に流す
- 上の重みで3軸を計算する
- 結果を記録し続けて、劣化に気づけるようにする
3種類目の「答えのない質問」が一番大事で、一番忘れられています。文書に答えがない質問にRAGがそれらしく答えたら、その回答のFaithfulnessはゼロです。強く減点してください。
ここまでのまとめと、配分の出どころ
「3軸を33%ずつ」は左右対称で居心地がいい配分です。ただ社内のRAGで致命傷になるのはFaithfulnessで、重みもそれに合わせるべきです。
すでにRAGを動かしていて、3軸を分けて測ったことがないなら、手を付けやすいところから始められます。Faithfulnessを50%にし、正解データの代わりに4つの間接指標を使い、スコアを記録し始める。最初の1週間で、どこで嘘をついているかが見えてきます。
なお、この記事の重み(50/25/25、0.4/0.4/0.2、30/25/25/20)は、失敗したときの損害の大きさから決めた方針です。実測で割り出したものは含まれていないので、自分のRAGで記録が溜まってきたら、そこから調整してください。
LLM Judgeは一番費用がかかる部品なので、全件に回さずに済ませたくなります。「もっともらしい回答にだけ回す」という方法を実際に測ったところ、検出率は無作為に間引いたときとほぼ同じでした。詳しくは別の記事に書いています。
社内で嘘をつくと、それは負債になります。バランスシートに載る種類の負債です。
この記事の元になった本
3軸の重み、Faithfulnessを測る3つの手法の組み合わせ、正解データなしで測る4つの指標は、拙著『LLMを「嘘つき」から「専門家」に変える技術 — Context Engineering 実践入門』の「エンタープライズRAG」の章が元になっています。
同じ章では評価のほかに、社内RAGのアクセス制御(多層防御の7ステップ)と、Vector DBの選び方も扱っています。社内でRAGを動かす前に、評価と守りをまとめて確認したい方向けです。
 関連書籍 LLMを「嘘つき」から「専門家」に変える技術 Context Engineering 実践入門 | RAG・MCP・CLAUDE.md・Agentic RAG をベンチマークで体系化 書籍ページを見る →
この記事は役に立ちましたか?