プロンプトの精度差4.6倍から得た3つの示唆
「もう少し上手いプロンプトを書けば伸びる」と3週間粘って、頭打ちを見ました。
同じ質問を、同じ LLM(Claude Sonnet 4)に、5 段階で情報の与え方だけ変えて投げ直した。総合スコアは 5.3 → 11.4、2.2 倍 に化けました。もっと衝撃だったのが軽量な Haiku 3 側で、こちらは 2.2 → 10.1、4.6 倍 の差が出ました。
プロンプトの言い回しは一文字も変えていません。変えたのはモデルが「見ていた情報」だけです。
同じ 5 段階の実験は Context Engineering 入門 側で詳細に書きました。こちらの記事は、その数字から取り出せる 3 つの示唆に絞ります。「じゃあ何を変えるか」の話です。
5段階ベンチマーク: サマリー
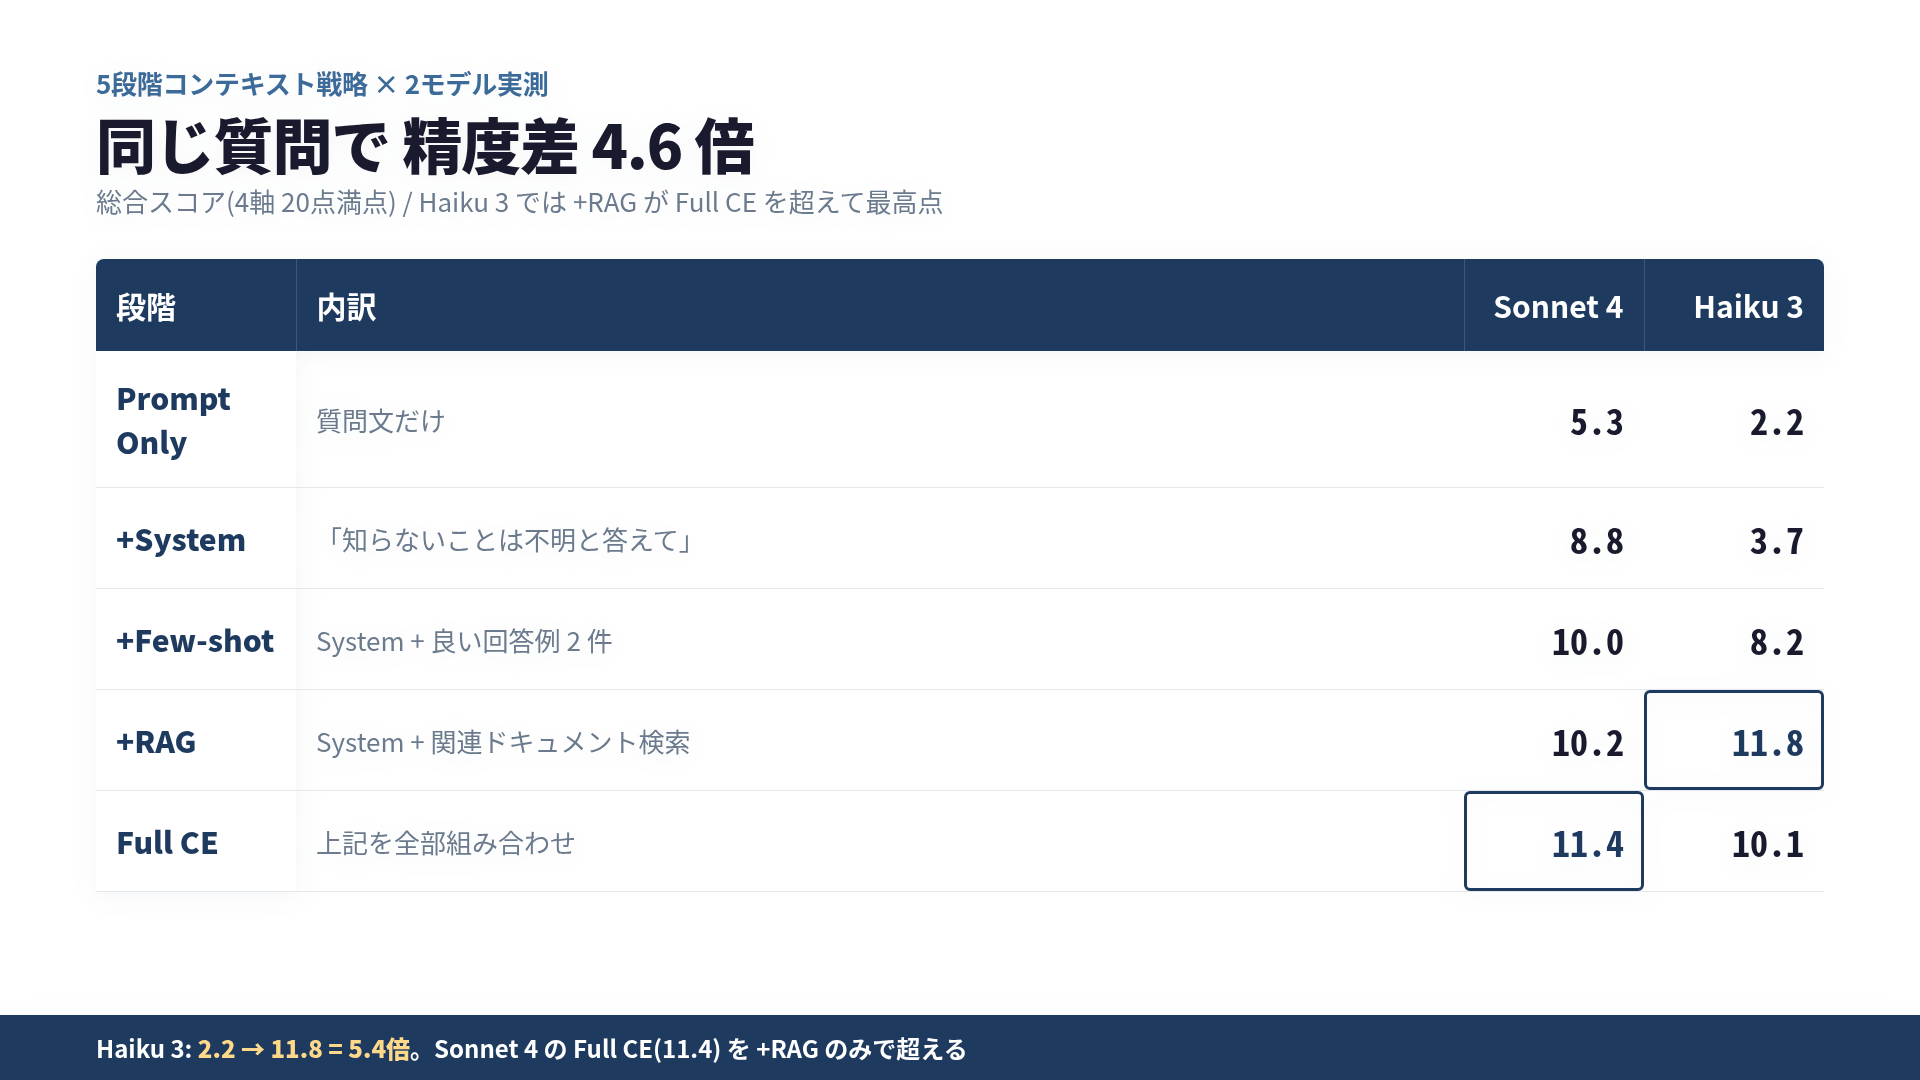
Claude Sonnet 4 と Haiku 3 に対して、架空の認証ツール「PropelAuth」の組織管理機能を質問し、コンテキストの与え方を 5 段階で変えました。評価は 事実正確性・幻覚抑制・具体性・誠実性 の 4 軸、各 0-5 点、合計 20 点満点です。
| 段階 | 内訳 | Sonnet 4 | Haiku 3 |
|---|---|---|---|
| Prompt Only | 質問文だけ | 5.3 | 2.2 |
| +System | 「知らないことは不明と答えて」を追加 | 8.8 | 3.7 |
| +Few-shot | System + 良い回答例 2 件 | 10.0 | 8.2 |
| +RAG | System + 関連ドキュメント検索 | 10.2 | 11.8 |
| Full CE | 上記を全部組み合わせ | 11.4 | 10.1 |
Haiku 3 では +RAG(11.8)が Full CE(10.1)を超えて最高点 になっています。ここが本記事の 3 つ目の示唆に繋がる、実運用で一番裏切ってくる挙動です。
示唆 1: モデルを買う前にコンテキストを設計する
Haiku 3 + RAG(11.8)が、Sonnet 4 + Full CE(11.4)を超えました。
これは金額の話として重い意味を持ちます。Anthropic の 2026 年 5 月時点の従量課金で、Sonnet 4 は Haiku 3 の 10 倍以上のトークン単価です。同じ用途なら Haiku 3 を選べば運用コストは 1 桁減ります。それでいて品質は上、ということが実測から出ています。
つまり 「精度が足りない → 上位モデルへ乗り換える」の前に、まずコンテキスト側を見る べきです。ドキュメントを RAG に流し込むだけで、Haiku 3 は Sonnet 4 を超えました。
私はこの結果を見るまで「軽量モデルを使うのは妥協」だと思っていました。今は逆で、軽量モデルこそコンテキスト設計の腕が問われる場所 です。同じ API 費で 10 倍のリクエストを捌ける相手だからこそ、ここに時間を投資する価値があります。
Anthropic 自身、2025 年 9 月の Effective Context Engineering for AI Agents で「Prompt Engineering In, Context Engineering Out」と書いています。公式もこの順番を推しています。
示唆 2: 「知らないなら黙る」は誠実性は上げるが具体性を落とす
System Prompt に「知らない情報については『不明』と答えてください」の 1 行を足すと、Sonnet 4 の誠実性は 0.2 点から 3.7 点へ、実に 18 倍 に跳ねます。
一方で、具体性は 4.2 点 → 1.7 点まで落ちる。事実正確性は 0 点のまま。
つまり「賢く謙虚」になっただけで、役に立つ答えは返してきていません。プロンプトを 1 行足せば安全性が上がる、という言い方は半分だけ正しくて、代わりに具体性を差し出している ことを見落としがちです。
この段階で止まると、社内チャットボットに「本件については弊社ではお答えできません」を返させる LLM ができあがります。誠実 100%、業務貢献 0%。
誠実性を上げたら、必ず RAG まで進める。 4 軸を同時に上げる唯一の方法は、正しい情報を渡すことです。System Prompt だけで満足せず、+Few-shot、+RAG、Full CE と積み上げる前提で設計してください。
示唆 3: コンテキストは積みすぎない
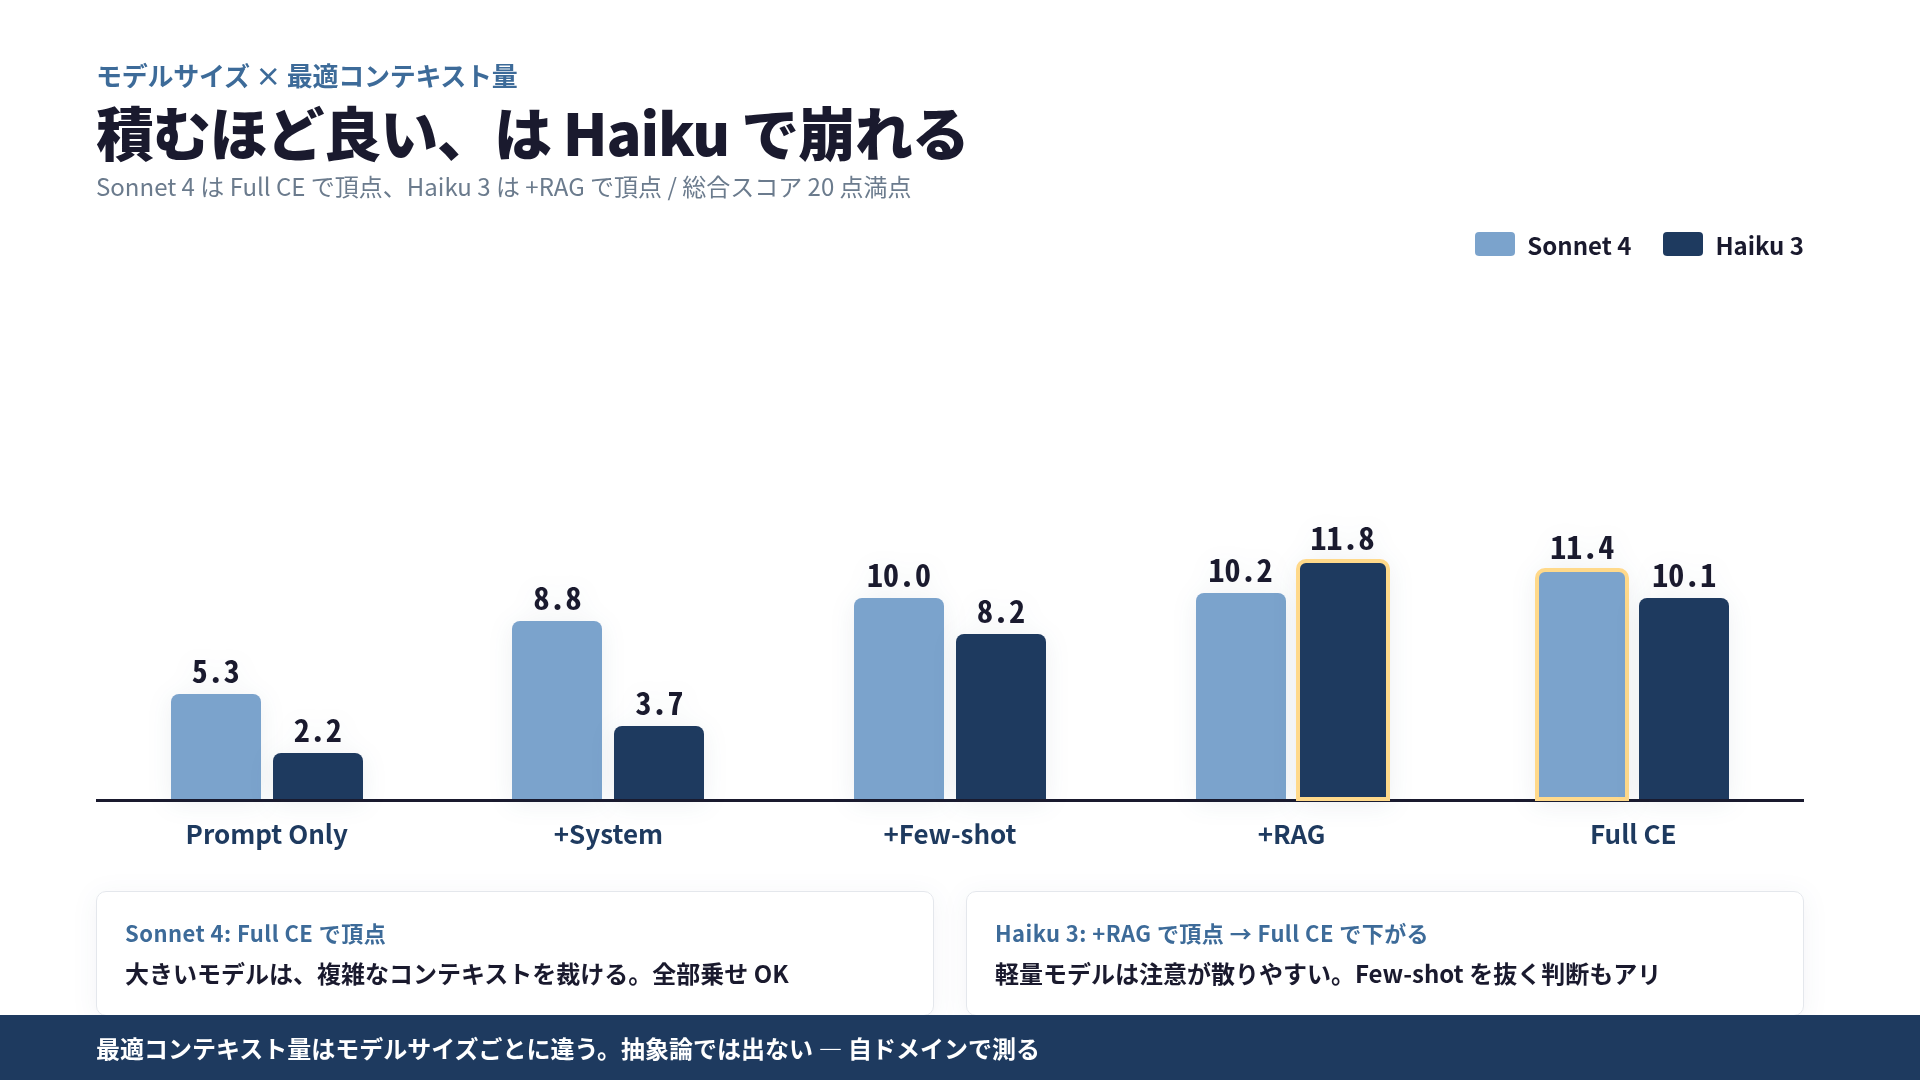
Haiku 3 の +RAG(11.8)が Full CE(10.1)を超えた事実は、「情報を足せば足すほど品質は上がる」という素朴な仮説が壊れる場面 を示しています。
Full CE で追加されているのは Few-shot 例と構造化出力の指示。ここが Haiku 3 のコンテキスト窓の中で RAG で取ってきた事実情報と競合 しました。軽量モデルは Working Memory が狭いので、注意が散ります。「良い情報」を足すこと自体が悪影響になる転換点があります。
Sonnet 4 では逆に Full CE が +RAG を 11.4 vs 10.2 で上回ります。この差は「モデルが大きいほど、複雑なコンテキストを裁ける」ことを示しています。
含意はシンプルです。
モデルサイズごとに、最適なコンテキスト量が違う。
Haiku 3 で運用するなら、RAG に絞って Few-shot は抜く判断もアリ。Sonnet 4 なら全部乗せて OK。この判断は、抽象論では出ません。同じベンチマークを自分のドメインで走らせて、初めて見えます。
この 3 つを自分のドメインで測るには
抽象論で終わらないためには、同じ実験を自社データで再現するのが一番早いです。
書籍 LLM を「嘘つき」から「専門家」に変える技術 には、本記事で示した 5 段階ベンチマークを自社ドメインで走らせる手順(付録 B、96 コードファイル)を置いています。架空ツール「PropelAuth」の作り方から、4 軸評価の実装、RAG のベクトルインデックス構築、コスト集計まで、手を動かせる粒度でまとめました。
Anthropic 公式定義との対応
念のため、2025 年 9 月の Anthropic 公式定義との位置づけを揃えておきます。
Context Engineering は望ましいエージェント挙動を引き出す コンテキスト全体の設計 である。プロンプトの文字面ではなく、システム指示・ツール定義・履歴・RAG 出力・出力形式まで含めた「LLM が見るもの全部」を最適化対象にする。
— Anthropic, Effective Context Engineering for AI Agents, 2025-09
本記事で 5 段階に切ったのは、この公式定義を 段階に分解して個別の寄与を可視化する ためです。5 番目の Full CE だけを見ると「じゃあ全部やればいいのか」で終わってしまいます。段階に分けると、System が誠実性、RAG が事実正確性、Full CE が全軸バランス、と役割が別れて見えてきます。そこに、モデルサイズによって最適な合成比率が変わる という 3 つ目の変数が乗ります。
Gartner も 2025 年に「Context Engineering In, Prompt Engineering Out」を主要トレンドとして挙げました。呼び名の変化はもう起きています。あとは、実測でこれを裏付ける習慣を持てるかどうかです。
まとめ
- 同じプロンプトでも情報の与え方で 精度差 4.6 倍(Haiku 3)、2.2 倍(Sonnet 4)
- 示唆 1: 上位モデルへ乗り換える前に、コンテキストを設計する。Haiku 3 + RAG が Sonnet 4 + Full CE を超えた事実は、コスト構造ごと考え直すきっかけになる
- 示唆 2: 「知らないなら不明と答えて」だけ実装すると誠実性は上がるが具体性は落ちる。必ず RAG まで進める
- 示唆 3: コンテキストは積みすぎると軽量モデルでは下がる。モデルサイズごとに最適比率が違うので、自ドメインで測る
自分のプロンプトが伸び悩んだら、まず架空のツール名で 1 質問投げてみてください。返ってきた「もっともらしい嘘」の量が、そのままコンテキスト設計の余地です。
伸びしろが 4.6 倍もあると知って、私はプロンプトを磨く手を止めました。
 関連書籍 LLMを「嘘つき」から「専門家」に変える技術 Context Engineering 実践入門 | RAG・MCP・CLAUDE.md・Agentic RAG をベンチマークで体系化 書籍ページを見る →
この記事は役に立ちましたか?