GraphRAG 7ステップで効くのは3つだけ
GraphRAG を自分で組もうとして、最初に手を止めるのは Step 3 です。
Neo4j 公式の構築フレームワークは全部で7ステップ。ユースケース定義、データソース特定、オントロジー設計、データモデリング、取り込み、クエリとAPI、運用。並べて書くと整然としていますが、やってみると Step 3 のオントロジー設計で週末が2回消えます。私はそれで消えました。
ところが本番でこれをまともに動かしているチームの事例を分解すると、7ステップは 等価ではありません。LinkedIn が社内サポートに GraphRAG を入れて、問題解決時間の中央値を 28.6% 削った事例が arXiv 2404.17723 として公開されていますが (LinkedIn Engineering 原著 PDF)、その7ステップの時間配分を読むと、効いていたのは3つだけだったことが分かります。
残りの4つは「ちゃんとやる」で済むコモディティ工程でした。そこを早く済ませて、効く3つに時間を預け直す、という話を今日は書きます。
7ステップのおさらい
Neo4j のフレームワークはこう並びます。
| Step | 中身 |
|---|---|
| 1 | ユースケース定義 |
| 2 | データソース特定 |
| 3 | オントロジー/スキーマ設計 |
| 4 | データモデリング |
| 5 | データの取り込み・変換 |
| 6 | クエリとAPI構築 |
| 7 | 運用と拡張 |
私が初めて自分の KG を作ったとき、全ステップに同じ重さをかけました。結果は、Step 4-6 で詰まった時間が長く、動き出した後の運用が死ぬほど雑でした。先に順番を疑えばよかった、というのが2回目以降の学びです。
LinkedIn の時間配分を7ステップに照らす
LinkedIn の論文を読むと、どこに時間とエンジニアを突っ込んだかが見えます。それを7ステップに当て直すとこうなります。
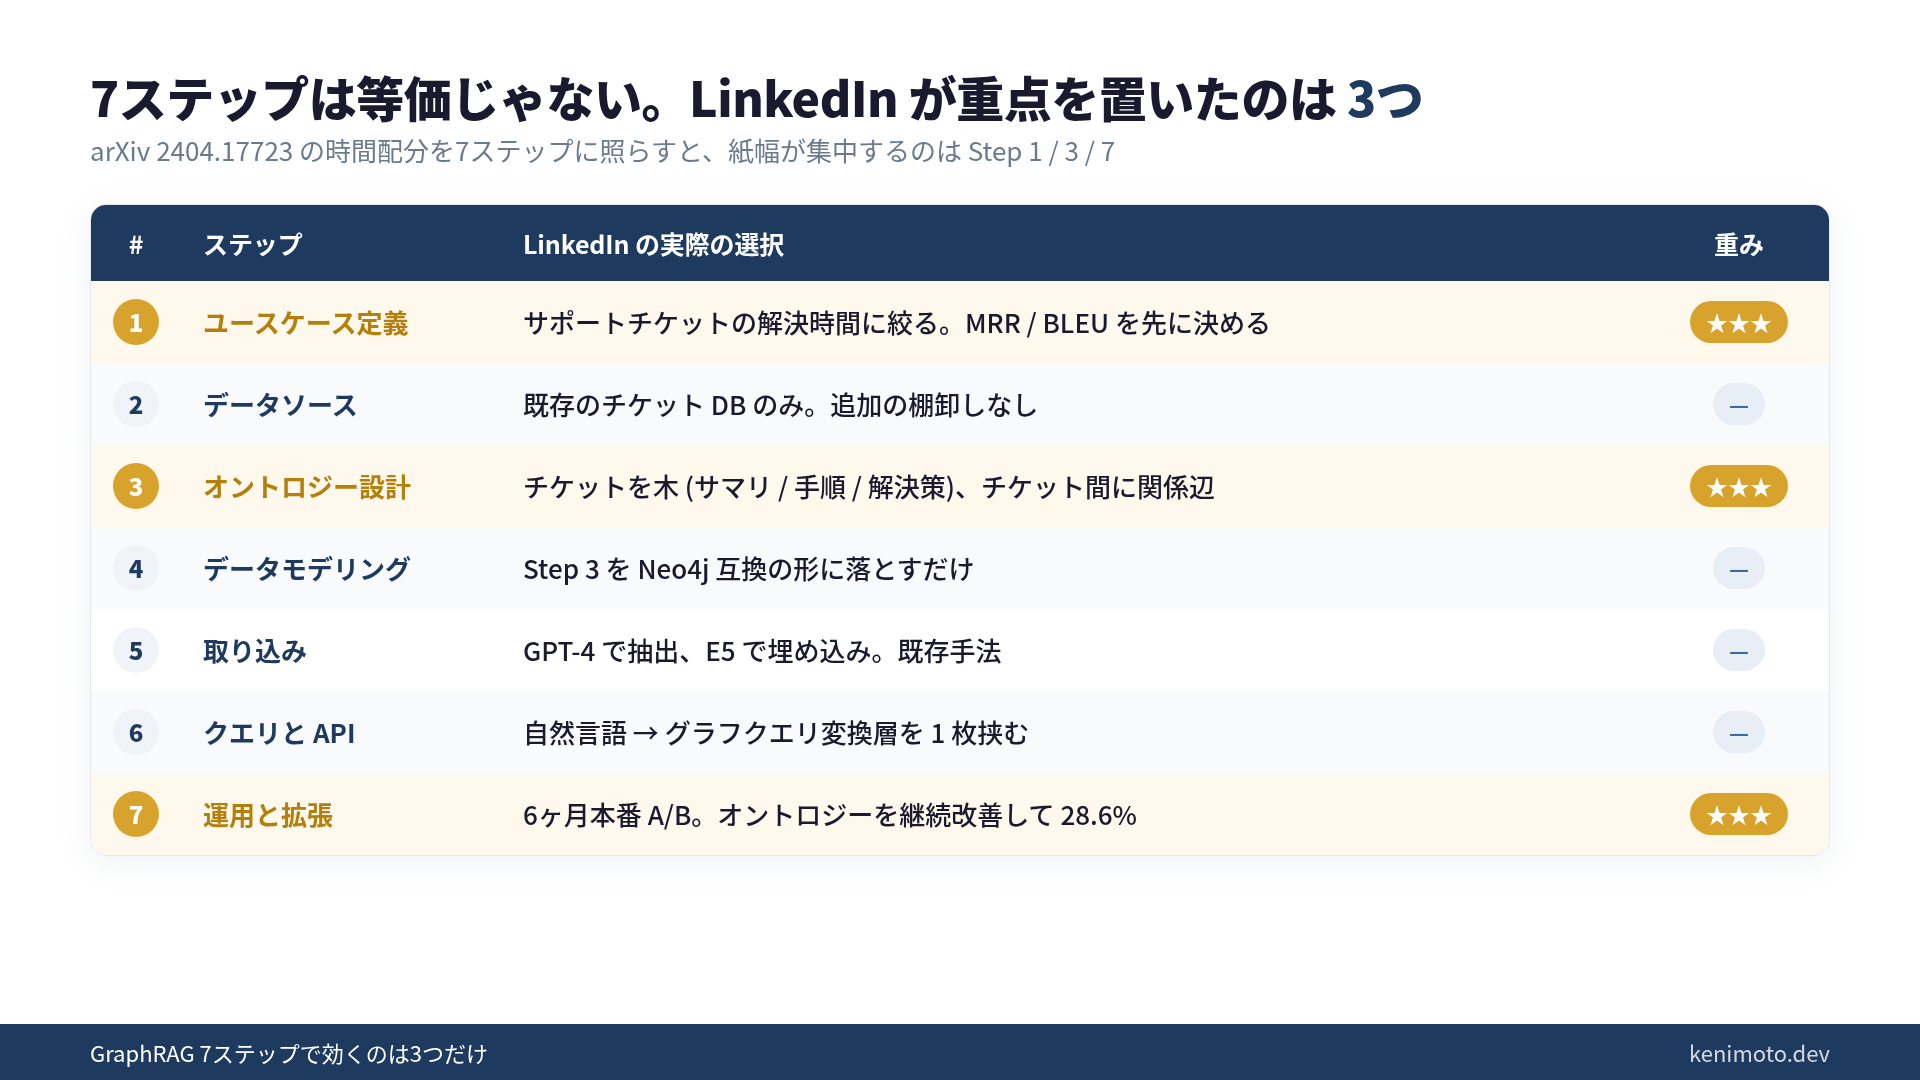
- Step 1 (ユースケース定義): 「社内の全ナレッジ」ではなく「サポートチケットの解決時間」に絞った。評価指標も最初から MRR と BLEU で定めた
- Step 2 (データソース特定): 既存のサポートチケット DB。追加の棚卸しはなし
- Step 3 (オントロジー設計): ★チケットを「木」として表現。サマリ・説明・優先度・再現手順・解決策を子ノードに。チケット間は related / copied-from / caused-by の明示リンクと、タイトル埋め込みの類似度で辺を張る。ここが肝
- Step 4 (モデリング): ツリー構造を Neo4j 互換の形に落とすだけ
- Step 5 (取り込み): GPT-4 でエンティティ抽出、E5 で埋め込み。既存の手法
- Step 6 (クエリ): 自然言語質問をグラフクエリに変換する層を1枚挟む
- Step 7 (運用): ★6ヶ月の本番運用を A/B で回し、オントロジーを継続改善
7ステップのうち、論文で紙幅と図を割いているのは Step 1、Step 3、Step 7 の3つです。残りは1-2段落で終わる。
なぜ Step 3 が勝敗を決めたのか
ベクトル検索ベースの RAG が LinkedIn で効かなかった理由は、論文の背景に書いてあります。
チケットは長い。埋め込みは長文になるほど「雰囲気の類似度」しか出せない。
チケットには構造がある。サマリ・説明・優先度・再現手順・解決策。ベクトルはそれを潰す。
チケット間に関係がある。過去の類似障害、前提となる別チケット、連鎖する障害。ベクトルは点同士の類似しか見ない。
このうち2つ目と3つ目が、まさに Step 3 のオントロジー設計で救う話です。「チケット=木、章と章の間に辺、関連チケット同士に辺」という形を先に決めると、Step 5 のエンティティ抽出が自動的にその型に流れ込みます。
ここを決めずに Step 5 の抽出 LLM を回すと、何が返るかは LLM の気分次第です。私は最初、Step 3 を薄く済ませて Step 5 の prompt を豪華にすることで巻き返そうとしましたが、戻ってきたグラフは繋がりがバラバラでクエリが書けませんでした。Step 3 を薄くした分の負債は、Step 5 の prompt では返せません。
ナレッジグラフ実務ガイド の第4章では、ユースケースのクエリから逆算してオントロジーを設計する手順を書いています。LinkedIn の事例をこの型に当て直したのが本記事です。
なぜ Step 7 が勝敗を決めたのか
GraphRAG を立ち上げた直後の精度は、だいたい想像より低いです。LinkedIn の 28.6% は、立ち上げ時点の数字ではなく 6ヶ月運用後の数字 です。
何を6ヶ月やっていたかを論文の後半から拾うと、
- エンティティ抽出の精度を実データで測り直す
- オントロジーの穴 (想定していなかったチケット型) を拾って追加する
- グラフクエリの変換層で、言い回しの異表記を潰す
- クエリ実行に失敗したときのフォールバック (ベースラインのテキスト検索) を本番に残しておく
要するに、オントロジーの反復改善です。これは Step 3 の延長戦なので、7の順位は実質 Step 3 と連番で考えたほうがいい。
なぜ Step 1 が勝敗を決めたのか
Step 1 を薄くやると、Step 7 で何を測ればいいか分からなくなります。
LinkedIn は最初から「問題解決時間の中央値」「MRR」「BLEU」の3つを決めて、どの数字を見て良し悪しを判断するかを合意していました。6ヶ月の反復改善は、この指標があるから回ります。
一方、「社内のナレッジを全部グラフにしたい」から始めた KG プロジェクトは、Step 7 で何を見ればいいか決まらないので、改善サイクルが回りません。回らないまま3ヶ月経つと忘れ去られます。
私が今動いている KG を2つ生かせているのは、立ち上げ時に「このクエリが2秒以内に返ること」を KPI として先に決めたからです。この KPI がないと、オントロジーをいじるべきかクエリ変換層をいじるべきかの判断が付きません。
残り4つは「ちゃんとやる」で済む
対して Step 2、4、5、6 は、ちゃんとやりさえすれば勝敗を分けません。
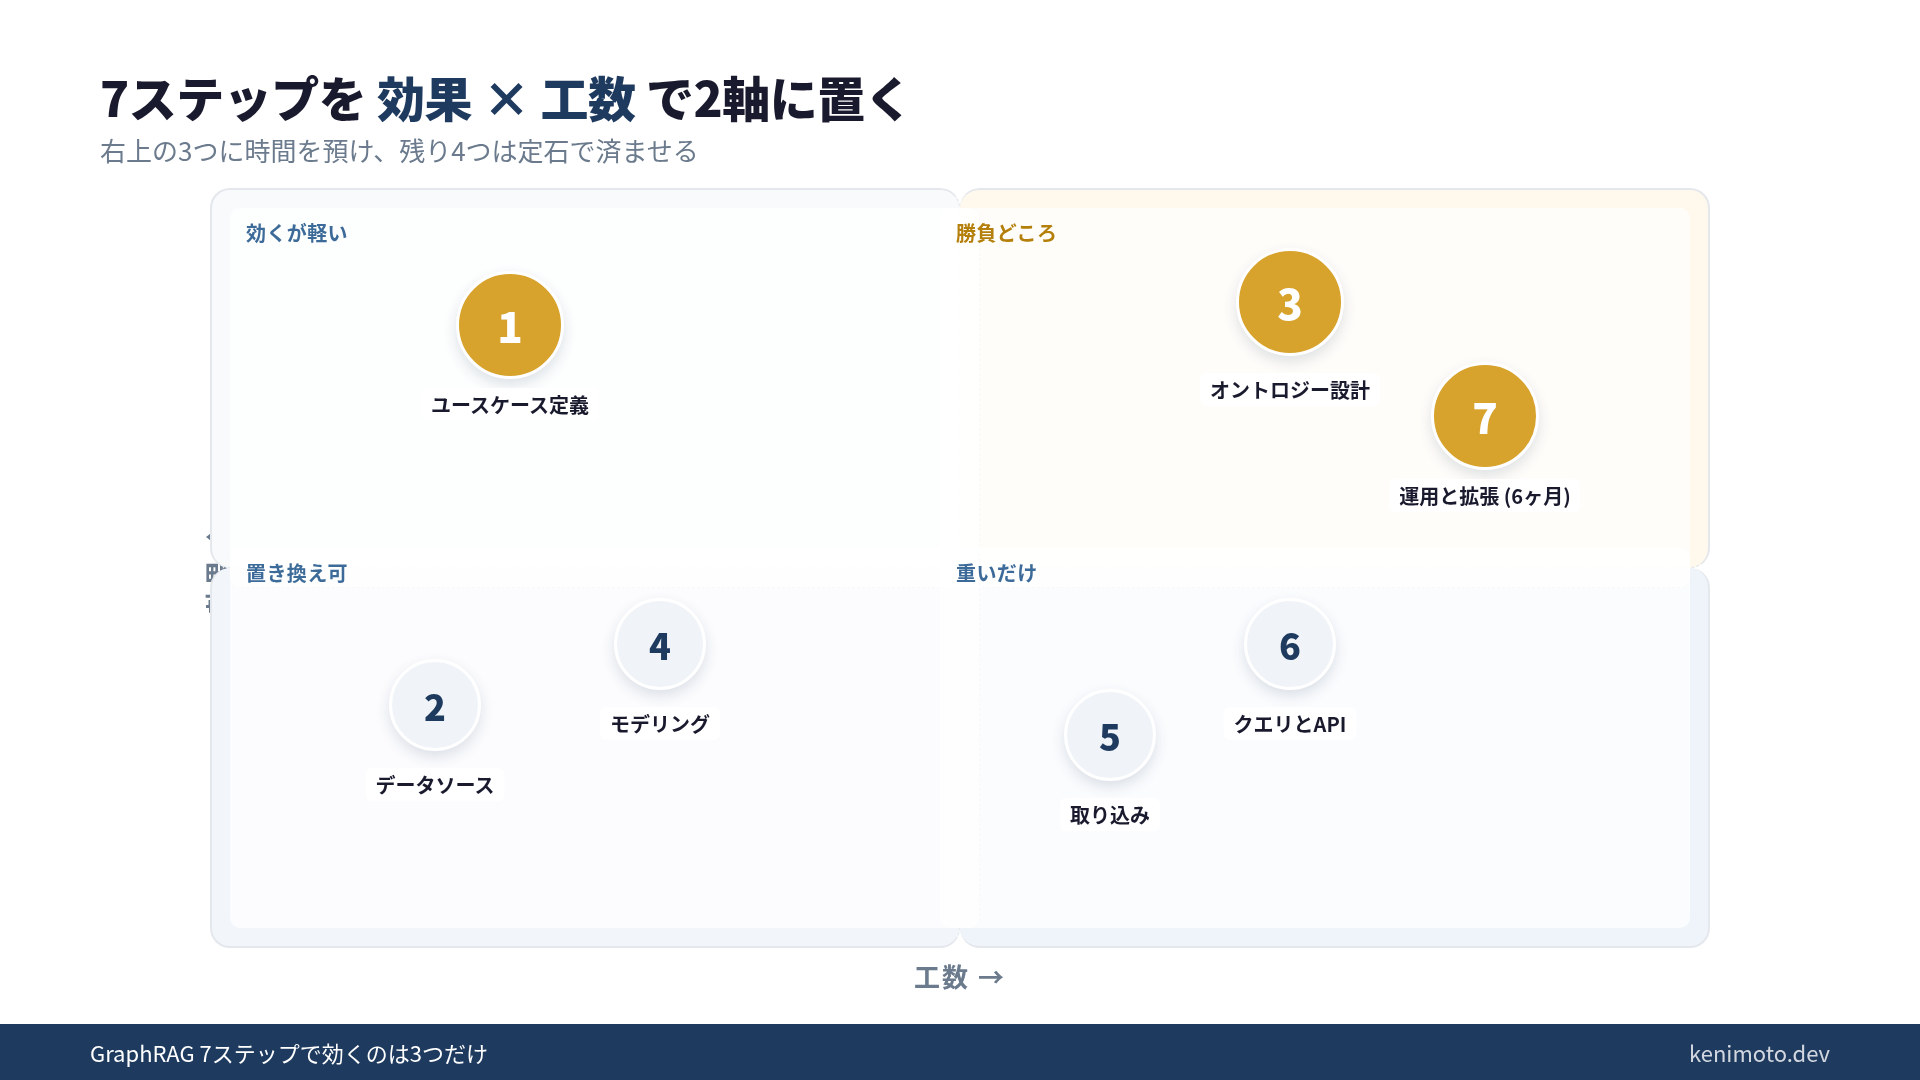
- Step 2 (データソース特定) は、既存のチケット DB が1つあれば十分。新しいデータを足そうとした瞬間に Step 3 が壊れます
- Step 4 (モデリング) は Step 3 の機械的な落とし込み。設計が正しければ数時間で終わる
- Step 5 (取り込み) は、2026年時点で LLM によるエンティティ抽出が成熟しています。GPT-4 や Claude 系で動く。精度が足りないときの原因は Step 3 側にある
- Step 6 (クエリ) は、自然言語→グラフクエリの変換層を1枚置くのが定石。LangChain でも Neo4j 公式でも同じ構成
これらは「新しさで差別化する」工程ではありません。Step 1/3/7 で勝ち筋を作って、2/4/5/6 は定石で済ませる。この配分が本番に行ける GraphRAG と行けない GraphRAG を分けます。
自分の KG に落とすときの手順
ここまでを踏まえて、私が自分の小さな KG を組むときに守っている順番はこうです。
- 1 日目: Step 1 を書く。1つのクエリを決める。KPI を2秒以内と決める。この段階ではコードを書かない
- 2-3 日目: Step 3 を書く。ユースケースのクエリから逆算してオントロジーを紙に書く。Neo4j のクエリを頭の中で3本書けるか試す。書けなければオントロジーが足りていない
- 4-5 日目: Step 2、4、5、6 をまとめて書く。Neo4j AuraDB の無料枠に入れる。既存のサンプルコードから最大限借りる
- 6 日目以降: Step 7 に全部投げる。実データで KPI を測って、オントロジーに戻る
1-3 日目で動くものはできませんが、動かした後に戻る回数が激減します。私はこの配分にしてから、KG の立ち上げが2週間→1週間に半減しました。
まとめ
- GraphRAG 構築の7ステップは等価ではない。LinkedIn の論文を分解すると、紙幅と効果が集中しているのは Step 1、3、7 の3つだけ
- Step 3 のオントロジー設計は、Step 5 の抽出 LLM では返せない負債を作る。先にここに時間を預ける
- Step 7 の運用反復を抜いて PoC で止めると「GraphRAG は効かなかった」になる。LinkedIn の 28.6% は6ヶ月運用後の数字
- 残り4つ (Step 2、4、5、6) は定石で済ませる。差別化しない
7ステップを並べて1個ずつ丁寧にやるより、効く3つに時間を預け直すほうが、本番に出る GraphRAG に近い。私はこの順番で2本の KG を立ち上げました。
GraphRAG の実装をもう少し体系的にやりたい方には、私の ナレッジグラフ実務ガイド をどうぞ。第4章が Neo4j の7ステップ、第6章が LinkedIn 事例と NTT 東日本の4ステップ導入フレームワークです。本記事はその2つの章を1枚に貼り直したものです。
参考文献
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?