タイトル長さ監査、全525本の74%が上限超過
タイトルは短くするもの、というのはずっと知っていたつもりでした。実際、記事を書くときは SERP で切れないように意識して付けていました。それなのに今日、自サイトの全記事のタイトルを lint-title.py に流し込んでみたら、525本中 386本、つまり 74% が長さ上限を超えていました。意識していたのに、です。
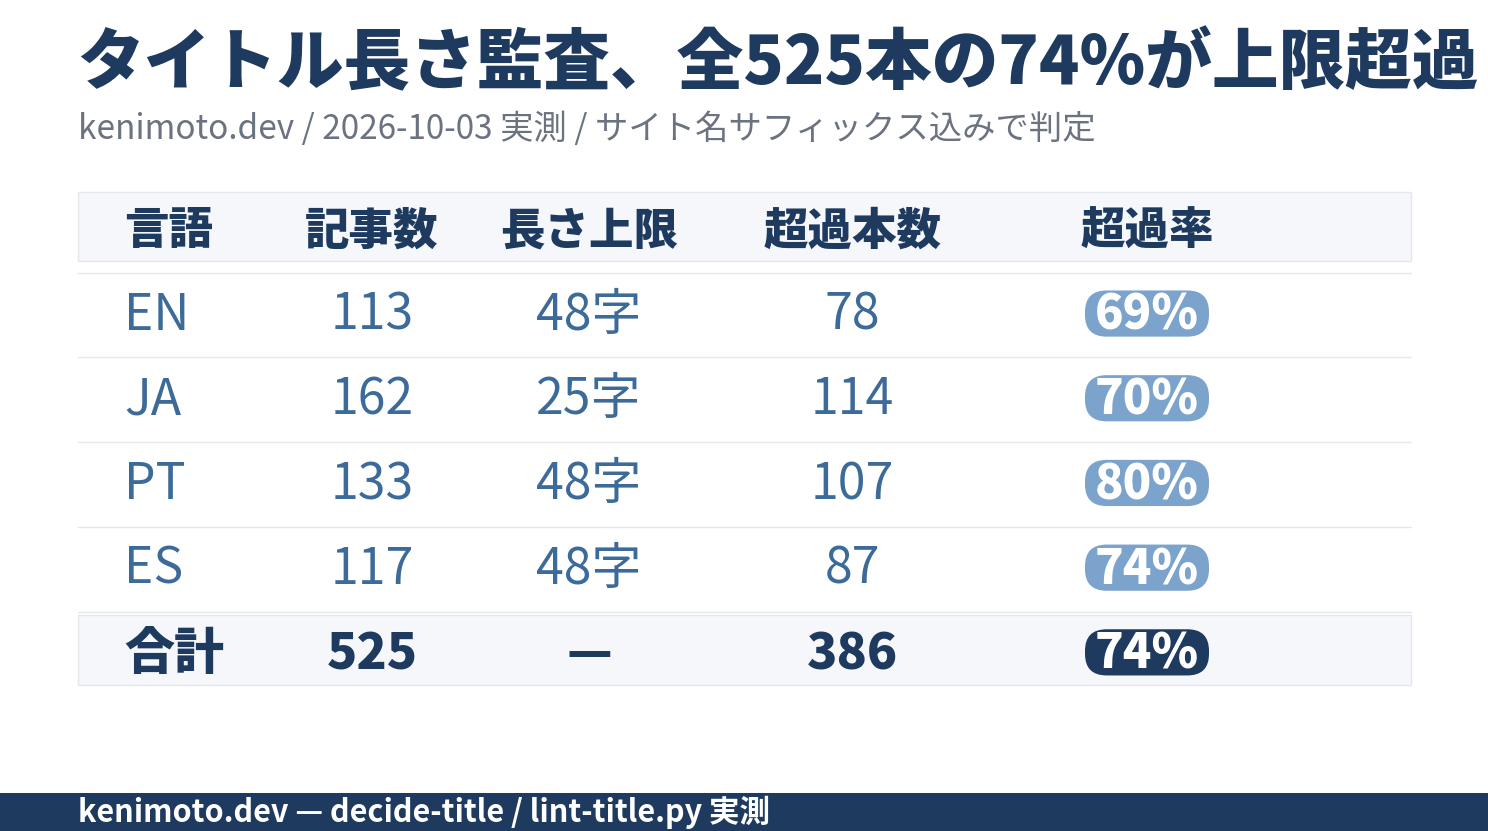
この記事では、監査した 2026-10-03 時点の内訳と、なぜ「意識していた」のに守れていなかったのか、そして上限超過を全部一斉には直さないと決めた理由を書きます。lint ツール自体の話ではなく、使ってみたら積み上がっていた借金をどう返すか、の運用の話です。
今日の実測
まず lint-title.py --site kenimoto-dev を4言語の全記事に回した結果です。lint の判定ロジックは1つで、面 (SERP面) ごとのルール表に沿って「上限 − サイト名サフィックス」の文字数と照合します。
| 言語 | 記事数 | 長さ上限 | 超過本数 | 超過率 |
|---|---|---|---|---|
| EN | 113 | 48字 | 78 | 69% |
| JA | 162 | 25字 | 114 | 70% |
| PT | 133 | 48字 | 107 | 80% |
| ES | 117 | 48字 | 87 | 74% |
| 合計 | 525 | — | 386 | 74% |
4言語とも 69〜80% の帯に収まっていて、言語差はそれほどありません。意識して書いていたのに揃って外していた、という結果が出た時点で、「意識」で解決する問題ではなかったとわかります。
「意識」が外れていた理由
lint のソースを読み直して気づいたのは、上限の決め方が頭の中の目安とズレていたことです。
SERP に出るのは frontmatter の title そのものではなく、title + サイト名サフィックス です。kenimoto.dev の場合、EN は末尾に — Ken Imoto が付くので 12字、JA は — 井本 賢 が付くので 7字が加算されます。lint が見る上限は、SERP の生の上限 (EN 60字 / JA 32字) から、このサフィックス長を引いた値です。EN なら 48字、JA なら 25字。
私は書くときに「EN 60字くらいで」と頭でカウントしていました。でも SERP 側は 60字時点でサフィックスまで含めて切るので、frontmatter が 60字あるとサイト名が落ちた表示になります。「サイト名が落ちても意味は通じるからいい」ではなく、落ちない保証も無いので、短い方に倒すのが安全側です。この上限の決め方は 2026-08-27 に、本番 HTML の <title> を curl で引いてサフィックス長を実測した上で lint 側の正本に書き込みました。自分で書いて自分で守れていなかった、という間抜けな状態です。
ここに気づいたのは SKILL.md の該当節を読み返した 2026-08-26 で、記録として残っている JA の集計は 143/149 (96%) でした。今日 (2026-10-03) 測り直したら JA は 114/162 (70%) に落ちています。この約1ヶ月で何が起きたかは次の節で分解します。
なぜ一斉リライトしなかったのか
当初は「じゃあ全部直せばいい」と思いました。386本なら1本1分でも6時間半で終わる作業です。それでも一斉リライトはやめました。理由は3つで、どれも SEO 固有の話です。
ひとつめは、SERP で切れるのは表示のされ方であって、表示回数そのものではないということ。順位も表示回数も、既に付いてしまったぶんは title を直しても即日では動きません。この74%がすべて「表示が出ているのに切れてクリックされていない」ならリライトは効きますが、実際には表示自体が付いていない記事も混ざっています。表示が0の記事の title を直しても、効果は測れません。
ふたつめは再インデックス待ちのブレです。GSC で順位や CTR が落ち着くまで、1本あたり3〜4週間はかかる体感があります。386本を一斉に書き換えると、同じ日に 386本の計測窓が開くことになります。1ヶ月後に「で、どの改題が効いたの?」の問いに答えられなくなります。1本ずつ書き換えて1本ずつ観測した方が、何が効いて何が効かなかったかが見えます。
みっつめは、ハーネスの原則としての「判断を小さく割る」 です。1日の判断回数を400回から40回に落としたときに書いたハーネス3層設計の記事で、判断の総量を減らすには一発で全部直すよりも、小さく割って自動化側に落とす方が効く、という話を書きました。386本の一斉リライトは、まさに「夕方のポンコツな私が1本1本ついつい手を入れて何かを壊す」典型です。判断列を長く引かない方が安全です。
ちなみに skill-eval の lint ツールを作ったときも同じ判断で動く2層に分けました。lint は決定論で毎日走らせ、実行 eval はコストが大きいので別層に置きました。全部を同じ層に詰め込まないという考え方で、今回も同じことをやっています。
代わりに「ついで直し」で返す
一斉リライトしない代わりに採った運用はこれです。
毎週 observer が rewrite-candidates-YYYY-MM-DD.json を吐きます。この中の striking_distance (順位 5〜10位・CTR 1%未満で表示が付いている記事) と dead_snippet (順位5位以内なのに CTR 3%未満の記事) は、既にリライトの対象として自然に選ばれます。これらを直すときに、title の長さ超過もついでに直すという方針にしました。
- 元々リライトする記事なので再インデックス待ちは「ついで」で発生し、追加の観測コストはゼロ
- 直す本数は週に数本なので、計測窓が重ならない
- 表示が付いている記事から順に直すので、効果が出る確率が高い
JA の 143/149 (96%) → 114/162 (70%) の約1ヶ月の変化は、たぶんこの運用の結果です。「たぶん」と書いたのは、変化の内訳 (新規記事での追加 vs 既存記事での短縮) まで追えていないからです。粗い内訳で見ると、2026-08-26 の149本に対し新規が13本増えて162本になっており、新規がすべて上限内だったとしても、超過が143から114に減るには既存の29本が短縮された計算になります。この29本が全部「ついで直し」だったのか、気になって手で直したのが混ざっているのかは、git log を全title変更に遡って引かないと確定できません。
新規記事側は入口で止める
既存の借金を「ついで直し」で返す一方で、新規記事は書く時点で lint を通すのが必須になっています。marketer の記事生成パイプラインで lint-title.py が ★★★ を返したら公開を止める、という門番を置きました。
これは「意識で守れなかった」という今回の学びをそのまま入口に置いた形です。意識はズレるので、意識させないで決定論で落とす方が安全です。
次に測る
次に測るのは、2026-11-03 ぐらいの時点でもう一度全記事を lint して、「ついで直し」運用で超過率がどこまで落ちているかです。新規の分だけ母数が増えて超過率がむしろ上がる展開も十分ありえます。その場合は「ついで直し」のペースが追いついていない証拠なので、striking_distance の候補が少ない週に、超過本数の多い言語 (今日時点では PT の 80%) を軸にして追加で2〜3本直す運用を試す予定です。
一斉リライトを我慢する代わりに、1ヶ月で何本返せているかを数えるのは続けます。386本の借金を眺めながら、今週は3本返した、今週は0本だった、を淡々と記録する地味な回収戦です。SEO の仕事はだいたいこういう地味な方に転がっていくのが相場で、そこに正解の近道は無いというのが、1ヶ月回してみての私の体感です。
タイトル lint の思想そのものや、SERP での切れ方の面別ルール、観測 → 判断 → 実装 → 回収のループをどう組むかは、ハーネスエンジニアリング実践ガイドにまとめました。この記事で書いた「一斉にやらない / 小さく割って返す」の運用も、ハーネス側の判断の作法のひとつです。
 関連書籍 ハーネス・エンジニアリング ハーネスエンジニアリング 入門 | AGENTS.md 設計・hooks 実装・AIエージェント運用の体系書 書籍ページを見る →
この記事は役に立ちましたか?