マルチエージェントは15倍トークン食う: Anthropic 公式が1行で公表した現実
Anthropic の公式エンジニアリングブログ「How we built our multi-agent research system」に、1行だけ、やけに素っ気なく置かれた数字があります (Anthropic Engineering)。
In our data, agents typically use about 4× more tokens than chat interactions, and multi-agent systems use about 15× more tokens than chats.
直訳すると「エージェントはチャットの約4倍、マルチエージェントは約15倍のトークンを使う」です。同じ記事には、Claude Opus 4 を lead agent にして Claude Sonnet 4 のサブエージェントを並列で走らせた構成が、単一の Claude Opus 4 を内部調査タスクで90.2%上回ったという数字も載っています。性能は+90.2%、コストは×15。この2行が全てです。
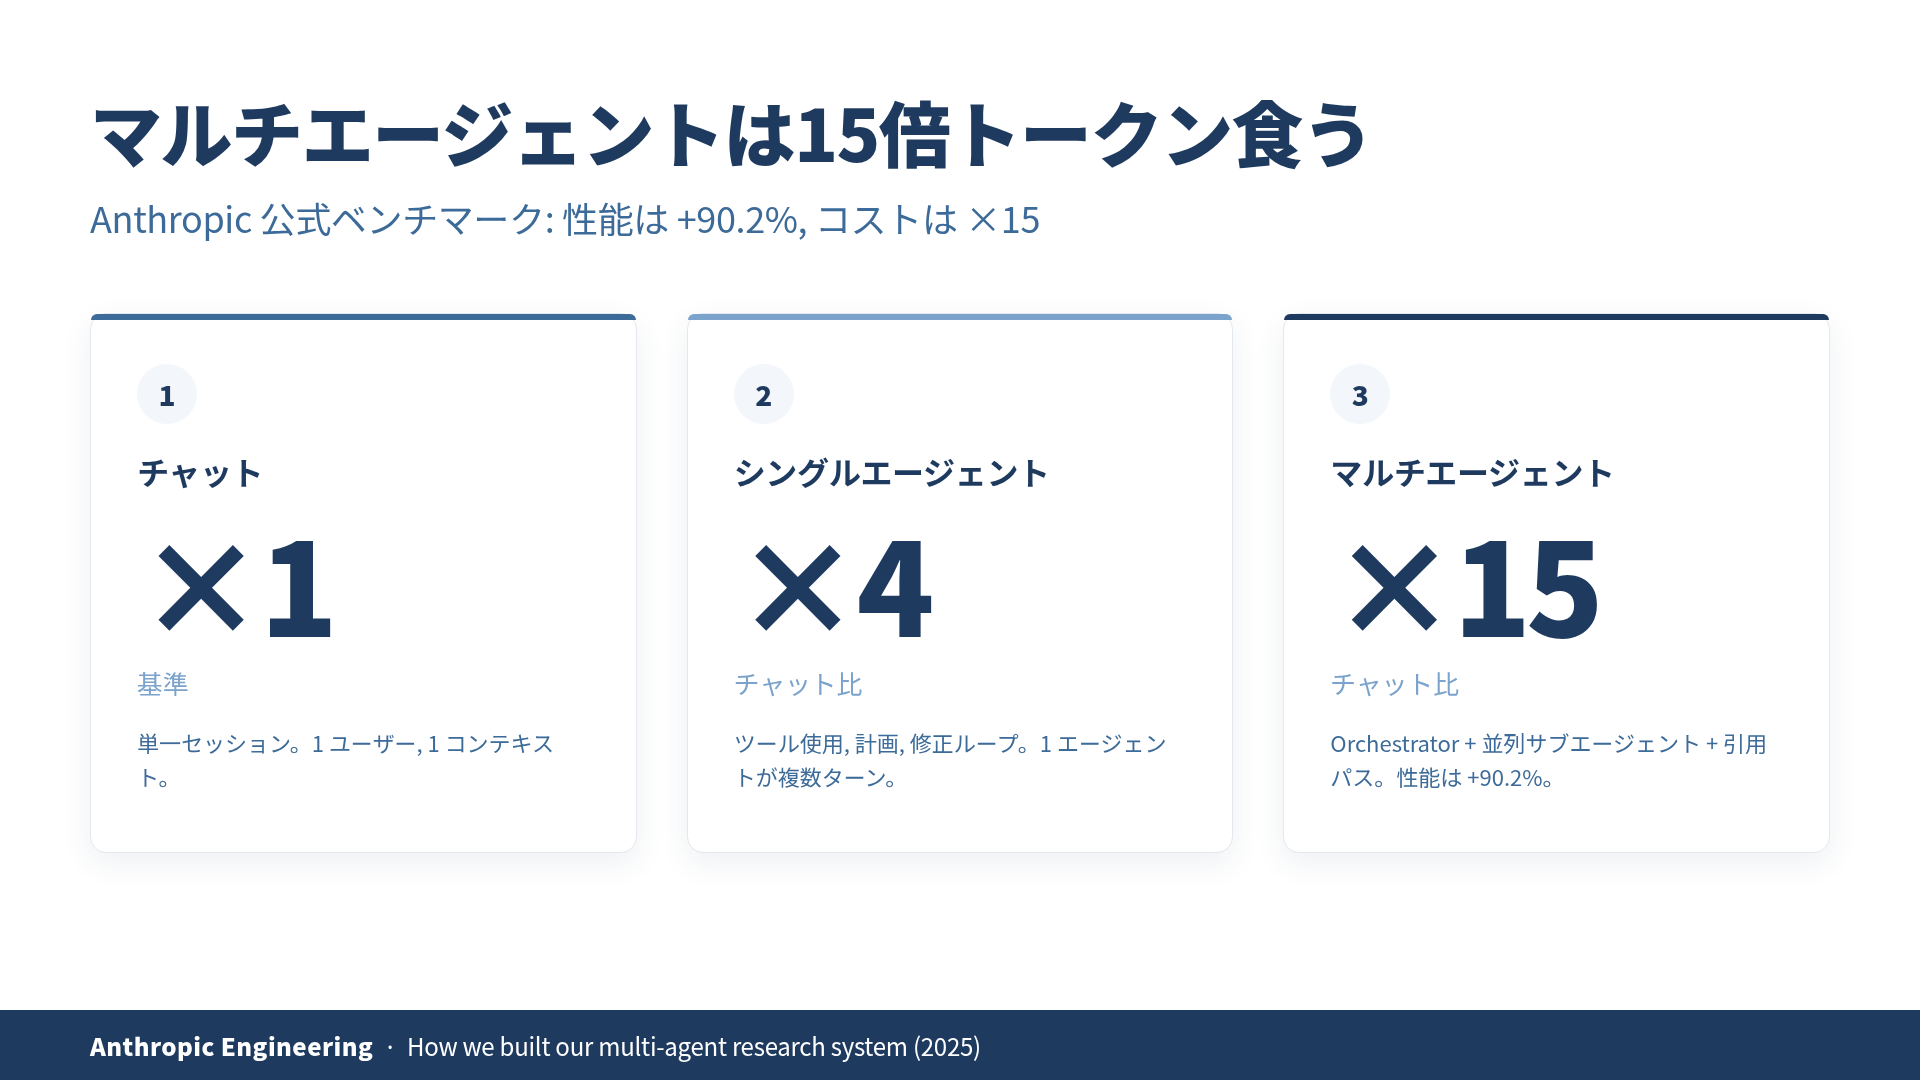
私はこの数字を見てから、個人で組んでいる Claude Code のサブエージェント構成を一度全部ばらしました。並列で走らせる場所と、1体で粘る場所をはっきり分けておかないと、月末の請求書で現実の方からぶつかってくる種類の数字です。「並列は速い」の素朴な感覚と、現場で起きることのズレがここに全部詰まっています。
15倍は「性能改善と抱き合わせの数字」である
まず誤解しやすい点を潰します。15倍のトークンは、同じタスクを「ただ並列化しただけ」で発生する倍率ではありません。Anthropic の構成はこうです。Claude Opus 4 を lead agent (計画と統合担当) に置き、複数の Claude Sonnet 4 サブエージェントが並列で独立した情報源を読む。最後に lead agent が結果を統合する。パイプラインの3段 (lead のプロンプト、サブエージェントそれぞれの文脈、結果の統合プロンプト) が別々にトークンを消費します。
言い換えると、15倍は「3〜4体の独立した頭を同時に走らせ、それをもう1体の頭で束ねたときに自然に積み上がる量」です。性能が90.2%伸びるのは、同じ時間で複数仮説を同時に試して、情報源を広く触れたからで、トークン倍率と性能向上はほぼ同じ構造から生えています。
ここから出てくる結論は冷たくて、1つのタスクを「並列化で安く速くする」は原理的に無理、です。並列化で得られるのは「幅のある情報収集」と「仮説の同時探索」であって、節約ではありません。
並列実行が壊れる4つの場所
数字の次は現場です。私が実際に Claude Code を複数セッションで並列に走らせて踏んだ失敗を、4つの型に分けて書きます。全て、15倍を払う前に設計で封じておきたい話です。
1. 相互干渉: 2つのエージェントが同じファイルに書き込みに来ます。git worktree で物理的にブランチを分けても、最終的に本流に戻すところでマージ衝突が出ます。「同じ package.json を同時に触る」のは、物理的な分離では解けない論理的な競合です。
2. コンパクション喪失: 長時間走ると、各エージェントが別々のタイミングで自動コンパクションに入ります。そのとき「途中まで進めた仕事」の一部が落ちます。並列だと、どのエージェントが何をいつ忘れたかを人間が追うのは実質不可能になります。全体の進捗が誰にも分からなくなる、という静かな破綻です。
3. 人格喪失: 長時間セッションで CLAUDE.md の指示に沿った振る舞いが徐々に薄れていきます。序盤は規約に従っていたのに、後半は無視して暴走するやつです。並列だと、各エージェントが独立に暴走するので、まとめて止めるボタンがありません。
4. 結果の食い違い: 3つのエージェントに「同じテストを書け」と並列で頼むと、3種類の違うテストが返ってきます。どれを採用するかの判断が、今度は人間に押し付けられます。verification-load (検証負荷) が一気に跳ね上がる場所です。
この4つは、「複数走らせれば早い」という感覚を素直に裏切ります。並列化はコストです。設計を持たない並列は、速度ではなく判断疲労を増やします。この構造については、以前書いた「マルチエージェントは並列化で速くなる、は幻想だった」で、調整コストがエージェント数の二乗で増えることを数式で示しました。今日の話は、その二乗則の上に乗ってくる「トークン単価」側の話です。
Supervisor パターンが構造で解く範囲
4つの問題のうち、構造で封じられるのは3つです。Supervisor パターンという設計で、Supervisor が状態と計画を持ち、Worker は短命の作業者として使い捨てる形にすると、こうなります。
- 相互干渉: Supervisor が触れる範囲を割り振る。Worker 同士は会わない
- 結果の食い違い: Supervisor が3つの結果を見て統合判断する。採用判断を人間に戻さない
- コンパクション喪失: Worker が終わるたびに Supervisor がメタ状態を更新する。Worker の中の忘却は Supervisor の記憶で補える
残る「人格喪失」は、Supervisor パターンでも完全には解けません。これは Worker の寿命を短くする (タスク1つで使い捨てる) ことで予防するしかなく、構造ではなく運用の話になります。
Anthropic の research system も、構造としては Supervisor パターンの一種です。lead agent (Claude Opus 4) が計画と統合を持ち、サブエージェント (Claude Sonnet 4) は独立した探索タスクを並列でこなして使い捨てられます。公式ブログの構成図を読む限り、サブエージェントが互いの状態に触りに行く経路はありません。この「触らせない」が、構造で封じる、の実装です。
モデルを分けると何が変わるか
Supervisor パターンのもう1つの効き所は、Supervisor と Worker で違うモデルを当てられることです。
Anthropic 自身のレシピは、lead = Opus 4 / subagents = Sonnet 4 の組み合わせです。この構成で+90.2%の性能改善を出しています。計画と統合には上位モデル、個別の探索タスクには1段下のモデル、という設計で、全部を上位モデルで組むより総トークン単価が下がります (Sonnet 4 の料金は Opus 4 より安いため、サブエージェントの15倍ぶんが Opus 単価で乗らずに済みます)。公式ブログで強調されているのは性能側ですが、料金構造の恩恵は副作用として付いてきます。
もっと攻めた「Opus を Supervisor、Haiku を Worker」の構成でどこまで削れるかは、Anthropic 公式では明言されていません。第三者の運用レポートでは「全部 Opus の構成から比べて数割の削減、ルーティング品質はほぼ維持」といった報告が複数出ていますが、タスクの性質やプロンプト設計で結果が大きく振れるため、具体的な%は自分のワークロードで実測しないと当てになりません。公式の数字は「Opus+Sonnet で+90.2%」までで、それ以上に強い主張はできない、というのが現時点で安全な理解です。
私自身の harness-ops (事業運営を自律化しているローカルハーネス) では、Strategist 相当のレイヤーは Claude のフル機能を当て、Marketer のサブステップはより小さいモデルや単なるシェルスクリプトに切り分けています。具体的な削減%の実測は取っていないので数字は書きませんが、少なくとも「全部 Opus に投げていた頃」より請求書は目に見えて軽くなりました。構造を分けると請求書が軽くなる方向に動く、くらいは体感で言えます。
並列が効くタスクと、効かないタスク
15倍を払って90%の性能改善が「割に合う」かは、タスクの性質で決まります。私が自分の中で持っているルールを3つだけ書きます。
1. 探索的調査には並列を当てる: 「このエラーの原因を3方向から調べて」のように、仮説が複数ある場面。1体で順に試すより、並列で同時に当たったほうが人間の意思決定が速くなります。15倍のトークンが「幅のある情報収集」として戻ってきます。
2. 独立した一括処理には並列を当てる: 「20個のテストファイルを並列でリファクタリングして」のような、互いに干渉しないタスク。並列化の恩恵がほぼ純粋に効き、調整コストが乗りません。
3. 文脈依存の連鎖には並列を当てない: 「前のステップを踏まえて次を決める」が繰り返される構造は、原理的に並列化できません。無理に分けても Supervisor 経由でシリアルに戻るだけで、トークンだけが膨らみます。日常のLint修正や、1本道のバグ修正はここです。シングルエージェントで十分です。
Anthropic の数字をそのまま個人の設計に輸入するなら、「性能が90%跳ねる価値があるタスク」と「ないタスク」を自分の中で分けておく、というのが結論です。「とにかく並列で走らせる」設計は、15倍を払って90%を取り逃がす場所に簡単にハマります。
まとめ
Anthropic が公表した「マルチエージェントはチャットの15倍トークン」という1行は、並列化が節約ではないことを公式に認めた数字です。15倍を払って+90.2%の性能を取りに行く構成なので、タスクが「幅のある探索」でないなら、そもそも並列化を選ぶ理由がありません。
Supervisor パターンは、4つの壊れ方のうち3つ (相互干渉、結果の食い違い、コンパクション喪失) を構造で封じます。モデルを分けられるので、全部を上位モデルで組むより総コストも下がります。Anthropic 公式のレシピは Opus + Sonnet で、ここより攻めた構成の削減%は自分のワークロードで実測するしかありません。
マルチエージェントは、使うと決めてから設計するものではなく、「ここは15倍を払うに値する」と判断してから使うものです。公式が1行で公表した数字は、その判断の起点になります。
マルチエージェントの運用設計、Supervisor と Worker の切り分け、CLAUDE.md での人格維持といった「エージェントを支える足場 (ハーネス)」側の設計は、書籍『ハーネス・エンジニアリング』で体系的にまとめています。15倍を払う前に読んでおくと、請求書が少し軽くなるかもしれません。
 関連書籍 ハーネス・エンジニアリング ハーネスエンジニアリング 入門 | AGENTS.md 設計・hooks 実装・AIエージェント運用の体系書 書籍ページを見る →
この記事は役に立ちましたか?