事故を4回。止まったのはシミュレーションの発想
harness-opsは、私が運用している自動化システムです。cronが時間になるとAIエージェント(Claude)を呼び出し、どの記事を書くか・いつ公開するかという判断から、記事の生成や投稿までを任せています。エージェントへの指示は、各スクリプトがシェル上で組み立てる1本のプロンプト文字列です。
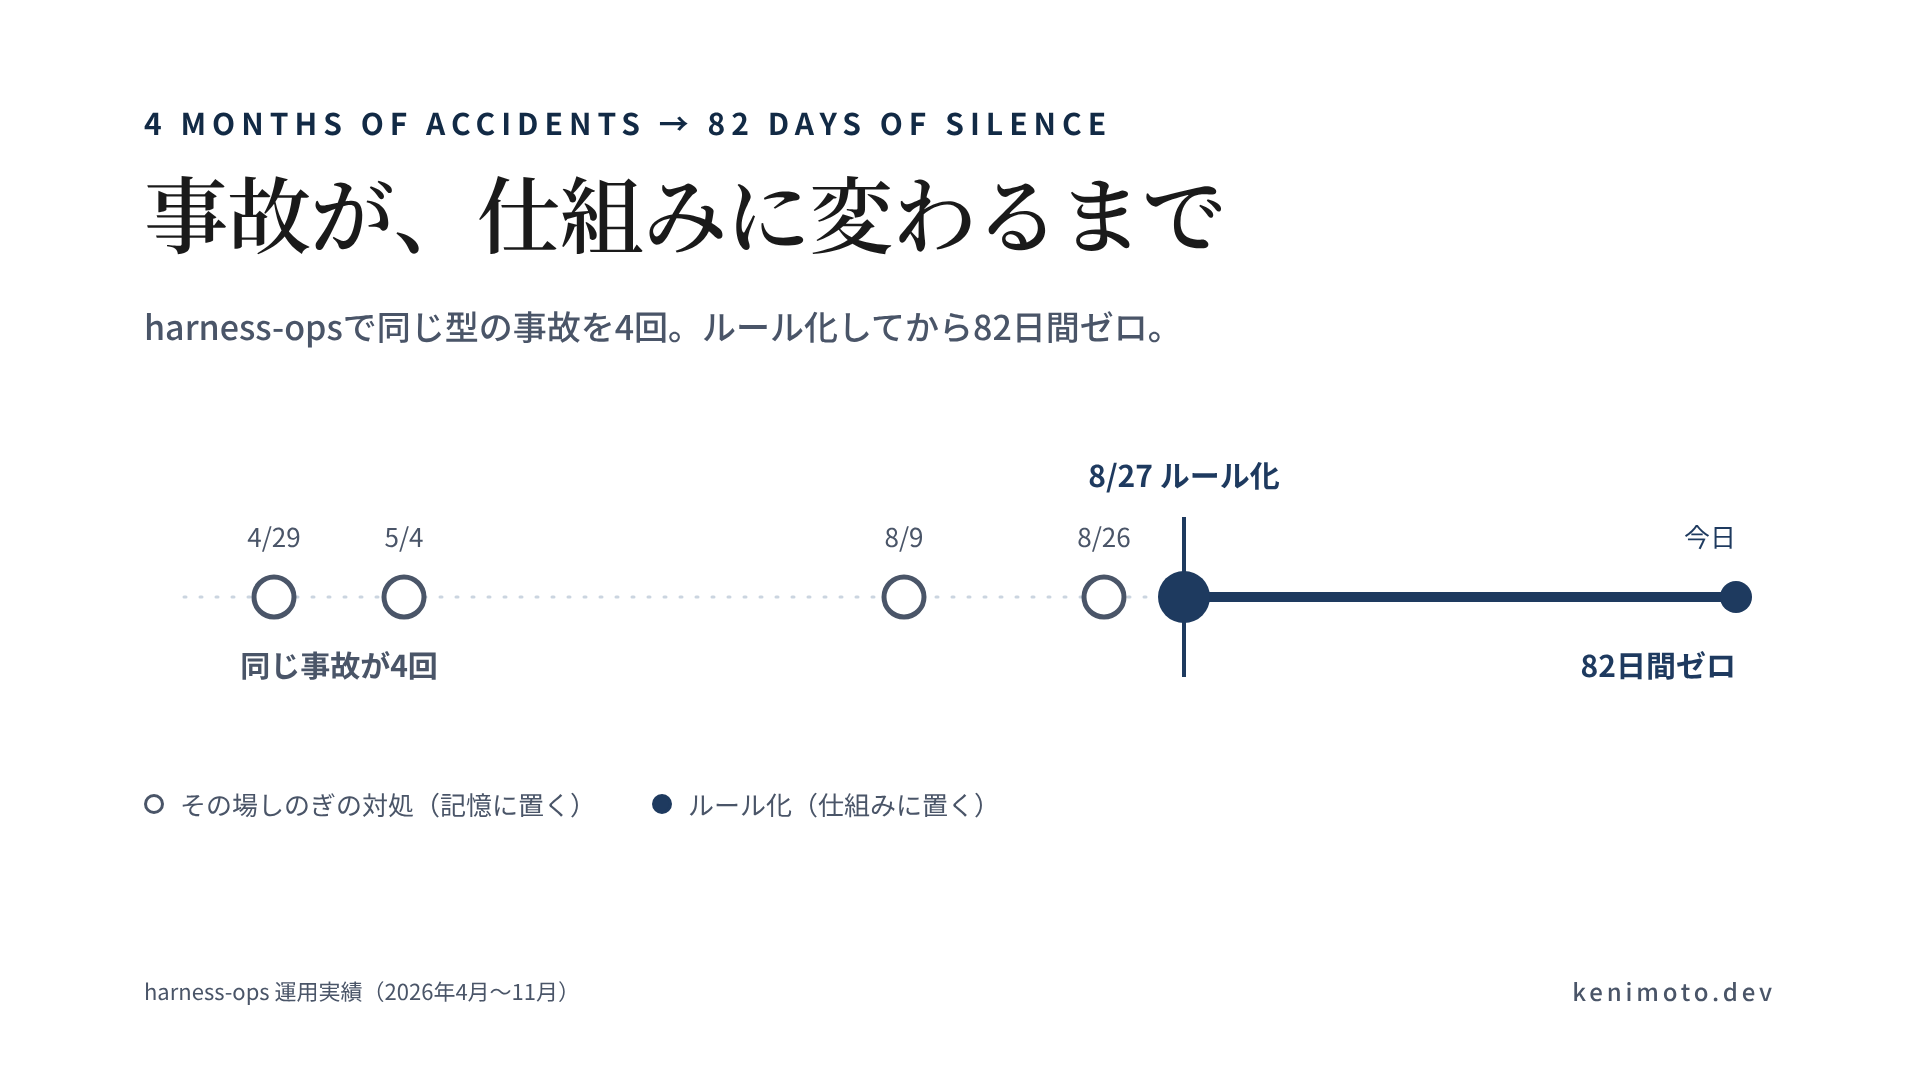
2026年4月から8月の間に、このプロンプトを組み立てる行で同じ型の事故が少なくとも4回起きました。本文に書いたクォート(バッククォートやダブルクォート)が、エージェントに渡る前にシェル自身に解釈されてしまう、という事故です。直近の8月26日には、4サイトを運用しているstrategistが2日間連続で失敗し、chainが止まってmarketerも動かず、3サイトの投稿が飛びました。
8月27日、やり方を変えました。lint-prompt-quotes.sh という検査スクリプトを作り、各スクリプトのプロンプト本文を、pushする前に機械的に検査するようにしました。それ以降、今日まで82日間、同じ型の事故は起きていません。
「直す」には2種類あります
4回とも、私はちゃんと直していました。やることは毎回同じで、エラーが出ている行を見つけて、その場で直すだけでした。
でも、次に別のスクリプトを書くとき、その教訓は私の頭の中にしかありませんでした。「プロンプト本文のクォートは危険」という知識は、気をつけていても抜けます。実際、何度も抜けました。
ここで気づいたのは、「直す」という行為には2種類あるということです。
- その場の症状を消す: エラーが出ている行を直して、動くようにする
- 同じ型の問題が二度起きないようにする: 検査のルールを作り、次に同じ罠を踏もうとしたときに機械的に止める
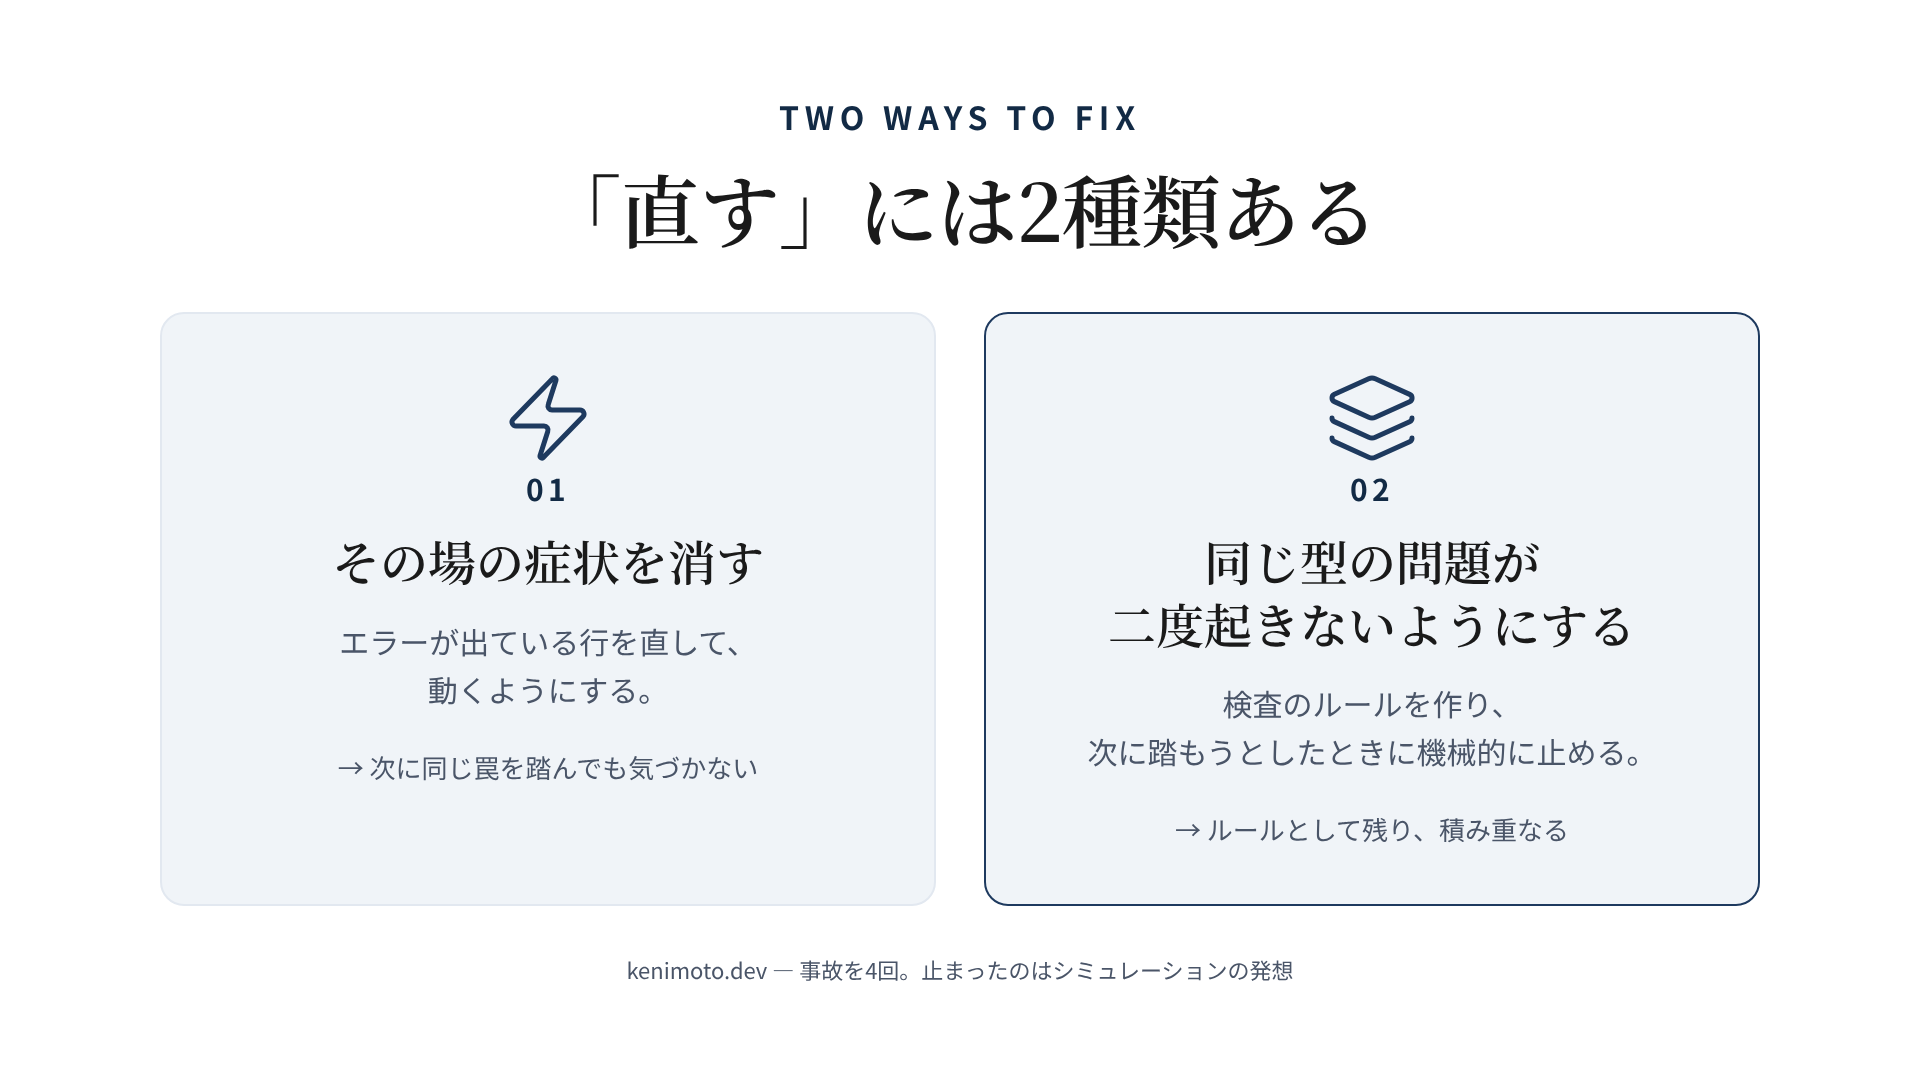
4回とも、私がやっていたのは1だけでした。8月27日にやったのは2です。知識を人間の記憶に置くのをやめて、ルールとして残し、毎回機械的に検査する側に置きました。それが82日間の無事故につながっています。
なぜAIエージェントの運用にはシミュレーションが必要なのか
ここまでの話は、私のスクリプトの中の、静的な検査の話です。書く前に危険なパターンを機械的に拒否する、という仕組みでした。
でも、AIエージェントが外部の本物のサービス(決済、メール、ストレージ、認証)と話す場面では、静的な検査だけでは足りません。危険なのはコードの書き方ではなく、相手が本物であるがゆえに起きる、こちらが選べない失敗だからです。
エージェントに「決済が失敗したときの処理を直して」と頼みます。エージェントはコードを直し、「動作確認しました」と報告します。多くの場合、その確認は、本物の決済サービスに対して、正常系のテストを1回流しただけです。
本番で実際に起きるのは、こういうケースです。
- 決済が1回目は失敗し、2回目に成功する
- SMSが届かず、ユーザーが折返しのWhatsAppで返信してくる
- トークンがフローの途中で失効する
- アップロードが2回失敗してから成功する
これらは、ステージング環境が本物のプロバイダーと話している限り、意図的に再現しようとしない限り、絶対に起きません。エージェントの「動作確認しました」は、起きていないケースについて何も証明していません。
ここで必要になるのが、障害そのものを演じさせる仕組みです。書く前に危険なパターンを拒否する検査では足りず、実際に障害を起こして、エージェント自身に復旧を証明させる必要があります。 これがシミュレーションです。
Stuntmanという、シミュレーションを仕組みにする道具
2026年11月、Stuntmanという名前のOSSプロジェクトが公開されました(作者: edivanteixeira、Apache 2.0ライセンス)。公開から3日、star3の生まれたてのプロジェクトで、名前自体も「working name(仮の名前)」と明記されています。
やっていることはシンプルです。アプリが呼び出す外部プロバイダーの代わりに立ち、本物と同じパス・同じレスポンス形式・同じステータスコードで応答します。それだけでなく、いつ失敗させるかをルールとして定義できます。「次のアップロードを2回だけ503で失敗させて、その後は正常に戻す」。これをYAMLのルールとして書くと、エージェントはそのルールの下で実際にアプリを動かし、本当にリトライして復旧するかを確認できます。
プロジェクトの原則の1つに、こう書かれています。
Text is the source of truth. The web UI is a second way to edit the same YAML, never a separate copy.
(訳: テキストが正であり、ウェブUIは同じYAMLを編集するもう一つの手段に過ぎない。別のコピーではない。)
テキスト(YAML)が正であり、UIはその編集手段の一つに過ぎない、という考え方です。これは、私がlint-prompt-quotes.shで学んだこと(障害のシナリオを人間の記憶や1回の確認に置かず、テキストのルールとして残す)と同じ形をしています。静的な検査とシミュレーションは、拒否するタイミングも相手も違いますが、残す場所は同じです。
もう1つの原則も近いです。
The provider’s words first.
(訳: プロバイダーの言葉が先。)
エージェントが「成功しました」と報告する言葉ではなく、実際のHTTPのやり取り(タイムライン)が証拠になります。Stuntmanは、アプリが実際に送ったリクエストと受け取ったレスポンスを全部記録します。エージェントの要約よりも、記録を読んで確認することを優先する設計です。
シミュレーションがなければ、一生対処を繰り返します
4回の事故も、障害対応も、根は同じです。知識が記憶に置かれている限り、何度でも同じ罠を踏みます。
決済の2回失敗からの復旧ロジックを一度直したとしても、そのテストが「その場で1回動かして確認した」で終わっていれば、半年後に別の開発者(あるいは別のエージェント)がコードに手を入れたとき、同じ経路がまた壊れていないかは誰も保証しません。壊れてから、また同じ原因を調べ直すことになります。
これは、障害対応の知見が積み重ならない状態です。毎回、同じ種類の問題を「初めて」として扱い、同じ時間をかけて原因を特定し、同じ修正をします。
ルールとして残せば、違います。決済の2回失敗シナリオは、YAMLのルールとして残ります。次にそのコードに誰か(人間でもエージェントでも)が手を入れたとき、同じルールの下でもう一度流せます。壊れていれば、すぐに分かります。壊れていなければ、それも記録になります。
これが、シミュレーションを「一回のテストツール」ではなく「運用し続ける仕組み」として持つ価値だと思います。82日間の無事故を支えているのは、クォートに気をつけ続けたことではありません。気をつけなくても止まる仕組みを作ったことです。
結び
Stuntmanはまだ生まれたばかりで、サインインの機能すらありません。プラグインの形式もこれから変わるかもしれません。でも、そこに書かれている原則(テキストが正、プロバイダーの言葉が先)は、私が4回の事故を経て学んだことと、驚くほど近いものでした。
エージェントに「直りました」と言われたとき、何で確認していますか。もしその答えが「今、目の前で動いている」だけなら、それは「今日は晴れている」と言っているだけです。傘が要らないかどうかは、別の話です。
 関連書籍 MCP実践セキュリティ MCP セキュリティの実践書 | OWASP MCP Top 10・攻撃の実演・認証認可・本番ワークアラウンド 書籍ページを見る →
この記事は役に立ちましたか?