Ollama vs llama.cpp 2.8倍
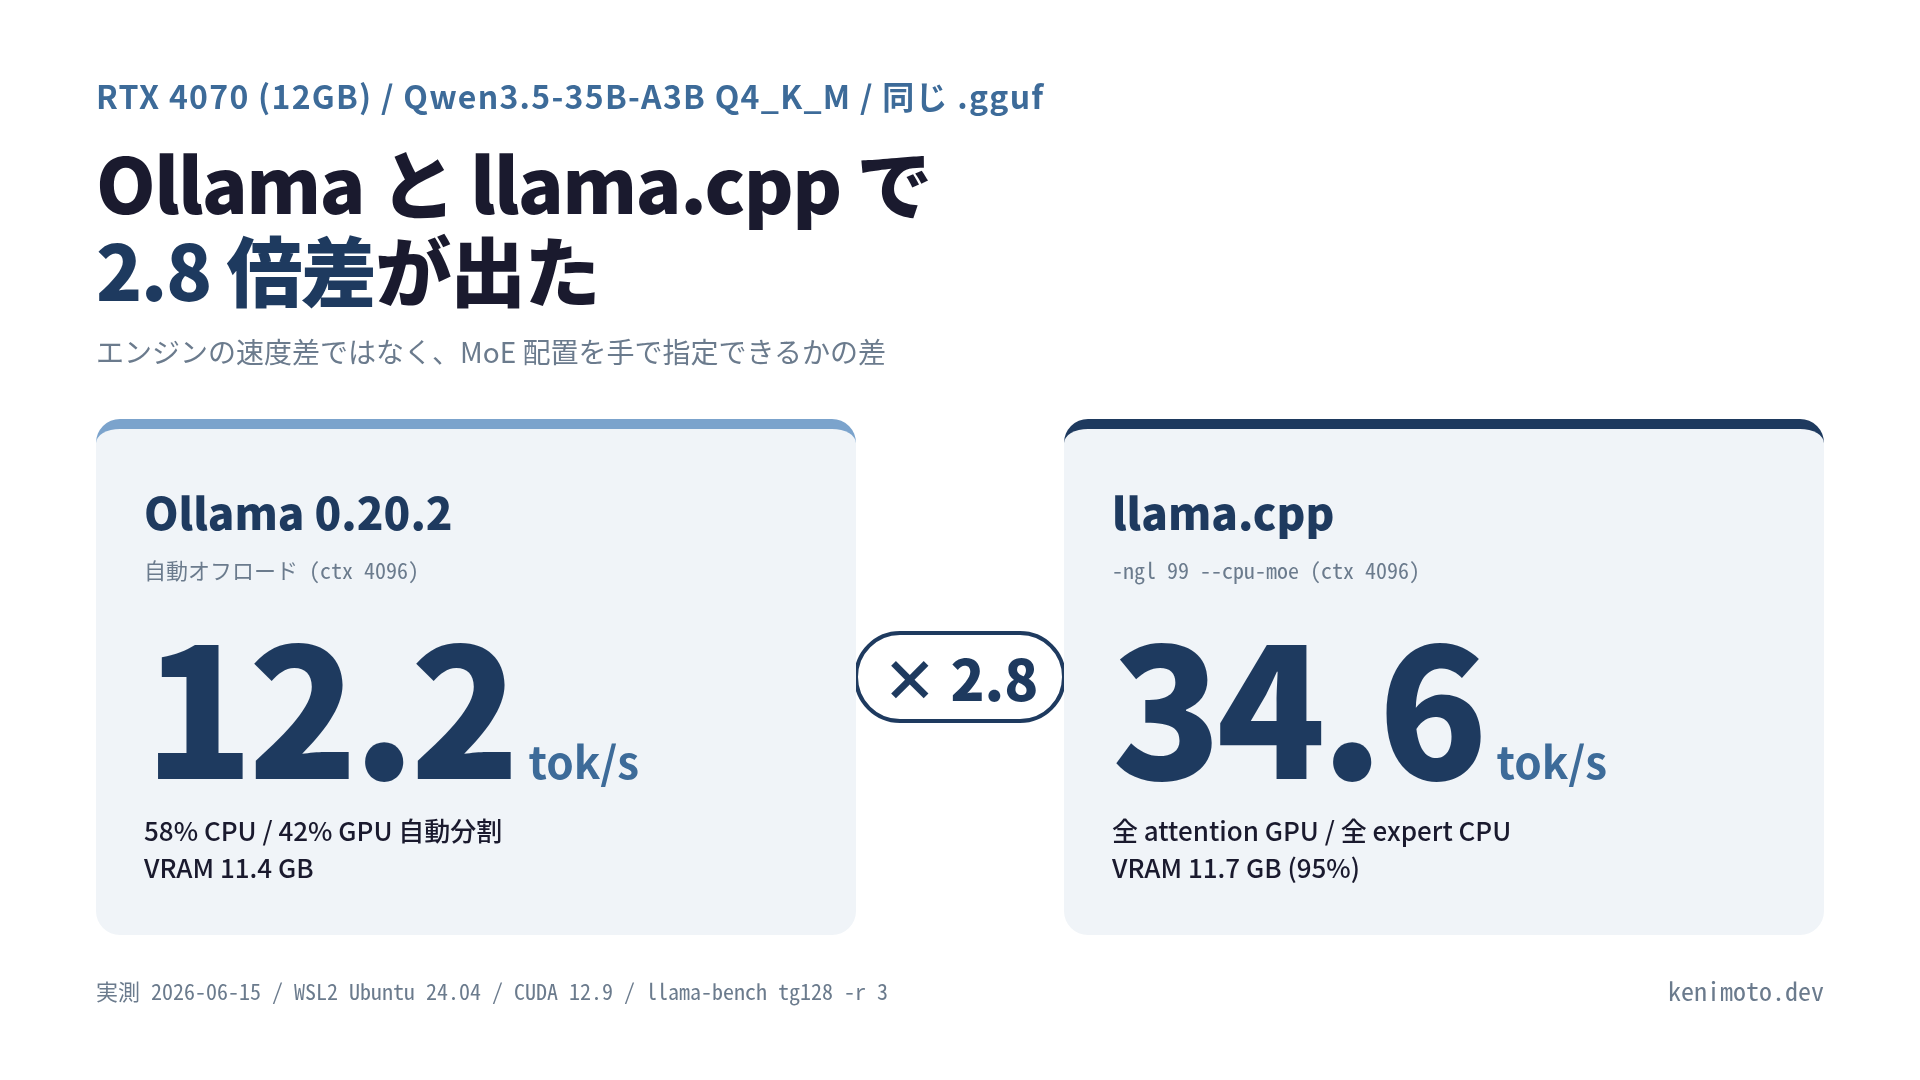
RTX 4070 (12GB) で 35B を動かす仕事で、私は Ollama と llama.cpp を使い分けています。同じ .gguf を同じ GPU に食わせても、生成速度は 12.2 と 34.6 tok/s。2.8 倍ひらきました。
これを「llama.cpp は速くて Ollama は遅い」で片付けると、たぶん選定を間違えます。差の正体は、エンジンの中の 判断の自動化レベル の違いで、どっちを選ぶかは状況で変わります。
計測条件を先に
借り物の数字ではないので、環境を先に全部出しておきます。
- GPU: RTX 4070 (12GB)
- RAM: 31 GiB (WSL2 側に見える量)
- OS: WSL2 Ubuntu 24.04
- CUDA: 12.9
- モデル: Qwen3.5-35B-A3B の Q4_K_M 量子化 (20.49 GiB、34.66B パラメータ)
- Ollama: 0.20.2
- llama.cpp: CUDA 有効ビルド (
-DGGML_CUDA=ON) - 計測は
llama-benchの tg128、3 試行
生成側のベンチは「128 トークン生成を 3 回」で、Ollama 側は同じ .gguf を Modelfile 経由で読ませてプロンプトを揃えました。実測日は 2026-06-15 で、以降のバージョン更新は追っていません。だからこの記事の数字は「あの日のあの環境」の値で、読んだ日の最新ビルドでは多少動くはずです。前置きとして書いておきます。
2 エンジンの実測
結果はこうなりました。
| エンジン | 設定 | 生成速度 (tok/s) | VRAM 使用 | CPU/GPU 分割 |
|---|---|---|---|---|
| Ollama 0.20.2 | 自動オフロード (ctx 4096) | 12.2 | 11.4 GB | 58% CPU / 42% GPU |
| llama.cpp | -ngl 99 --cpu-moe -c 4096 | 34.60 | 11.7 GB | 全 expert CPU / 全 attention GPU |
Ollama の 12.2 tok/s 自体は、遅いとは思いません。35B を 12GB の家庭用 GPU で動かしているのだから、むしろ健闘している方です。引っかかるのは、同じハードウェアと同じモデルファイルで llama.cpp 側が 2.8 倍を叩き出している、という事実が隣にあること。
ここから選び方に入ります。
判断の自動化レベルが違う
Ollama と llama.cpp は、ランタイム層ではどちらも ggml 系のコードを踏んでいて、同じ .gguf を扱います。ところが「どこに何を置くか」の決め方は、2 つで方針が反対です。
Ollama は配置を自動で決めます。ollama run qwen35 と打つと、エンジンが手元の VRAM を見て、モデルを層単位でなるべく GPU に積む。入り切らない分は CPU に逃がす。この自動分割は dense モデル (Llama 3.1 70B など) ではだいたい正解です。全部の層が毎ステップ使われる前提なので、GPU に乗る分を乗せれば素直に速くなるからです。
対して llama.cpp は手配置です。-ngl 99 と書けば「全層を GPU に載せろ」の意思表示で、--cpu-moe を足せば「ただし MoE の expert は CPU に逃がせ」という例外指定になる。層単位の判断は呼び出した人間に委ねられていて、何も指定しなければ GPU には何も載りません。
MoE モデルでは、この違いが数字に出ます。
Qwen3.5-35B-A3B は MoE で、総パラメータ 35B のうち 1 トークンで実際に動く active な部分は約 3B (256 expert のうち routed 8 + 共有 1) にすぎません。計算が疎なので、expert を CPU に置いても毎ステップのペナルティは軽い。一方で attention と KV キャッシュは毎ステップ全部読まれるので、メモリ帯域の速い GPU に置くリターンが大きい。-ngl 99 --cpu-moe はこの構造を踏んだ手配置で、Ollama のデフォルトは層単位の自動配置なので、ここまでは踏み込まない。
結果として Ollama の自動分割は、MoE に対しては少し惜しい選択を続けます。帯域が効くはずの attention を CPU に押し出して、CPU 帯域でも軽いはずの expert を VRAM の一等地に積む、みたいな逆向き配置が混ざってくる。12.2 tok/s はこの「惜しさ」が積み上がった値です。
llama.cpp 側で手にしたのは柔軟性だけ
llama.cpp の 34.6 tok/s は、エンジン自体が速いから出たというより、手で指定したから出た数字です。同じ llama.cpp でも -ngl 99 だけで --cpu-moe を抜くと、tg128 は 12.94 tok/s でした。Ollama と誤差の範囲です。--cpu-moe を抜いた llama.cpp は Ollama と同じく「GPU に乗る分を乗せる」発想に落ちていて、expert と attention の役割分担まで降りてこない。この条件なら 2 エンジン間に有意な差は出ません。
2.8 倍差の中身は、エンジン同士の生の速度差ではなくて、MoE 構造を踏まえた配置を書けるかどうかにあります。llama.cpp には書くための口が開いていて、Ollama は (本記事を書いた時点のバージョンでは) そこまで降りてこなかった、ということです。
もう 1 つ判断材料があります。-ngl 99 --cpu-moe で動かすと、VRAM は 11.7 GB で天井 (12 GB) のほぼ 95% まで埋まります。余白は 600 MiB しかない。この構成は、裏で Windows の常駐プロセスが VRAM を 1 GB 握った瞬間に OOM で落ちます。計測前に nvidia-smi で VRAM をクリーンにしてから起動、というお作法を踏むのはこの余白の無さが理由です。Ollama の自動分割はこの余白を勝手に確保してくれる代わりに、2.8 倍を取りには行きません。安全マージンと生成速度を Ollama 側が勝手に交換してくれていて、llama.cpp はその交換を自分で止めている、と見るとつじつまが合います。
私がエンジン選定で見ている 3 点
同じ家庭用 GPU で MoE を動かすとき、私がエンジン選定で見ているのは 3 点です。
1. モデルが MoE か dense か。 dense (Llama 3.1 70B のような全層稠密なモデル) 相手なら、Ollama の自動分割はほぼ正しい判断を返します。ここで llama.cpp に手で乗り換えても、2.8 倍のような差は出ません。MoE かどうかで、エンジン選定の意味がだいぶ変わる。本記事の実測が成立しているのは Qwen3.5-35B-A3B という MoE だからで、同じ 35B でも dense ならこの話は成り立ちません。
2. エージェント連携を長く続けるか、単発プロンプトか。 llama.cpp を -c 4096 で立ち上げっぱなしにすると、VRAM 11.7 GB の緊張状態が延々続きます。短い対話を 1 発撃つだけなら Ollama の自動分割の方が気楽。Qwen Code CLI のような重めのエージェントだと初回リクエストで 2 万トークン近く食うので、-c 32768 --cpu-moe 構成で llama-server を常駐させた方が結果として安定します。この辺の長文脈実測は過去記事 RTX 4070 2 フラグ + KV 量子化 に書きました。
3. VRAM 使用量を自分で見張れるか。 -ngl 99 --cpu-moe は VRAM 95% 構成で、Windows 側の WebGL タブが 1 枚起動しただけで吹き飛びます。この監視コストを払えないなら、Ollama の自動分割 (VRAM 11.4 GB、余白 600 MiB) の方が運用は楽です。2.8 倍を取りに行くかどうかは、結局この監視コストを払うかどうかの判断と重なります。
要するに、エンジン選定は速さランキングではなくて、自分が運用上払えるコストに合わせた選び方になります。llama.cpp を選ぶなら、--cpu-moe を含む配置の知識、VRAM の監視、モデルが MoE という前提、この 3 点が揃っている必要がある。揃わないなら Ollama の自動分割に戻る方が、たぶん平和です。
書けなかったこと
今回の実測は Ollama と llama.cpp の 2 エンジンだけです。vLLM や TGI のような高スループット重視のサーバ系は、同じ GGUF を直接食わせるパスが違っていて、本記事の計測対象には入れていません。手持ちで 3 エンジン目まで届いていないので、本記事の 2.8 倍は 2 エンジン間の数字と思って読んでください。
2.8 倍のうち --cpu-moe フラグ単体の寄与は、過去記事 Ollama 12.2 tok/s が 34.6 tok/s になった で分解しました。本記事はそのフラグ単体ではなくエンジン選定の判断側に寄せています。フラグの中身を知りたい方はそっちが近道です。
まとめ
- 同じ
.ggufを同じ RTX 4070 (12GB) に食わせても、Ollama 自動分割は 12.2 tok/s、llama.cpp-ngl 99 --cpu-moeは 34.60 tok/s、差は 2.8 倍 - 中身はエンジン自体の速度差ではなく、MoE 構造を踏まえた層配置を「自動で諦める」か「手で指定する」かの判断差
- llama.cpp の 34.6 tok/s は VRAM 95% 構成で、監視コストを払って取りに行く数字
- MoE か dense かでエンジン選定の意味が変わる。dense ならどっちでも大差ない
- 2 エンジンの実測。vLLM など 3 エンジン目は今回入れていない
エンジン選定を「速さランキング」で丸めると取り違えます。見るのはモデルの構造 (MoE か) と自分の運用コストで、どっちを払えるかで決まる話でした。もっと深く追いたい方は、全 10 章で計測ログと再現コマンドを並べた RTX 4070 で動かす 35B ローカル LLM に同じ数字の裏側が全部あります。
 関連書籍 RTX 4070でQwen 35Bを2.8倍速くする RTX 4070 × Qwen 35B — llama.cppのフラグ2つで 12.2 → 34.6 tok/s、2.8倍 書籍ページを見る →
この記事は役に立ちましたか?