ローカルLLMの自走 claw+35Bは終了0/5
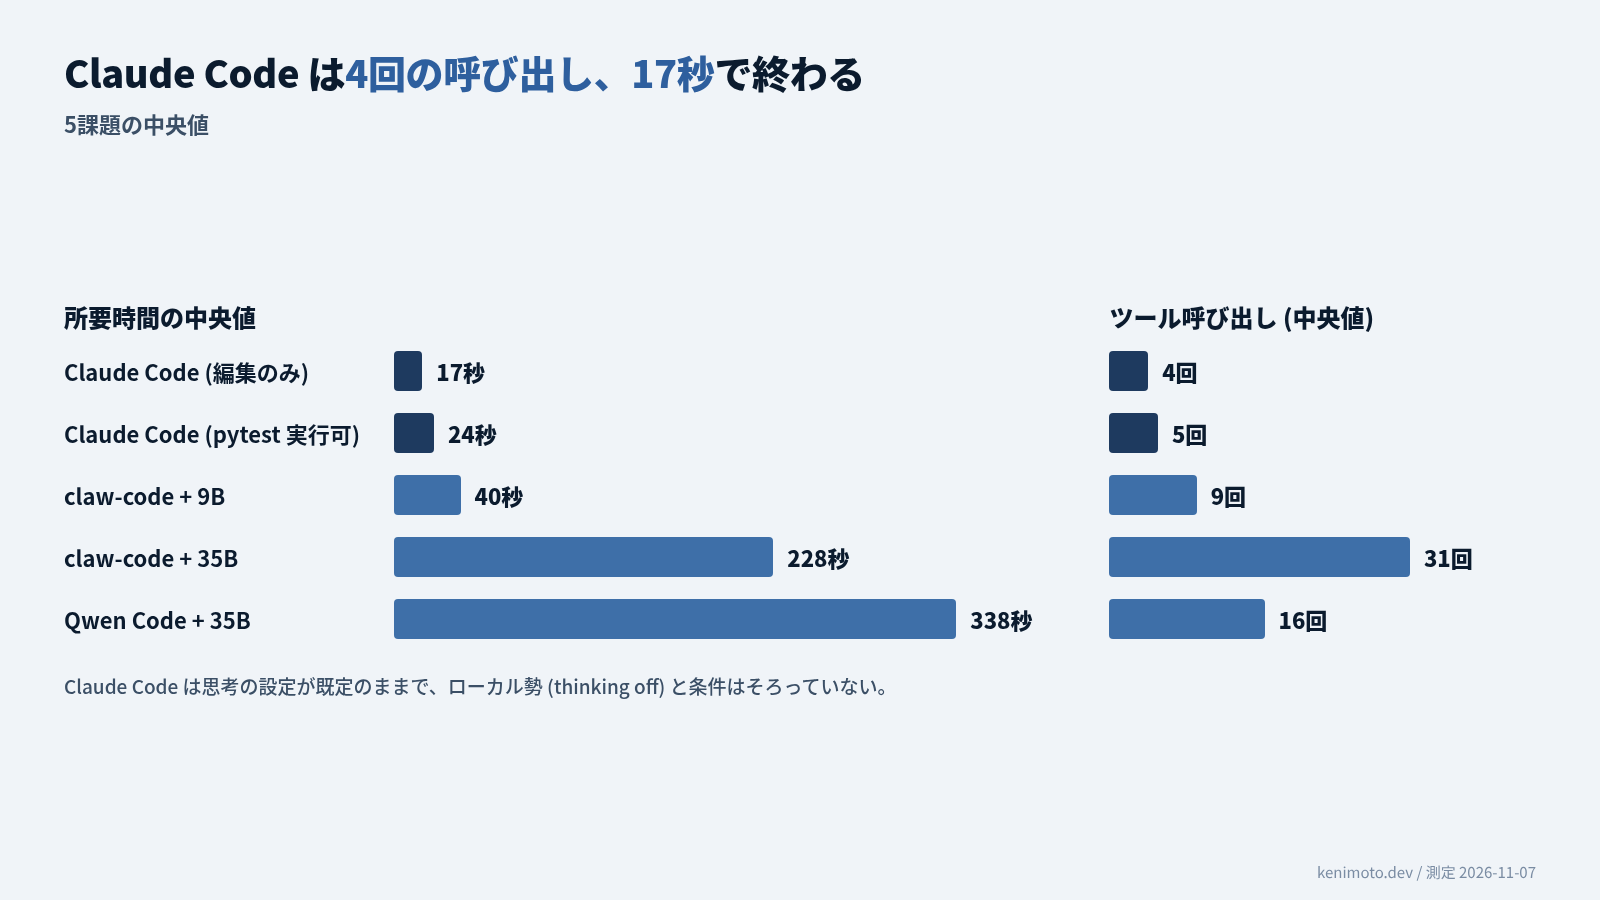
ローカルLLM に依頼を丸ごと任せて、Claude Code のように自走させるとどうなるか。使ったのは、ローカルのモデルにつないで Claude Code のように動く CLI の claw-code と Qwen Code です (どちらもファイルを読み書きしながら課題を進めます)。テスト付きの小さな課題5件で試すと、claw-code と 35B はコードを5件とも正しく直したのに、自分で終われたのは0件でした。Qwen Code と 35B は合格2件・自分で終了2件、claw-code と 9B は合格2件・自分で終了3件です。Claude Code は5件すべてに合格しました。中央値17秒です。
claw-code と 35B が詰まったのは、コードを書く力のほうではありません。作業を終える判断です。
テストを回せない環境で「確かめたい」を繰り返し、5件とも文脈を使い切って止まりました。Qwen Code も同じ呼び出しの連続を検出されて3件が止められ、9B は仕様の読み落としで落ちています。手順を切り出して渡せばローカルで足りる仕事でも、手順の並びを自分で決めさせると別の壁に当たります。
5つの課題
使い捨ての git リポジトリを課題ごとに作り、エージェントに作業ディレクトリとして渡しました。
| 課題 | 中身 |
|---|---|
| a1 新規ファイル | README の仕様どおりに文字列の統計を返すモジュールを新しく作る |
| a2 月の加算 | 1月31日 + 1か月で例外になるバグを、月末は繰り下げる仕様に直す |
| a3 在庫 | 在庫がマイナスになるバグを、docstring の仕様どおりに直す |
| a4 3ファイルの変更 | 請求書を円以外 (USD・EUR) でも出せるようにし、整形・請求書・集計の3ファイルを直す |
| a5 テストを書く | 実装を変えずに、ユーザー名の検証関数のテストを書く (正しい実装で通り、わざと壊した版7個のうち6個以上を落とせば合格) |
合格と、自分で終われたか
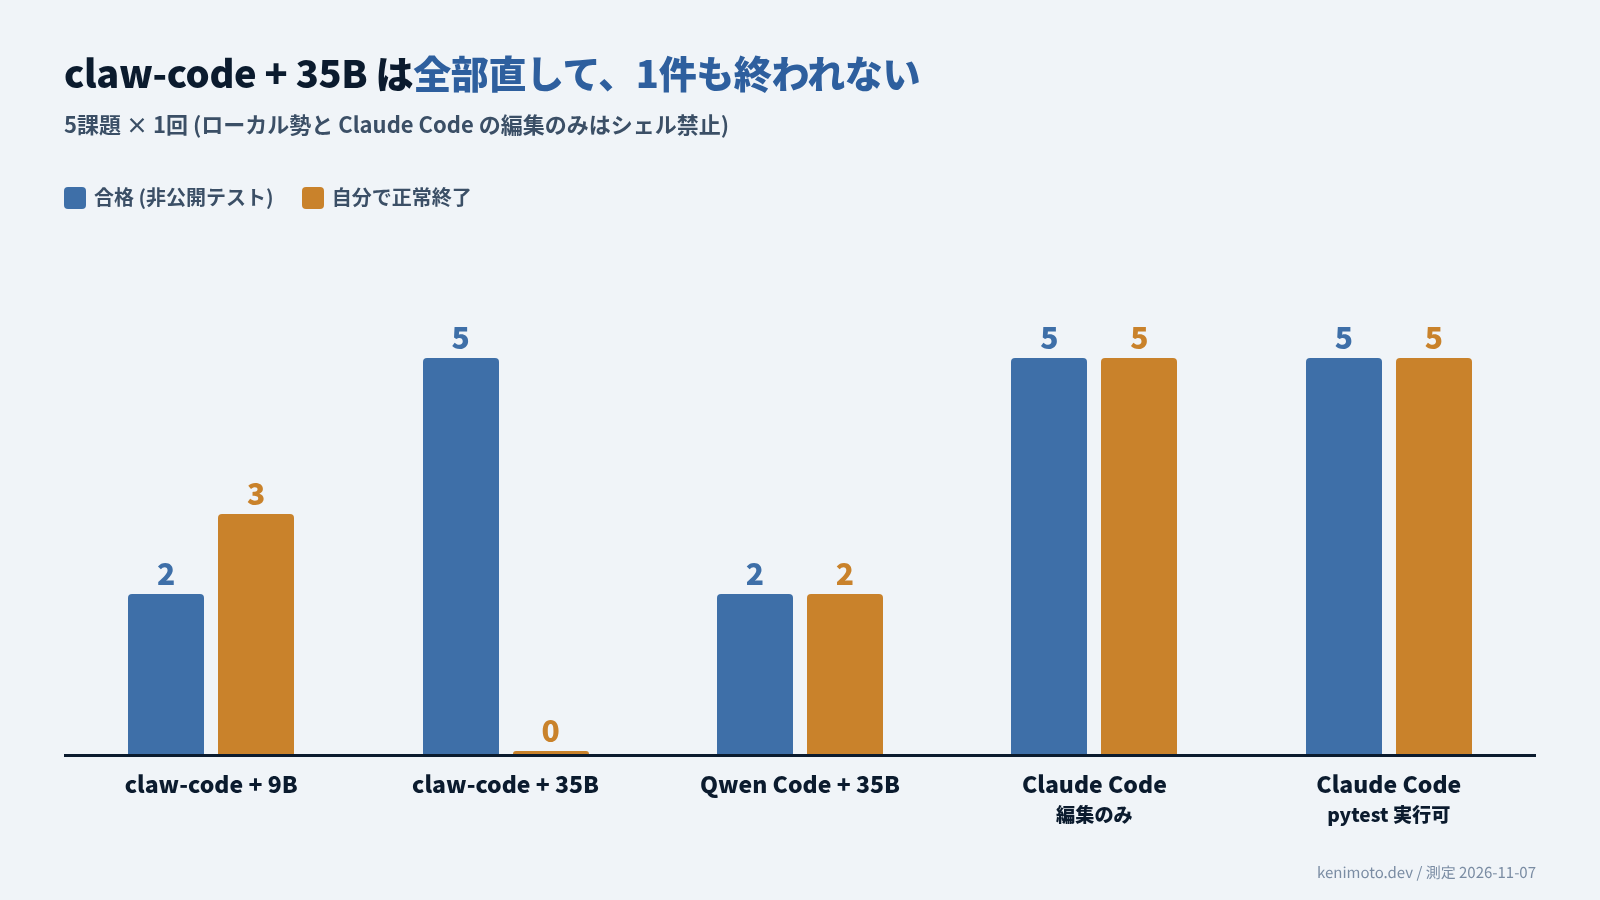
| エージェント | 合格 | 自分で終了 | 所要時間 (中央値) | ツール呼び出し (中央値) |
|---|---|---|---|---|
| claw-code + 9B | 2/5 | 3/5 | 40秒 | 9回 |
| claw-code + 35B | 5/5 | 0/5 | 228秒 | 31回 |
| Qwen Code + 35B | 2/5 | 2/5 | 338秒 | 16回 |
| Claude Code (編集のみ) | 5/5 | 5/5 | 17秒 | 4回 |
| Claude Code (pytest 実行可) | 5/5 | 5/5 | 24秒 | 5回 |
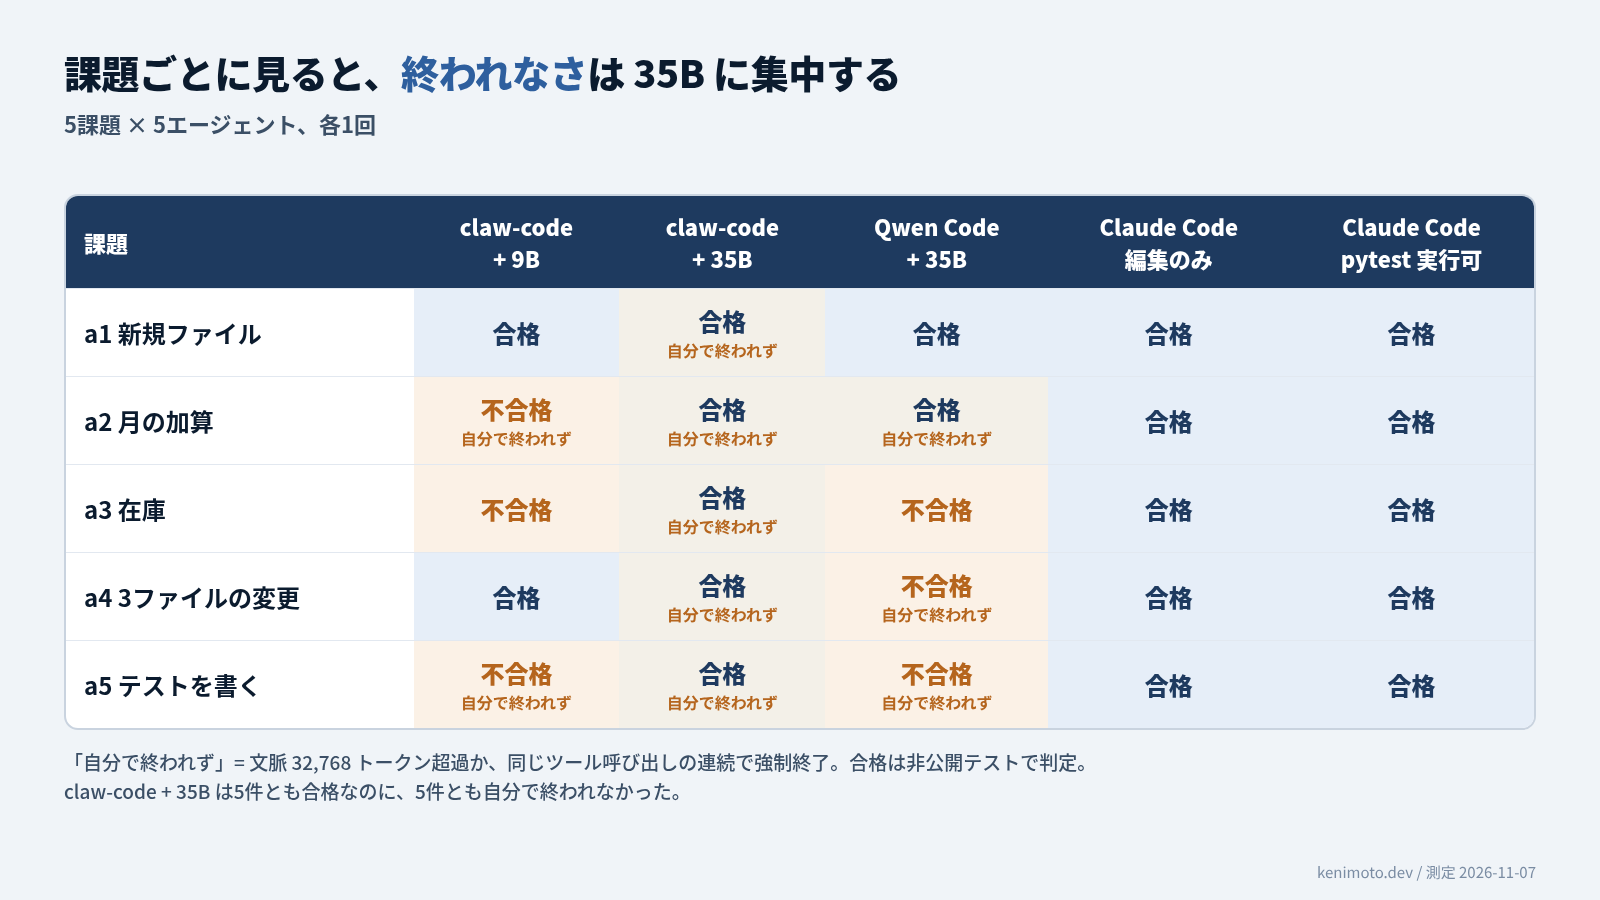
claw-code と 35B: 直したのに終われない
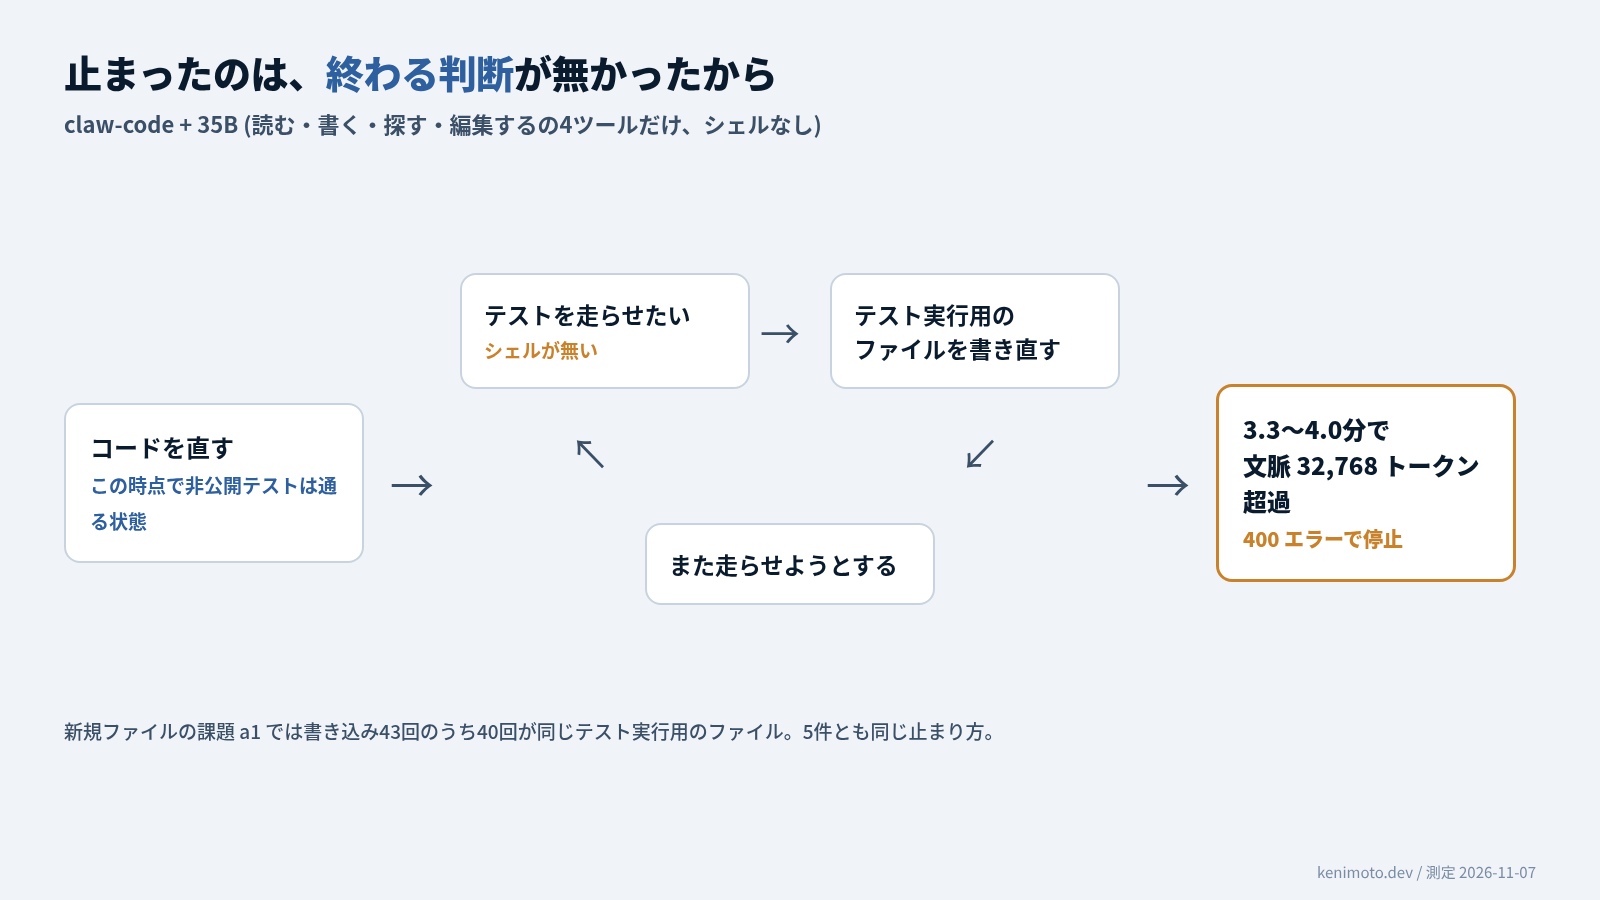
claw-code と 35B は、5件ともコードを正しく直しています。終われませんでした。シェルが無いのにテストを走らせようとして、テスト実行用のファイルを書き直し続けたからです。
新規ファイルの課題 a1 では書き込みが43回あり、うち40回が同じテスト実行用のファイルでした。3.3〜4.0分で文脈が 32,768 トークンを超え、サーバーが 400 エラーを返して止まります。
Qwen Code と 35B: 外したシェルの代わりを探す
Qwen Code はシェルを外しても、サブエージェント・スキル・ツール検索を使ってテストを回そうとしました。月の加算 (a2)・3ファイルの変更 (a4)・テストを書く (a5) の3件は、Qwen Code 自身の「同じツール呼び出しの連続」の検出で強制終了しています。
コードにも問題が残りました。在庫の課題 (a3) は条件式の中に del を書いた、Python として読めないコードで終わっています。a4 は通貨記号が落ち、a5 は仕様とずれたテストを書いて正しい実装で2件落ちました。合格した a1 も 601秒かかりました。
claw-code と 9B: 速いが読み落とす
9B は速く、a1 と a4 は40秒前後で自分で終えて合格しました。
落ちた3件のうち2件は仕様の読み落としです。a2 は月末の繰り下げを直したのに閏年 (2028年1月31日 → 2月29日) を落とし、a3 は登録の無い品目に docstring にある KeyError の代わりに在庫不足の例外を出しました。残る a5 は、自分で書いたテストが正しい実装で1件落ちたものです (わざと壊した版7個はすべて検出していました)。
Claude Code: 4回で終わる
Claude Code は編集のみでも5件すべて合格しました。所要時間は12〜41秒、ツール呼び出しは中央値4回で、ローカルのエージェントより1桁少ない課題もあります。a4 と a5 では確認のためにサブエージェントを起動しています (シェル禁止はサブエージェントにも効きます)。pytest を許すと、テストを回して通ったのを見てから終えました。
依頼を任せるには、何が足りないのか
claw-code と 35B に足りなかったのは「もう確かめなくていい」と決める判断でした。シェルを渡してテストを回せるようにすれば終われる可能性はありますが、私は安全のためシェルを外した条件でしか測っていないので、シェルを渡したローカルのエージェントは別の検証になります。
今の結論は1つです。ローカルLLM を Claude Code の代わりに据えるより、Claude Code が決めた手順のうち材料の揃ったものを切り出して渡すほうが回ります。どの手順を切り出せるかは ローカルLLMで足りる手順 9Bで要約10/10 に、ローカルが遅くて試す気になれないときの設定は ローカルLLMが遅いとき 設定で8→55tok/s にあります。
 関連書籍 ローカルLLMで足りる仕事、Claude Codeに任せる仕事 依頼の96%はローカルに回せなかった。1ステップずつに下ろすと、半分が回せた 書籍ページを見る →
この記事は役に立ちましたか?