ローカルLLMで外れる手順 難しいコード1/3
同じ入力・同じ採点で、ローカルLLM と Claude の差がはっきり出たのは難しいコード修正でした。3問のうち、9B は0問、35B は1問、Claude は3問で非公開テストを通しています。材料 (ファイル一式とバグ報告) は全員に同じだけ渡しているので、差を生んだのは問題の難しさです。易しい・中くらいの7問なら 35B は全部通しているので、「コードはローカルでは無理」とまでは言えません。
もう1つ、別の理由でローカルに移さないものがあります。
次に何をするかを決める応答です。私の Claude Code の料金の約76%は、シェルの実行・ファイルの編集・読み取り・最終回答の応答に付いていました。品質は採点していません。ただ、これを移すには会話の全文ごと移すことになり、手順を切り出して渡すという話から外れてしまいます。
コード修正10問
ファイル数個の小さな Python プロジェクトのバグ修正を、易3・中4・難3の10問用意しました。ファイル一式とバグ報告を渡して直したファイルを返させ、モデルには見せていない pytest で採点しています。
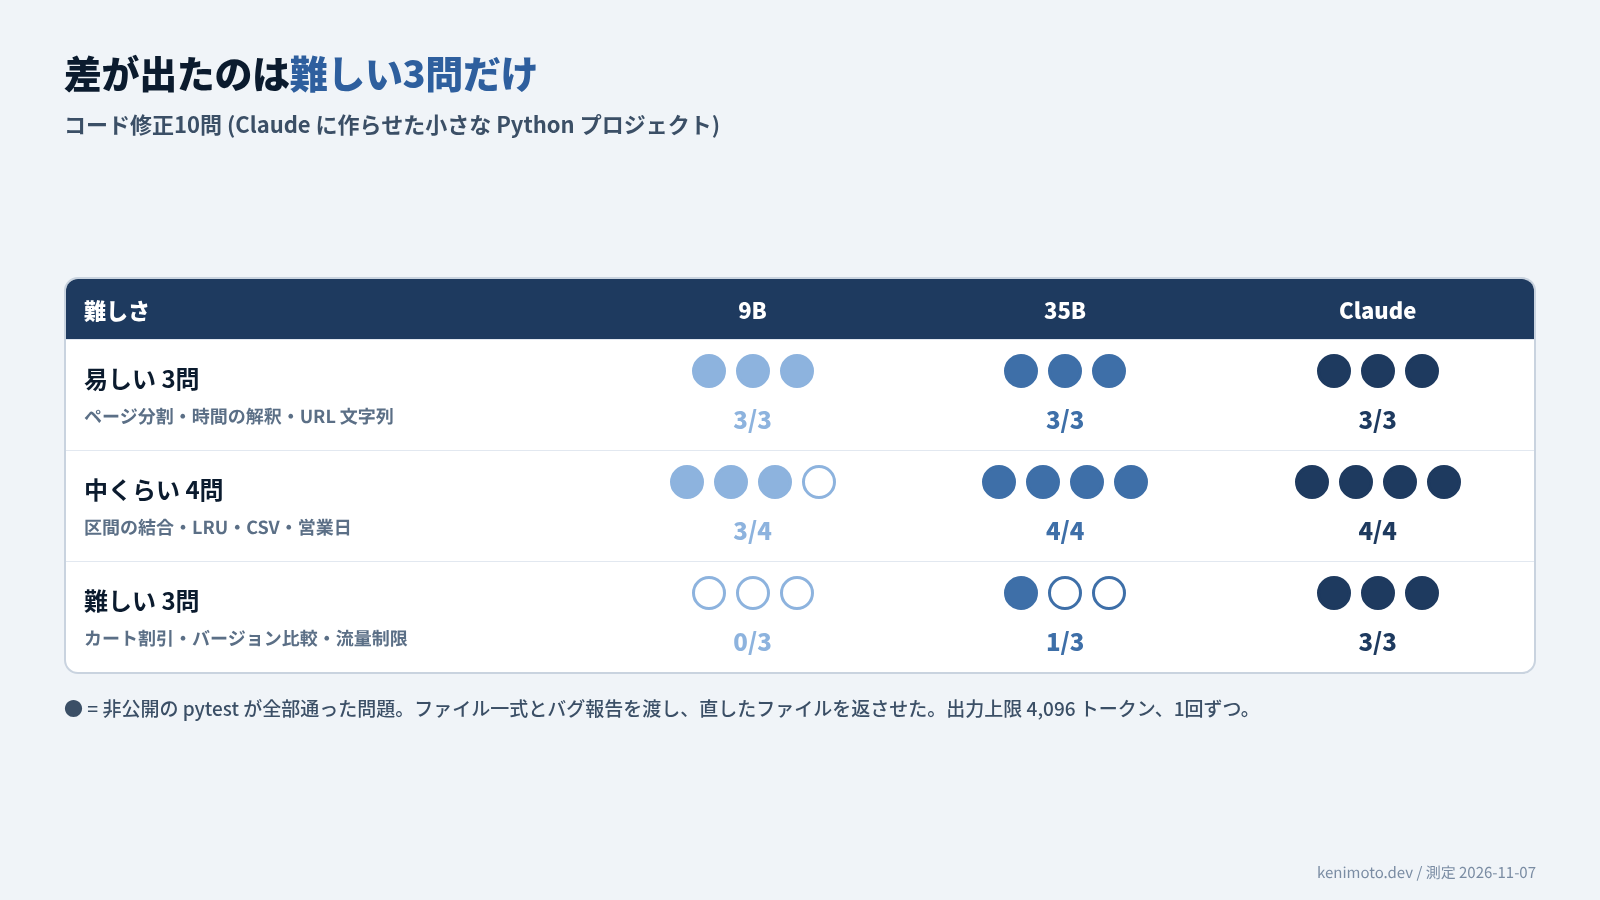
易しい3問はページ分割・時間の文字列の解釈・URL 用の文字列化で、3つとも全部通しました。中くらいでは 9B が区間の結合を1問落としただけです。難しい3問はショッピングカートの割引計算、バージョン番号の比較、流量制限で、35B が通せたのはバージョン番号の比較1問でした。
落ち方は2通りありました。
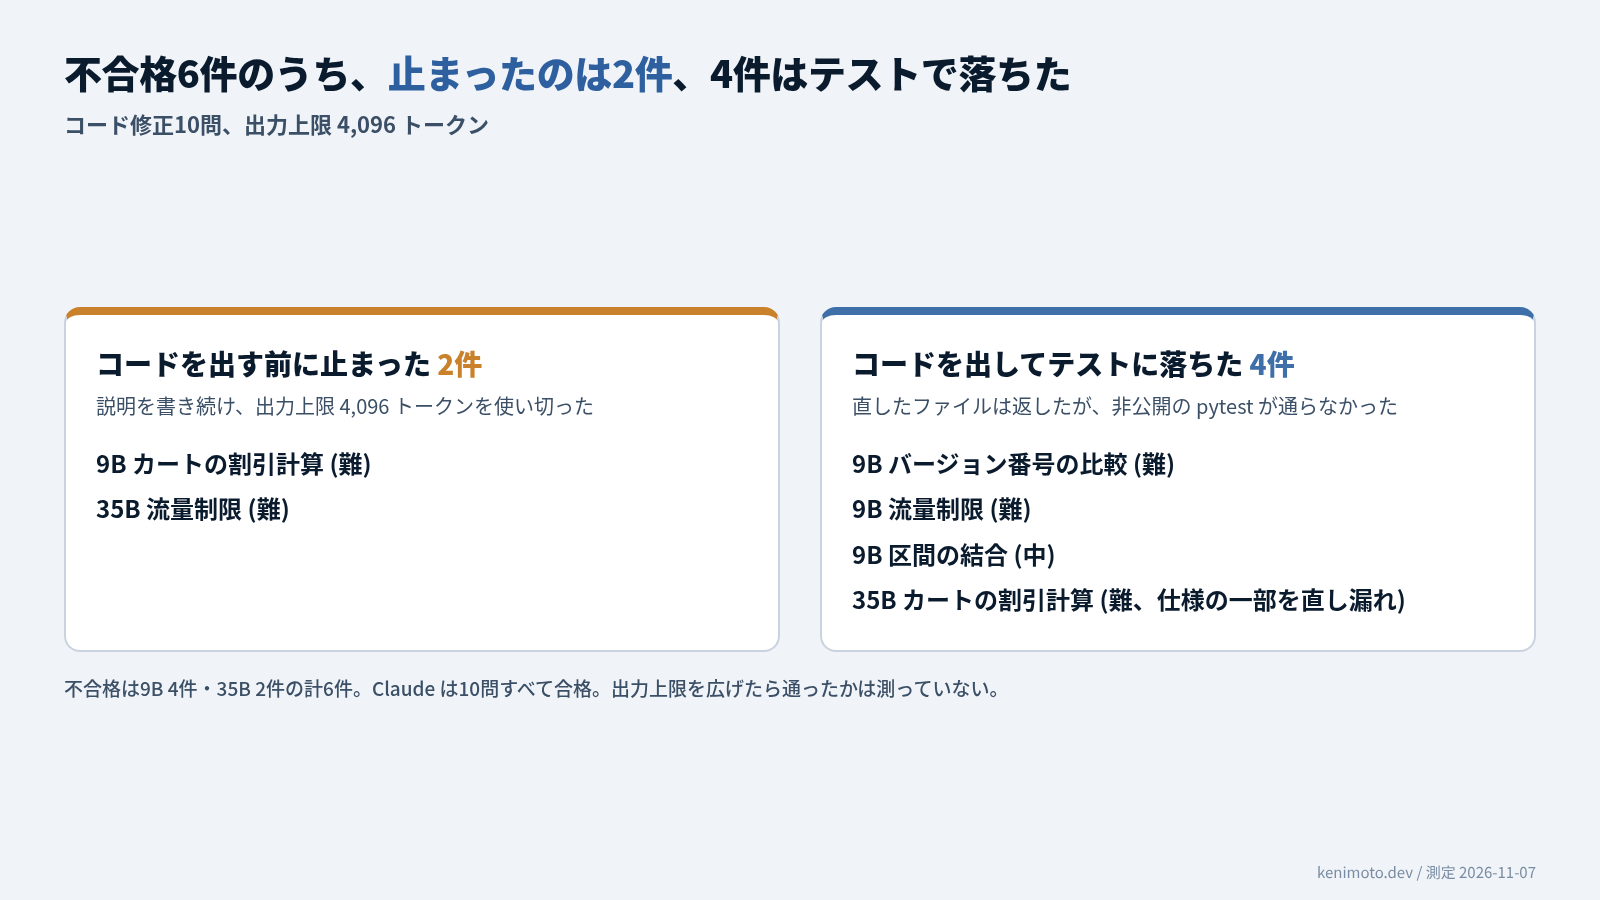
不合格の6件のうち、出力の上限 4,096 トークンを使い切ってコードを出さずに止まったのは2件です。9B はカートの問題で説明を書き続け、35B は流量制限の問題で説明が長くなりました。残る4件 (9B のバージョン比較・流量制限・区間の結合、35B のカート) はコードを出したうえでテストに落ちていて、35B のカートは仕様の一部を直し漏らしたものです。上限を広げれば通った問題があるかは、測っていません。
料金の4分の3は判断の応答に付いている
コード修正の手順は、材料を渡せば単体で解かせられます。Claude Code の実際の仕事では、その前後に「どのファイルを読むか」「テストを回すか」「次はどこを直すか」を決める応答が挟まります。小さな課題5件を Claude Code に任せた測定では、ツール呼び出しは1件あたり中央値4〜5回でした (ローカルLLMの自走 claw+35Bは終了0/5)。
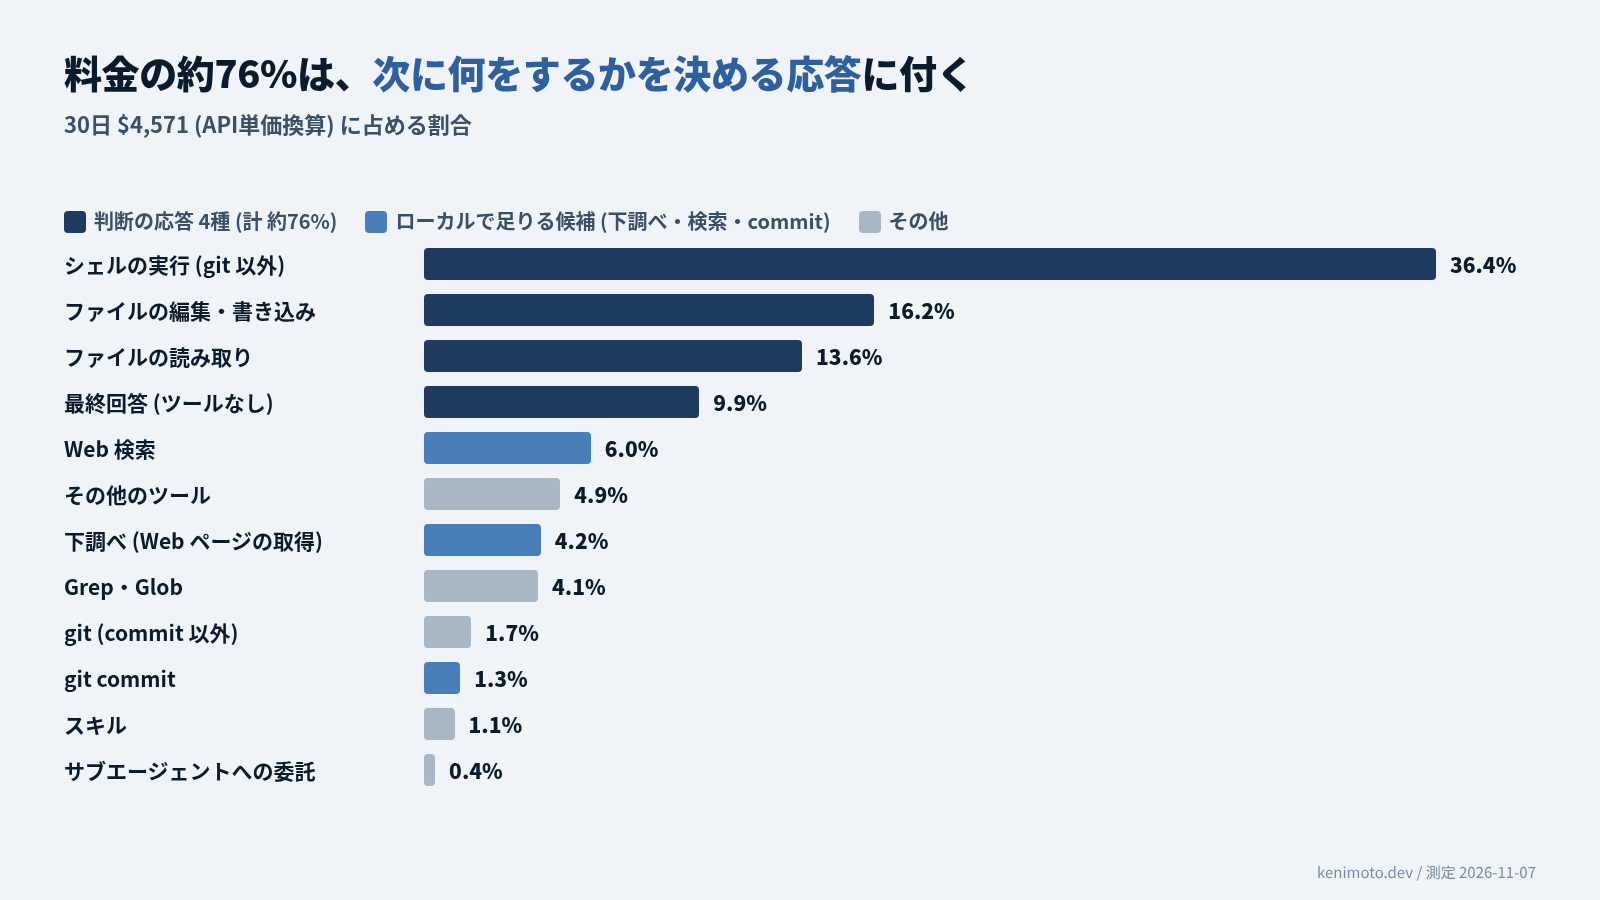
30日分の料金を、応答が呼んだツールの種類で分けると、シェル 36.4%・編集 16.2%・読み取り 13.6%・最終回答 9.9% で、この4つが約76%を占めます。ローカルで足りる種類の手順 (下調べ 4.2%、commit 1.3%) は小さな枝にすぎません。
判断の応答に料金が集まるのは、回数が多いからです。1回あたりの料金は種類であまり変わりません。判断の質そのものは採点していません。手がかりは判断を含む委託の手順 (サブエージェントに調べ物を任せる) で、ローカルLLMへ依頼ごとは0/100 手順で分ける では60件中1件しか「ローカルで足りる」のラベルが付きませんでした。
線は2本引かれる
ローカルで足りた手順と外れたものを並べると、線は2本あります。1本は難しさで、材料を全部渡しても、難しいコード修正では 9B と 35B が落ちました。もう1本は次に何をするかを決める応答で、こちらは材料を自分で集め、会話の全文を踏まえて決めるので、手順として切り出せません。
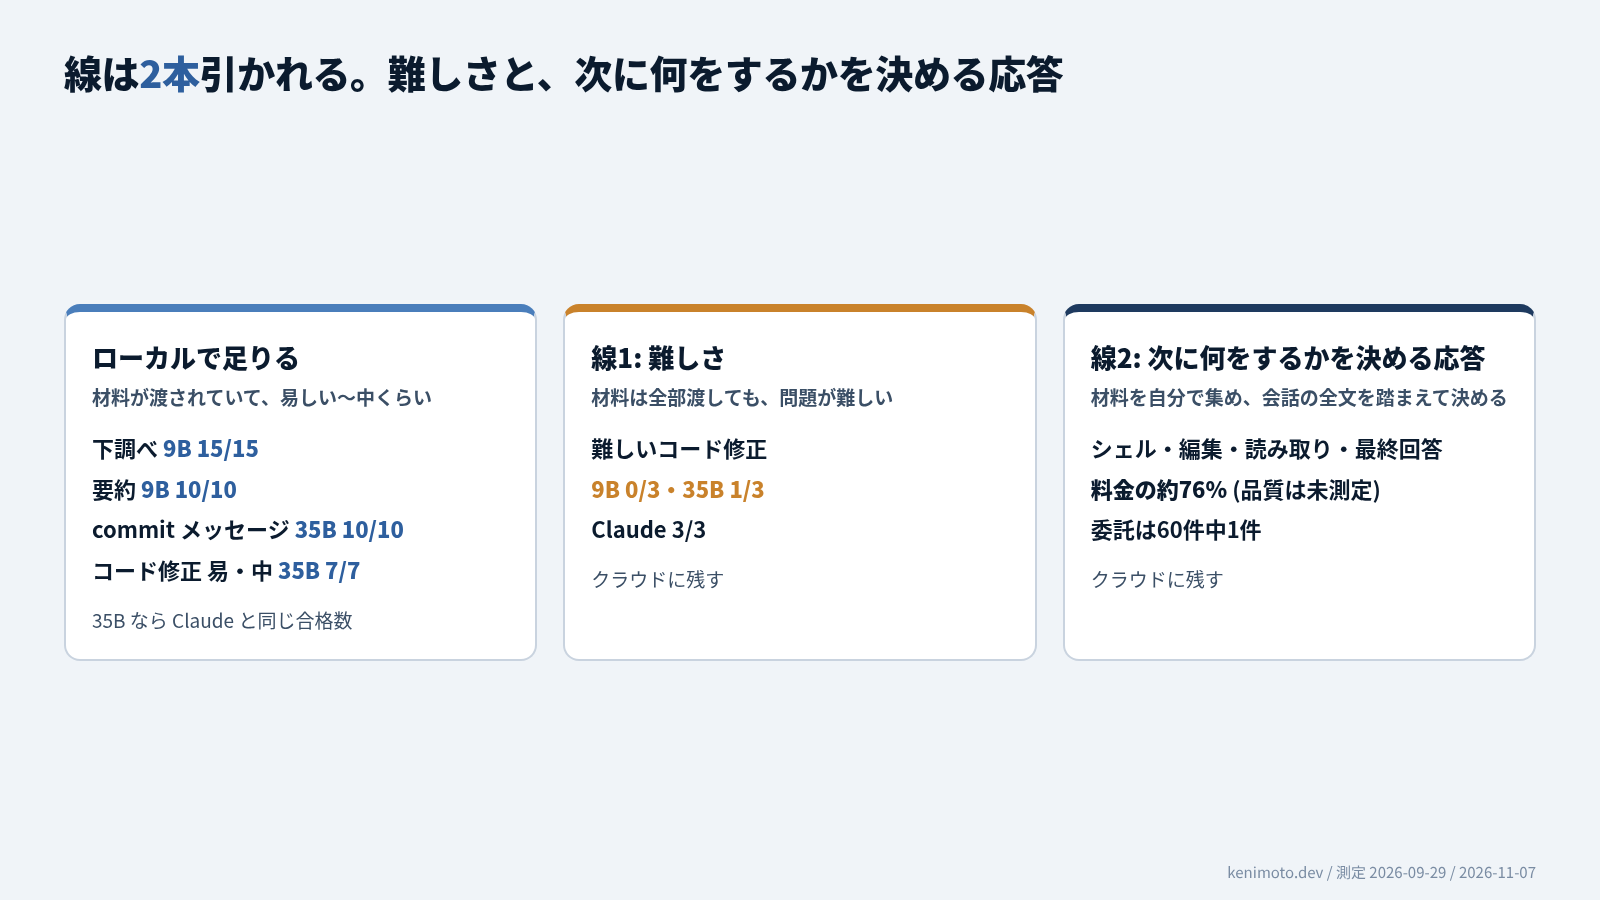
| 対象 | 9B | 35B | Claude | 置き場所 |
|---|---|---|---|---|
| コード修正 (易・中) | 6/7 | 7/7 | 7/7 | 35B ならローカルで足りる |
| コード修正 (難) | 0/3 | 1/3 | 3/3 | クラウドに残す (線1: 難しさ) |
| 次に何をするかを決める応答 | 未測定 | 未測定 | ― | クラウドに残す (線2: 料金の約76%) |
| 委託 | ― | ― | ― | クラウドに残す (60件中1件) |
判断ごとローカルに任せたらどうなるか、つまりローカルのモデルをエージェントとして自走させた結果は ローカルLLMの自走 claw+35Bは終了0/5 にあります。
 関連書籍 ローカルLLMで足りる仕事、Claude Codeに任せる仕事 依頼の96%はローカルに回せなかった。1ステップずつに下ろすと、半分が回せた 書籍ページを見る →
この記事は役に立ちましたか?