ローカルLLMが遅いとき 設定で8→55tok/s
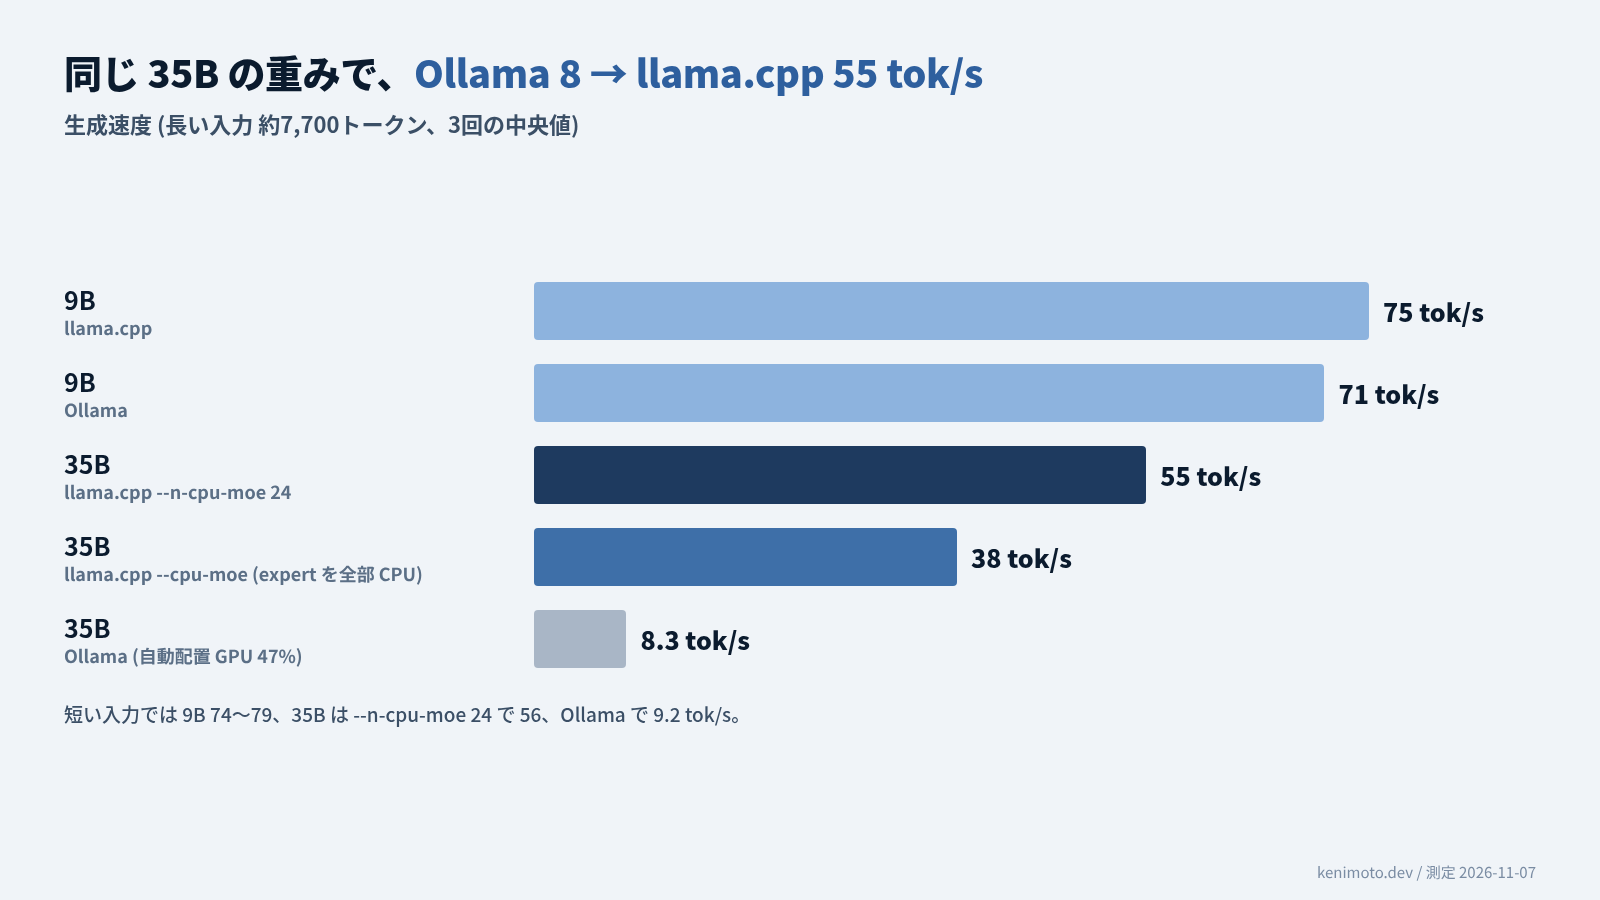
ローカルLLM が遅くて試す気になれないなら、先にモデルの大きさとエンジンを見直します。RTX 4070 12GB で 35B (Qwen3.6-35B-A3B) を Ollama に任せると生成は 8〜9 tok/s でしたが、同じ重みを llama.cpp で動かし、--n-cpu-moe 24 で expert (下で説明します) の置き場所を指定すると 55〜56 tok/s になりました。約6倍です。
9B (Qwen3.5-9B) なら VRAM に全部載るので、Ollama でも llama.cpp でも 71〜79 tok/s 出ます。
ローカルLLMで足りる手順 9Bで要約10/10 で見たとおり、下調べと要約は 9B と 35B で合格数が同じでした。そういう手順は 9B に回すのが一番速く、35B の設定を詰めるのは commit メッセージやコード修正を任せたいときです。
大きさ: 9B は載り、35B は載らない
9B は載ります。GGUF (Q4_K_M) のファイルで約5.7GB です。VRAM の増加分は llama.cpp で 6,249 MiB、Ollama で 8,999 MiB でした (Ollama の 9B は画像を読む部分を含み、確保の仕方も違います)。
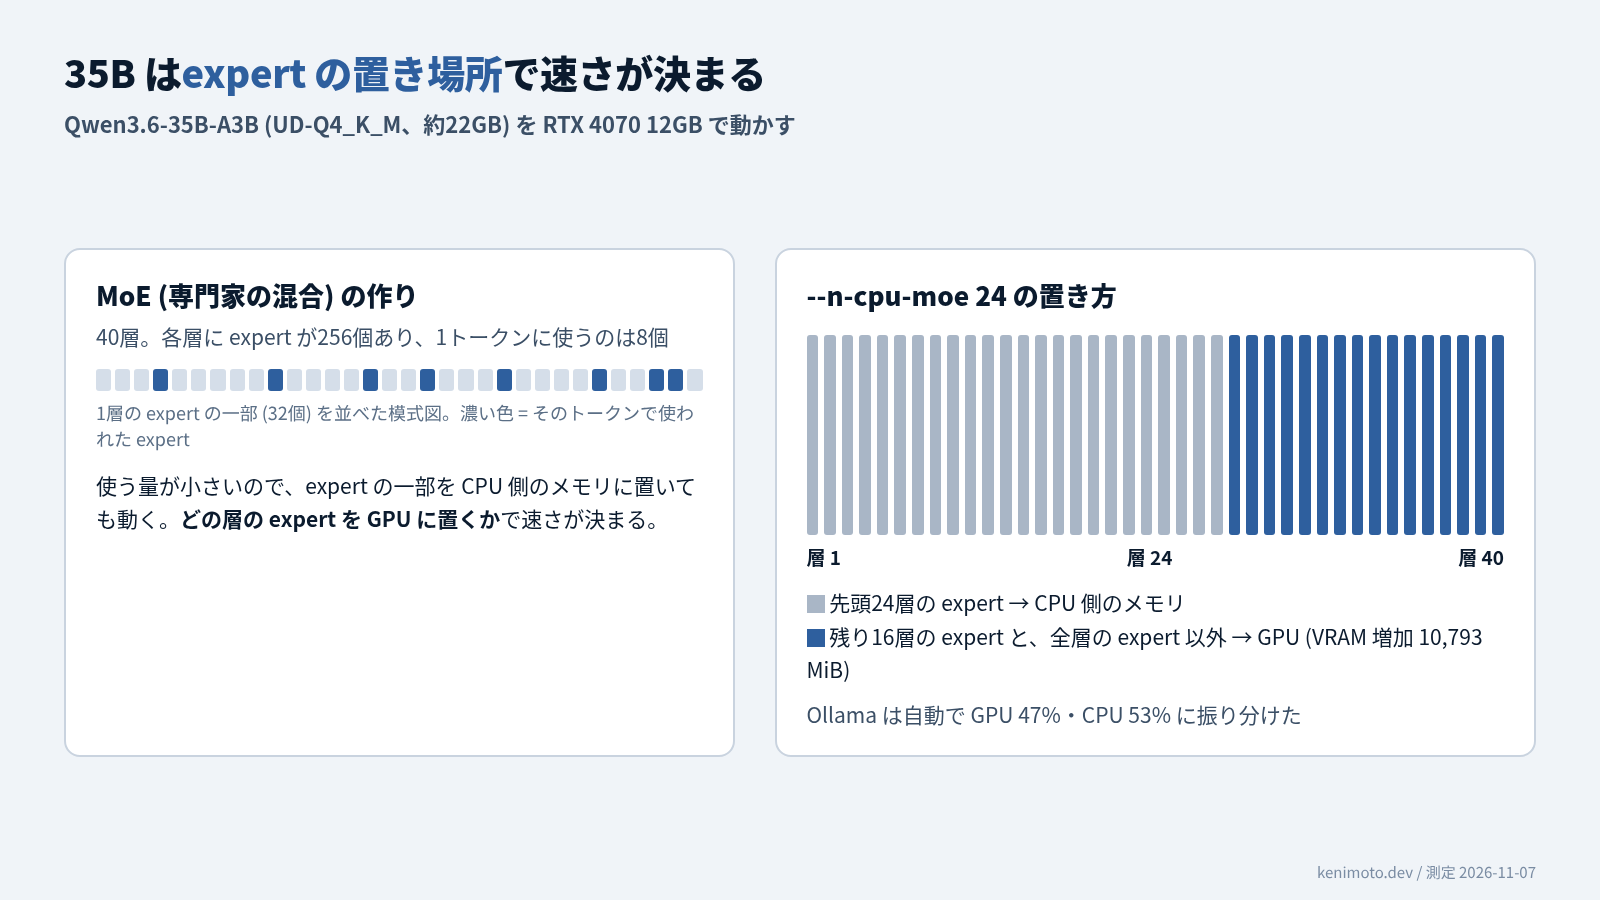
35B (UD-Q4_K_M) はファイルで約22GB あり、VRAM に入りきりません。
ただしこのモデルは MoE (専門家の混合) という作りで、各層に256個ある小さな部分ネットワーク (expert) のうち、1トークンを作るのに8個しか使いません。名前の A3B は、1トークンあたりに動かすのが全体の約3B ぶんだけ、という意味です。使う量が小さいので、expert の一部を CPU 側のメモリに置いても動きます。どの層の expert を GPU に置き、どれを CPU に置くかで速さが決まります。
エンジン: 同じ重みで6倍
同じ 35B の GGUF を、Ollama に取り込んだものと llama.cpp で比べました。
| エンジン | モデル / 設定 | 生成 tok/s (短/長) | 入力処理 tok/s (長) | VRAM (増加分) |
|---|---|---|---|---|
| Ollama | 9B | 74 / 71 | 2,911 | 8,999 MiB |
| llama.cpp | 9B | 79 / 75 | 3,807 | 6,249 MiB |
| Ollama | 35B (自動配置 GPU 47%) | 9.2 / 8.3 | 490 | 11,428 MiB |
| llama.cpp | 35B --cpu-moe | 38 / 38 | 427 | 3,301 MiB |
| llama.cpp | 35B --n-cpu-moe 24 | 56 / 55 | 654 | 10,793 MiB |
Ollama は VRAM をほぼ使い切っているのに、8〜9 tok/s しか出ていません。どの部分を GPU に置くかを Ollama が自動で決め、その配置が MoE に向いていなかった、というのが私の読みです (配置の中身までは切り分けていません)。llama.cpp で expert を全部 CPU に置く --cpu-moe ですら 38 tok/s 出ます。
設定: —n-cpu-moe を下げて、溢れる手前で止める
--n-cpu-moe N は「先頭から N 層ぶんの expert を CPU に置く」指定です。N を下げるほど GPU に載る expert が増えます。
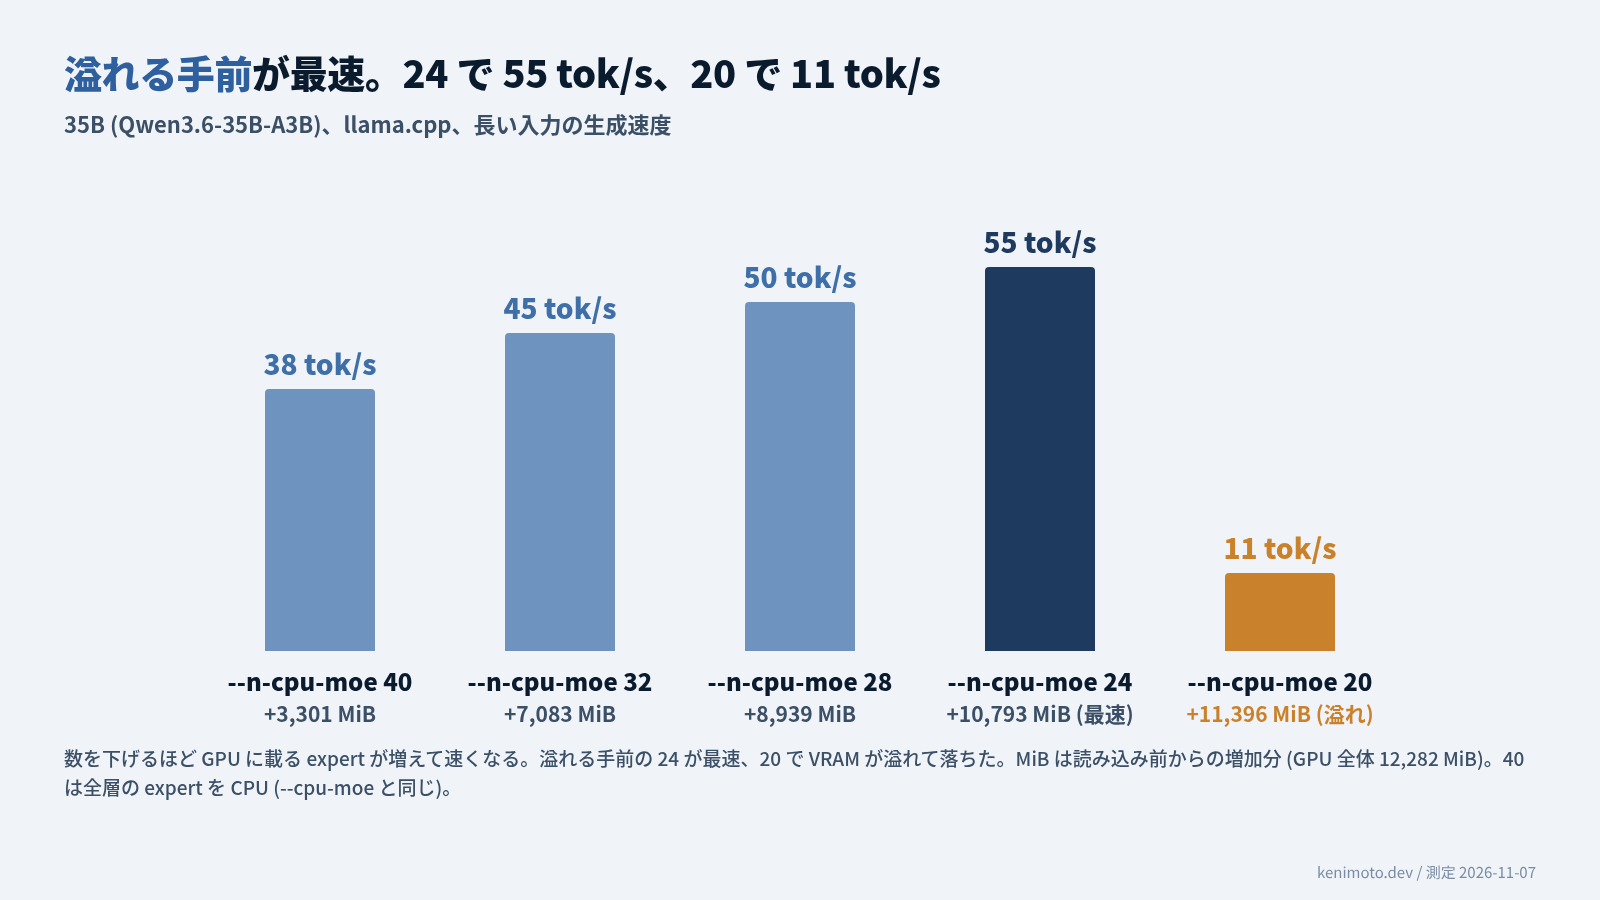
24 までは下げるほど速くなり、20 で VRAM が溢れて 11〜20 tok/s に落ちました。
境目は VRAM の空きとコンテキスト長で動きます。私が測ったのは 40・32・28・24・20 の5点なので、自分の環境でも数段に分けて下げ、速度が落ちたら1段戻すのが手堅いはずです。このモデルは40層なので、40 を指定すると --cpu-moe と同じ配置になります。
llama.cpp のフラグを1つずつ詰めて 35B を速くする過程は、本 RTX 4070でQwen 35Bを2.8倍速くする にまとめています。本の数字は別の時期・別の版で測ったもので、この章の値とは一致しません。
入力処理: 長い材料は 9B が速い
入力処理は事情が違います。生成速度だけ見ると 35B でも 55 tok/s 出ますが、材料を読み込む入力処理は 9B よりずっと遅く、長い入力で 35B が 654 tok/s、9B が Ollama で 2,911 tok/s (約4.5倍、llama.cpp なら 3,807 tok/s) でした。5〜8千トークンの Web ページを読ませる下調べで 35B が1件 8.3秒、9B (Ollama) が 2.1秒かかったのはこのためです。
電力: GPU 単体なら 1,000トークンで約1Wh
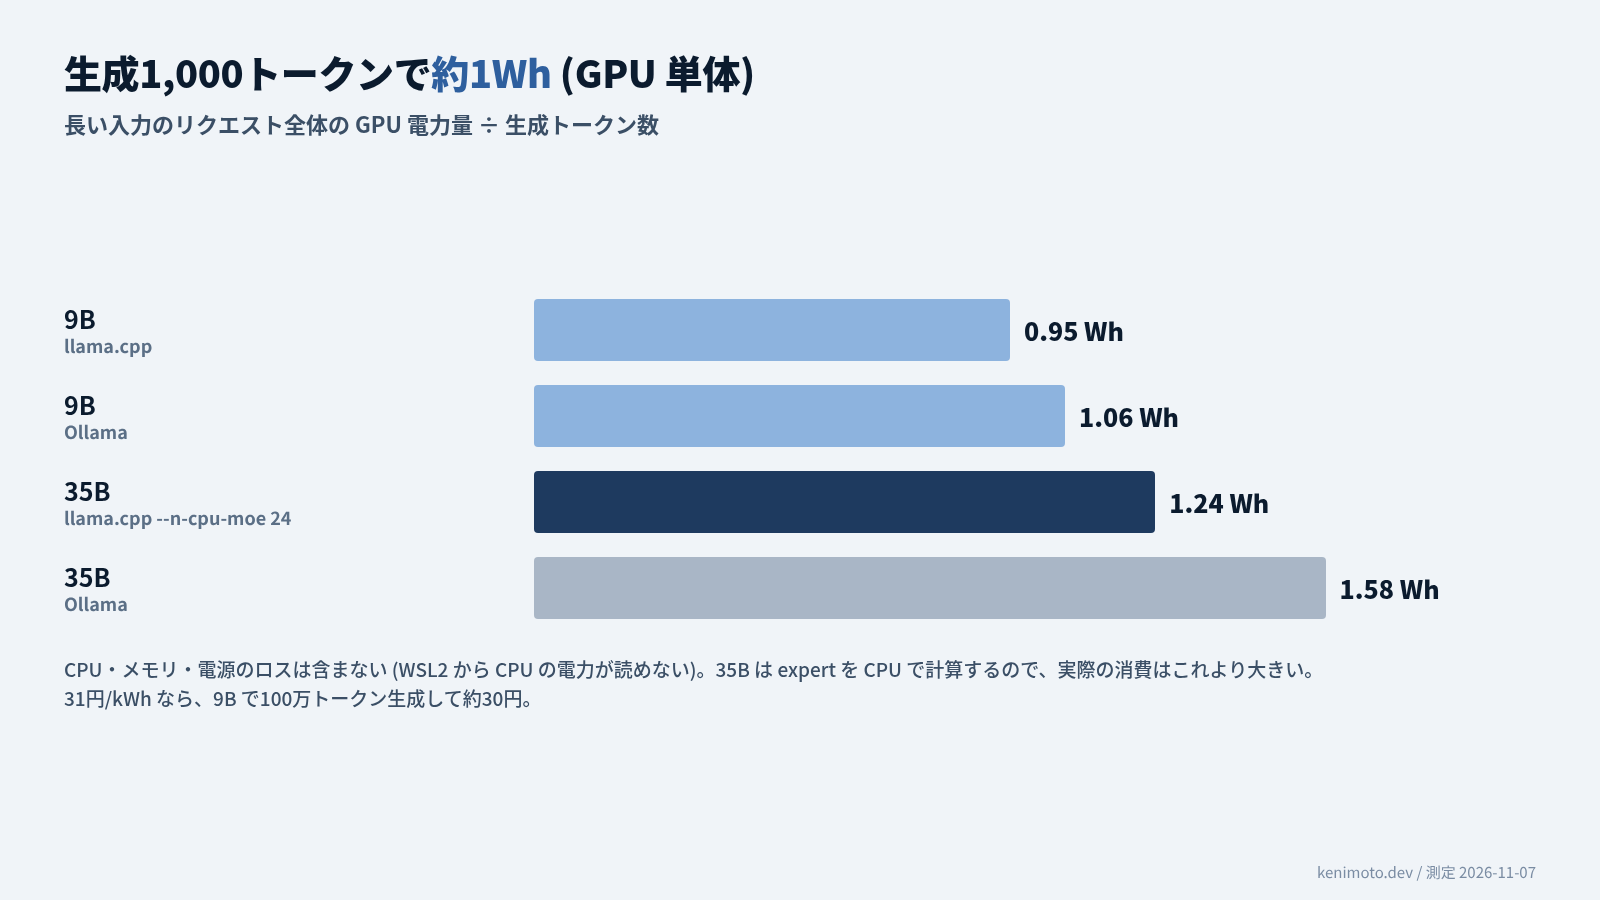
GPU 単体の値で、長い入力のとき生成1,000トークンあたり 9B が 0.95〜1.06 Wh、35B (--n-cpu-moe 24) が 1.24 Wh でした。31円/kWh なら、9B で100万トークン生成して約30円です。
35B は違います。expert の一部を CPU で計算するので、CPU を含めた実際の消費はこれより大きく、その分は測れていません。
電気代を Claude Code の料金と並べて、移すと得かを計算したのが Claude Code料金 ローカルで減るか実測 です。
 関連書籍 ローカルLLMで足りる仕事、Claude Codeに任せる仕事 依頼の96%はローカルに回せなかった。1ステップずつに下ろすと、半分が回せた 書籍ページを見る →
この記事は役に立ちましたか?