ハイブリッド検索 RAGの外れを3分の1に
Advanced RAG は、素朴な RAG の「上位k件を取って貼る」の前と後ろに手を足したものです。検索の前に質問を書き換え、検索を BM25 と埋め込みの二本立てにして混ぜ、検索の後に別のモデルで候補の順位をつけ直します (再順位づけ)。素朴な RAG の困りごとは、正解が上位k件に入らないことと、入っても中ほどに置かれると読まれないことでした。前者には二本立てと書き換え、後者には再順位づけが効きます。
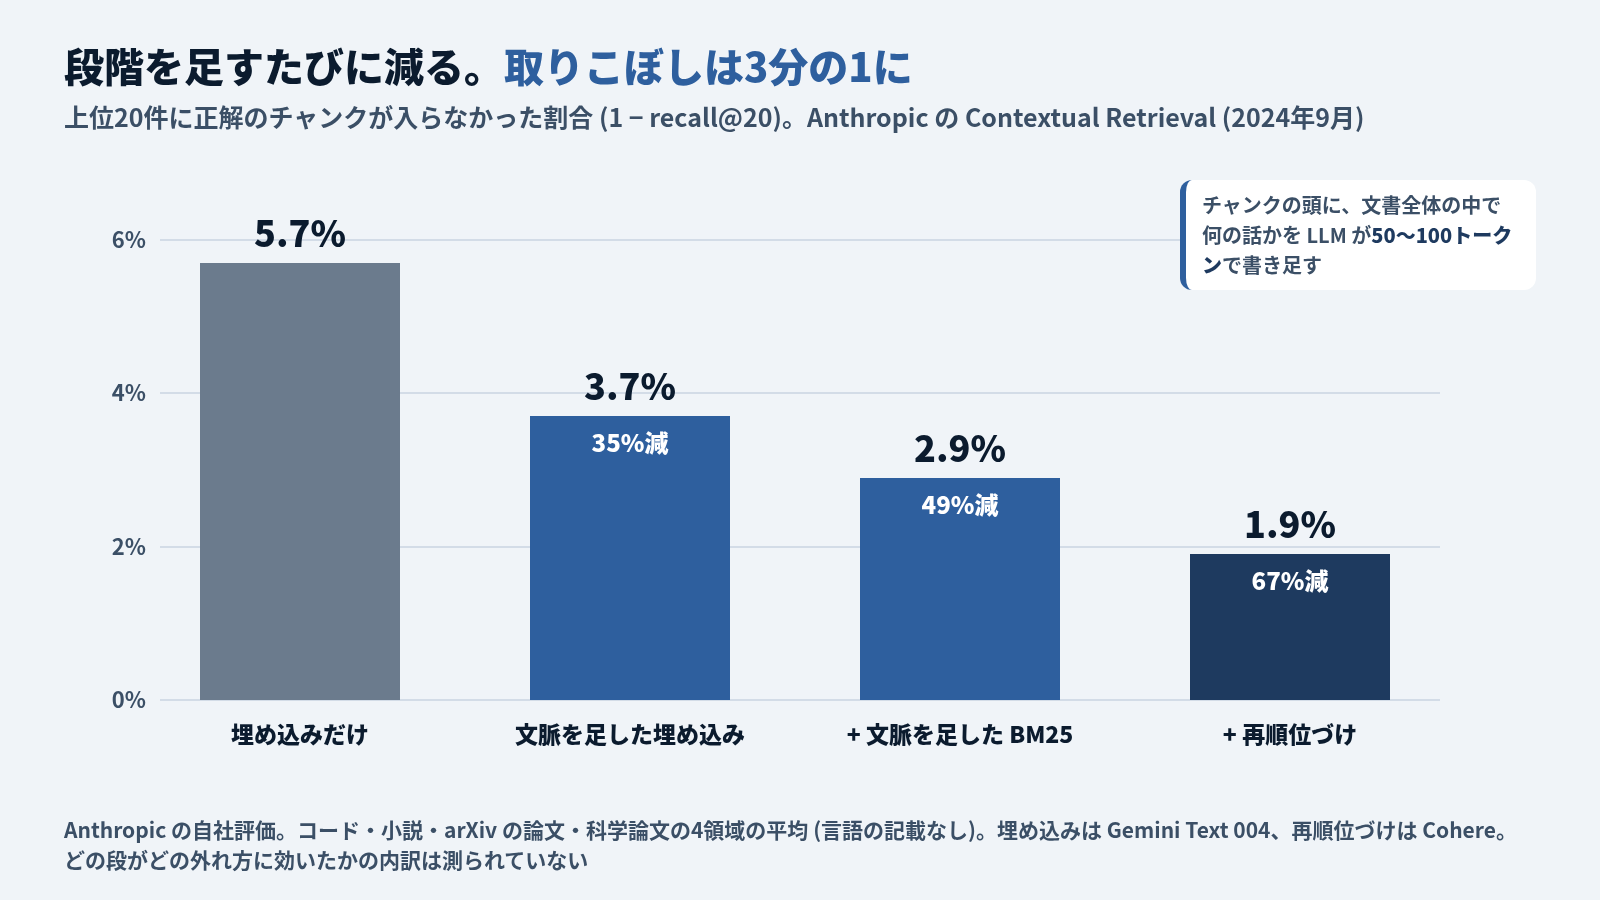
効き目の大きさは、Anthropic が2024年9月に自社の評価で段階ごとに出しています。コード・小説・arXiv の論文・科学論文の4つの領域の平均で、上位20件に正解が入らなかった割合 (1 − recall@20) が、埋め込みだけの5.7%から、文脈を足した埋め込みで3.7%、BM25 を併用して2.9%、再順位づけまで足して1.9%。
3分の1です。
ただしどの手をどの順で回すかはまだ人が決めた手順なので、簡単な質問にも難しい質問にも毎回同じ書き換えと同じ再順位づけがかかります。この「毎回同じ」を崩すのが、次の段階の自分で判断する RAG です。
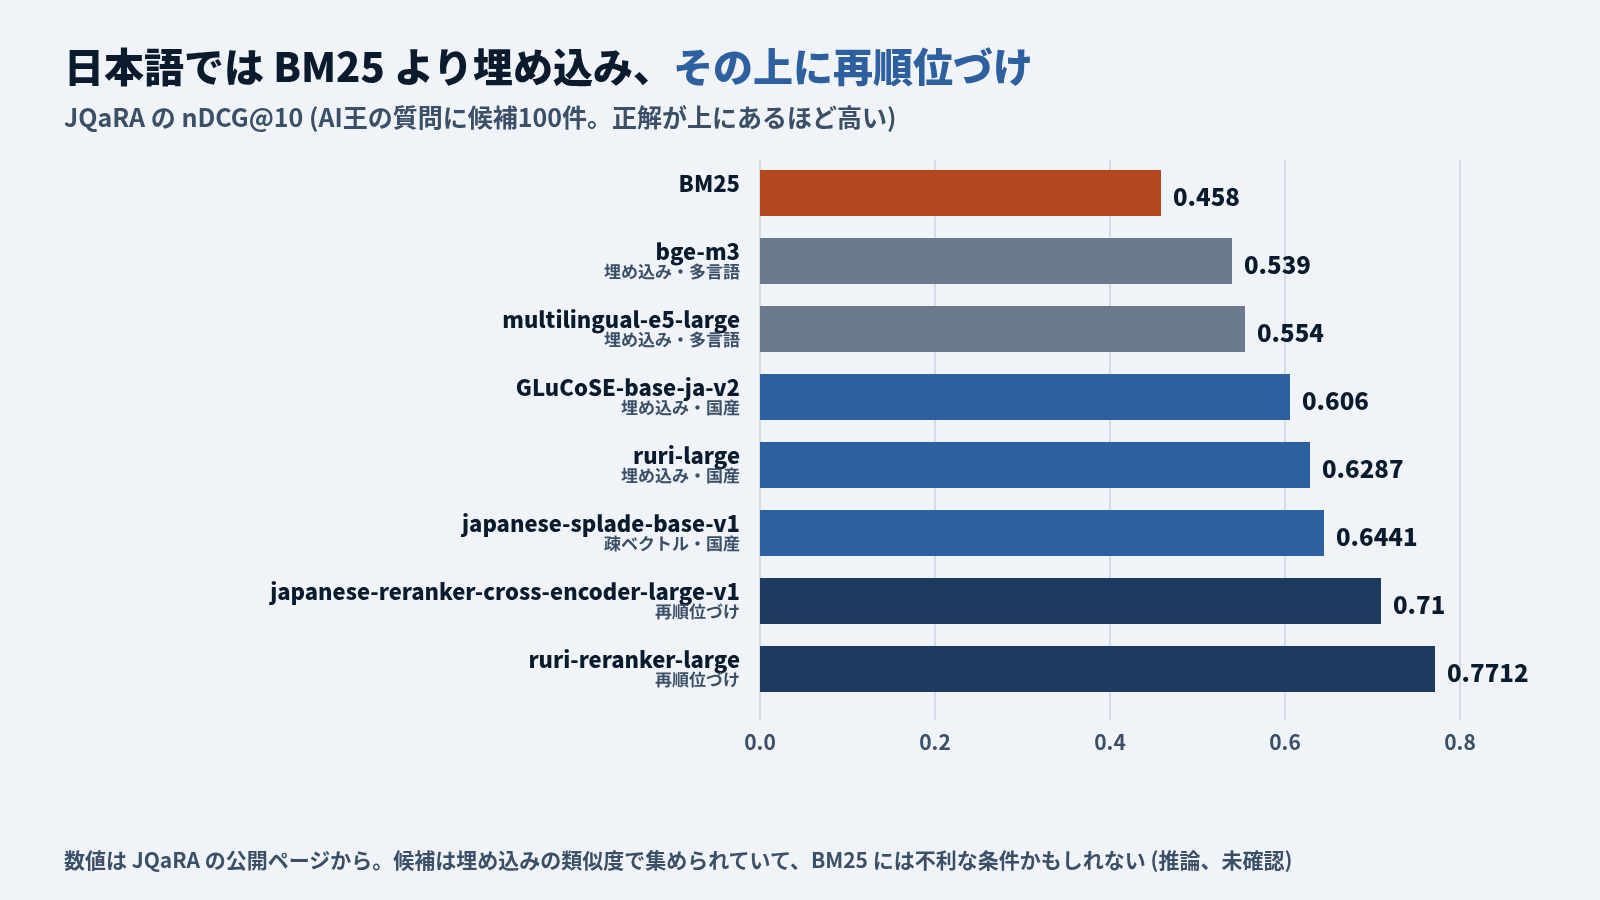
日本語ではもう1つ事情が加わります。BM25 が単語の区切り方に左右され、再順位づけのモデルは国産のものが強い。JQaRA という日本語の評価では、BM25 の0.458に対して日本語の再順位づけのモデルが0.7712でした。
困りごと: 上位k件では外れる、中ほどが読まれない
素朴な RAG の外れ方のうち Advanced RAG が狙ったのは2つです。
1つ目は正解が上位k件に入らないこと。
私は rag-retriever-bench で、MIRACL の日本語版10万段落に OpenAI の text-embedding-3-small を使って測りました。全段落と比べる全件走査でも、上位10件の再現率は0.952でした。正解の約5%は、ベクトルデータベースをどう選んでも上位10件に入りません。埋め込み1本の限界です。型番の一致や否定のように埋め込みが苦手な質問ではもっと落ちるはずですが、これは私の推論で、質問の種類ごとには測っていません。
2つ目は入っても読まれないこと。Lost in the Middle の実験では、答えの書いてある文書を20件中10番目に置くと GPT-3.5-Turbo の正解率は53.8%で、文書を渡さないとき (56.1%) より下がりました (詳しくはベクトルデータベース7種を実測 素朴なRAG)。
上位k件の k を増やせば1つ目は減りますが、2つ目が悪化します。
だから k を増やさずに正解を上位に入れ、しかも上に置く工夫が要りました。
Gao らの3分類: Naive・Advanced・Modular
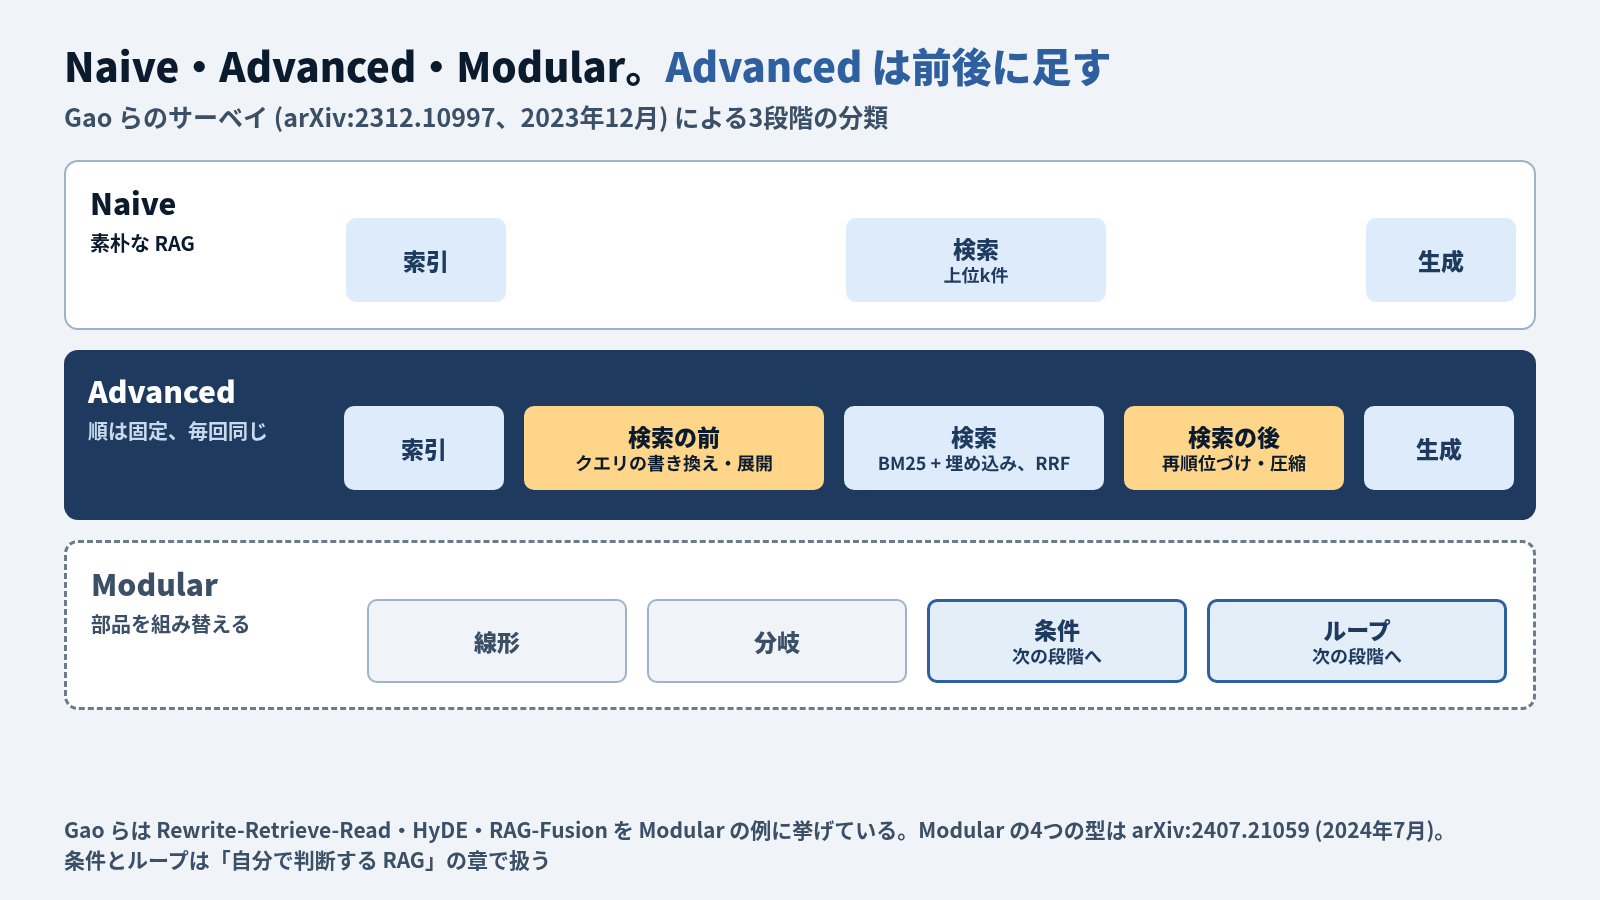
名前の出どころは2023年12月の Gao らのサーベイ論文です (arXiv:2312.10997)。RAG の研究を3段階に分類しました。
- Naive RAG: 索引・検索・生成の3工程だけ。このシリーズの「素朴な RAG」です
- Advanced RAG: 検索の前 (pre-retrieval) と後 (post-retrieval) に処理を足す。前はクエリの書き換えや展開、後は再順位づけや文脈の圧縮
- Modular RAG: 部品をモジュールとして組み替える。検索を繰り返す、条件で分岐する、といった流れも含む
Modular RAG の側は、2024年7月の別の論文が、部品のつなぎ方を線形・条件・分岐・ループの4つの型に整理しています (arXiv:2407.21059)。このうち条件とループは、次の段階の「自分で判断する RAG」につながる話です。この章では、線形のまま前後に手を足す Advanced RAG を扱います。
この章の手3で扱う Rewrite-Retrieve-Read・HyDE・RAG-Fusion は Gao らの論文では Modular RAG の側に例として挙がっていますが、手順を固定したまま検索の前に足せる手なので、この章では Advanced RAG の側でまとめて扱います。
手1: BM25 と埋め込みを両方使う
BM25 は、このシリーズの第1章「原論文 2017〜22年」で出てきた、語の重なりで点数をつける古典的な検索です。DPR はこれに平均で勝ちましたが、語の一致が決め手になる質問では BM25 が強いままです。「型番 KX-1234 の保証期間」と聞かれたら、KX-1234 という文字列を含むチャンクを引くべきで、意味が近いだけの別の型番のチャンクは外れです。逆に「電源が入らない」と聞かれて「起動しない」と書いた文書を引くのは、埋め込みの仕事です。
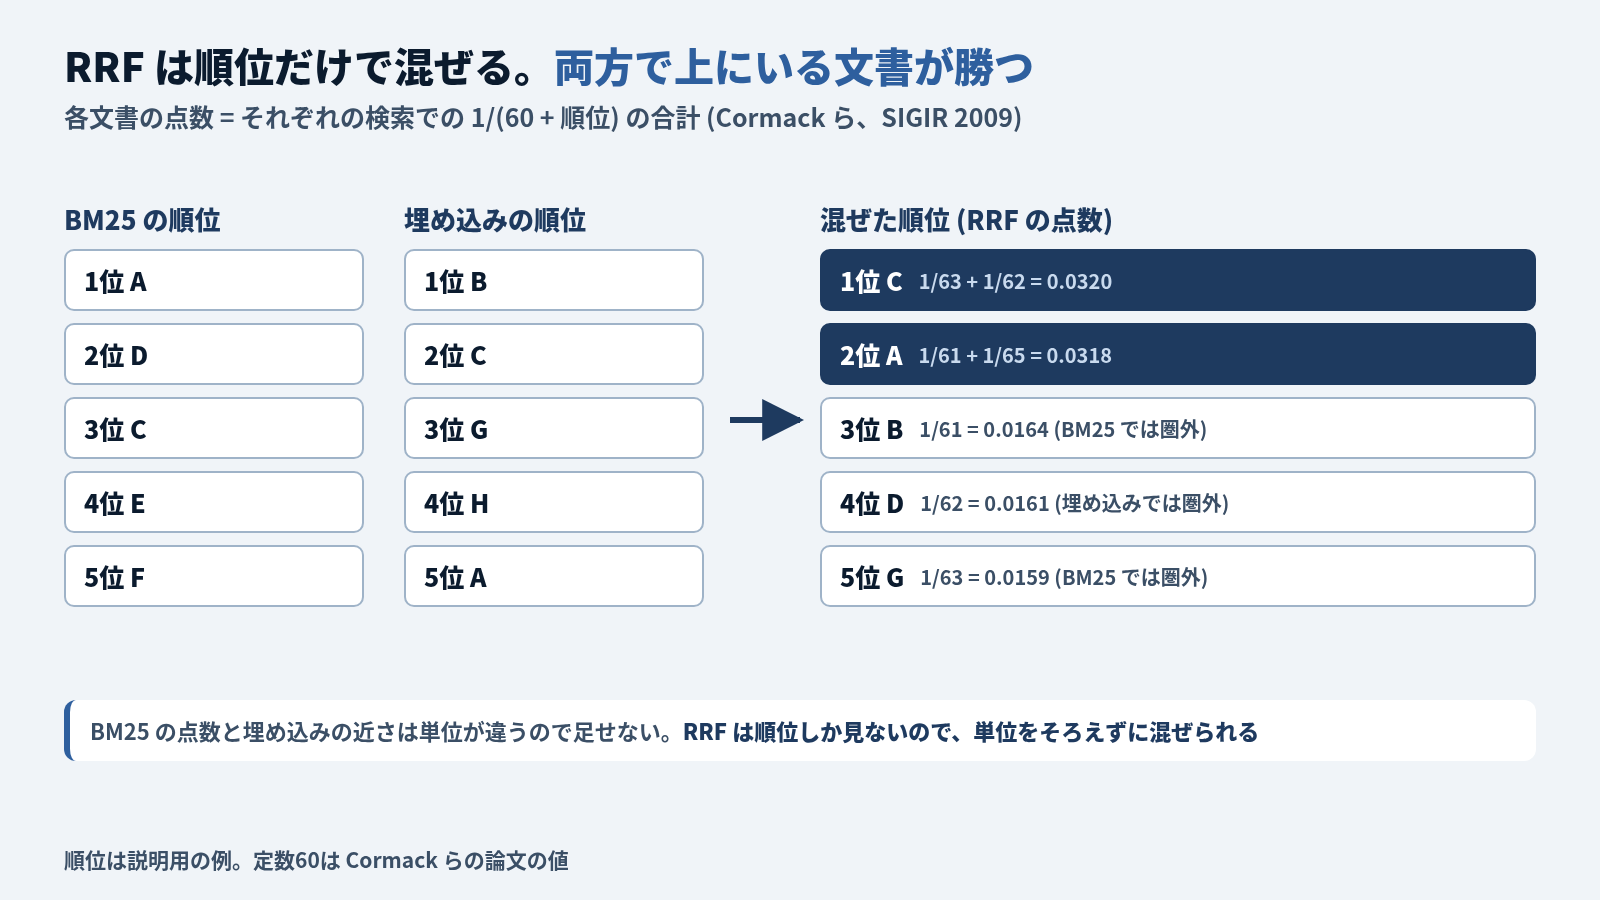
そこで両方で検索し、結果を1本の順位に混ぜます。これをハイブリッド検索と呼びます。混ぜ方の定番が RRF (Reciprocal Rank Fusion、逆順位の足し合わせ) で、2009年の SIGIR で Cormack らが出したものです (PDF)。
各文書の点数は、それぞれの検索での順位 r から 1/(60 + r) を計算して足すだけです。60 は論文が使った定数です。BM25 の点数と埋め込みの近さは単位が違うので、そのまま足せません。RRF は順位しか見ないので、単位をそろえる必要がありません。例で計算します。
| 文書 | BM25 の順位 | 埋め込みの順位 | RRF の点数 | 混ぜた順位 |
|---|---|---|---|---|
| C | 3位 | 2位 | 1/63 + 1/62 = 0.0320 | 1位 |
| A | 1位 | 5位 | 1/61 + 1/65 = 0.0318 | 2位 |
| B | 圏外 | 1位 | 1/61 = 0.0164 | 3位 |
片方で1位でももう片方で圏外の B は3位です。両方の検索がそこそこ上に置いた文書が勝つのが RRF の性格です。
手2: 並べ直す (再順位づけ、rerank)
検索で集めた候補を、別のもっと精密なモデルで点数づけし直して並べ直すことを、このシリーズでは再順位づけ (rerank) と呼びます。
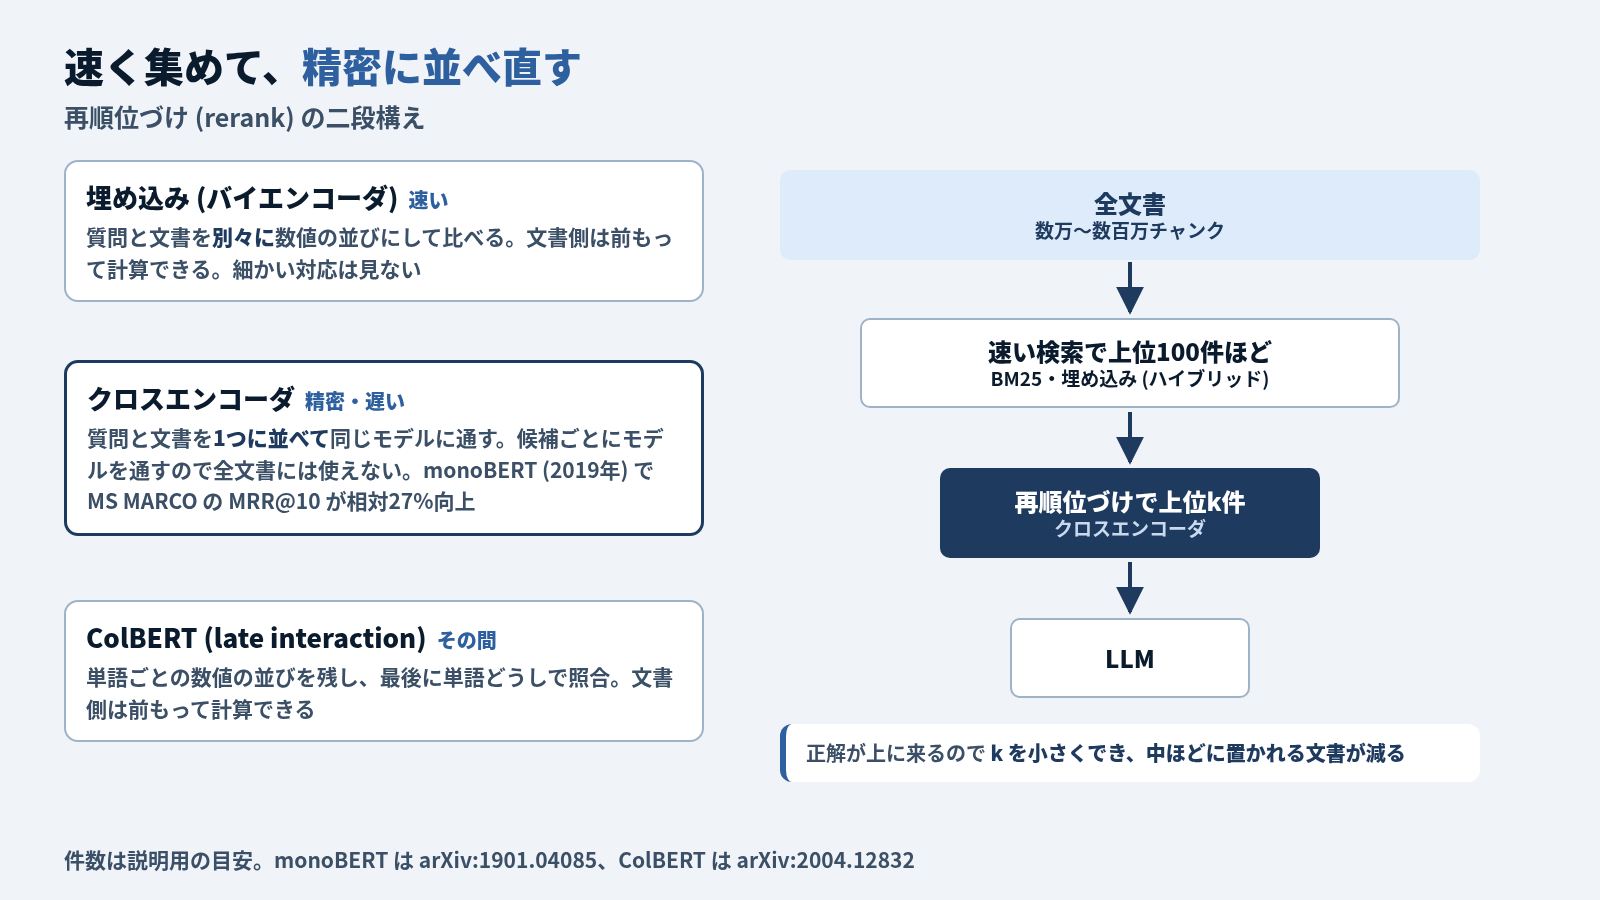
埋め込み検索 (ベクトル検索) は、質問と文書を別々に数値の並びに変えて比べます。文書側は前もって計算しておけるので速いのですが、質問と文書の細かい対応は見ていません。再順位づけのモデルは、質問と文書を1つに並べて同じモデルに通し、関連の強さを直接出します。この形をクロスエンコーダと呼びます。
2019年1月の monoBERT は、BERT をこの形で使って、MS MARCO の段落検索で従来の最高を MRR@10 (正解が何番目に来たかの逆数の平均) で相対27%上回りました (arXiv:1901.04085)。代わりに、質問が来るたびに候補の数だけモデルを通すので遅く、全文書には使えません。
だから二段構えにします。速い検索 (BM25 や埋め込み) で上位100件ほどを集め、その中だけを再順位づけのモデルで並べ直し、上位k件を LLM に渡します。正解が上に来るので、k を小さくでき、Lost in the Middle の中ほども減ります。
中間の形もあります。2020年4月の ColBERT は、質問と文書を別々に処理しつつ単語ごとの数値の並びを残しておき、最後に単語どうしで細かく照合します。遅い相互作用 (late interaction) です (arXiv:2004.12832、SIGIR 2020)。論文は、BERT で並べ直す方式に近い精度のまま、2桁速いと報告しています。
手3: 質問のほうを書き換える
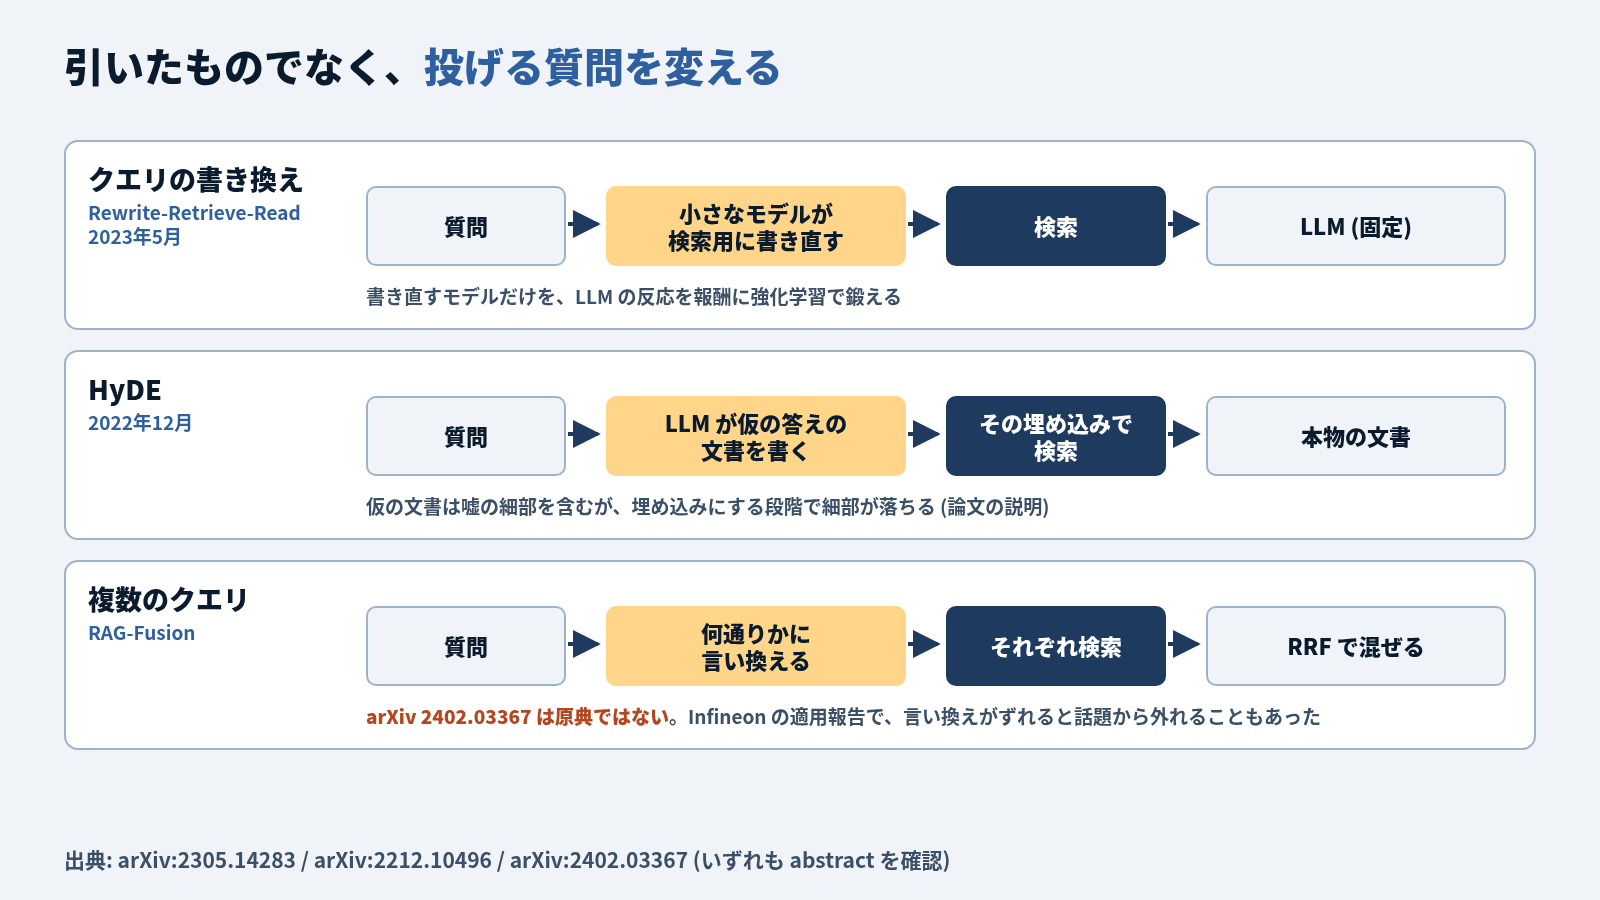
ここまでは引いてきたものの扱い方でした。もう1つの方向は、検索に投げる質問そのものを変えることです。利用者の質問文が、検索に向いたクエリとは限りません。最初の手は、それを書き換えることです。2023年5月の Rewrite-Retrieve-Read は、検索の前に LLM に検索用のクエリを書かせます (arXiv:2305.14283、EMNLP 2023)。さらに、書き換えを担う小さなモデルを、答える側の LLM の反応を報酬にして強化学習で鍛えました。答える LLM 本体は固定したままです。第1章「原論文 2017〜22年」の頃は検索器を学習していましたが、ここでは固定した LLM の手前の、小さな部品だけを学習しているのが面白いところです。
HyDE。 2022年12月の HyDE は、質問から LLM に「答えが書いてありそうな仮の文書」を書かせ、その仮の文書の埋め込みで検索します (arXiv:2212.10496)。質問文と文書は書き方が違うので、文書の書き方をした仮の文書のほうが、本物の文書の近くに落ちやすいという考え方です。仮の文書は嘘の細部を含みます。それでも埋め込みに変える段階で細部が落ち、近くにある本物の文書が引ける、と論文は説明しています。
複数のクエリ (RAG-Fusion)。 質問を LLM に何通りかに言い換えさせ、それぞれで検索し、結果を RRF で混ぜます。手1の RRF を、クエリの数だけ回す形です。arXiv の 2402.03367 はよく引かれますが、これは手法の原典ではありません。 Infineon の社員1人が、エンジニア・営業担当・顧客が製品情報を引く用途に当てた適用報告で、論文自身が「新しく広まった RAG-Fusion を評価した」と書いています。評価は人手で、言い換えたクエリが元の質問からずれると、答えが話題から外れることもあったと報告しています。
Contextual Retrieval: 手を足すごとの効き目
手を重ねるとどれだけ効くのか。2024年9月19日の Anthropic の Contextual Retrieval が、段階ごとの数字を出しています (Anthropic)。
Contextual Retrieval そのものは分割のときの工夫で、チャンクを索引に入れる前に LLM に「このチャンクは文書全体の中で何の話か」を50〜100トークンで書かせ、チャンクの頭に足してから埋め込みと BM25 の索引を作ります。素朴な RAG の外れ方の1つ目、「分割で切れる」への手当てです。物差しは、上位20件に正解のチャンクが入らなかった割合 (1 − 上位20件の再現率) です。文書はコードベース・小説・arXiv の論文・科学論文の4つの領域で、その平均です。埋め込みは Gemini の Text 004、再順位づけは Cohere のモデルでした。
| 段階 | 取りこぼし | 減り方 |
|---|---|---|
| 埋め込みだけ | 5.7% | — |
| 文脈を足した埋め込み | 3.7% | 35%減 |
| + 文脈を足した BM25 | 2.9% | 49%減 |
| + 再順位づけ | 1.9% | 67%減 |
チャンクに文脈を書き足す費用は、文書100万トークンあたり1.02ドルと試算されています (チャンク800トークン、文書8,000トークン、プロンプトキャッシュを使う前提)。
この数字は Anthropic の自社評価で、文書の言語は書かれていません。それにここで重ねた3段階 (文脈を足した埋め込み・文脈を足した BM25・再順位づけ) は、この章の3つの手と同じではありません。書き換えは入っておらず、BM25 も文脈を足したものです。どの段がどの外れ方に効いたかの内訳も出ていないので、ここから言えるのは重ねるほど取りこぼしが減ったところまでです。
まだ人が判断している
ここまでの手はどれも人が決めた手順を毎回同じ順で回します。 書き換えるかどうか、何件取るか、並べ直すかどうかは作った人が設定ファイルで決めているので、挨拶にも答えが1か所に書いてある質問にも同じ処理が走ります。何段も推論が要る質問でも、回す手は変わりません。
簡単な質問には過剰で、難しい質問には足りない。
検索するかどうか、何回検索するかを質問を見て LLM 自身に決めさせる。それが次の段階です。
日本では
日本語で RAG を組むと、英語の記事には出てこない論点が2つあります。
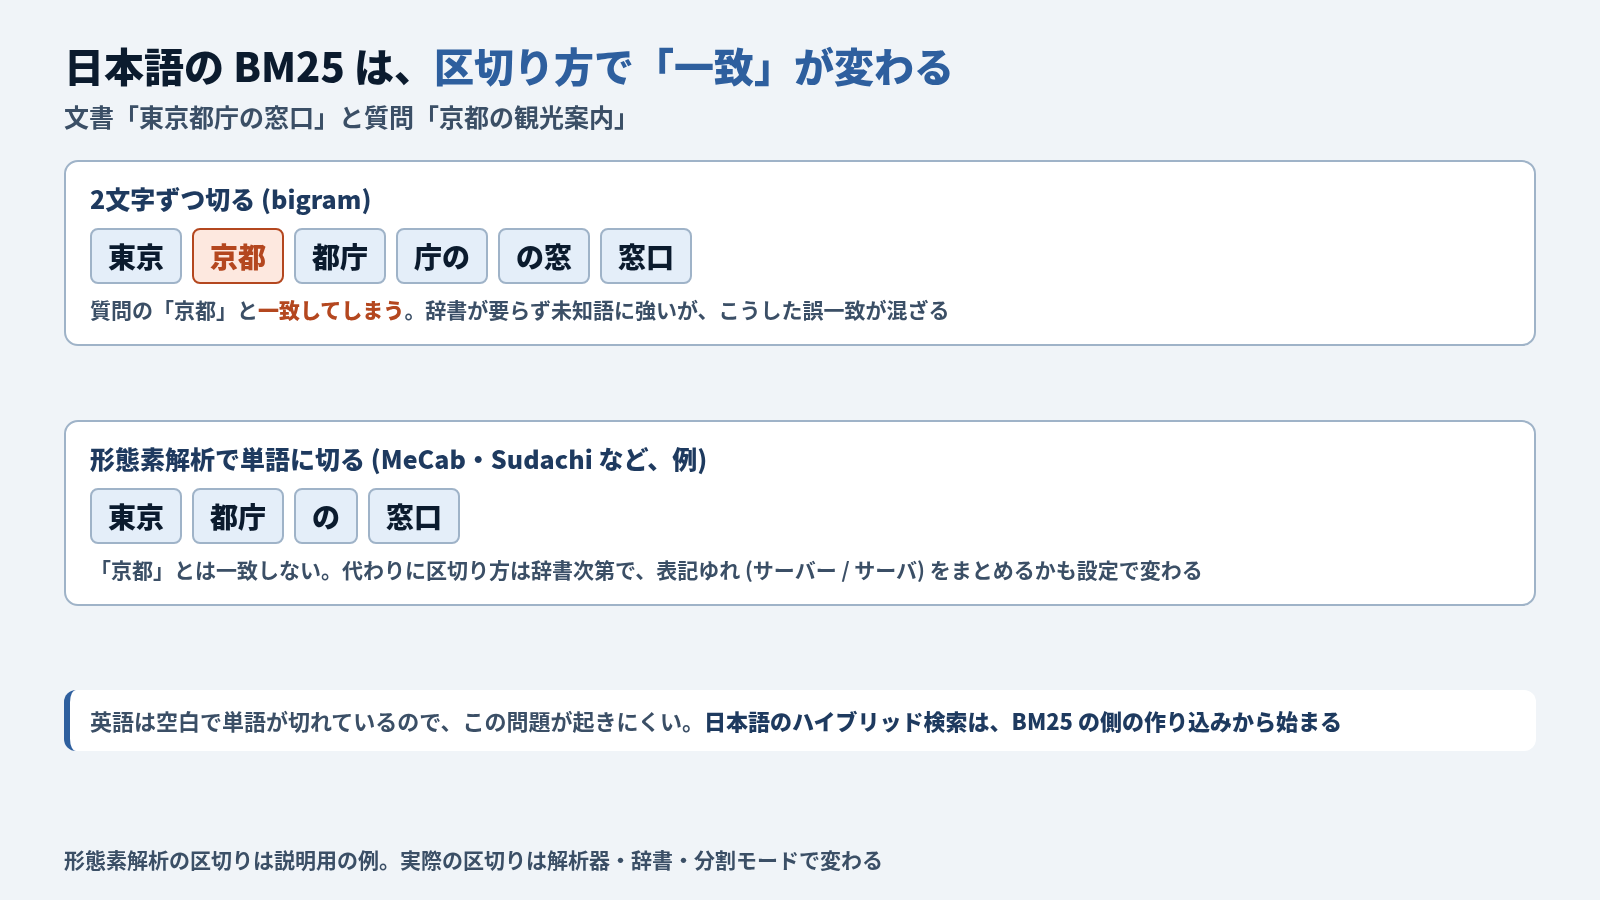
1つ目は、BM25 が単語の区切り方に左右されること。 BM25 は語の一致を数えます。日本語には単語の間の空白がありません。MeCab や Sudachi のような形態素解析で単語に切るか、文字を2つずつ切る n-gram にするかで、何が「一致」になるかが変わります。表記ゆれ (「サーバー」と「サーバ」) を同じ語とみなすかも、解析器の辞書と正規化の設定次第です。手1のハイブリッド検索は、日本語ではまず BM25 の側の作り込みが要ります。
2つ目は、埋め込みと再順位づけのモデルを、国産で選べるようになったこと。 日本語の検索の評価に、hotchpotch さんが2024年3月に公開した JQaRA があります (Hugging Face)。第1章「原論文 2017〜22年」で出てきた AI王 (JAQKET) の質問に、1問あたり100件の候補段落を付け、正解の段落を上位に並べられるかを nDCG@10 (上位10件の並びの良さ。正解が上にあるほど高い) で測ります。
| 方式 | モデル | nDCG@10 |
|---|---|---|
| BM25 | — | 0.458 |
| 埋め込み (多言語) | bge-m3 | 0.539 |
| 埋め込み (多言語) | multilingual-e5-large | 0.554 |
| 埋め込み (国産) | GLuCoSE-base-ja-v2 | 0.606 |
| 埋め込み (国産) | ruri-large | 0.6287 |
| 疎ベクトル (国産) | japanese-splade-base-v1 | 0.6441 |
| 再順位づけ | japanese-reranker-cross-encoder-large-v1 | 0.71 |
| 再順位づけ | ruri-reranker-large | 0.7712 |
並びはこの章の3つの手の効き方と同じ向きです。BM25 より埋め込み、多言語より国産、そして再順位づけが一段上です。ただし JQaRA の候補100件は埋め込みの類似度で集められているので、BM25 には少し不利な条件かもしれません。これは私の推論で、確かめてはいません。
埋め込みの総合評価 JMTEB の検索の項目では、名古屋大学の ruri-v3-310m が81.89で、小さい ruri-v3-130m も同じ81.89です。OpenAI の text-embedding-3-large は74.48、text-embedding-3-small は66.39でした (cl-nagoya/ruri-v3-310m、Ruri の技術報告は arXiv:2409.07737)。私が rag-retriever-bench で使ったのは、この表でいちばん低い text-embedding-3-small でした。素朴な RAG で見た「上限0.952」は、埋め込みを国産に替えれば上がる余地があります。ここもまだ測っていません。
業務の文書での例もあります。弥生と筑波大学は2025年の言語処理学会で、弥生の会計の解説ページ2,454件を検索の対象にした結果を報告しています (NLP2025 E7-4)。質問は、記事をもとに GPT-4o に作らせたものです。埋め込み検索 (FAISS、埋め込みは ruri-large) で引いた上位5件を Google の LLM (Gemini 1.5 Pro) に並べ直させると、「経理お役立ち情報」の質問260問で、1位の正答率が74.23から86.15に上がりました。
この86.15は順位をつけた理由も書かせる (CoT) 形での値で、理由を書かせないと81.54でした。ほかの2つの質問セットでは、CoT ありで60.53→72.63と72.39→78.62です。CoT なしだと後者は72.22で、並べ直す前をわずかに下回りました。専用の再順位づけモデルでなく、LLM そのものに並べ直させた例です。書かせ方でも効き目が変わります。
次に読む
検索するかどうかや何回検索するかを質問ごとに LLM に決めさせる段階は、Self-RAGとCRAG 検索を判断する7手法で扱います。手順を決める役が、人から LLM に移り始めるところです。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?