ベクトルデータベース7種を実測 素朴なRAG
素朴な RAG は、何も学習しない RAG です。文書を決まった長さに切り、埋め込みにしてデータベースに入れ、質問に近い上位k件を LLM に貼る。2022年10月に LangChain、11月に GPT Index (現 LlamaIndex) が出て、この4工程が数十行で組めるようになり、2023年にはこれが RAG の標準になりました。
出てきた理由ははっきりしています。2020年の原論文の RAG は、検索器と生成器を正解つきの質問で一緒に学習していました。手元にあるのが API の向こうの LLM と、正解の付いていない社内文書だけなら、一緒に学習するのは重すぎます。 だから学習済みの部品を、学習せずにつなぎました。
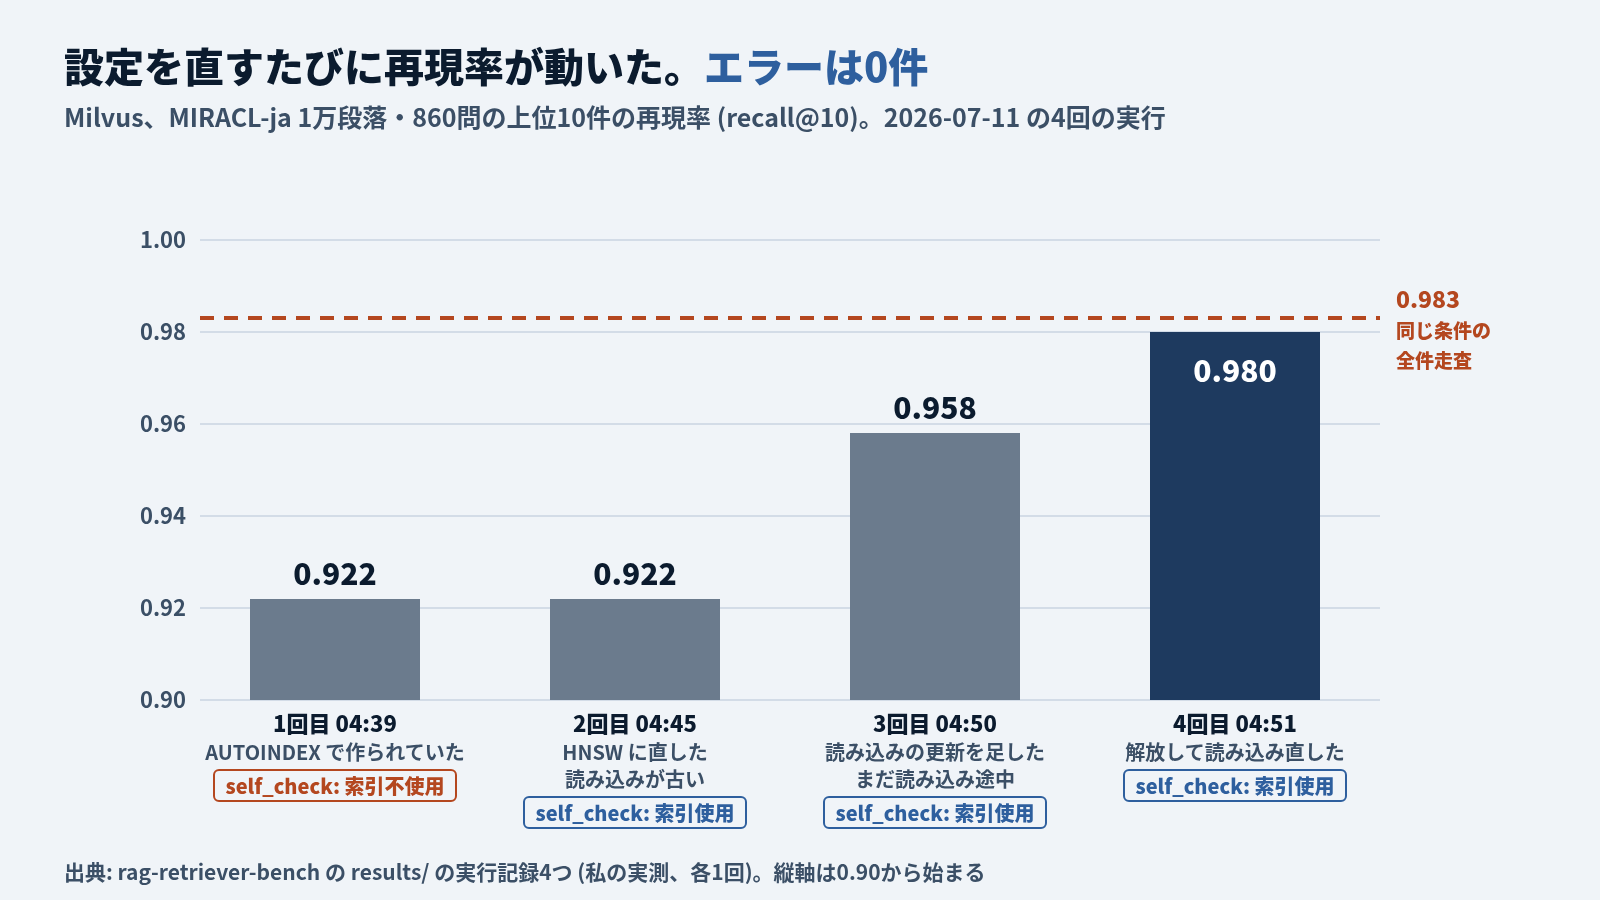
引き換えに失ったものがあります。部品のどれも、外れたことに気づきません。 原論文の RAG では、答えを外せば検索器まで学習で直りました。素朴な RAG では、分割がまずくても、索引が取りこぼしても、エラーは出ずにもっともらしい答えが返ります。私がベクトルデータベースを7種類測ったときも、索引が黙って本来の働きをしていない状態を3件踏みました。そのうち1件では、上位10件の再現率が0.922から0.980まで、設定を直すだけで動いています。
困りごと: 一緒に学習するのは重すぎる
2020年の RAG を自社の文書でそのまま再現しようとすると、3つのものが要ります。
- 正解つきの質問が数万件。 RAG の論文は Natural Questions などの公開データで学習しました。社内の文書には、そんな質問集はありません
- モデルの重み。 生成器を微調整するには、重みを手元の GPU に載せる必要があります
- 索引を作り直す計算。 文書側を学習するなら、学習の途中で全文書の埋め込みを計算し直します
2022年11月30日に ChatGPT が公開され (OpenAI)、手元にある LLM の多くは API の向こうになりました。2番目がまず満たせません。1番目もたいてい満たせません。残ったのは、学習済みの埋め込みモデルと学習済みの LLM を、そのまま使う道でした。
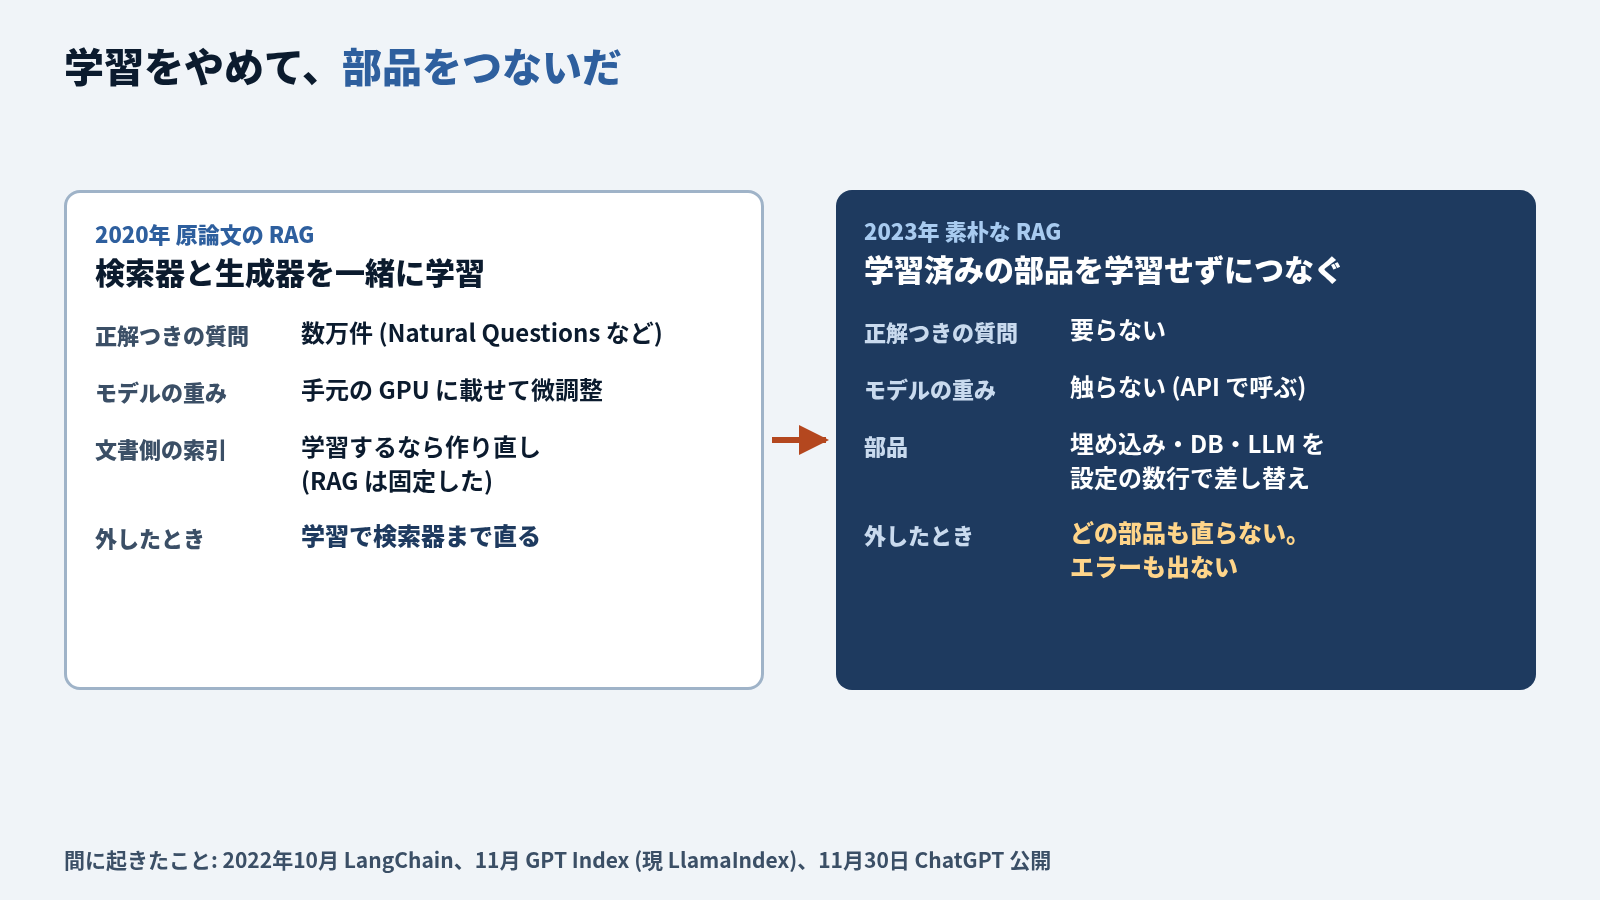
2022年10〜11月 部品をつなぐ道具が出た
LangChain の GitHub リポジトリが作られたのは2022年10月17日、PyPI に 0.0.1 が出たのが10月25日です。GPT Index のリポジトリは11月2日に作られ、PyPI には11月22日に出ました。2023年2月16日に llama-index の名前で出し直されています。ChatGPT の公開 (2022年11月30日) は、この2つが出た直後でした。
どちらも、文書の読み込み、分割、埋め込み、ベクトルデータベースへの保存、検索、プロンプトの組み立てを部品として揃えました。部品ごとに差し替えられるので、埋め込みを OpenAI から別のモデルに変える、ベクトルデータベースを別の製品に変える、といった入れ替えが設定の数行で済みます。
この組み方に「Naive RAG」という名前が付いたのは後からです。2023年12月の Gao らのサーベイ論文が、RAG を Naive・Advanced・Modular の3段階に分け、索引・検索・生成の3工程だけのものを Naive と呼びました (arXiv:2312.10997)。このシリーズでは「素朴な RAG」と訳します。
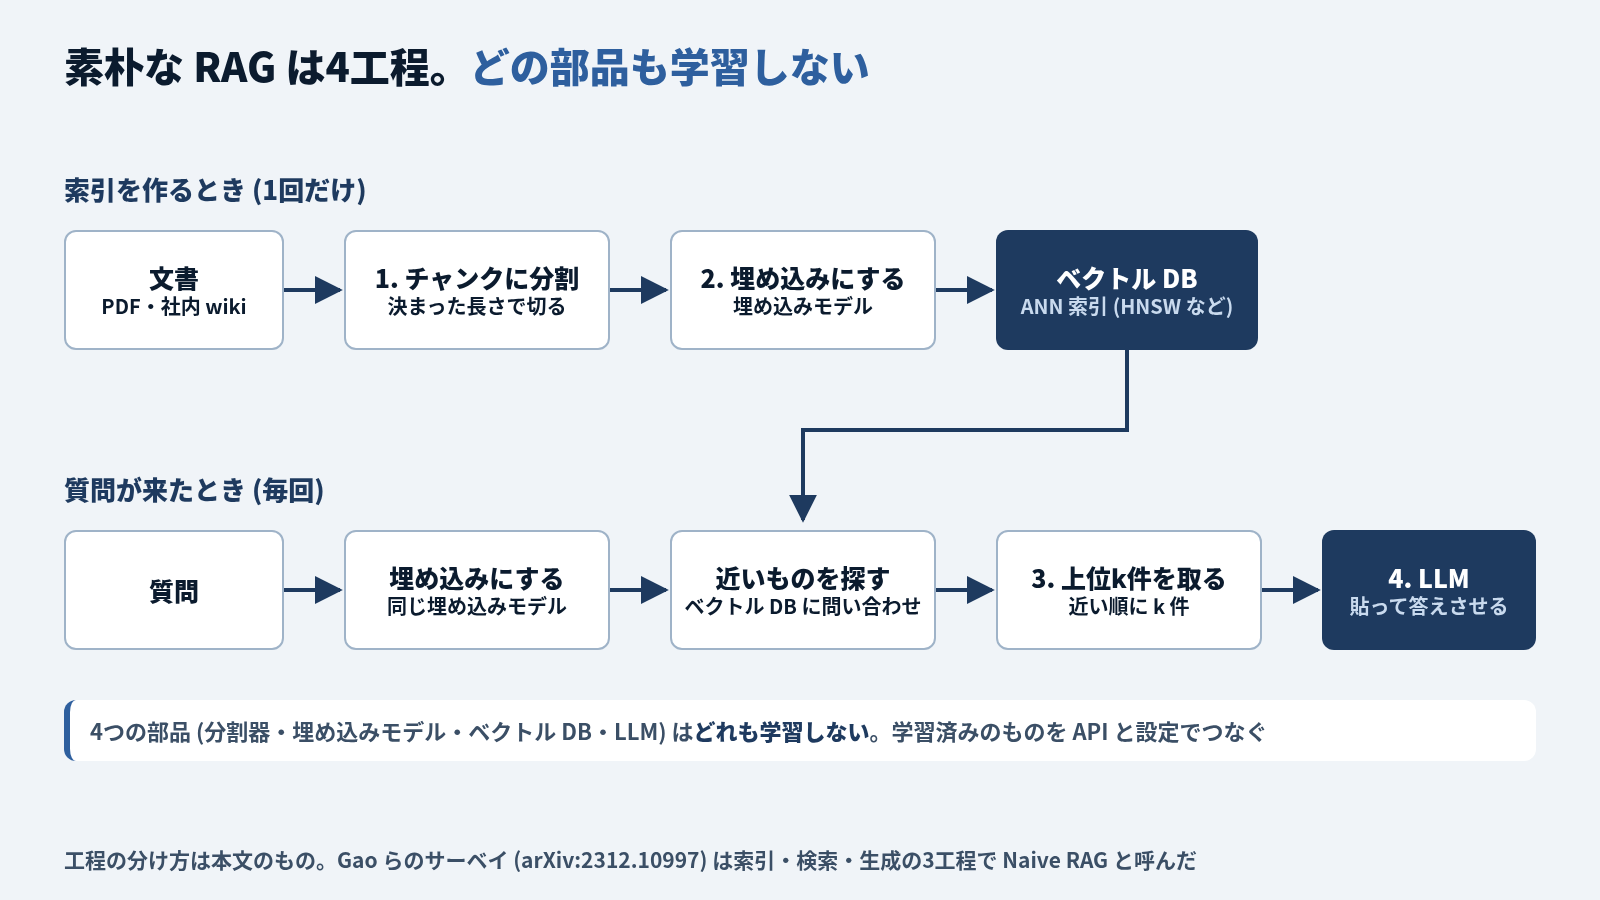
素朴な RAG の4工程
部品を順に並べます。用語はこのシリーズの第1章「原論文 2017〜22年」で導入したものを、そのまま使います。
索引を作るとき (1回だけ)
- チャンクに分割する。 文書を決まった長さの断片 (チャンク) に切ります。2020年の RAG は Wikipedia を100語ずつに切りました。社内文書では、文字数やトークン数で切り、前後を少し重ねるのが一般的です
- 埋め込みにして索引に入れる。 各チャンクを埋め込みモデルで数値の並びに変え、ベクトルデータベースに入れます。データベースは、質問のたびに全チャンクと比べなくて済むように ANN 索引 (近似最近傍探索の索引。全件と比べずに近いものを速く探す代わりに、少し取りこぼす) を作ります。代表が HNSW (点どうしを近さでつないだ多層のグラフをたどる方式) です
質問が来たとき (毎回)
- 上位k件を取る。 質問を同じ埋め込みモデルで変換し、近い順に k 件のチャンクを取ります
- プロンプトに貼って答えさせる。 取ったチャンクを質問と一緒にプロンプトに並べ、LLM に「以下の文書に基づいて答えよ」と頼みます
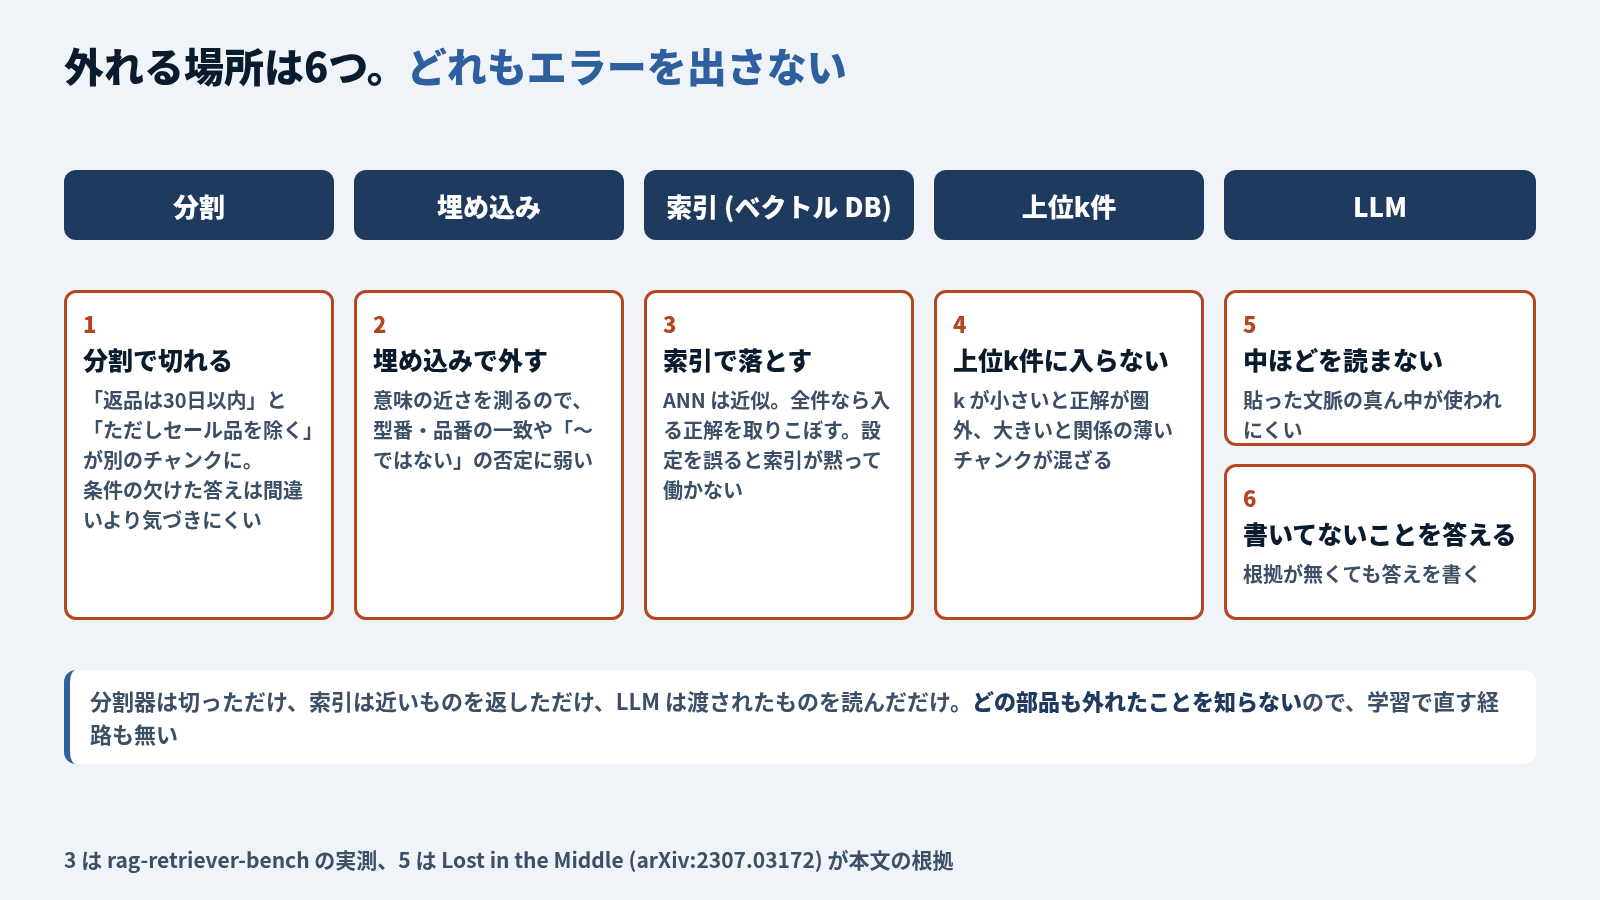
外れる6つの型
4工程それぞれに、外れ方があります。6つに分けると、どこを直すかの見当がつきます。
- 分割で切れる。 「返品は30日以内」と「ただしセール品を除く」が別のチャンクに入ると、片方だけが引かれます。条件の欠けた答えは、間違いより気づきにくい形です
- 埋め込みで外す。 埋め込みは意味の近さを測るので、型番や品番のような記号の一致や、「〜ではない」のような否定に弱くなります。DPR が BM25 に勝ったのは平均の話で、語の一致が決め手になる質問では逆転します
- 索引で落とす。 ANN 索引は近似です。全件と比べれば上位10件に入る正解を、索引をたどる途中で取りこぼします。設定を誤ると、索引そのものが効いていないこともあります。後の実測の節で扱います
- 上位k件に入らない。 k が小さいと正解が圏外に落ち、大きいと関係の薄いチャンクが混ざります
- 中ほどを読まない。 上位k件に入っても、プロンプトの中ほどに置かれた文書は LLM に使われにくくなります。次の節で数字を見ます
- 書いてないことを答える。 引いたチャンクに答えが無くても、LLM は「分かりません」と言わずに、もっともらしい答えを書くことがあります
6つに共通するのは、どの工程もエラーを出さないことです。分割器は切っただけ、索引は近いものを返しただけ、LLM は渡されたものを読んだだけです。
Lost in the Middle: 上位k件を増やしても安心できない
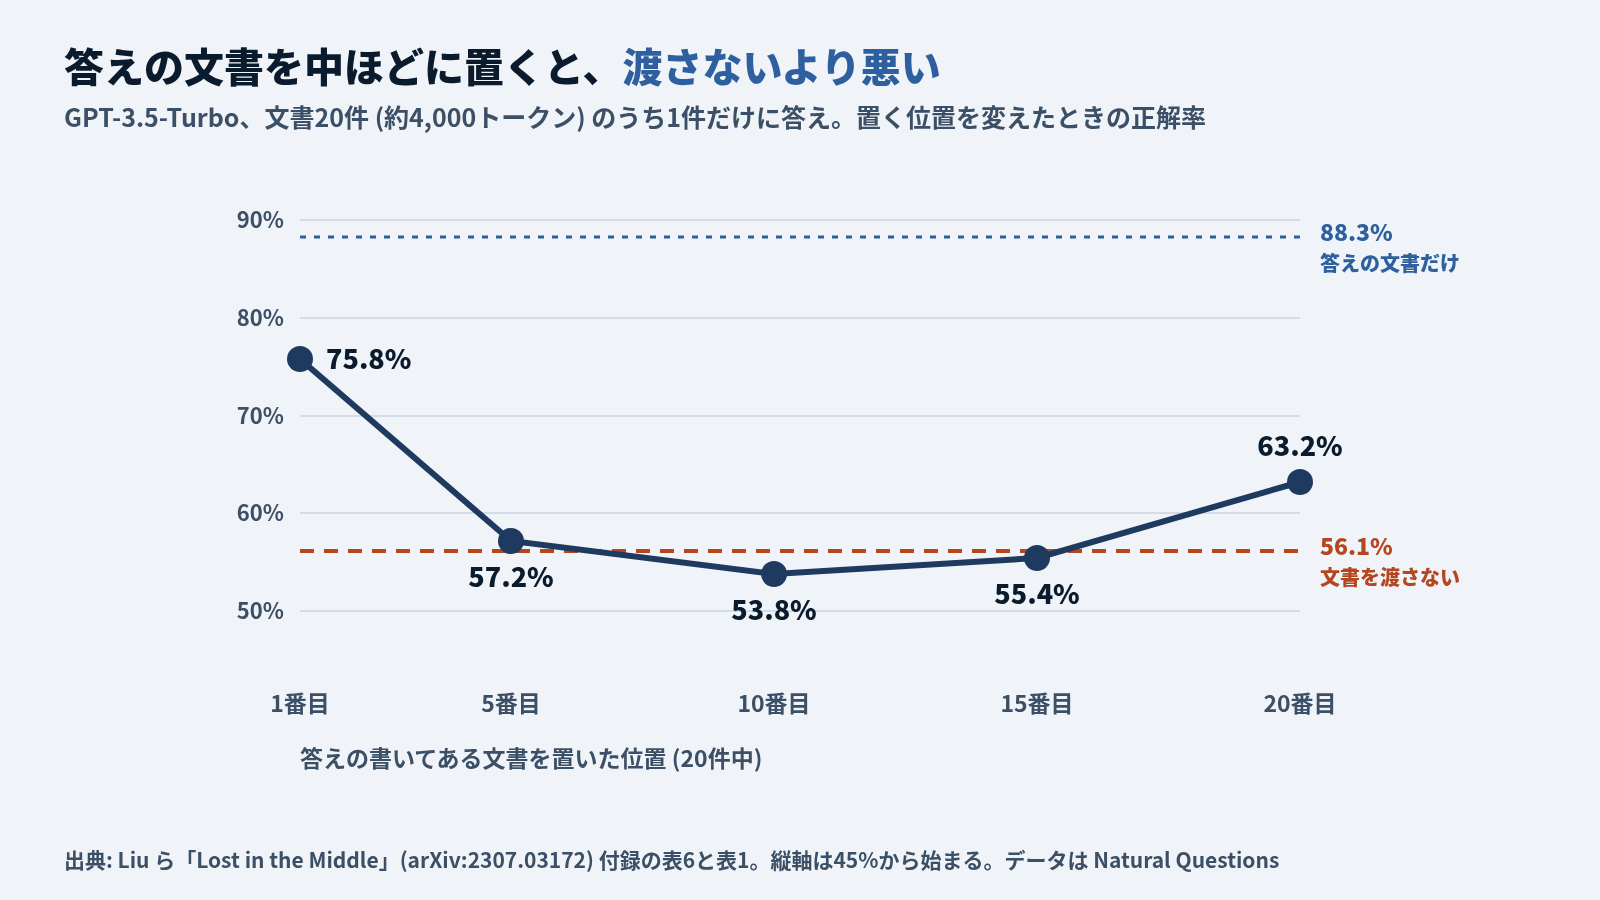
5番目の型を測ったのが、Liu らの「Lost in the Middle」です (2023年7月6日、arXiv:2307.03172、TACL)。
実験はこうです。Natural Questions の質問1つに、文書を20件 (約4,000トークン) 渡します。そのうち答えが書いてあるのは1件だけで、残り19件は答えを含まない関連文書です。答えの文書を何番目に置くかを変えて、正解率を比べました。
GPT-3.5-Turbo の結果 (論文の付録の表6) は、1番目に置くと75.8%、5番目で57.2%、10番目で53.8%、15番目で55.4%、20番目で63.2%でした。端は読まれ、中ほどが読まれない U 字 です。そして10番目の53.8%は、文書を1件も渡さずに答えさせたときの56.1%を下回ります。 答えの書いてある文書を渡したのに、渡さないより悪くなったわけです。答えの文書だけを渡したときは88.3%でした。
素朴な RAG の上位k件は、近い順に上から並べてプロンプトに貼るのが普通です。k を増やせば正解が圏内に入る確率は上がりますが、その正解が5番目や10番目に置かれれば、LLM が使わない場所に置いたことになります。k を増やすことは、取りこぼしを減らすと同時に、読まれない場所を広げます。
実測: 索引は黙って劣化する
3番目の型「索引で落とす」は、私が自分で測ったものがあります。rag-retriever-bench は、同じ文書と同じ質問のままベクトルデータベースだけを差し替えて比べるために作ったベンチマークです (製品ページ)。
条件をそろえておきます。
- 文書と質問: MIRACL の日本語版 (日本語 Wikipedia の段落に、人手で質問との関連を判定したもの)。質問は860問
- 埋め込み: OpenAI の text-embedding-3-small (1536次元)。全データベースに同じ埋め込みを入れる
- 索引: HNSW を使う6種類は m=16、ef_construction=64、ef_search=100 にそろえ、距離はコサイン。LanceDB だけは索引の形が違い (IVF_HNSW_SQ、後述)、m と ef_construction は同じですが、検索時に ef_search を渡していません
- 物差し: 上位10件の再現率 (recall@10。正解の段落のうち、上位10件に入った割合)。LLM は使わず、答えの良し悪しは測っていない
1点目: 索引が効いていなくても、エラーは出ない
ハーネスには、実行ごとに「ANN 索引が本当に使われたか」を確かめる self_check という仕組みを入れました。データベースの実行計画 (EXPLAIN) やサーバーの統計を見て、索引を通ったかどうかを記録します。
これを入れてから、索引が黙って本来の働きをしていない状態を3件見つけました。 ClickHouse は、索引を作る最後の手順 (OPTIMIZE FINAL) を飛ばすと、索引を使わず全件を比べる走査に落ちていました。Qdrant は、索引を作り始める量のしきい値がデータより大きいと索引を作らず、索引の付いていない生のデータを検索していました。Milvus は、データを書き込んだあとに読み込んだ状態が古く、一部の区画を見ないまま結果を返していました。
いちばん数字に出たのが Milvus です。1万段落での上位10件の再現率は、次のように動きました。
| 実行 (2026-07-11、UTC) | 状態 | self_check | recall@10 |
|---|---|---|---|
| 04:39 | 索引が HNSW でなく AUTOINDEX で作られていた | 索引不使用 | 0.922 |
| 04:45 | HNSW に直した。ただし読み込んだ状態が古く、一部の区画を見ていない | 索引使用 | 0.922 |
| 04:50 | 読み込みを更新する命令を足した。完了を返したあとも読み込みが続いていた | 索引使用 | 0.958 |
| 04:51 | いったん解放して読み込み直した | 索引使用 | 0.980 |
4回とも、エラーは1件も出ていません。 0.922 という数字だけを見れば、「Milvus は少し精度が低い」と読めてしまいます。比較表に載せていれば、私の設定ミスがそのまま製品の評価になっていました。
もう1つ大事なのは2回目です。索引の設定を直したので self_check は「索引使用」を返しましたが、再現率は0.922のままでした。索引が使われていることと、全部のデータが検索されていることは別です。 ここは同じ条件の全件走査 (0.983) や他のデータベースと並べて初めて、低すぎると気づけました。点検の仕組みを1つ入れても、黙った劣化は全部は捕まりません。
2点目: 索引の種類と、データの量で落ちる
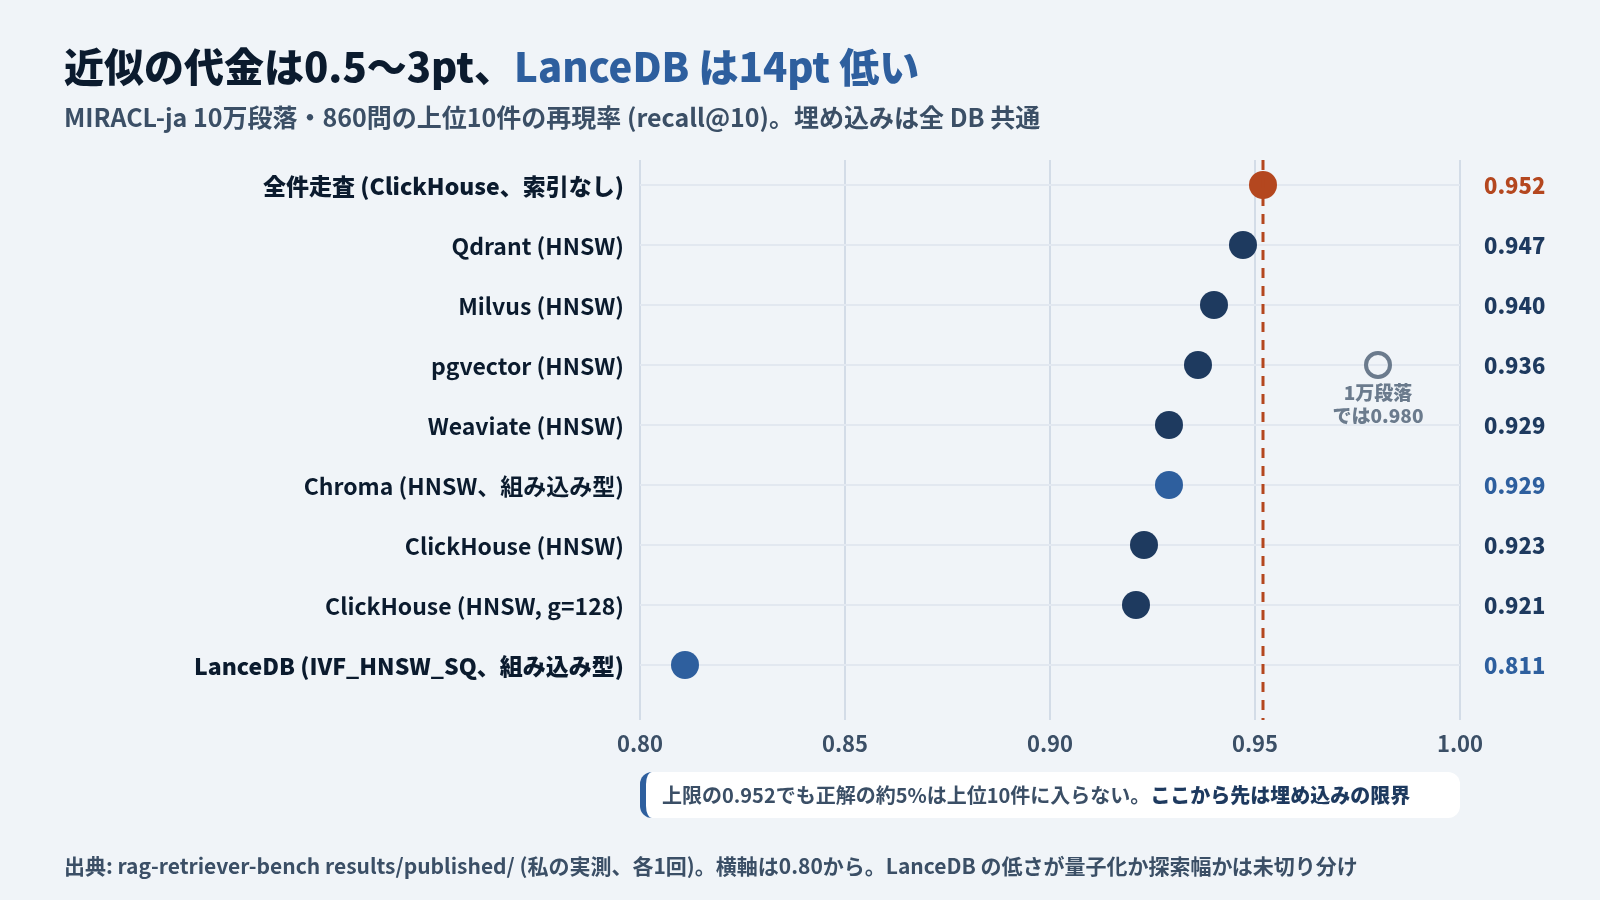
直したあとの正式な結果 (results/published/) で、10万段落にしたときの上位10件の再現率を並べます。
- 全件走査 (ClickHouse の索引なし): 0.952。 全段落と比べるので、この埋め込みで出せる上限です
- HNSW の6種類 (Qdrant・Milvus・pgvector・Weaviate・Chroma・ClickHouse): 0.921〜0.947。 上限から0.5〜3ポイント落ちます。これが近似の代金です。ClickHouse は設定を2通り測り、低いほうが0.921です
- LanceDB (IVF_HNSW_SQ。区画ごとに HNSW を作り、ベクトルを8ビットに縮めて持つ索引): 0.811。 上限から14ポイント落ちます。区画は1つにしたので区画に分けた効果は入っておらず、検索時の探索幅 (ef_search) もほかとそろえていないため、落ちた原因が量子化か探索幅かは切り分けていません
データの量でも落ちます。pgvector の HNSW は、1万段落では0.980でしたが、10万段落では0.936になりました。同じ質問、同じ正解、同じ設定で、探す相手が10倍になっただけです。
もう1つ見ておきたいのは、上限の0.952そのものです。全件と比べても、正解の約5%は上位10件に入りません。索引のせいではありません。埋め込みの限界です。ここから先は、ベクトルデータベースを替えても直りません。
日本では
日本で素朴な RAG が業務に入ったのは2023〜24年で、社内文書の検索と問い合わせ対応から始まっています。以下はどれも各社の発表で、評価の方法は公開されていないか、自社の評価です。
| 組織 | 時期 | 中身 | 発表の数字 |
|---|---|---|---|
| パナソニック コネクト | 2023年2月 汎用の対話 AI を全社展開、2024年4月 品質管理の自社特化 AI | 2023年2月は ChatGPT をベースにした社内向けの対話 AI (現 ConnectAI) を国内全社員約12,400人に。これは RAG ではありません。RAG にあたるのは自社の文書を引いて答える自社特化 AI で、2023年9月に公開情報で試験運用し、2024年4月から品質管理の情報630件・11,743ページに広げた | 2023年6月〜2024年5月の12か月で1,396,639回。年18.6万時間の削減は、社員が答えた1回あたりの削減時間からの推計。品質管理の自社特化 AI の回答への社員の評価は5点満点の3.5点 (発表) |
| 三井住友フィナンシャルグループ | 2023年4月 実証実験の開始 | SMBC-GPT。グループ専用の環境で動かす社内向けの対話 AI。グループの独自情報に答えられるようにするのは、発表の時点では今後の予定 (NEC 発表) | — |
| LINEヤフー | 2024年7月 全従業員へ | SeekAI。社内ワークスペースツールのページや社内データを参照元に、RAG で答える。社内規程・問い合わせ先・技術スタック・取引先とのやり取りの履歴などを引ける | 広告事業のカスタマーサポートで、テスト導入時に正答率約98% (発表) |
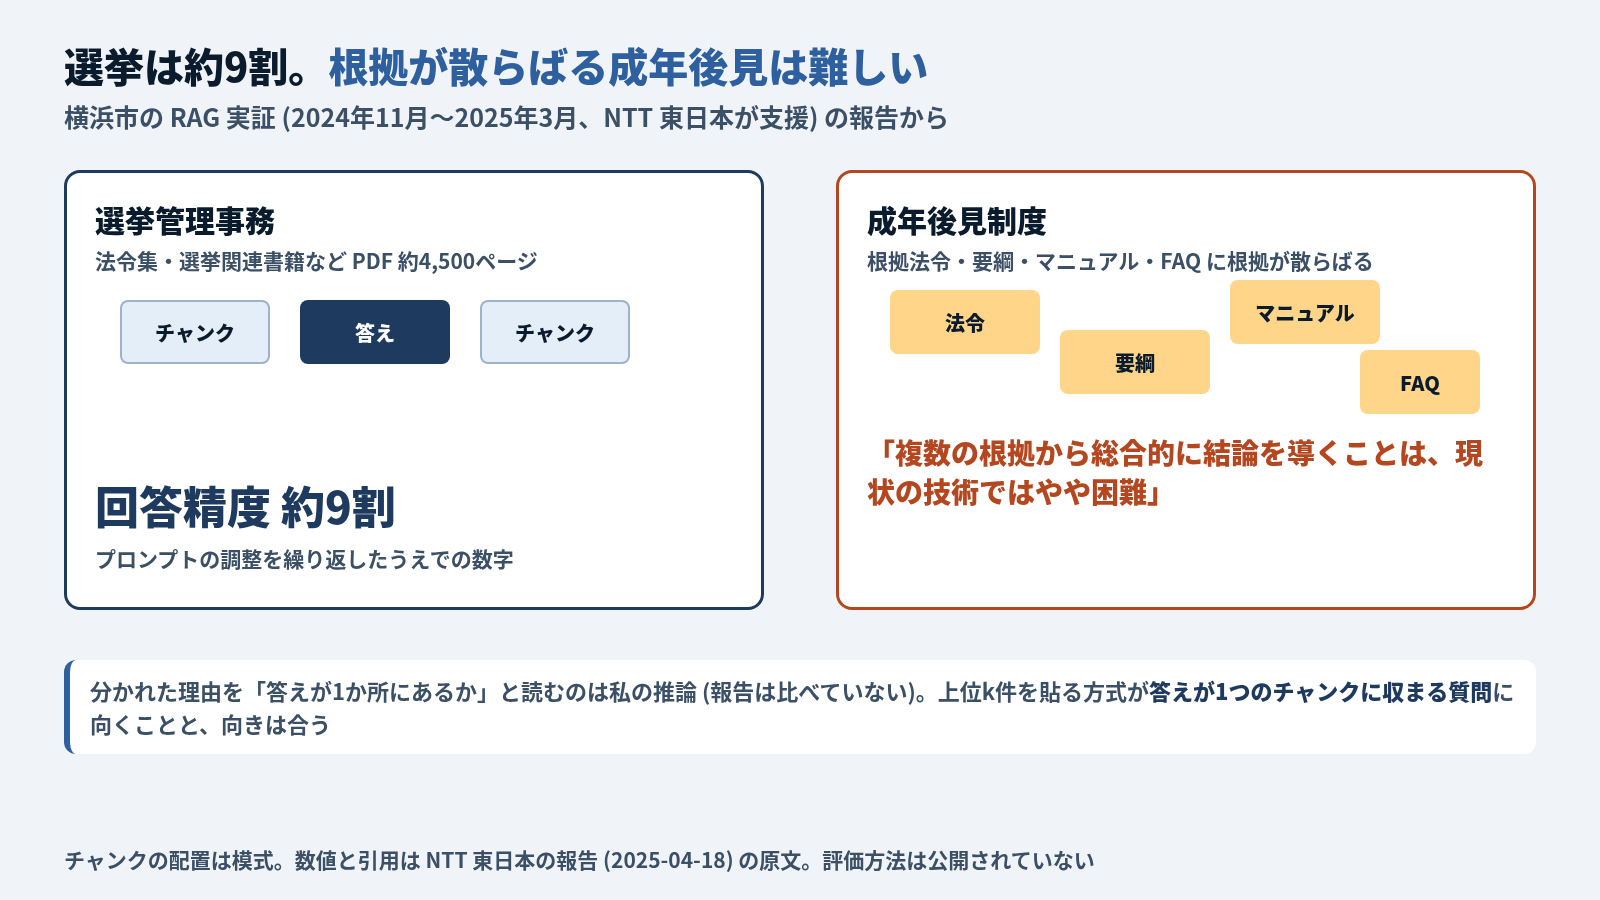
| 横浜市 (NTT 東日本が支援) | 2024年11月〜2025年3月 | 選挙管理事務で、法令集や選挙関連書籍など PDF 約4,500ページを機械が読みやすい形に整理して RAG に | 選挙の回答精度は約9割 (プロンプトの調整を繰り返したうえで)。成年後見制度では「複数の根拠から総合的に結論を導くことは、現状の技術ではやや困難」 (報告) |
横浜市の報告は、選挙と成年後見で結果がはっきり分かれました。
選挙の問い合わせは約9割でしたが、これはプロンプトの調整を繰り返したうえでの数字です。根拠が法令・要綱・マニュアル・FAQ に散らばる成年後見は難しい、という結果でした。報告が理由に挙げているのは「根拠データが多岐に渡るため」だけです。
分かれ目を「答えが1か所に書いてあるかどうか」と読むのは私の推論で、報告がそこを比べたわけではありません。それでも、上位k件を貼る方式が答えが1つのチャンクに収まる質問に向くことと、向きは合っています。散らばった根拠をつなぐ問いは、このシリーズの後半の GraphRAG の章で扱います。
パナソニック コネクトの「3.5点」も見ておきたい数字です。全社展開の数字 (回数と時間) とは別に、品質管理の文書を引く用途の質を社員の評価で出したもので、発表はこれを「高い水準」と書いています。
私は5点満点との差のほうに目が行きます。これは私の読みです。
次に読む
素朴な RAG の外れ方に、一つずつ手を打っていったのが Advanced RAG です。語の一致で引く BM25 と埋め込みを組み合わせ、引いたものを並べ直し、質問そのものを書き換えます。Anthropic の自社評価 (4つの領域の文書の平均) では、チャンクに文脈を書き足す処理と BM25 の併用と再順位づけを重ねて、上位20件で取りこぼす割合が5.7%から1.9%まで下がりました。続きは ハイブリッド検索 RAGの外れを3分の1にで扱います。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?