RAGとは 2017〜2026年の手法9段階
RAG の解説を読むと、Advanced RAG、Self-RAG、GraphRAG、Agentic RAG、CAG、DecisionRAG と、名前が次々に出てきます。どれも「前の方式では困ること」があって生まれたものですが、名前だけ並べると全部を入れないといけないように見えます。このシリーズは、2017年の原論文から2026年10月の DecisionRAG までを9段階に並べます。各段階が何に困って生まれ、どの型の質問に届くようになったかを一次資料で追い、自分の質問にはどこまで要るのかを決められるようにします。
読み終えるとできること
- 社内の規程やマニュアルを引くような、答えが1か所に書いてある使い方なら、基本の RAG に少し工夫を足すだけで足りると判断できます
- 自分の質問が「いくつかの資料をつながないと答えられない」ものか、「資料全体を見渡さないと答えられない」ものかを見分け、新しい手法が本当に要るかを決められます
- 「AI が長い文章を読めるようになったから検索は要らない」といった話を聞いたとき、どんな条件なら当てはまるのかを自分で確かめられます
- 日本語の文書で検索がつまずきやすい理由と、日本の製造業がベテランの知識を図にして残そうとしている理由を説明できます
シリーズ目次全 10 章
- 0 RAGとは 2017〜2026年の手法9段階 Pillar (現在のページ)
- 1 検索拡張生成RAGの原論文 2017〜22年 検索拡張生成 (RAG) の原論文は何を提案したのか。2017〜22年の8本を、検索器を誰が学習したかで並べ、今の学習しないRAGとの違いを押さえます。
- 2 ベクトルデータベース7種を実測 素朴なRAG ベクトルデータベース7種を同じ10万段落で実測しました。素朴なRAGの外れる6つの型と、エラーを出さずに精度が落ちる索引の落とし穴を見ます。
- 3 ハイブリッド検索 RAGの外れを3分の1に ハイブリッド検索・再順位づけ・クエリ書き換えで、RAGの検索の外れはどこまで減るか。失敗率5.7%→1.9%の条件を読み、日本語で何が効くかまで見ます。
- 4 Self-RAGとCRAG 検索を判断する7手法 Self-RAGやCRAGは、検索するか・何回するか・やり直すかをモデルに判断させます。ReActからAdaptive-RAGまで7手法を一次資料で追います。
- 5 GraphRAG 系譜とベクトル検索との実測比較 GraphRAGはベクトル検索より強いのか。2024〜25年の系譜を論文で追い、日本語の多段質問120問の予備測定 (73.3%対61.7%) も載せます。
- 6 暗黙知をナレッジグラフに 2007年問題から 暗黙知をナレッジグラフに残す取り組みは2007年問題から続いています。技能継承が順調な企業は1.9%。LLMで安くなった工程とまだ高い工程を分けます。
- 7 コンテキストウィンドウ100万でもRAGが残る理由 コンテキストウィンドウが100万トークンに伸びてもRAGは残りました。全部入れる方式やCAGと比べた論文から、量・費用・更新頻度で使い分ける線を引きます。
- 8 Agentic RAG 2025年 検索を学ぶAI Agentic RAGは検索の仕方を強化学習で学びます。Search-R1、Deep Research、MCPまでを一次資料で追い、AIに任せる範囲を分けます。
- 9 DecisionRAGとは 2026年の新検索手法 DecisionRAGとは、LLMが文書の木をたどる2026年の検索手法です。論文の数字と効かない条件を読み、Adaptive-RAGとの違いも整理します。
RAG について調べると、名前が次々に出てきます。Advanced RAG、Self-RAG、CRAG、GraphRAG、LazyGraphRAG、Agentic RAG、CAG、そして2026年10月には DecisionRAG。全部を入れないと時代遅れのように見えますが、どれも「前の方式で困ったこと」があって生まれたものです。困りごとが自分の質問に無ければ、その段階は要りません。
社内文書の検索のように、答えが1つの文書に書いてある質問が中心なら、Advanced RAG で足ります。 素朴な RAG に、キーワード検索と埋め込み検索を混ぜる hybrid 検索と、取ってきた候補を並べ直す再順位づけ (rerank) を足した形です。2026年の今も、業務の RAG の大半はここで止めて構いません。
先に進む理由は3つです。記事をまたいで関係をたどる質問が多いなら、グラフにするか、LLM に検索を何回も繰り返させる段階へ進みます。ただしグラフは作り方しだいで、私の予備測定では、簡易な GraphRAG がベクトル検索に負けました (GraphRAG)。文書群の全体を問う質問が多いなら、GraphRAG のコミュニティ要約が効きます。再順位づけを足しても正解の文書が上位に来ず、文書に見出しの構造がはっきりあるなら、検索器そのものを見直す段階 (DecisionRAG など) が候補に入ります。どれも、測ってから決めることです。
このシリーズは、2017年から2026年11月までを9段階に並べます。背骨にあるのは検索の判断を誰が持つかです。人が決めた手順で1回だけ検索する形から、LLM が検索の回数ややり直しを決める形へ、そして LLM が検索そのものを担う形へと移っていきます (1・2・3・4・8・9章)。途中には、探す対象をグラフに変える段階 (5章)、その動機を組織の側から見る章 (6章)、検索そのものを省けないかを問う段階 (7章) という寄り道もあります。
揃える課題: 3つの型の質問
段階を比べるには、物差しをそろえる必要があります。このシリーズでは、質問を次の3つの型に分け、各段階がどの型に届くようになったかで比べます。
| 型 | 例 | 答えのある場所 |
|---|---|---|
| 1つの文書で答えられる | 「出張の日当はいくらか」 | 社内規程の1か所に書いてある |
| 記事をまたいでたどる(多段、マルチホップ) | 「織田信長の妹の夫は、どの戦いで信長と戦ったか」 | お市の方 → 浅井長政 → 姉川の戦い、と3つの記事をつなぐ |
| 全体を問う | 「この文書群の主題は何か」 | どの文書にも書いていない。文書どうしの関係から浮かび上がる |
1つ目の型は、2022年の素朴な RAG でもかなり答えられます。2つ目と3つ目が、その後の段階が生まれた理由です。似た断片を集める仕組みは、書いてある場所が1つなら強いのですが、つなぐ必要がある答えには届きにくく、どこにも書いていない答えには構造的に届きません。
9つの段階
| 章 | 段階 | 時期 | 前の段階の何に困ったか |
|---|---|---|---|
| 1 | 原論文 | 2017〜22 | 知識をパラメータに詰めると、モデルが大きくなり続ける |
| 2 | 素朴なRAG | 2022〜23 | 検索器と生成器を一緒に学習するのは重すぎる |
| 3 | Advanced RAG | 2023〜24 | 上位k件では外れる。長い文脈の中ほどは読まれない |
| 4 | 自分で判断するRAG | 2022〜24 | 必要かどうかに関係なく、毎回同じ件数を検索する |
| 5 | GraphRAG | 2024〜25 | 全体を問う質問、点と点をつなぐ質問に届かない |
| 6 | 日本の現場: 人に固まった知識をグラフにする | 2002〜26 | 人が辞めると、判断の理由ごと知識が消える |
| 7 | 長い文脈とCAG | 2024 | 全部入れれば検索は要らないのでは、という問い |
| 8 | エージェントが検索する | 2025〜26 | 検索の判断のルールを人が書ききれない |
| 9 | LLMが検索器になる | 2025〜26 | 検索器が落としたものは、生成側では取り戻せない |
6章だけは手法の段階ではありません。グラフが求められた理由を、技術側 (5章) ではなく組織側から見る章です。日本の製造業では、熟練者の退職で知識が消えることが、グラフを作る一番の動機になってきました。
比較表
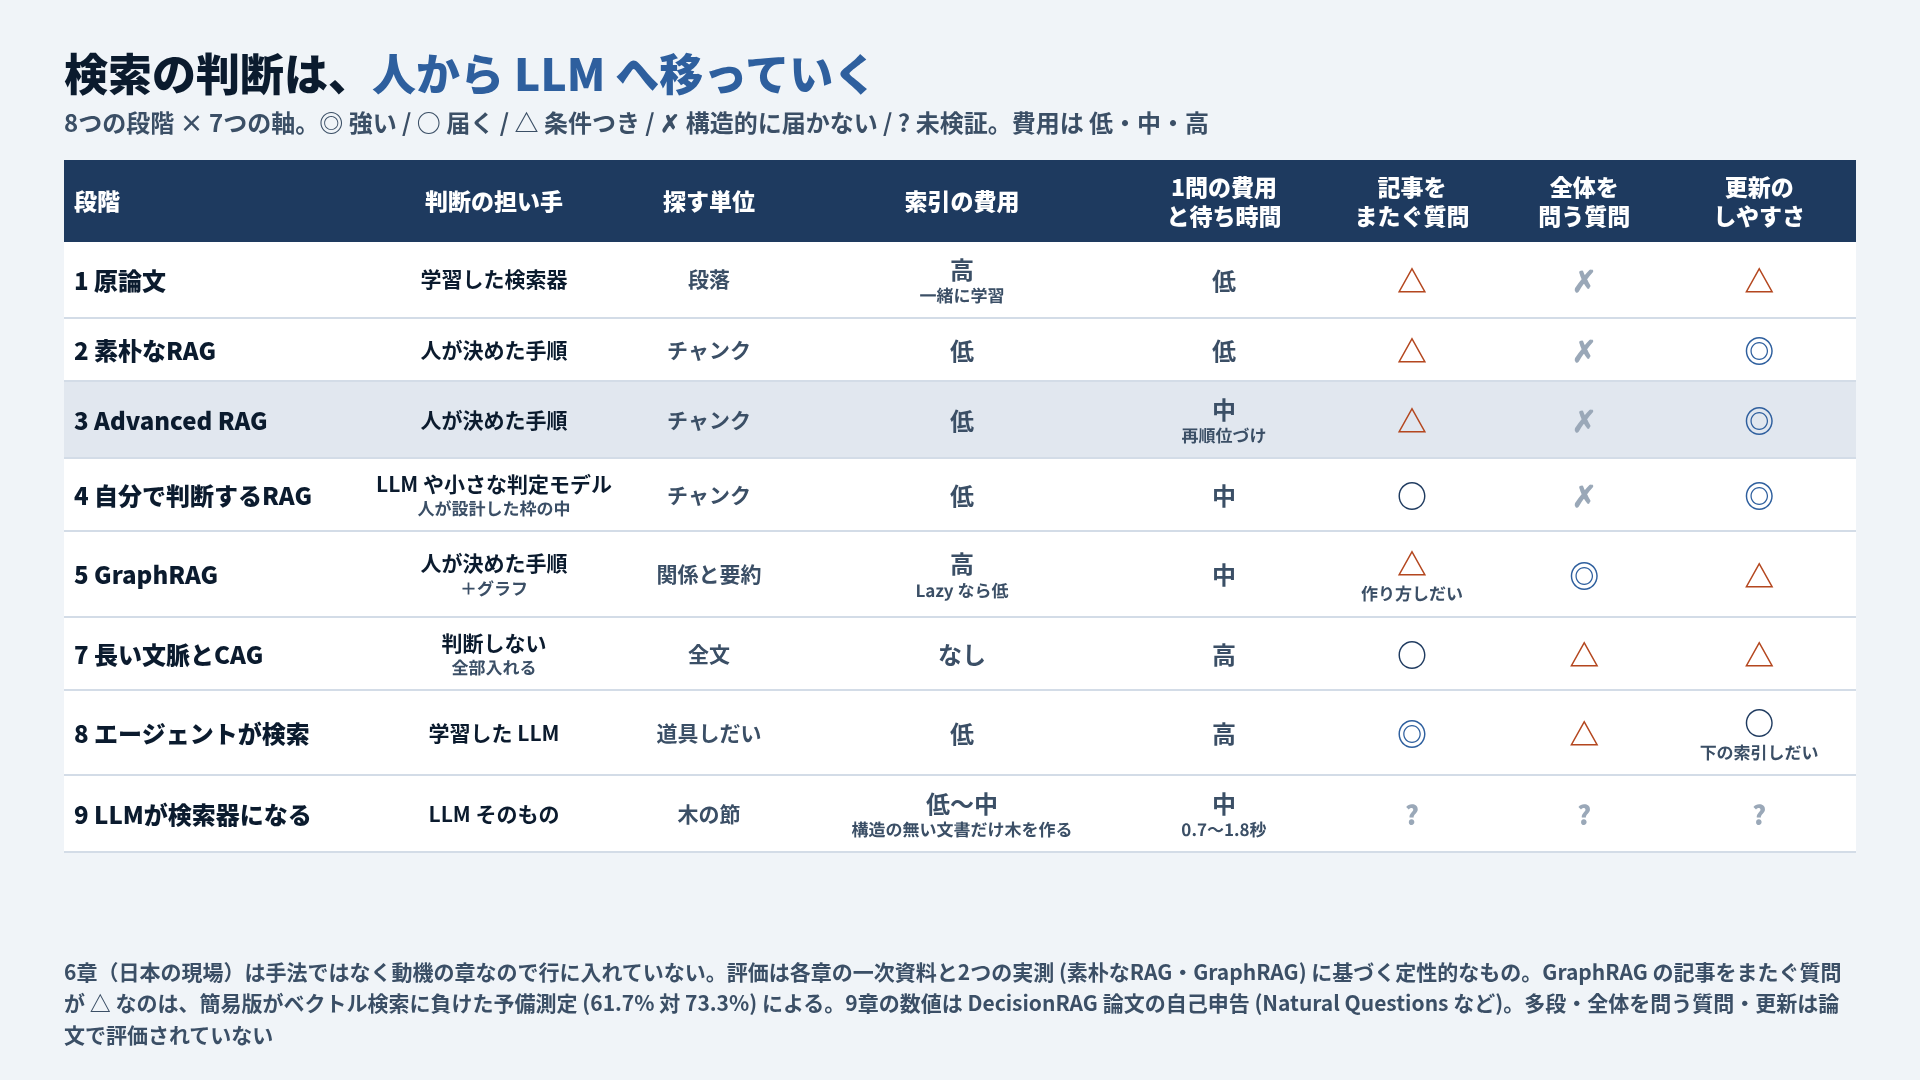
表の列は次の7つの軸です。
| 軸 | 何を見るか | なぜ効くか |
|---|---|---|
| 判断の担い手 | 検索するか、何回するか、何を使うかを誰が決めるか | シリーズを通す軸です。担い手が人から LLM へ移るほど柔軟になり、遅く高くなります |
| 探す単位 | 断片(チャンク)か、関係(トリプル)か、木の節か | 単位が答えの形に合っていないと、検索をいくら工夫しても届きません |
| 索引の費用 | 質問が来る前に払う費用 | 初代 GraphRAG は全文を LLM に通すので、文書が増えるほど先払いが膨らみます |
| 1問の費用と待ち時間 | 質問1つごとに払う費用 | エージェントや長い文脈は、索引を軽くする代わりにここが重くなります |
| 記事をまたぐ質問 | 多段の質問に届くか | 2つ目の文書に届かないことが、素朴な RAG の典型的な失敗です |
| 全体を問う質問 | どこにも書いていない答えに届くか | 似たものを集める方式では、原理的に届きません |
| 更新のしやすさ | 文書が変わったときに何を作り直すか | グラフや要約は、作るより更新し続けるほうが重くなります |
自分ならどれか
| 状況 | 残る候補 | 効いている軸 |
|---|---|---|
| 社内規程・FAQ・マニュアルを引く。答えは1つの文書にある | Advanced RAG | 1つの文書で答えられる型が中心なら、hybrid と再順位づけで足ります |
| 日本語の文書で、キーワードの取りこぼしが多い | Advanced RAG(BM25 側を作り込む) | 単語の区切りがないので、形態素解析と表記ゆれの統一が先に効きます |
| 簡単な質問と難しい質問が混ざり、毎回の検索が無駄に見える | 自分で判断するRAG | 質問の難しさで、検索なし・1回・繰り返しを切り替えます |
| 人・部品・設備の関係を2段以上たどる質問が多い | GraphRAG / エージェント(作り方しだい) | 2つ目の文書に届かないなら、関係を先に作るか、検索を繰り返させるかです。グラフは2つ目まで届く作りが前提で、質問中の人物につながる行で文脈が埋まる簡易版は、私の予備測定でベクトル検索に負けました |
| 「全体の傾向は」のような質問が多い | GraphRAG(LazyGraphRAG) | コミュニティ要約は全体を問う型のために作られました |
| 熟練者の判断の理由を残したい | ナレッジグラフ+人からの聞き取り | 文書からグラフを作る工程は安くなりましたが、人から言葉を引き出す工程は今も重いです |
| 知識が小さく、ほとんど変わらない | CAG(全部を文脈に入れてキャッシュ) | 量が文脈窓に収まり、更新が少なければ、検索を省けます |
| 調べ物の質問で、何を何回探すか事前に決められない | エージェントが検索する | 判断を学習した LLM に道具として検索を渡します。遅さと費用は増えます |
| 見出しの構造がはっきりした文書で、再順位づけを足しても正解が上位に来ない | LLMが検索器になる(実験段階) | DecisionRAG はまだ査読前で、コードも公開されていません |
どの行も、上から順に試すのが基本です。下の段階は、上の段階で測って届かないと分かってから進みます。
このシリーズの検証状態
| 段階 | 状態 |
|---|---|
| 原論文 | 一次資料 |
| 素朴なRAG | 実測あり(ベクトルデータベース7種、MIRACL-ja 10万段落・860問) |
| Advanced RAG | 一次資料 |
| 自分で判断するRAG | 一次資料 |
| GraphRAG | 実測あり(自作の簡易GraphRAG とベクトル検索、JEMHopQA 120問、予備測定・各1回) |
| 日本の現場 | 一次資料 |
| 長い文脈とCAG | 一次資料 |
| エージェントが検索する | 一次資料 |
| LLMが検索器になる | 一次資料(査読前のプレプリント、コード未公開) |
2026年11月4日の時点で、手元で動かしているのは2段階だけです。残りは論文と公式発表を読んで書いています。測るたびに、この表を「実測あり」に書き換えます。
ナレッジグラフを入れるかどうかの判断と、何段の関係まで LLM がたどれるかの実測は、別のシリーズ ナレッジグラフは要るのか にまとめています。
日本では
日本では2023年に生成 AI の社内導入が一気に広がり、社内文書を引く RAG がそれに続きました。パナソニック コネクトは2023年2月に対話型の生成 AI を全社に展開し、社内の品質管理情報に答える自社特化 AI を2024年4月から本格運用しています。全体で年18.6万時間の削減と公表していますが、これは社員の回答 (1回あたり平均約20分の削減) からの推計です。そこから先で日本語ならではの論点が3つ出てきます。
- 単語の区切りがない。 キーワード検索の BM25 は、単語の切り方しだいで精度が変わります。日本語の検索評価 JQaRA では、BM25 の nDCG@10 が 0.458、国産の再順位づけモデルが 0.7712 でした(Advanced RAG)
- 国産の埋め込みモデルが追いついたのは2024年以降。 2023年は海外のモデルを使うしかありませんでした
- 文書に表と画像が多い。 日本語の RAG 評価データでは、根拠の約半分が表か画像でした(長い文脈とCAG)
製造業では、技能伝承がナレッジグラフの大きな動機になっています。技能継承が必要と答えた製造業の4,262社のうち、「うまくいっている」は1.9%でした(JILPT、2026年5月。機械・金属系を中心とする製造業11業種の、従業員30人以上の企業が対象)。詳しくは日本の現場の章で扱います。
読む順
順に読むと、検索の判断が人から LLM へ移っていく流れが追えます。困っている場所が分かっているなら、その章から読んでも通じるように書いています。
| 章 | 内容 |
|---|---|
| 1 | 原論文 — 検索器も一緒に学習していた時代 |
| 2 | 素朴なRAG — 学習をやめて、分割・埋め込み・上位k件で組む |
| 3 | Advanced RAG — hybrid 検索・再順位づけ・クエリの書き換え |
| 4 | 自分で判断するRAG — 検索するか、何回するかを LLM が決める |
| 5 | GraphRAG — 断片ではなく関係をたどる |
| 6 | 日本の現場 — 人に固まった知識をグラフにする |
| 7 | 長い文脈とCAG — 全部入れれば検索は要らないのか |
| 8 | エージェントが検索する — 検索の仕方そのものを学ぶ |
| 9 | LLMが検索器になる — DecisionRAG と、質問のたびに検索器を使わない検索 |
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?