Self-RAGとCRAG 検索を判断する7手法
素朴な RAG と Advanced RAG は、質問が来るたびに同じ手順で検索します。上位5件と決めたら、挨拶にも、事実を3つつながないと答えられない質問にも5件です。2022年から2024年にかけて、この「毎回同じ」を崩す手法が続けて出ました。検索するかどうか、何回するか、取ってきた結果を信じてよいかを、LLM や小さな判定モデルに判断させる手法です (CRAG の評価器と Adaptive-RAG の分類器は、どちらも T5-large を学習させたものです)。
ただし、動いたのは判断の担い手だけです。いつ判断させるか、どんな行動を選ばせるか、どこで線を引くかは、論文の著者が設計しています。LLM や判定モデルは、その枠の中で「ここは検索する」「この結果は外れ」と答えます。この章では、そういう段階を「判断の仕組みは人が設計し、判断そのものはモデルがする」と呼びます。判断の仕方まで強化学習で身につける段階は、Agentic RAG 2025年 検索を学ぶAIの章で扱います。
毎回同じ件数を検索すると何が困るか
2023年10月の Self-RAG 論文は、困りごとを1文で書いています。
indiscriminately retrieving and incorporating a fixed number of retrieved passages, regardless of whether retrieval is necessary, or passages are relevant, diminishes LM versatility or can lead to unhelpful response generation.
必要かどうかに関係なく、決まった件数を取ってきて入れる。これが3つのずれを生みます。
1つ目は要らない検索です。モデルが覚えている一般常識の質問にも検索がかかるので、答えに関係の薄い文書が文脈に混ざり、かえって回答の邪魔をすることがあります。
2つ目は足りない検索です。この章とシリーズの以降の章では、多段 (マルチホップ) という言葉を「答えにたどり着くまでに、別々の文書にある事実を2つ以上つなぐ必要がある質問」の意味で使います。例として、日本語の多段質問データセット JEMHopQA にある問いを挙げます。「東條英機が死没した施設は何という戦争の後に設置されましたか」。東條英機の記事で死没した施設の名前を知り、その施設の記事で設置の経緯を読む必要があります。2回目に何を検索すればよいかは、1回目の答えを読むまで決まりません。質問文で1回検索するだけでは、2つ目の記事に届かないことがあります。
3つ目は外れた検索です。上位に関係のない文書が来ても、確かめずに生成に渡します。
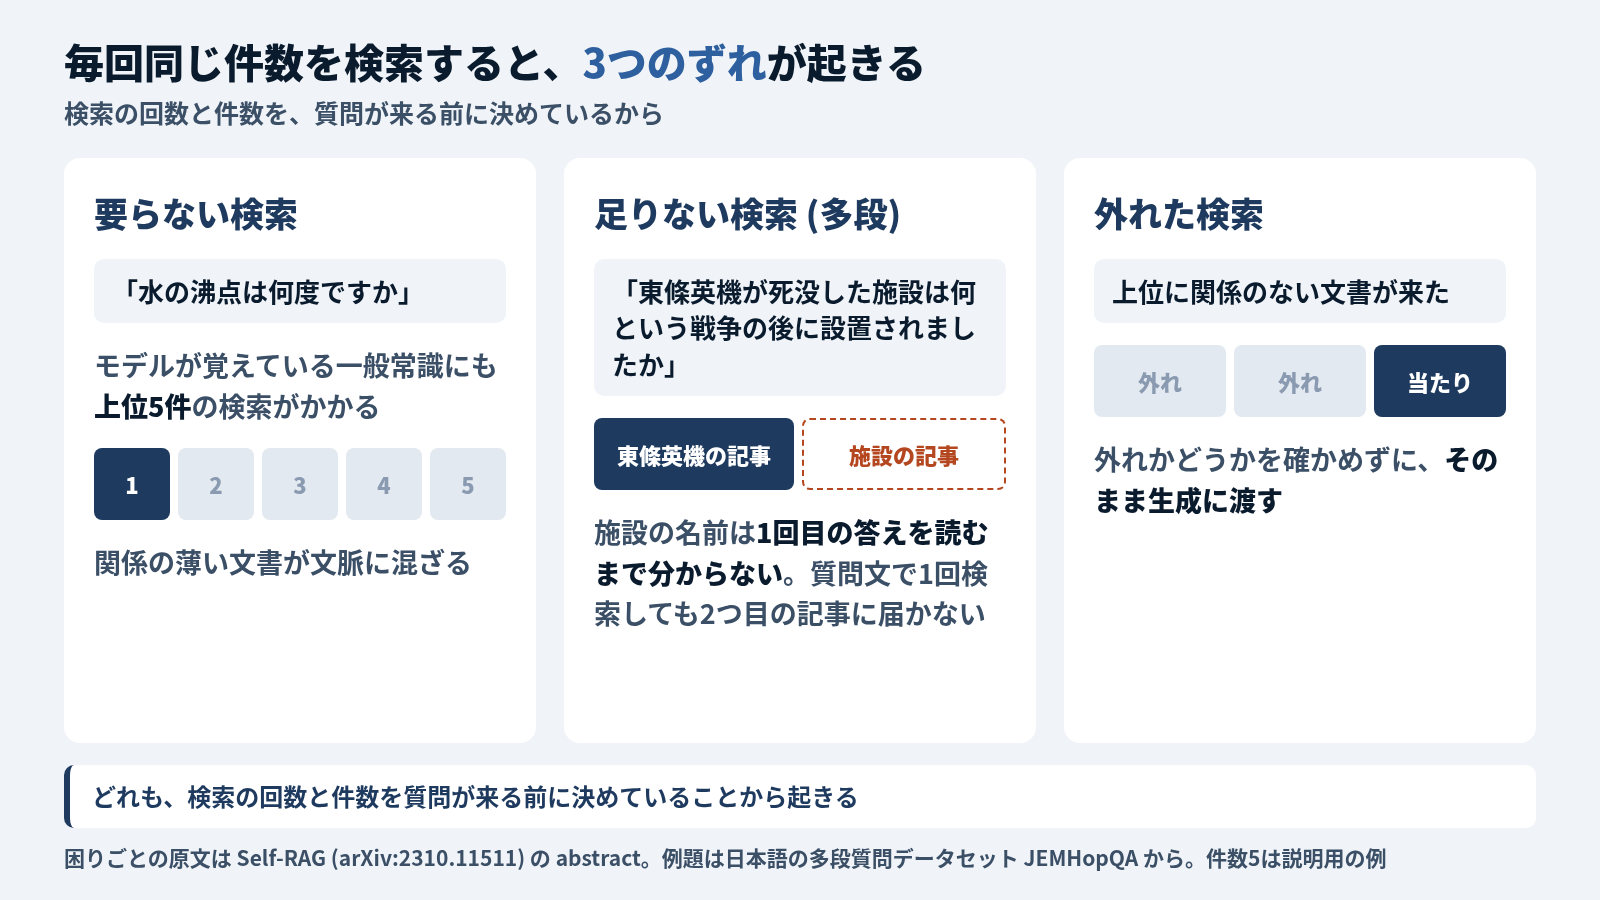
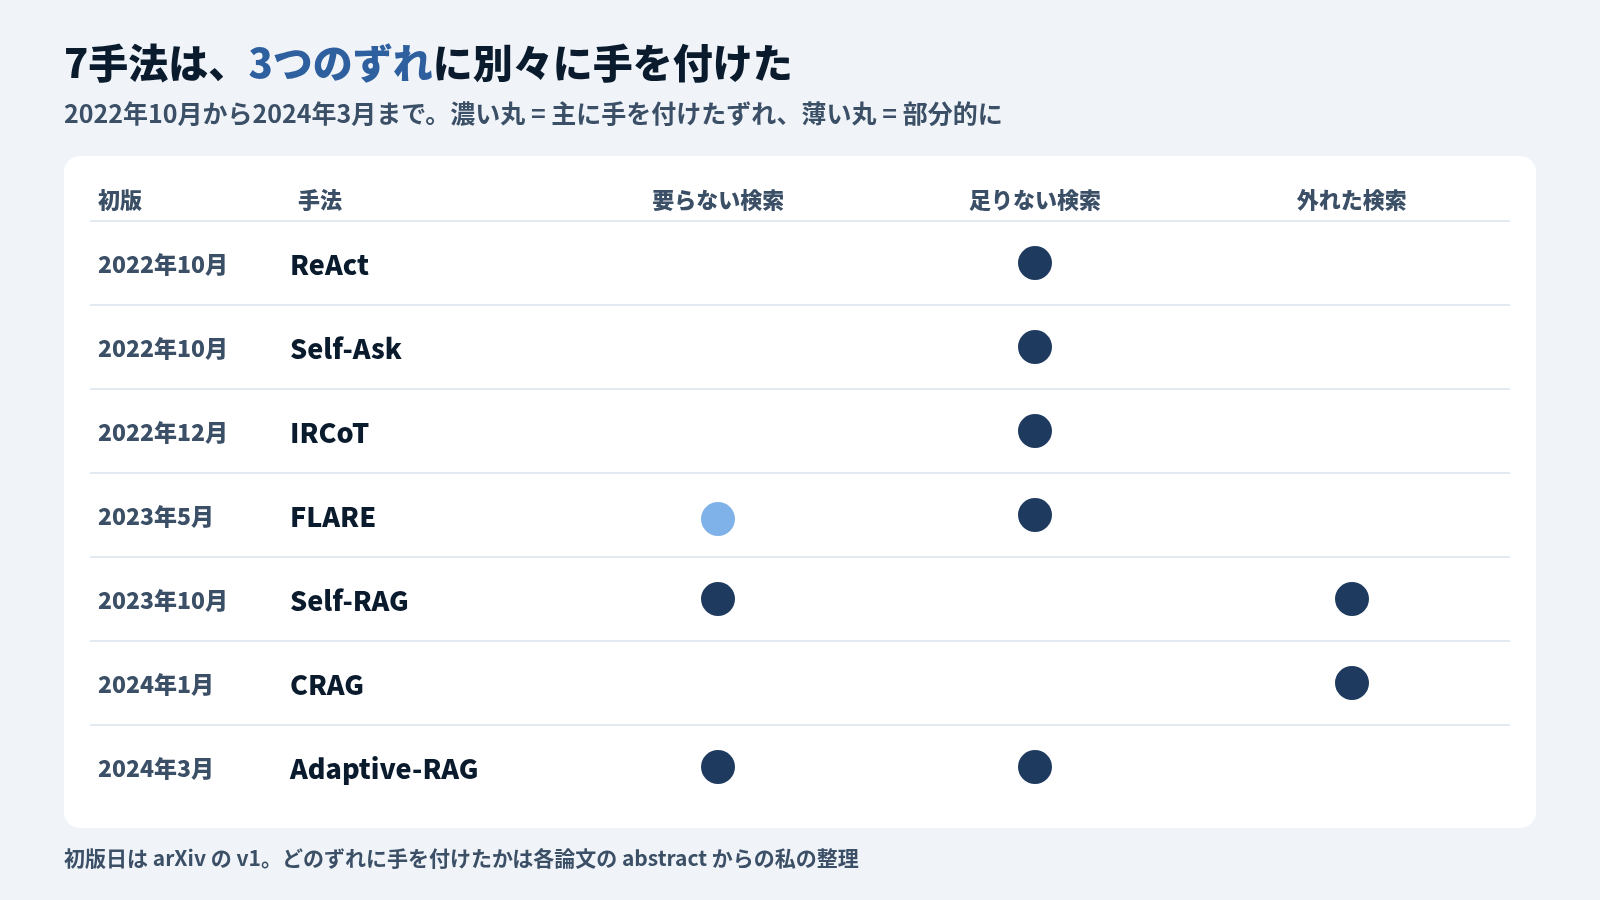
3つとも、検索の回数と件数を質問が来る前に決めていることから起きます。以下の7手法は、それぞれ別のずれに手を付けました。
2022年: 推論の途中で検索する (ReAct・Self-Ask・IRCoT)
最初に崩れたのは「検索は1回」という前提でした。2022年10月から12月にかけて、3本の論文が続きます。
ReAct (2022年10月6日、arXiv:2210.03629) は、推論の文と行動を交互に書かせます。行動は Wikipedia API の検索などです。結果を読んでから、次の推論を書きます。HotpotQA と FEVER で、思考の連鎖 (chain-of-thought) だけのときに起きる作り話と誤りの連鎖を、外部を参照することで抑えたと報告しています。
Self-Ask (2022年10月7日、arXiv:2210.03350) は、元の質問に答える前に「追加の質問」を自分で立てて答えさせます。追加の質問の答えを検索エンジンに任せると、さらに正答が増えたと書いています。この論文は、モデルが大きくなっても「部分の質問には答えられるのに組み合わせると外す」割合は縮まらない、という観察から出発しています。
IRCoT (2022年12月20日、arXiv:2212.10509) は、多段の質問の困りごとをこう書いています。
what to retrieve depends on what has already been derived, which in turn may depend on what was previously retrieved.
そこで、思考の連鎖を1文書くたびに検索します。検索語は、いま書いた1文です。GPT-3 で4つの多段データセットを測り、検索の再現が最大21ポイント、回答が最大15ポイント上がったと報告しています (論文の自己申告、ACL 2023)。
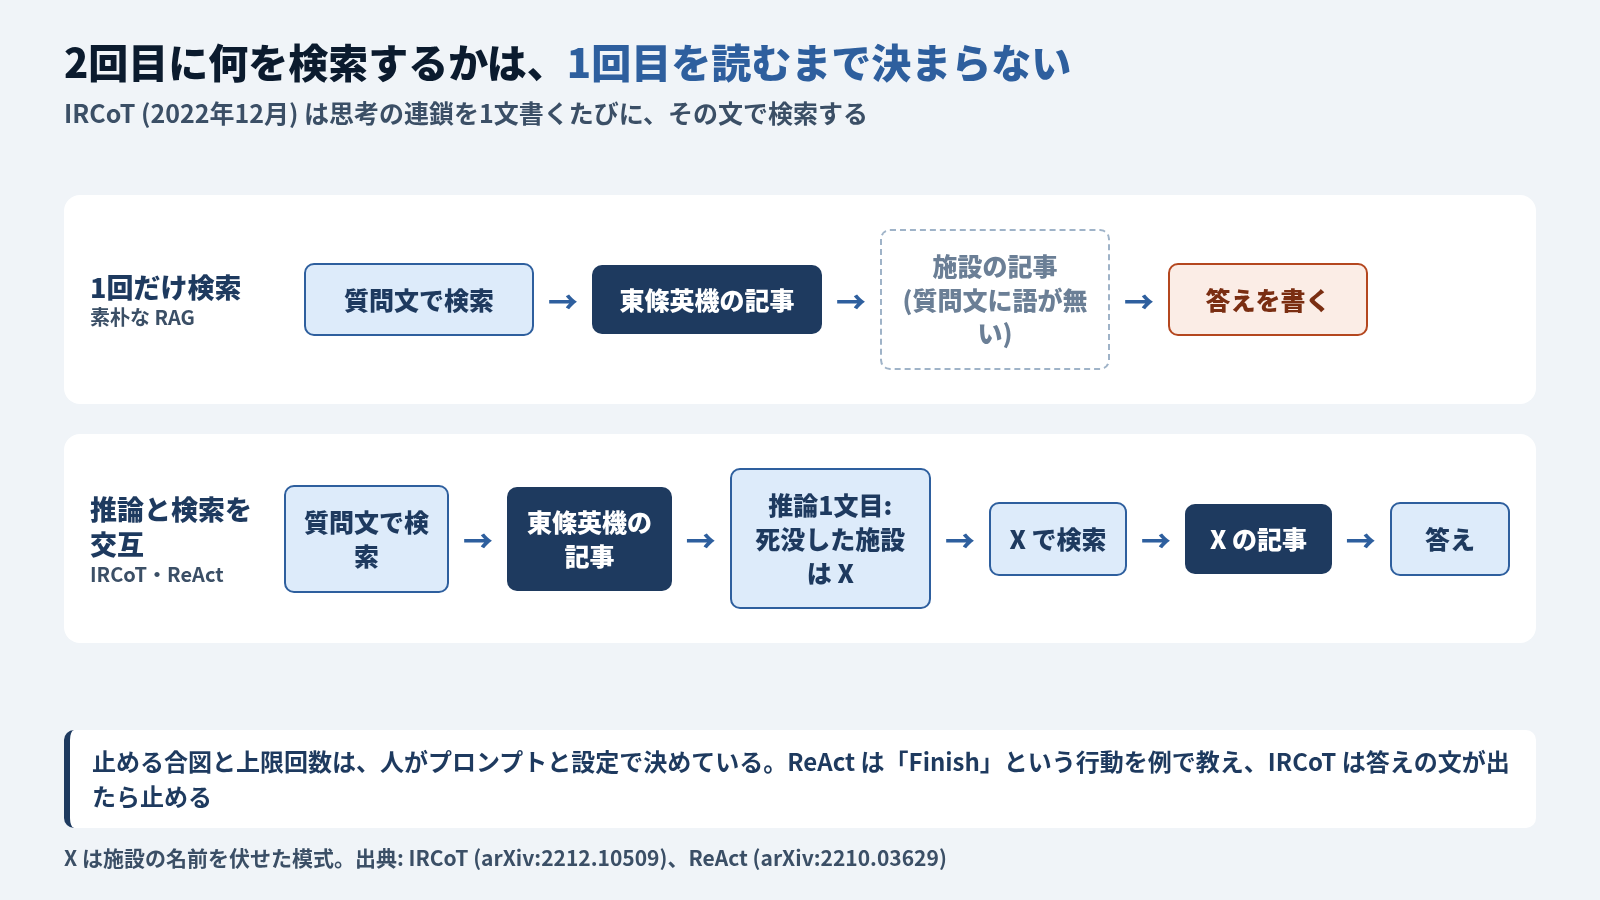
この3本で、検索の回数が質問ごとに変わるようになりました。2つ目の記事に届かないという足りない検索のずれに、正面から手を付けたことになります。ただ、止めどきはモデルの裁量ではありません。ReAct は「Finish」という行動をプロンプトの例で教えます。IRCoT は答えの文が出たら止まります。どちらにも上限の回数があります。選べる行動の種類も、プロンプトに書いた例が決めています。
2023年: 自信のない所だけ検索し直す (FLARE)
ReAct や IRCoT は、推論の1歩ごとに検索するかを考えます。長い文章でこれを続けると重い。ここは私の推論です。FLARE の論文が出発点にしたのは、別の困りごとでした。最初に1回だけ検索する RAG では、長い文章を書く途中で必要になる情報が足りなくなります。
FLARE (2023年5月11日、arXiv:2305.06983、EMNLP 2023) は、まず次の1文を仮に書かせます。その中に確率の低いトークンがあるときだけ、仮の文で検索して書き直させます。自信を持って書ける所は検索しません。
判断の材料はトークンの確率です。どこから「自信が低い」とみなすかは、人が決めたしきい値で決まります。主眼は足りない検索です。書く途中で足りなくなる情報を取りに行きます。自信のある所は検索しないので要らない検索も避ける作りですが、検索の回数がどれだけ減るかは論文の主眼ではなく、私も測っていません。外れた検索は扱っていません。
2023年: 検索するかをモデルが自分で書く (Self-RAG)
ここまでの手法は、プロンプトの工夫か確率のしきい値で判断させていました。Self-RAG (2023年10月17日、arXiv:2310.11511) は、判断を生成モデルの語彙そのものに組み込みます。
反省トークン (reflection token) と呼ぶ特別な語を4種類用意し、生成の途中でモデルに書かせます。
| トークン | モデルが答える問い |
|---|---|
| Retrieve | 今ここで検索するか |
| ISREL | 取ってきた文書は質問に関係あるか |
| ISSUP | 書いた文は文書に支えられているか |
| ISUSE | 回答全体は役に立つか (5段階) |
学習は2段階に分かれています。まず、評価役のモデル (critic) を作り、学習用の入出力データへ反省トークンを書き込ませます。次に、トークン入りのデータで生成モデル (7B と 13B) を学習させます。推論時には、Retrieve の出る確率が一定を超えたら検索し、複数の候補文を ISREL・ISSUP・ISUSE の重み付きの点数で選びます。重みは推論時に人が変えられます。
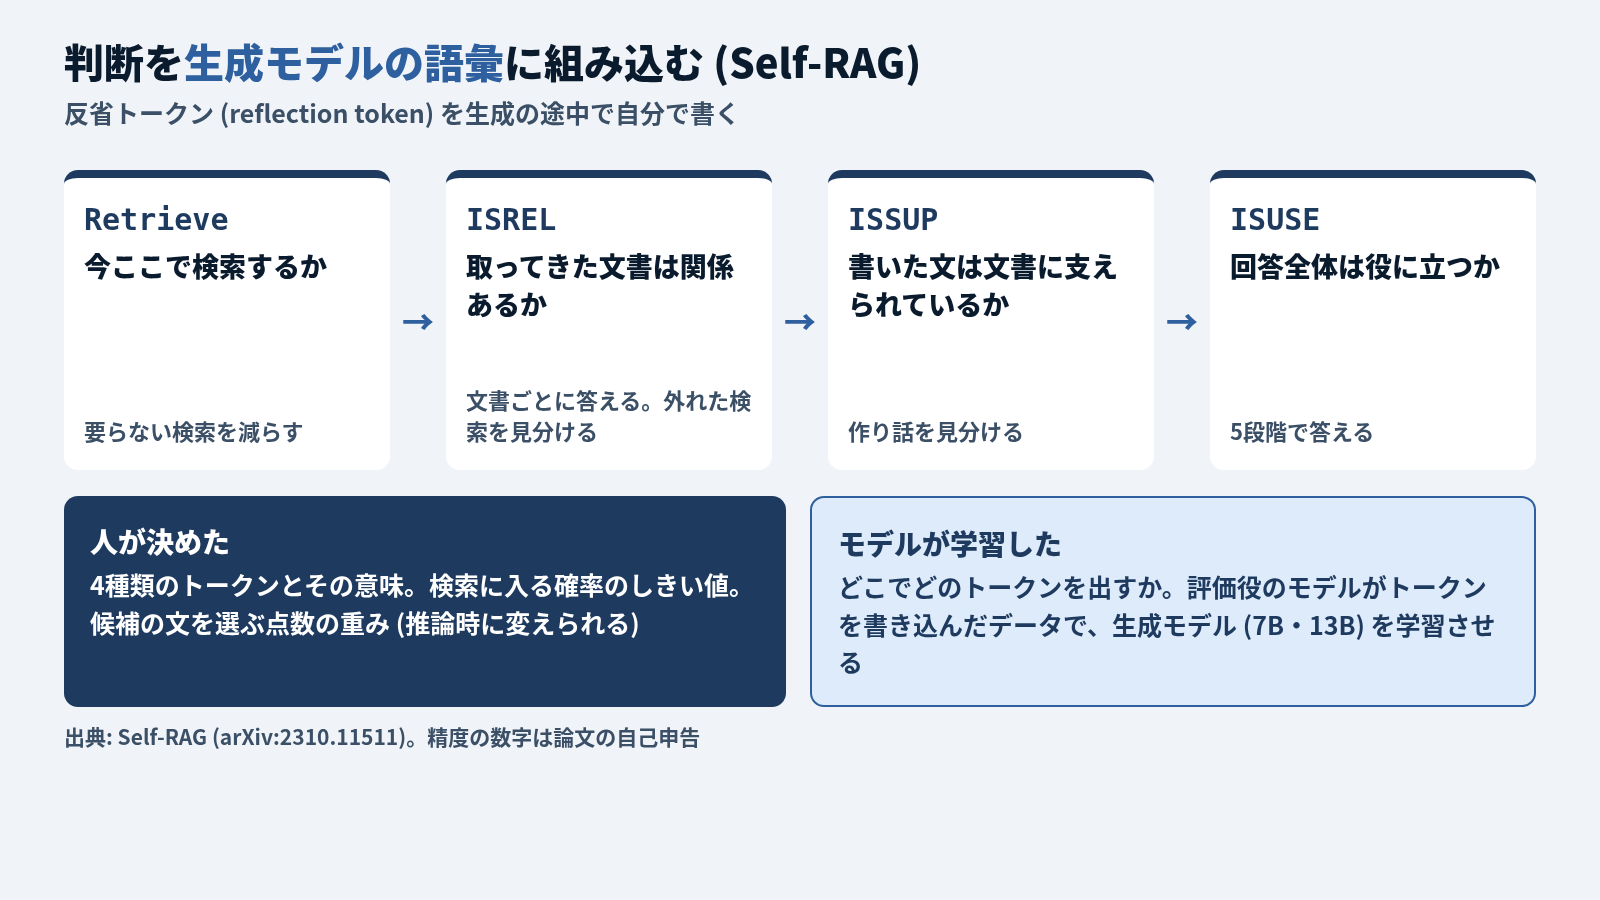
論文は、ChatGPT や検索付きの Llama2-chat を、オープンドメインの質問応答・推論・事実検証で上回ったと書いています (論文の自己申告)。ただし、全部の課題ではありません。表を見ると、TriviaQA (ChatGPT 74.3 対 Self-RAG 13B 69.3) と ARC-Challenge (75.3 対 73.1) では、ChatGPT のほうが上です。この手法で、要らない検索 (Retrieve) と外れた検索 (ISREL) の両方を、1つのモデルが自分で判断する形になりました。ただし、4種類のトークンとその意味は人が決めました。モデルが学んだのは、どこでどのトークンを出すかだけです。
2024年: 取ってきた結果を採点してやり直す (CRAG)
Self-RAG には弱点があります。生成モデルそのものを学習し直すので、API の向こうにある LLM のように重みを触れないモデルには使えません。
CRAG (Corrective RAG、2024年1月29日、arXiv:2401.15884) は、生成モデルの外に軽い評価器を置きます。評価器は質問と検索結果の組を採点し、確信度に応じて3つの行動のどれかを選びます。
- 正しいと判断したら、文書を細かく分けて要点だけを残し (分解して組み直す、と論文は呼んでいます)、生成に渡す
- 誤りと判断したら、検索結果を捨てて Web 検索に切り替える
- どちらとも言えないなら、両方を合わせて渡す
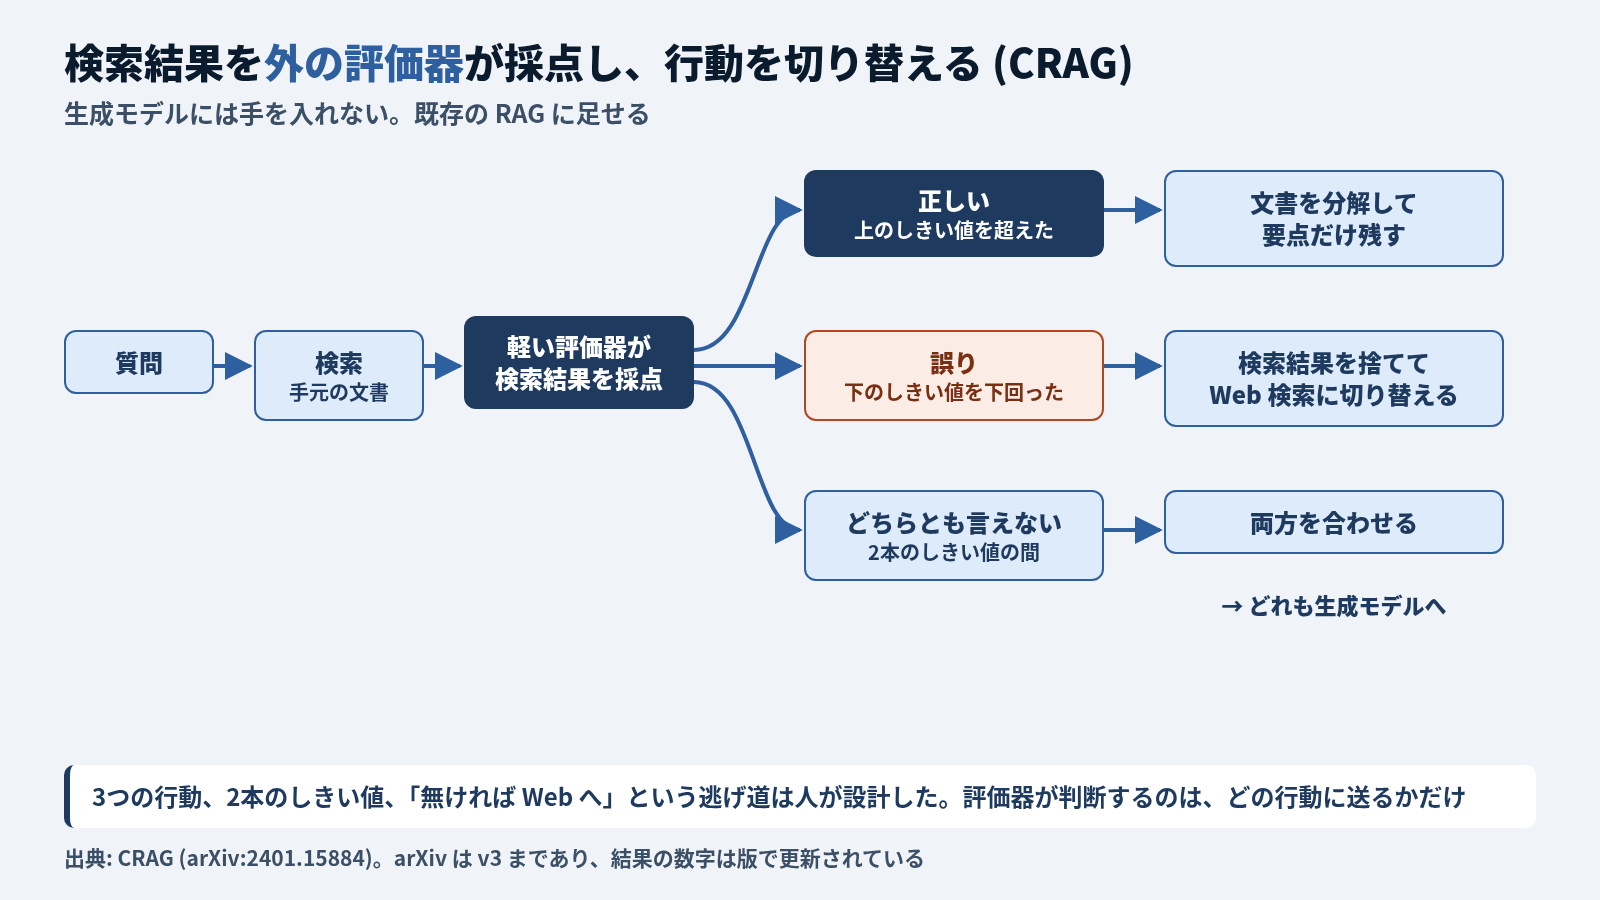
外れた検索に一番まっすぐ手を付けた手法です。既存の RAG に足せる (plug-and-play) と論文が強調している点も、実装する側には効きます。一方で、3つの行動と2本のしきい値、それに「手元に無ければ Web へ」という逃げ道は、どれも人が設計したものです。社内文書だけで答える必要がある環境では、Web 検索の分岐はそのまま使えません。なお arXiv の版は v3 まであり、結果の数字は版で更新されています。
2024年: 質問の複雑さで道を分ける (Adaptive-RAG)
ここまでの手法は、どれも「1つの方式を賢くする」方向でした。Adaptive-RAG (2024年3月21日、arXiv:2403.14403、NAACL 2024) は、方式を3つ並べて、質問ごとにどれに乗せるかを選びます。
- A: 検索しない (LLM の記憶だけで答える)
- B: 1回検索する
- C: 反復して検索する (IRCoT 型)
振り分けるのは、小さな言語モデル (T5-large) を学習させた分類器です。学習用のラベルは人手で付けていません。実際に A・B・C で解かせて一番簡単に正解できた方式を正解ラベルにし、どれでも解けなかった質問は、元のデータセットが1段か多段かでラベルを補います。
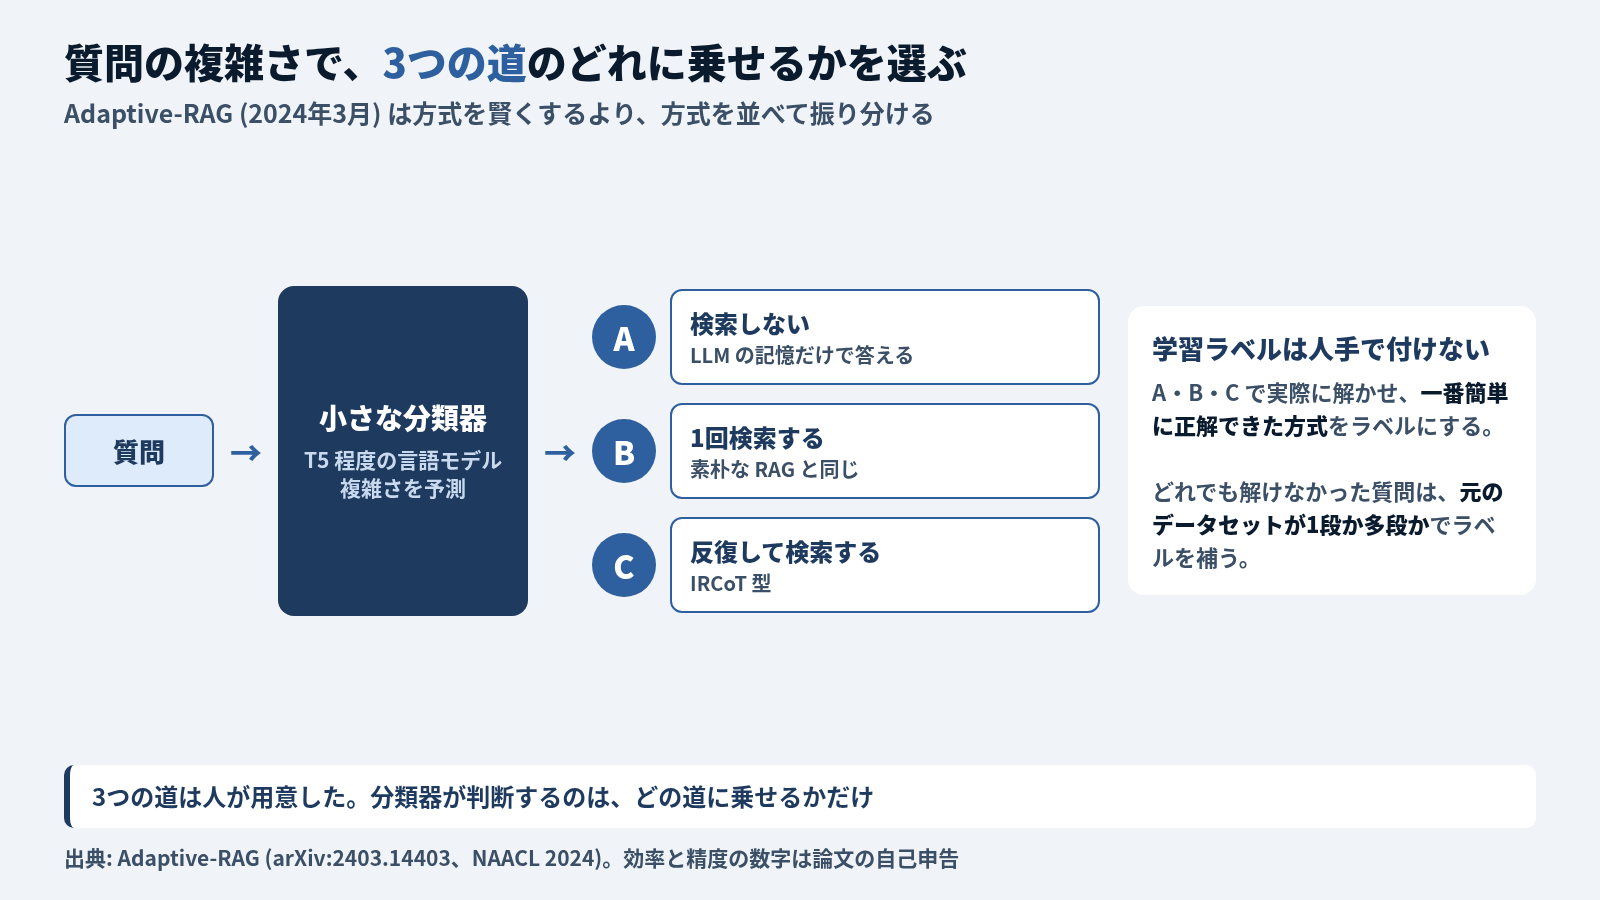
要らない検索と足りない検索を、1つの仕組みで両側から減らす設計です。論文の abstract も、簡単な質問に余計な計算をかけることと、複雑な質問を1回の検索で済ませることの両方を問題として挙げています。
判断の仕組みは人が設計し、判断そのものはモデルがする
7手法を並べると、きれいに分かれます。モデルに任せたものと、人が握ったままのものです。
| 手法 | 初版 | LLM (または小さなモデル) が判断すること | 人が設計していること | 追加の学習 |
|---|---|---|---|---|
| ReAct | 2022-10 | 次に検索するか、何で検索するか | 使える行動、止める合図、上限回数 | 不要 |
| Self-Ask | 2022-10 | 追加の質問を立てるか | 書式 (追加の質問と答え) | 不要 |
| IRCoT | 2022-12 | 1文ごとの検索語 | 毎文検索する、上限回数 | 不要 |
| FLARE | 2023-05 | 書き直す箇所 | 確率のしきい値 | 不要 |
| Self-RAG | 2023-10 | 検索するか、文書は関係あるか、文は支えられているか | 4種類のトークンと意味、しきい値、重み | 生成モデル |
| CRAG | 2024-01 | 検索結果の良し悪し | 3つの行動、しきい値、Web 検索 | 評価器 |
| Adaptive-RAG | 2024-03 | 質問の複雑さ | 3つの道 | 分類器 |
右から2列目が空の手法はありません。2024年7月の Modular RAG (arXiv:2407.21059) は、RAG を組み替えのきく部品の集まりとして扱う枠組みを提案した論文で、RAG の流れを線形・条件・分岐・ループの4つの型で整理しました。この章の手法は、条件・分岐・ループを人が組み、その分岐点で LLM に答えさせたもの、と読めます。
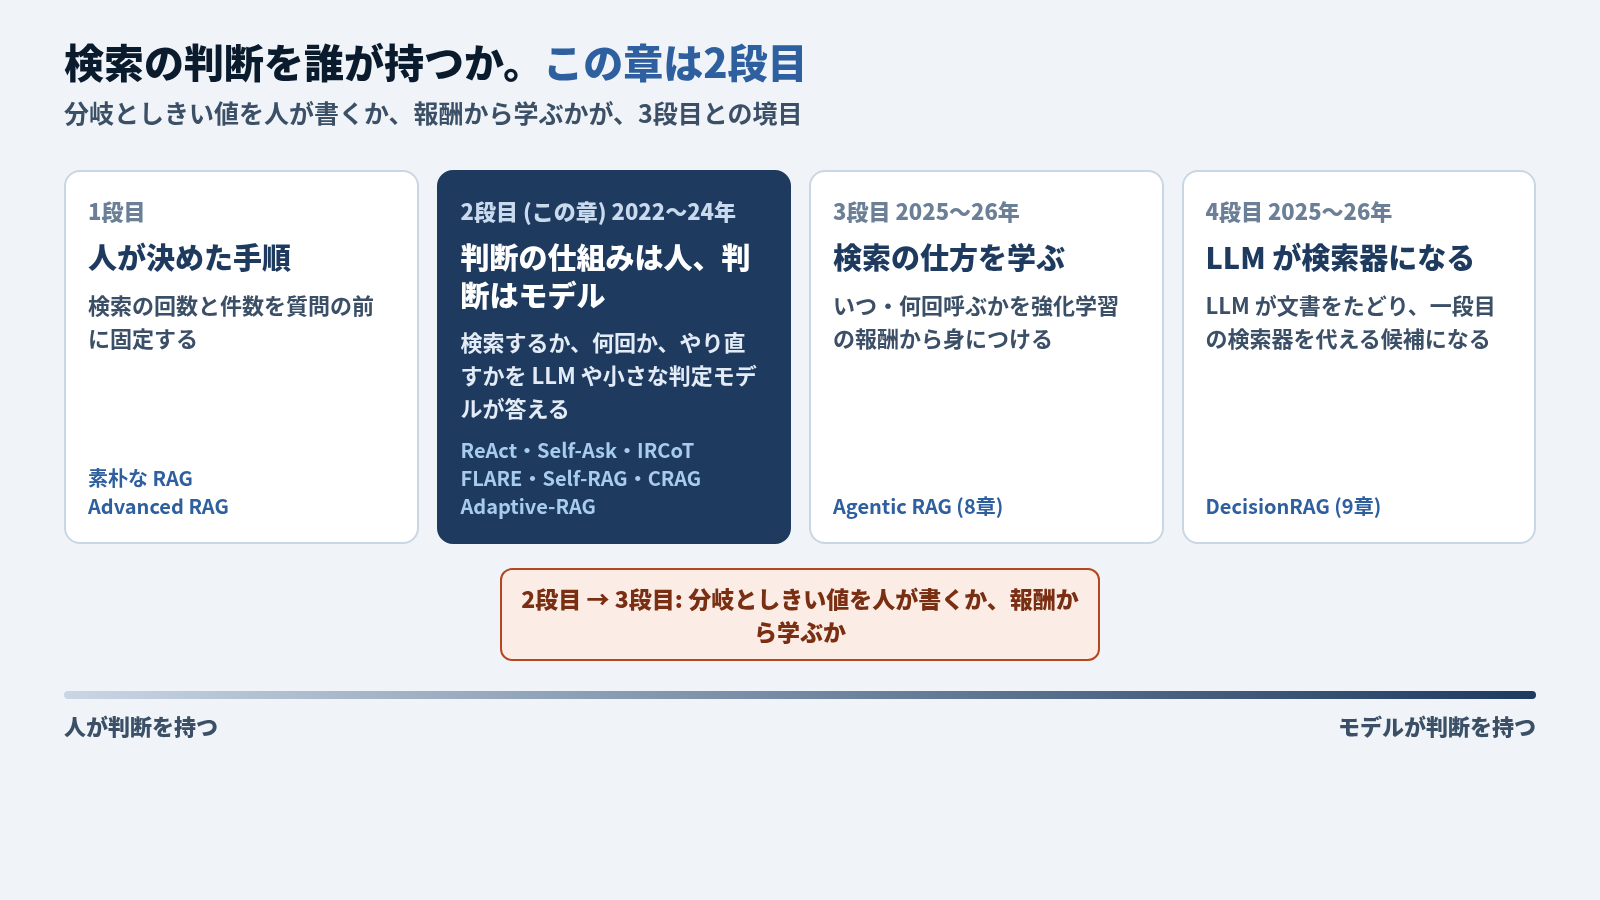
ここが Agentic RAG の章で扱う段階との境目です。2025年以降の Search-R1 なども、検索を呼ぶ道具を渡す点は同じです。違うのは、いつ・何回呼ぶかの決め方です。人が書いた分岐やしきい値を使わず、正解したかどうかの報酬から学びます。この章の手法は、判断の回数や場所を人が先に決めています。挙動は読みやすく、壊れたときの原因も追えます。その代わり、設計者が想定しなかった形の質問には、用意された道のどれかで答えるしかありません。
もう1つは呼び出しの回数です。判断を挟むたびに LLM か評価器を1回ずつ呼ぶことになるので、多段の質問ほど、質問1つあたりの遅延と費用は増えます。Adaptive-RAG が最初に分類器を置くのは、この増え方を抑えるためでもあります。手元で測ってはいないので、どれだけ増えるかは私には言えません。
2026年: 判断を部品として見直す動き
Adaptive-RAG の「質問ごとに道を選ぶ」考え方は、2026年に入って別の形で戻ってきています。
Retriever Portfolios (2026年5月29日、arXiv:2605.31176) は、副題に「Adaptive RAG への原理的なアプローチ」と掲げています。Adaptive-RAG が「検索しない・1回・反復」の3つから選んだのに対し、こちらは候補の検索器の中から少数の組み合わせを選んでおき、質問ごとにどれを使うかを振り分けます。要旨では、検索器1つの場合より検索の指標と回答の質の両方で上回ったと書いています。論文の自己申告です。
もう1つは、判断そのものを部品として切り出す動きです。個人開発の OSS JevRAG (GitHub、MIT、2026年9月公開) は、RAG の途中の判断を「状態 → 判断 → 確信度 → 行動」の形にそろえています。証拠が足りているか (足りなければもう1回探す)、答えずに保留するか、といった判断を差し替えのきく部品にして、確信度が実際の当たり外れと合っているか (較正) まで評価する作りです。この章の Self-RAG や CRAG がモデルや評価器の中に持っていた判断を、外に出して測れるようにした、と読めます。2026年11月4日の時点で GitHub のスターは6個で、広く使われている段階ではありません。
どちらも「判断の仕組みは人が設計し、判断を機械がする」という、この章の枠の中にあります。名前に「decision」を掲げる例が増えていますが、DecisionRAGとは 2026年の新検索手法 の章で扱う DecisionRAG は、一段目の検索器を代える候補として出てきた検索手法で、この節の2つとは別物です。
日本では
Self-RAG や CRAG を名指しで採用した国内の公開事例は、私が探した範囲では見つかりませんでした。解説記事はあります。けれども、どの手法をどの業務に入れてどうなったかを一次資料で書いた事例となると、国内の公開事例は乏しいです。
近い考え方を製品として出している例はあります。JAPAN AI は2025年4月28日に、回答の正当性を自ら検証する「Agentic RAG」で正答率 82.7% を出したと発表しました (プレスリリース)。約300問の正答率で、比較相手は「主要クラウドベンダー」とだけ書かれた A社 51.2%・B社 71.4% で、社名は伏せられています。採点は、複数の LLM で模範解答との意味の近さを見る指標だと書かれています。ベンダーの自社評価です。質問の中身も比較相手も公開されていないので、他の数字とは並べられません。仕組みの詳細も書かれていないため、この章の7手法のどれに近いのかも、外からは判断できません。
次に読む
この章の手法は、検索の回数ややり直しを増やして、2つ目の記事に届こうとしました。逆に、索引を作る段階で文書どうしのつながりを先に持たせておく方向があります。GraphRAG 系譜とベクトル検索との実測比較に進んでください。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?