検索拡張生成RAGの原論文 2017〜22年
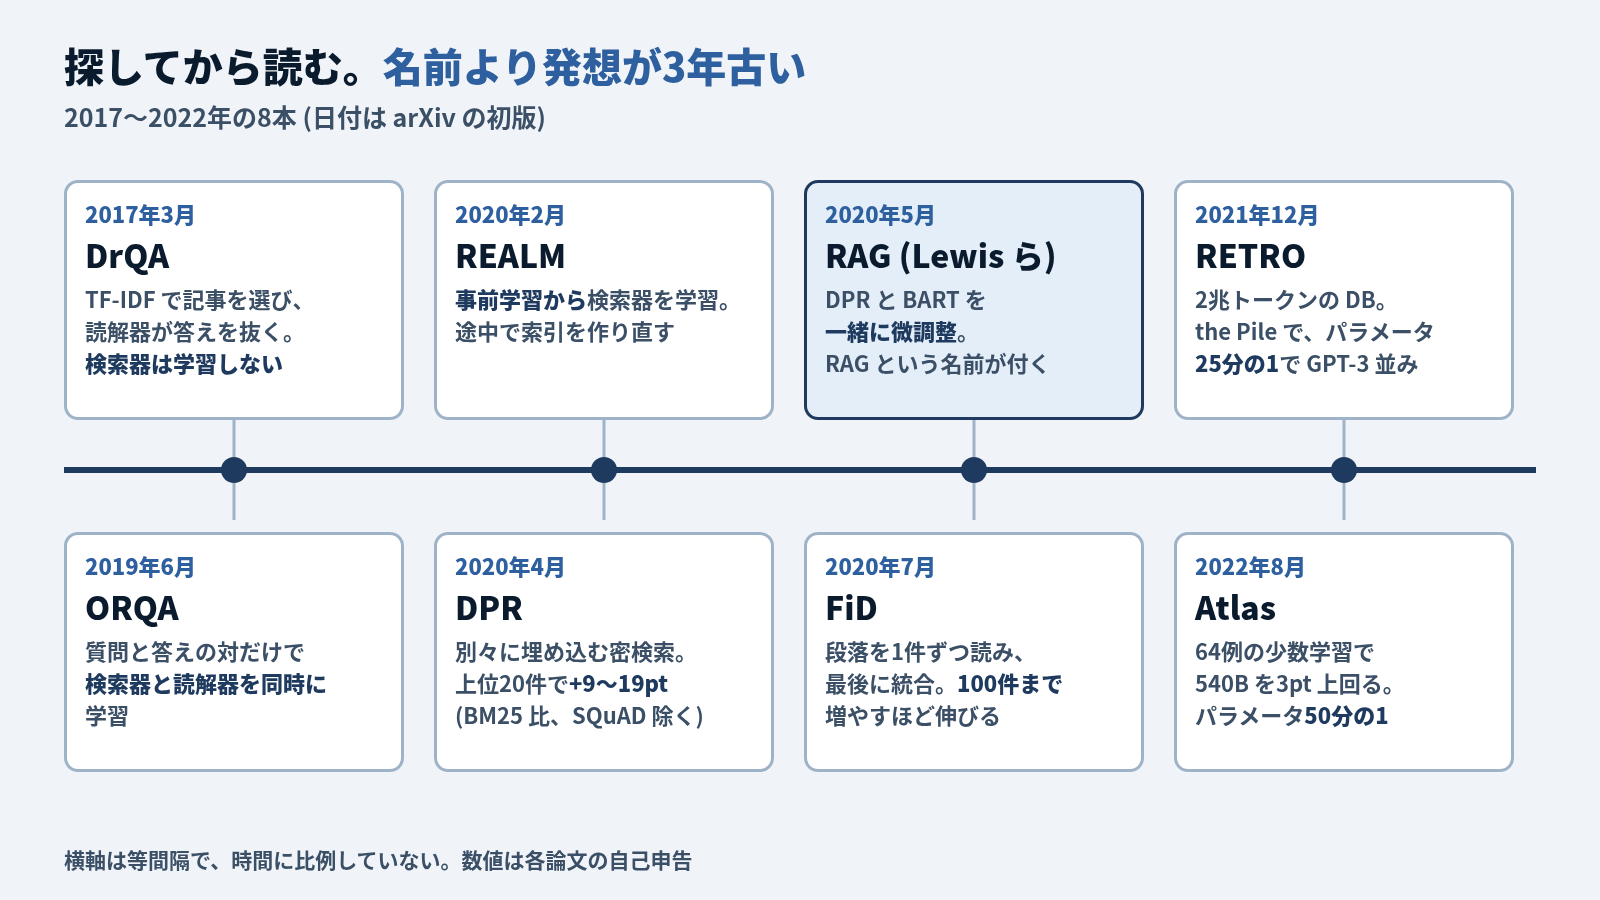
RAG (Retrieval-Augmented Generation、検索で補強した生成) という名前は、2020年5月の Lewis らの論文で付きました。筆頭著者は、当時ロンドン大学の博士課程にいながら Meta の研究室で働いていた Patrick Lewis さんです (どんな人かは、後半のコラムで紹介します)。けれども「先に Wikipedia から探して、それを読んで答える」という分担は、2017年の DrQA からすでにありました。
名前より、発想のほうが3年古いのです。
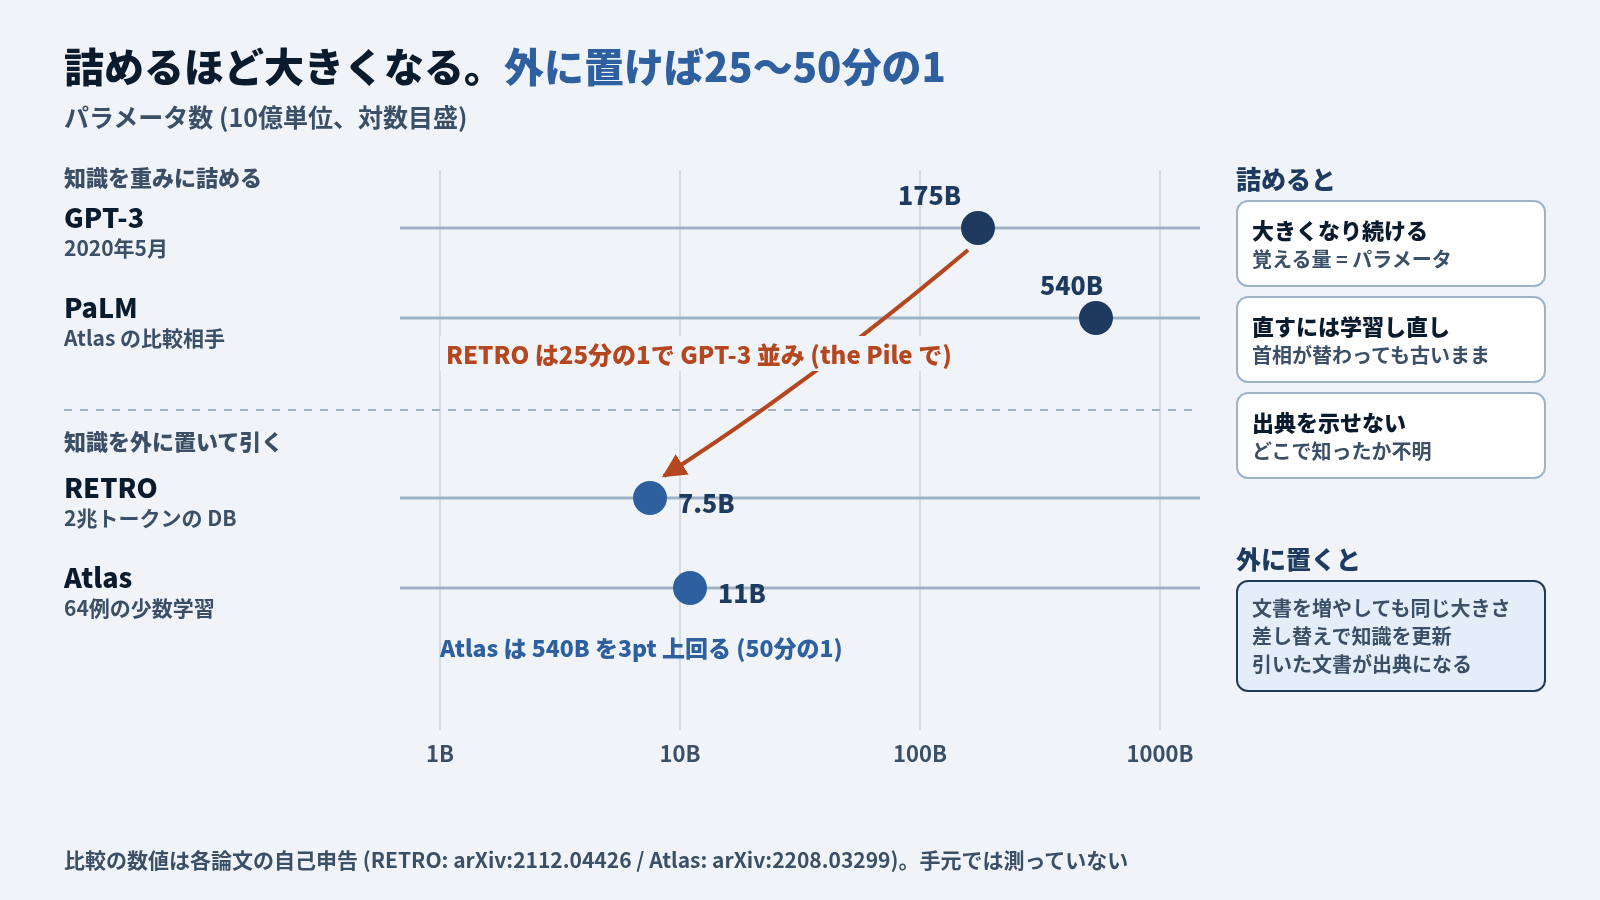
この時代の研究が解こうとしていた困りごとは1つです。知識をモデルのパラメータに詰め込むと、モデルが大きくなり続けます。 直すには学習し直すしかなく、どこで知ったのかも示せません。そこで知識をモデルの外の文書に置き、必要なときに探して読ませる方向が出てきました。質問が来たら関係する文書を検索で探し、それを読んで答える「検索して読む」方式です。RAG の論文の言葉でいえば、モデルの重みに入った記憶 (パラメトリック記憶) に、外に置いた文書という記憶 (ノンパラメトリック記憶) を組み合わせる方式で、これがのちに RAG と呼ばれます。
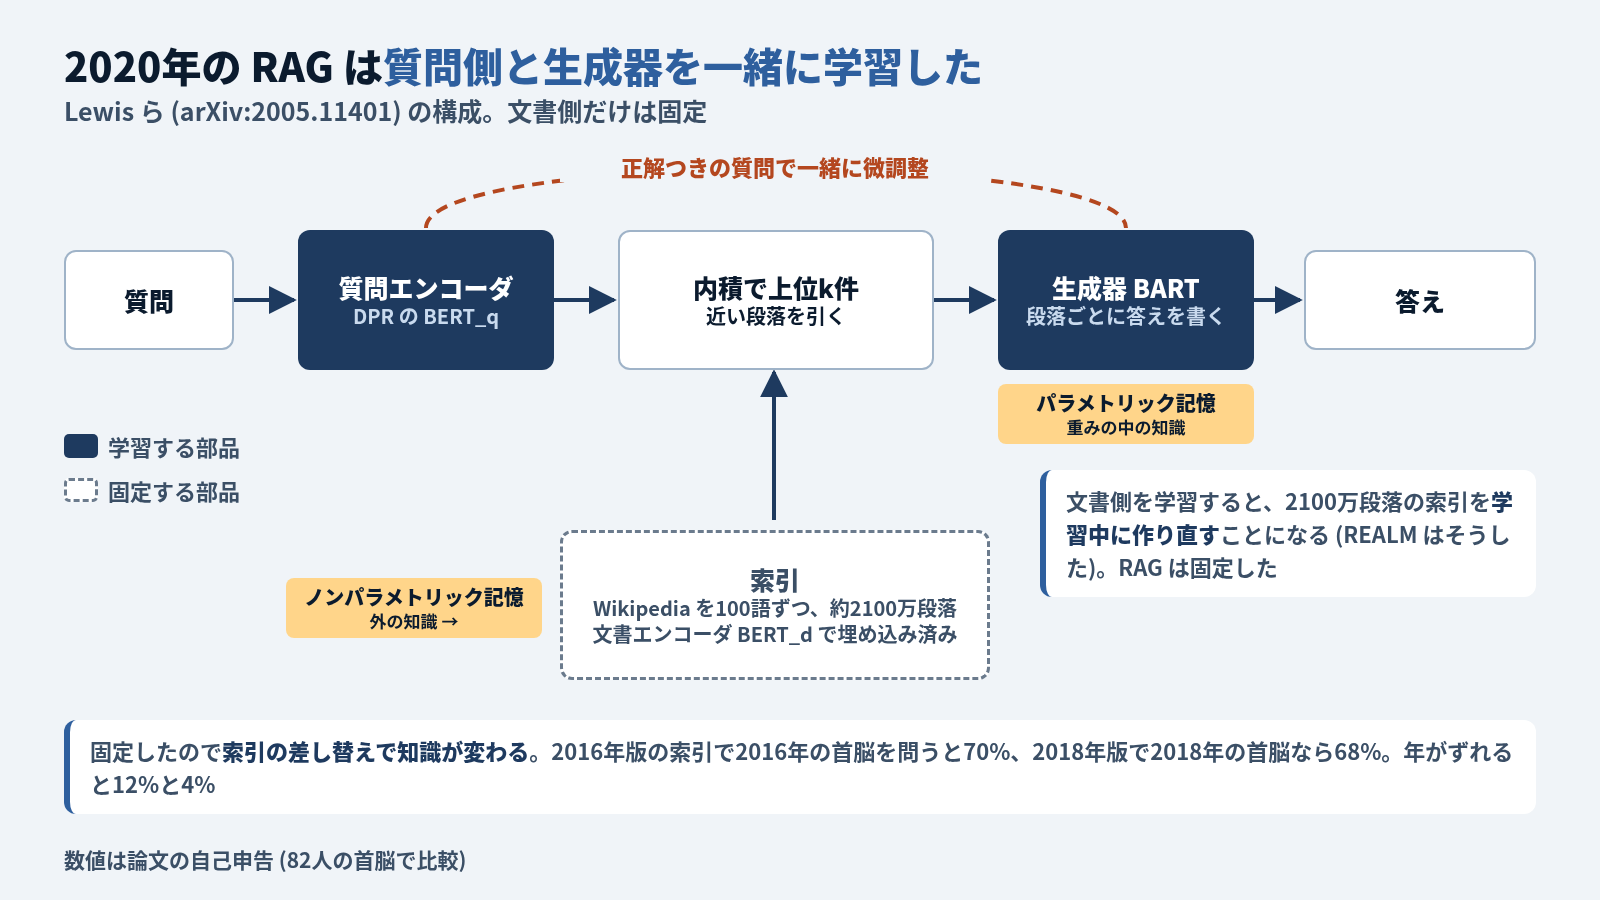
もう1つ、今の RAG と決定的に違う点があります。原論文の時代は、検索器と生成器を、正解つきの質問で一緒に学習していました。 どの文書を引けば正解に近づくかを、検索器そのものが学んでいたのです。機械学習の分類でいえば教師あり学習です。ただし正解として渡すのは質問と答えの組だけで、「どの文書を引けばよいか」の正解は渡しません。検索器は、引いた文書で答えが合ったかどうかから間接的に学びます。ORQA の論文は、これを弱い教師あり (weakly supervised) と呼んでいます。この「一緒に学習する」をやめたことが、2022年以降に RAG が一気に広まる理由になります。
困りごと: 知識をパラメータに詰めると、モデルが大きくなり続ける
2020年5月28日に出た GPT-3 の論文は、パラメータ数1750億のモデルが、例を数個見せるだけで多くの課題をこなせることを示しました (arXiv:2005.14165)。事実の知識もその重みの中に入っています。
この方式には弱点が3つあります。
- 大きくなり続ける。 覚える事実を増やすには、パラメータを増やすのがいちばん素直な道です
- 直せない。 首相が交代しても、重みを学習し直すまで古い答えを返します。2006年から6年続けて首相が替わった一時期の日本なら、学習し直しが毎年の行事になっていたところです
- 出典を示せない。 答えがどの文書から来たのか、モデル自身にも分かりません
Lewis らの RAG 論文も、冒頭で同じ問題を挙げています。大きな言語モデルは事実を覚えてはいるが、知識に正確に触れて操作する力は限られ、判断の出所を示すことと知識の更新は未解決のままだ、という問題提起です (arXiv:2005.11401)。外に置けば、3つとも変わります。文書を増やしてもモデルは大きくならず、文書を差し替えれば知識が更新され、引いた文書を見せれば出典になります。この方向で、どれだけパラメータを減らせたかを報告したのが、後半に出てくる RETRO と Atlas です。
2017年 DrQA: 探してから読む
DrQA は Facebook AI Research の Chen らが2017年3月に出したシステムで、Wikipedia 全体を知識源にして質問に答えます (arXiv:1704.00051、ACL 2017)。
仕組みは2段です。まず検索器が、質問と語 (単語と、2語の連なり) の重なりが大きい記事を TF-IDF (文書に多く出て、ほかの文書には少ない語ほど重く数える点数) で選び、次に読解器が選ばれた記事の中から答えの箇所を抜き出します。
TF-IDF は、語の重みを2つの掛け算で決めます。その記事の中で何回出るか (TF) と、全記事のうちその語が出る記事がどれだけ少ないか (IDF) です。「姉川」は姉川の戦いの記事に何度も出て、ほかの記事にはほとんど出ないので重くなります。「戦った」のようにどの記事にも出る語は、ほぼ0になります。
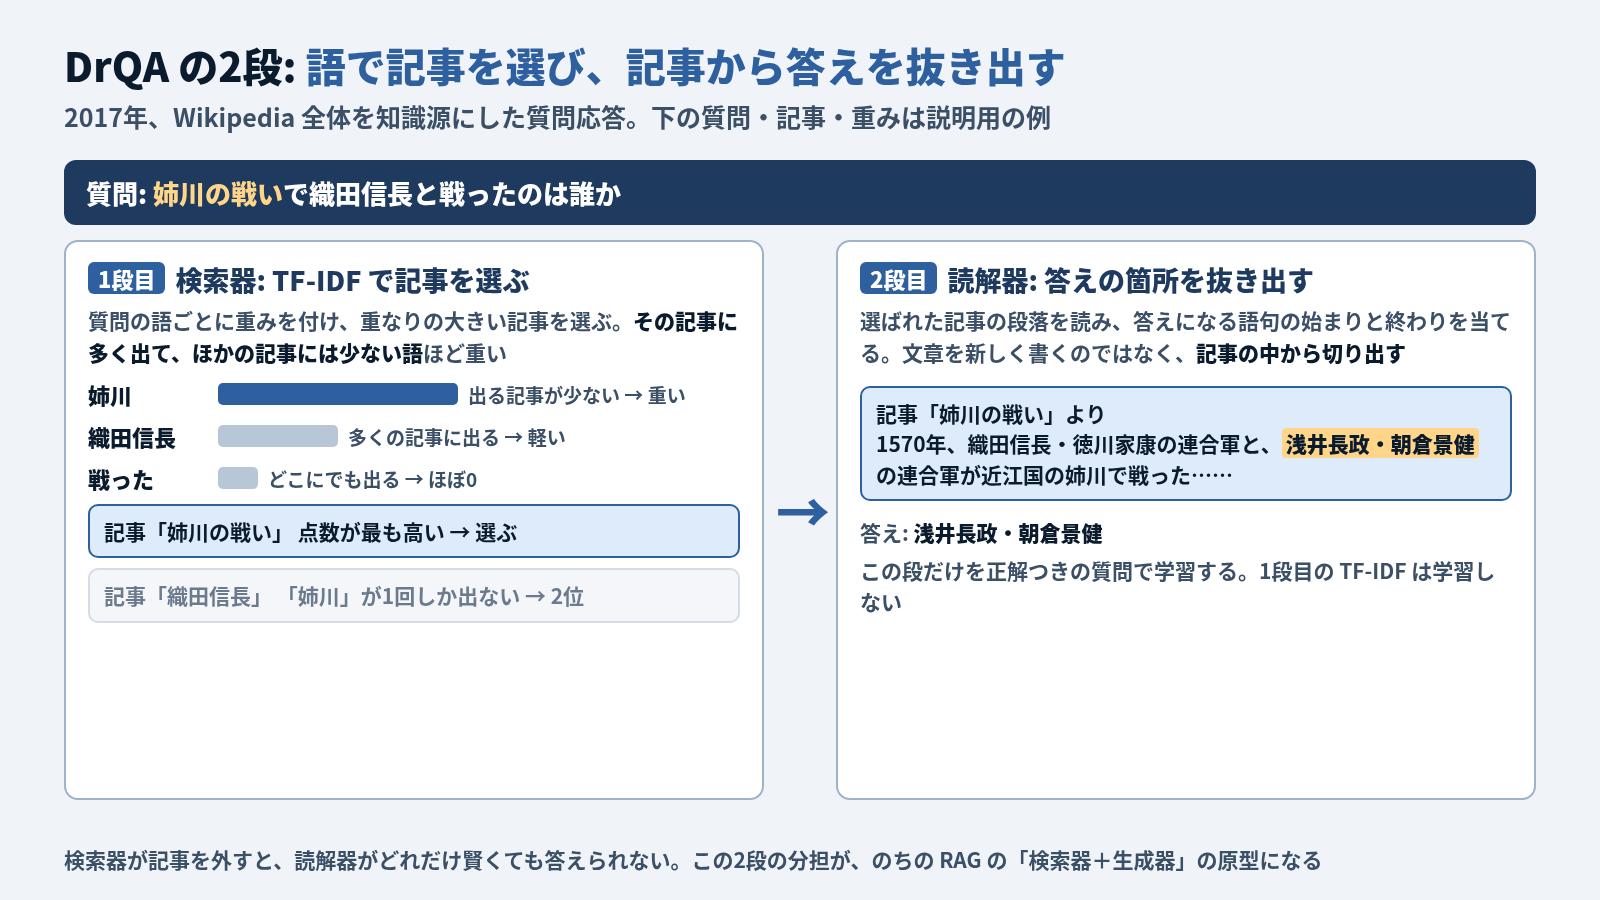
検索器は語の出現回数を数えるだけの古典的な方法で何も学習しておらず、学習するのは読解器だけでした。言い換えると、検索の質は読解器からは変えられません。 検索器が正解の記事を取りこぼせば、読解器がどれだけ賢くても答えられません。次の2年間の研究は、ここを崩しにいきます。
2019〜20年 検索器そのものを学習する: ORQA・REALM・DPR
ORQA (2019年6月)
Google の Lee らの ORQA は、どの段落を引くかを「正解からは見えない途中の選択」(潜在変数) として扱い、検索器と読解器を質問と答えの対だけで同時に学習しました (arXiv:1906.00300、ACL 2019)。どの段落が根拠かという正解は与えません。答えに辿り着けた段落が結果として良い検索結果として学ばれます。ゼロから学ぶのは難しいので、検索器は先に ICT (文を1つ抜き出し、それが元あった段落を当てる課題) で事前学習しています。質問者が答えを知らずに尋ねるデータセットでは BM25 (TF-IDF を改良した、語の重なりで点数をつける古典的な検索) を完全一致率で最大19ポイント上回った、と論文は報告しています。答えを知っている人が作った問題なら BM25 で足ります。
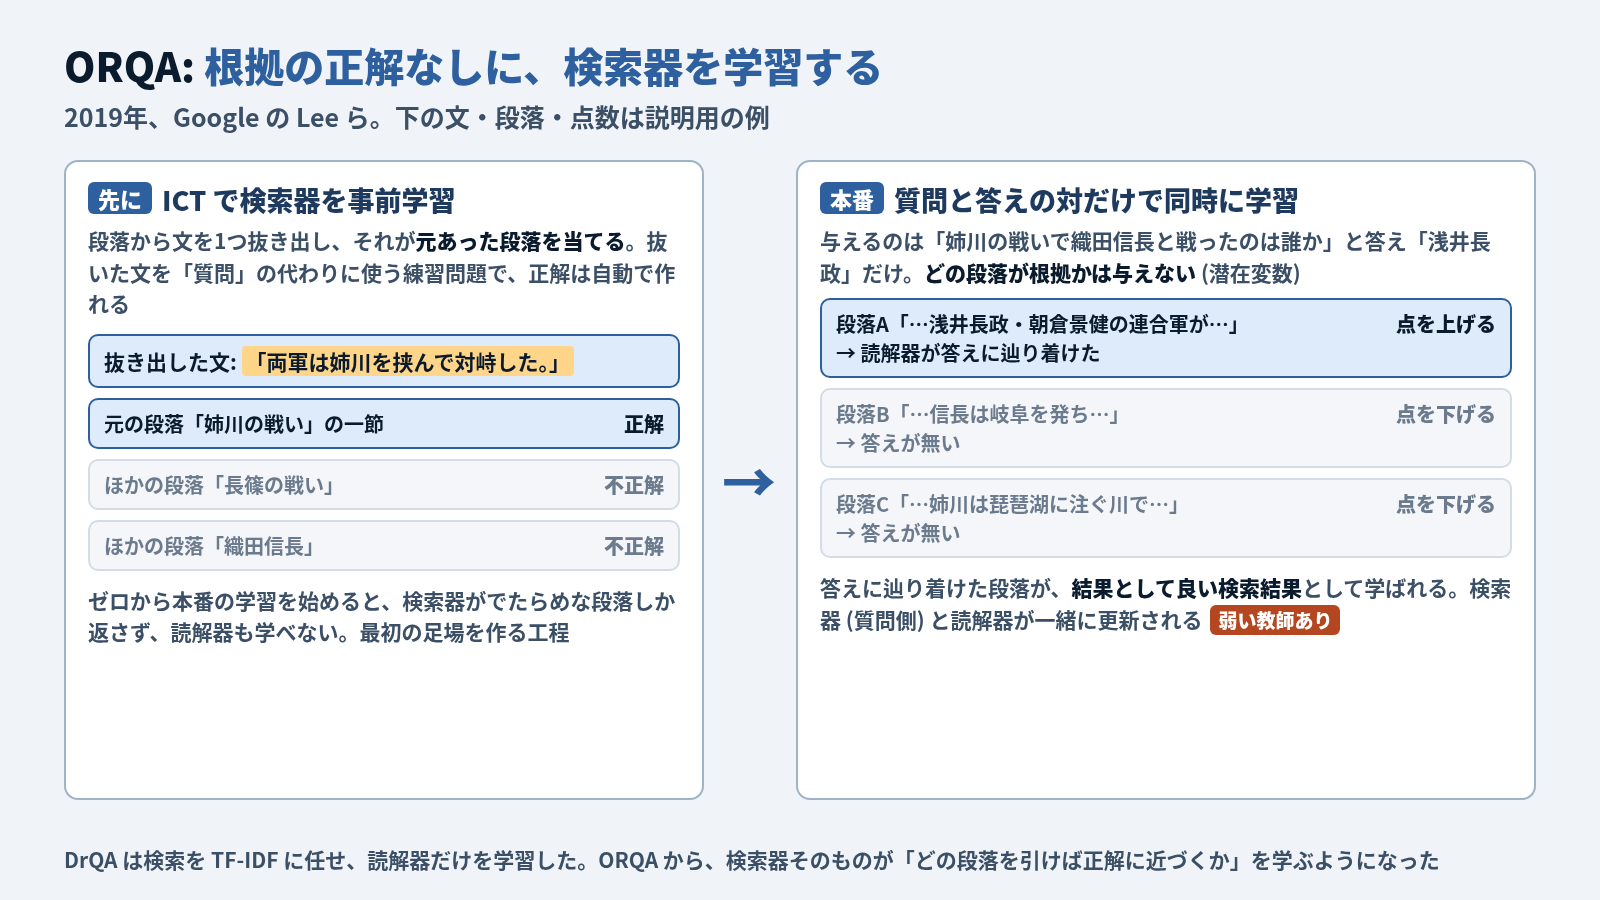
では、答えの文字列を含む段落が上位にいくつもあったらどうするのか。ORQA は、上位の段落の中で答えと一致する箇所をすべて拾い、全部を正解への道筋として点数を足し合わせて学習します (正しい道筋すべての確率の合計を大きくする)。どれが本当の根拠かは区別しません。
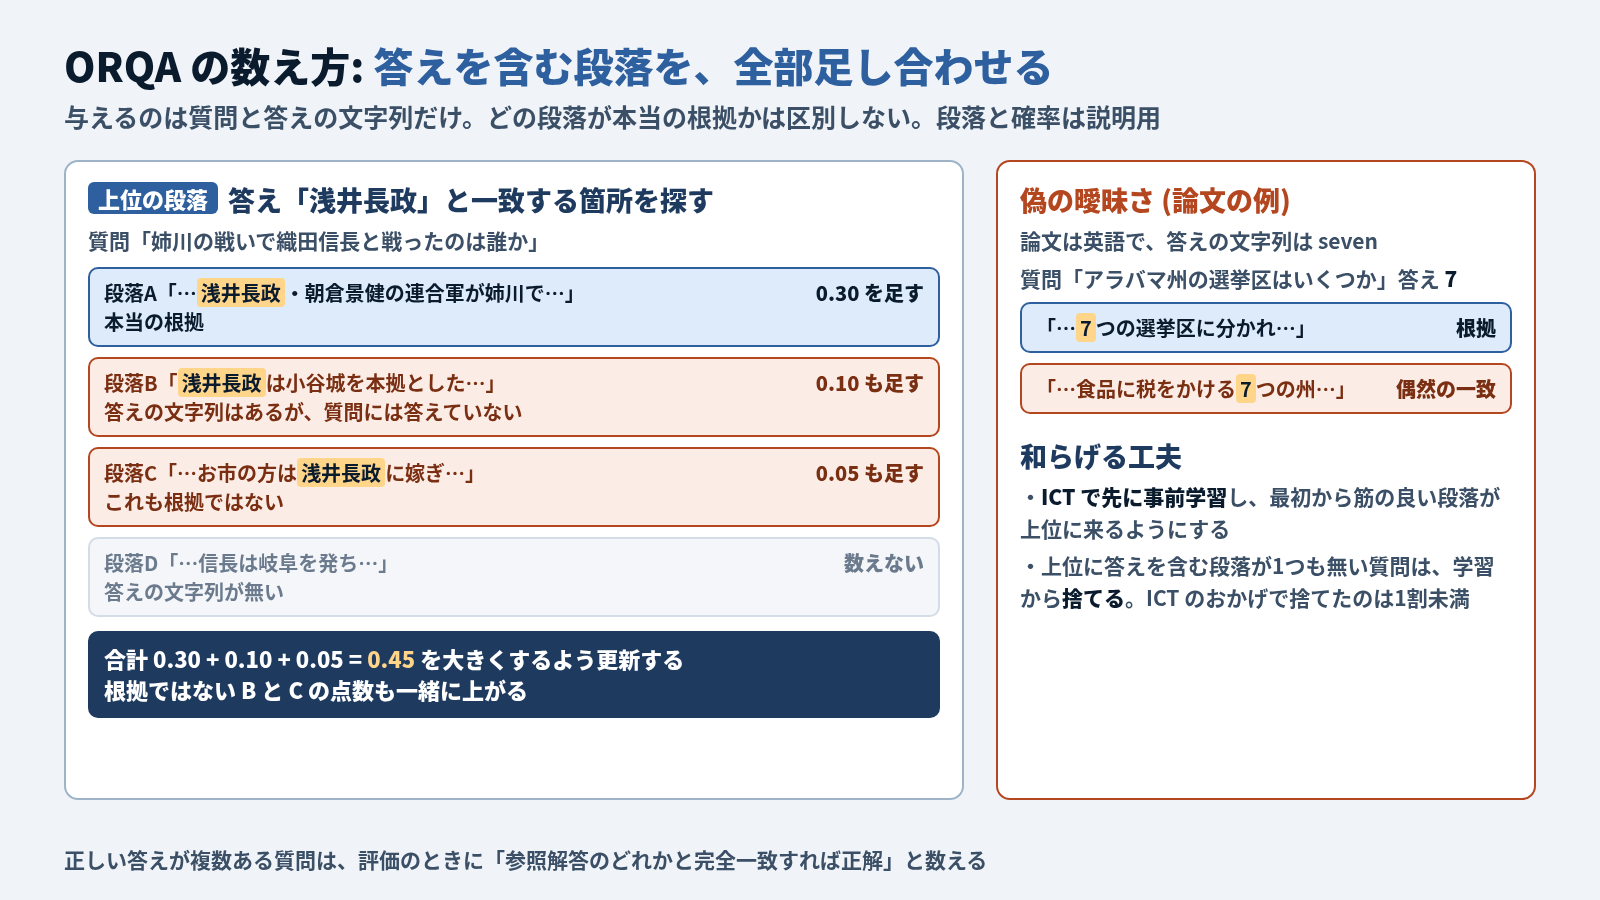
ここに弱点があります。論文自身が「偽の曖昧さ」(spurious ambiguity) と呼んで例を挙げています。質問「アラバマ州の選挙区はいくつか」の答えは「7」です (論文は英語なので答えの文字列は seven)。ところが「アラバマは食品に税をかける7つの州の1つ」という無関係な段落にも同じ「7」が出てくるので、これも正解扱いになります。姉川の例でいえば、「浅井長政は小谷城を本拠とした」のような、質問に答えていない段落まで一緒に点が上がるということです。
これを和らげているのが、先に済ませておく ICT の事前学習です。最初から筋の良い段落が上位に来るので、偶然の一致に引っ張られにくくなります。上位に答えを含む段落が1つも無い質問は、学習から捨てます。論文によると、ICT のおかげで捨てたのは1割未満でした (でたらめな初期値から始めれば、ほぼ全部を捨てることになるだろう、とも書いています)。
なお、正しい答えが複数ある質問については、評価のときに「参照解答のどれかと完全一致すれば正解」と数えています。
REALM (2020年2月)
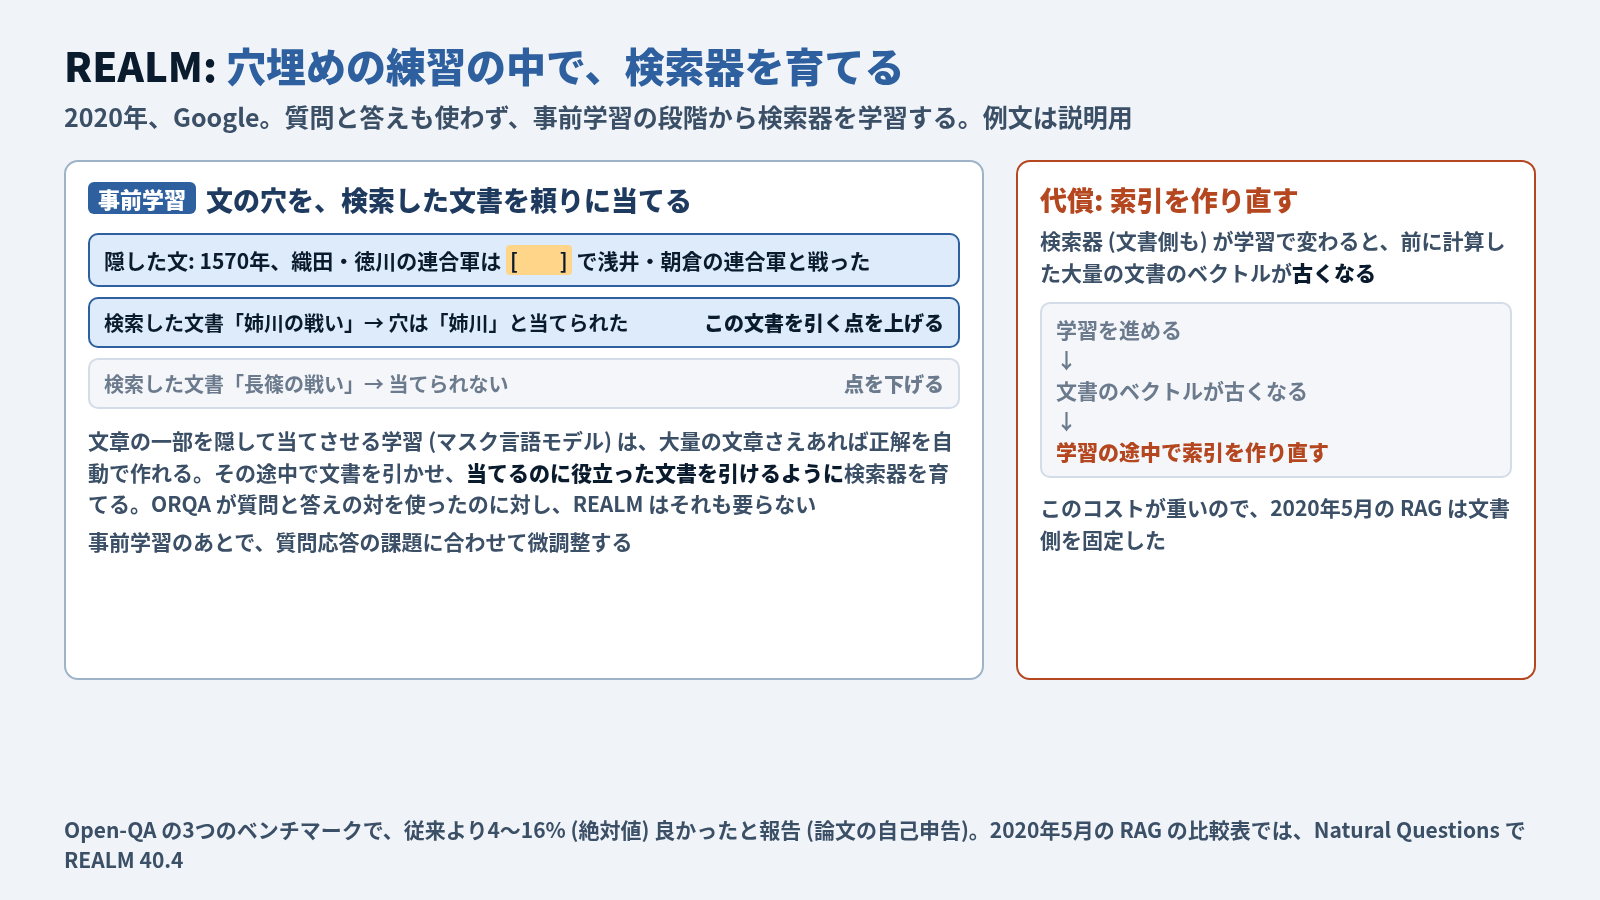
同じく Google の REALM は、さらに手前の事前学習の段階から検索器を学習しました (arXiv:2002.08909)。文の一部を隠して当てさせる学習 (マスク言語モデル) の途中で文書を検索させ、当てるのに役立った文書を引けるように検索器を育てます。検索器が変わると文書側のベクトルも古くなるので、学習の途中で索引を作り直す必要がありました。オープンドメイン質問応答の3つのベンチマークで、従来より4〜16% (絶対値) 良かったと報告しています。
DPR (2020年4月)
Facebook の Karpukhin らの DPR (Dense Passage Retrieval) は、今の埋め込み検索 (ベクトル検索) の直接の祖先です (arXiv:2004.04906、EMNLP 2020)。質問と段落を、別々のエンコーダで数百次元の数値の並び (ベクトル) に変え、内積が大きいものを近い段落とみなします。
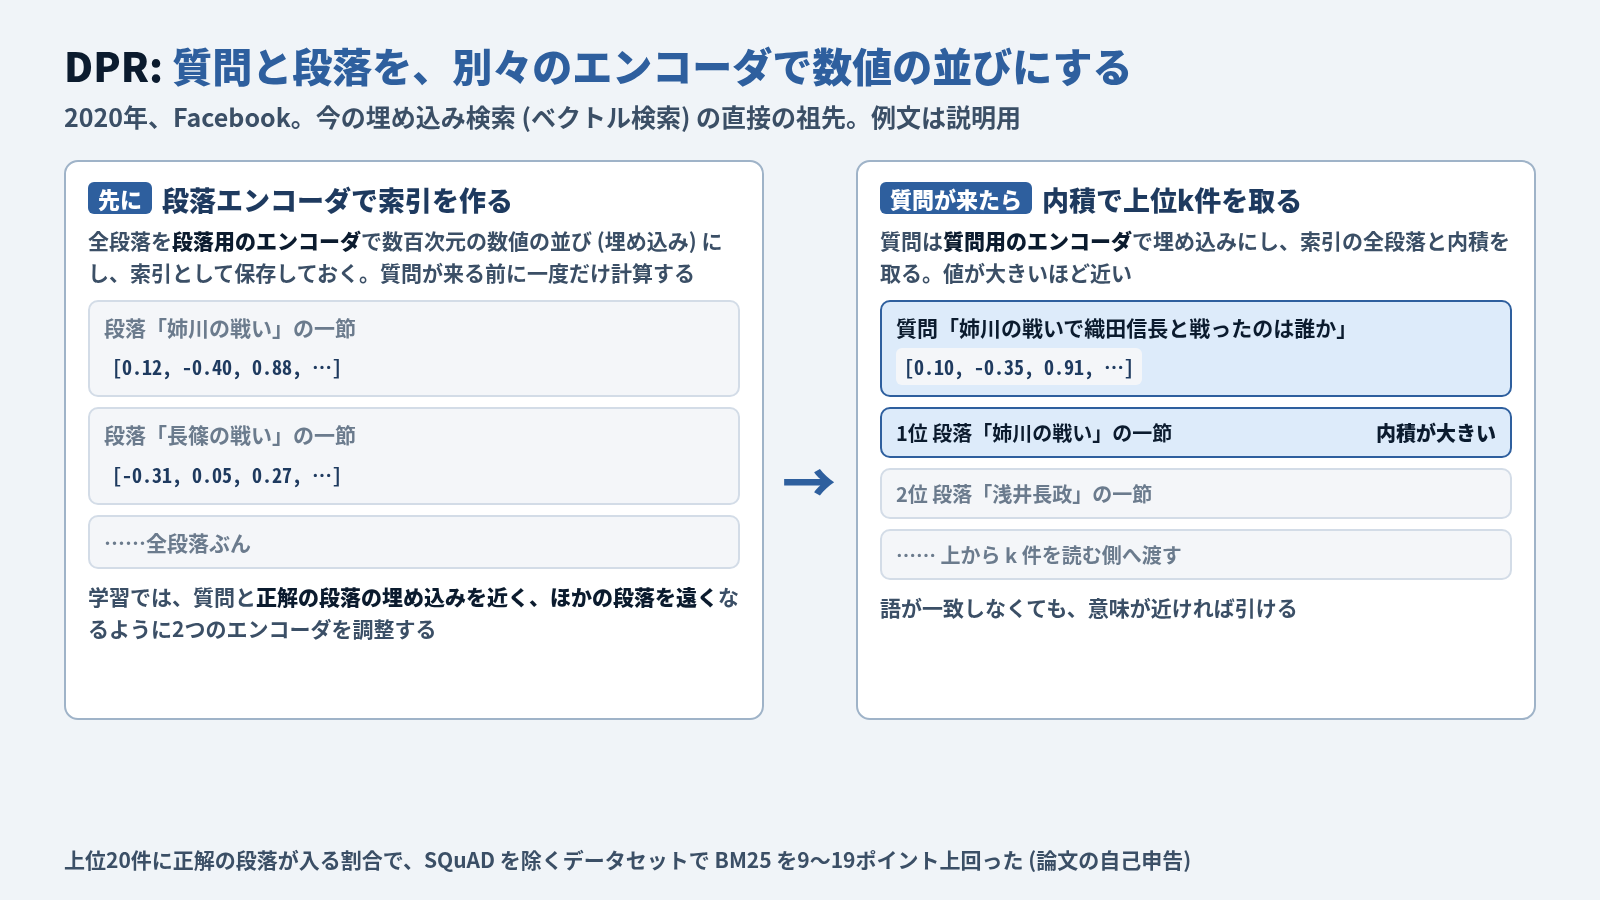
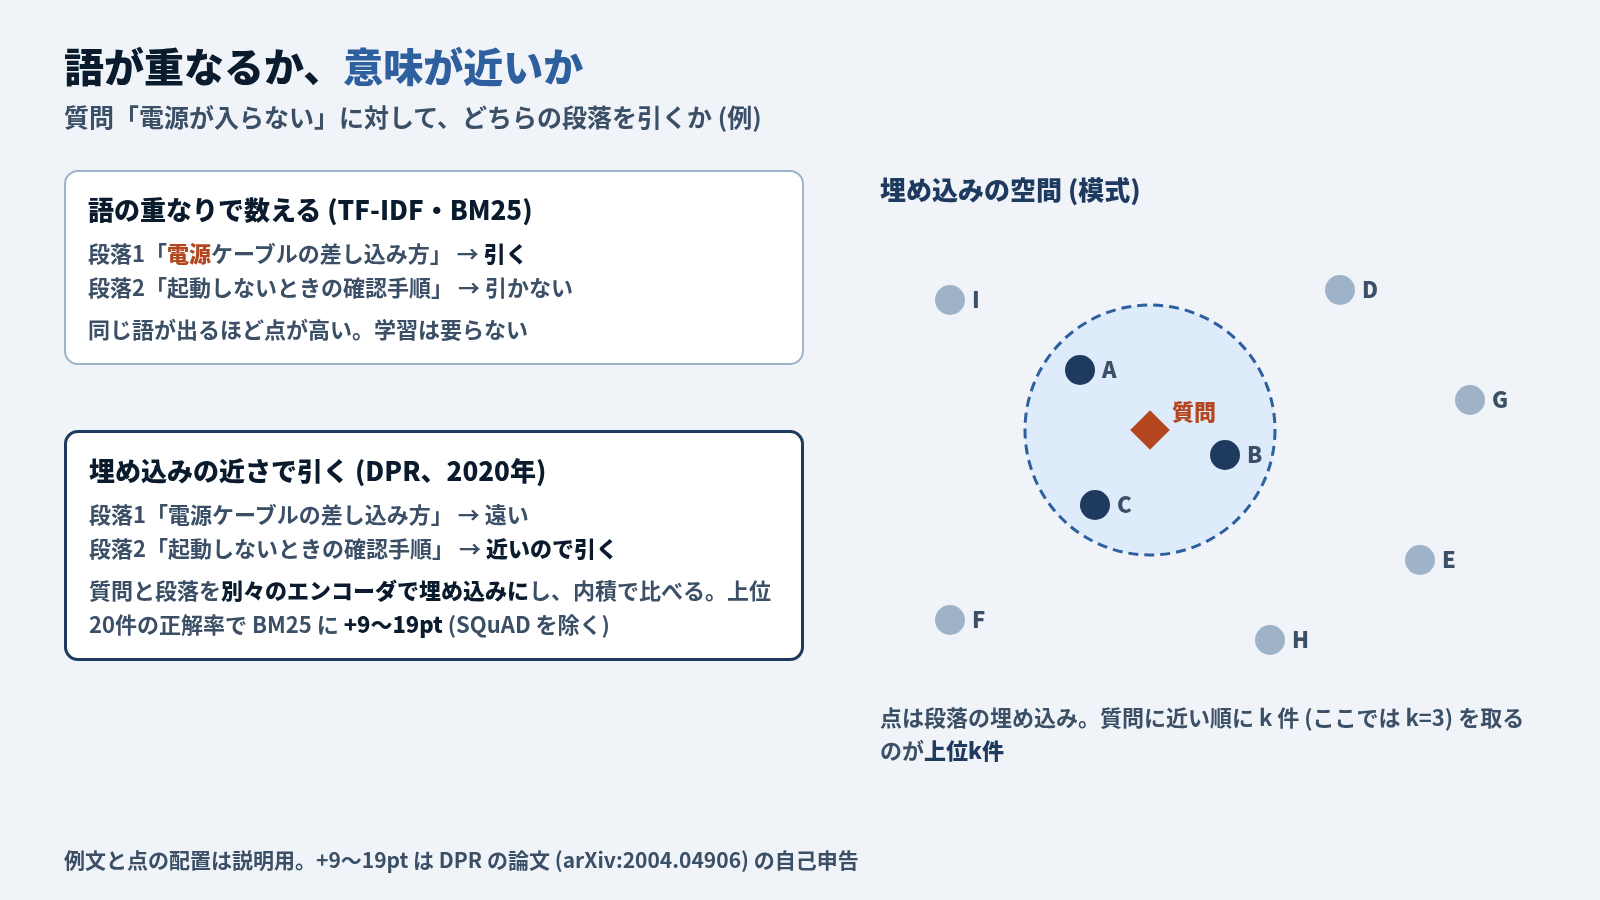
このシリーズでは、文章をこのように数値の並びに変えたものを埋め込み (embedding) と呼びます。意味が近い文章ほど、埋め込みどうしが近くなるように学習されています。そして質問の埋め込みに近い順に段落を並べて、上から k 件を取ることを上位k件を取ると呼びます。どちらも以降の章で繰り返し出てきます。
DPR は、上位20件に正解の段落が入る割合で、SQuAD を除くデータセットで BM25 を9〜19ポイント上回りました。SQuAD は段落を見ながら質問を書いたデータで、語がよく重なるので BM25 が勝ちます。
語が一致しなくても意味で引ける。それが語の重なりを数える検索に勝ったことが、この論文の大きさです。
2020年5月 RAG: 名前が付いた論文
Lewis ら12名 (Facebook AI Research・UCL・NYU) の論文が、RAG という名前を付けました (arXiv:2005.11401、NeurIPS 2020)。組み立ては、ここまでの部品をつないだものです。
- パラメトリック記憶 (重みの中の知識): 事前学習済みの生成モデル BART
- ノンパラメトリック記憶 (外の知識): Wikipedia を100語ずつに切った約2100万段落と、その DPR の埋め込みの索引
この「文書を決まった長さに切った断片」を、このシリーズではチャンクと呼びます。RAG の論文のチャンクは100語でした。
答えの作り方は2通りです。RAG-Sequence は、引いた段落1つごとに答え全体を書いて、段落の確からしさで重みをつけて足し合わせます。RAG-Token は、1語ごとに別の段落を頼れるようにします。Natural Questions (Google 検索の実際の質問を集めた質問応答のデータ) の完全一致率は RAG-Sequence 44.5 / RAG-Token 44.1 で、REALM の40.4、DPR の41.5を上回りました。
学習のしかたに注目してください。質問を埋め込みにするエンコーダと、BART を、正解つきの質問で一緒に微調整しています。 文書側のエンコーダだけは固定しました。動かすと、REALM がやったように学習の途中で2100万段落の索引を作り直すことになります。論文はこれをコストが高いとし、固定しても十分な性能が出たと書いています。
文書側を固定したおかげで、索引は丸ごと差し替えられます。論文には、索引を2016年12月版と2018年12月版の Wikipedia で入れ替え、その間に交代した82人の各国首脳を問う実験があります。2016年版の索引で2016年の首脳を問うと70%、2018年版で2018年の首脳を問うと68%が正解し、年がずれた組み合わせでは12%と4%に落ちました。モデルを学習し直さずに、索引の差し替えだけで答えが入れ替わったわけです。
困りごとの2番目、「直せない」への答えです。
2020〜22年 読む側を広げ、規模を変える: FiD・RETRO・Atlas
FiD (2020年7月)
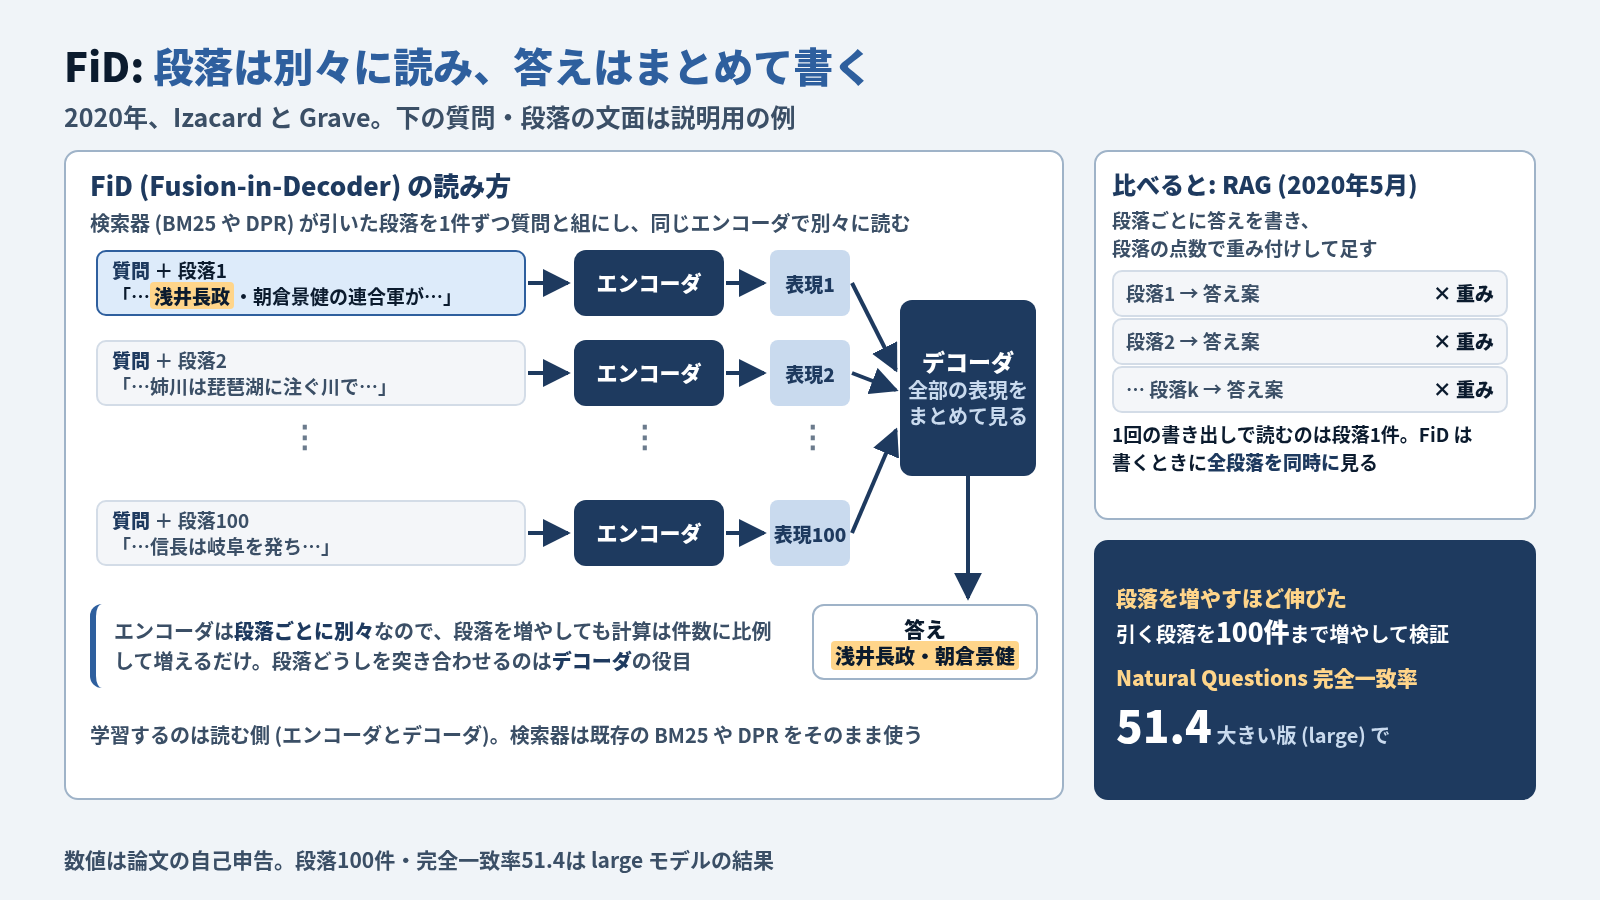
Izacard と Grave の FiD (Fusion-in-Decoder) は、引いた段落をエンコーダで1つずつ別々に読み、デコーダでまとめて答えを書きます (arXiv:2007.01282)。段落どうしを最初から連結しないので、件数を増やしても計算量が膨らみにくく、段落を100件まで増やすほど精度が伸びると報告しました。Natural Questions の完全一致率は、大きい版 (large) で51.4です。検索器は既存の BM25 や DPR をそのまま使い、学習したのは読む側でした。
RETRO (2021年12月)
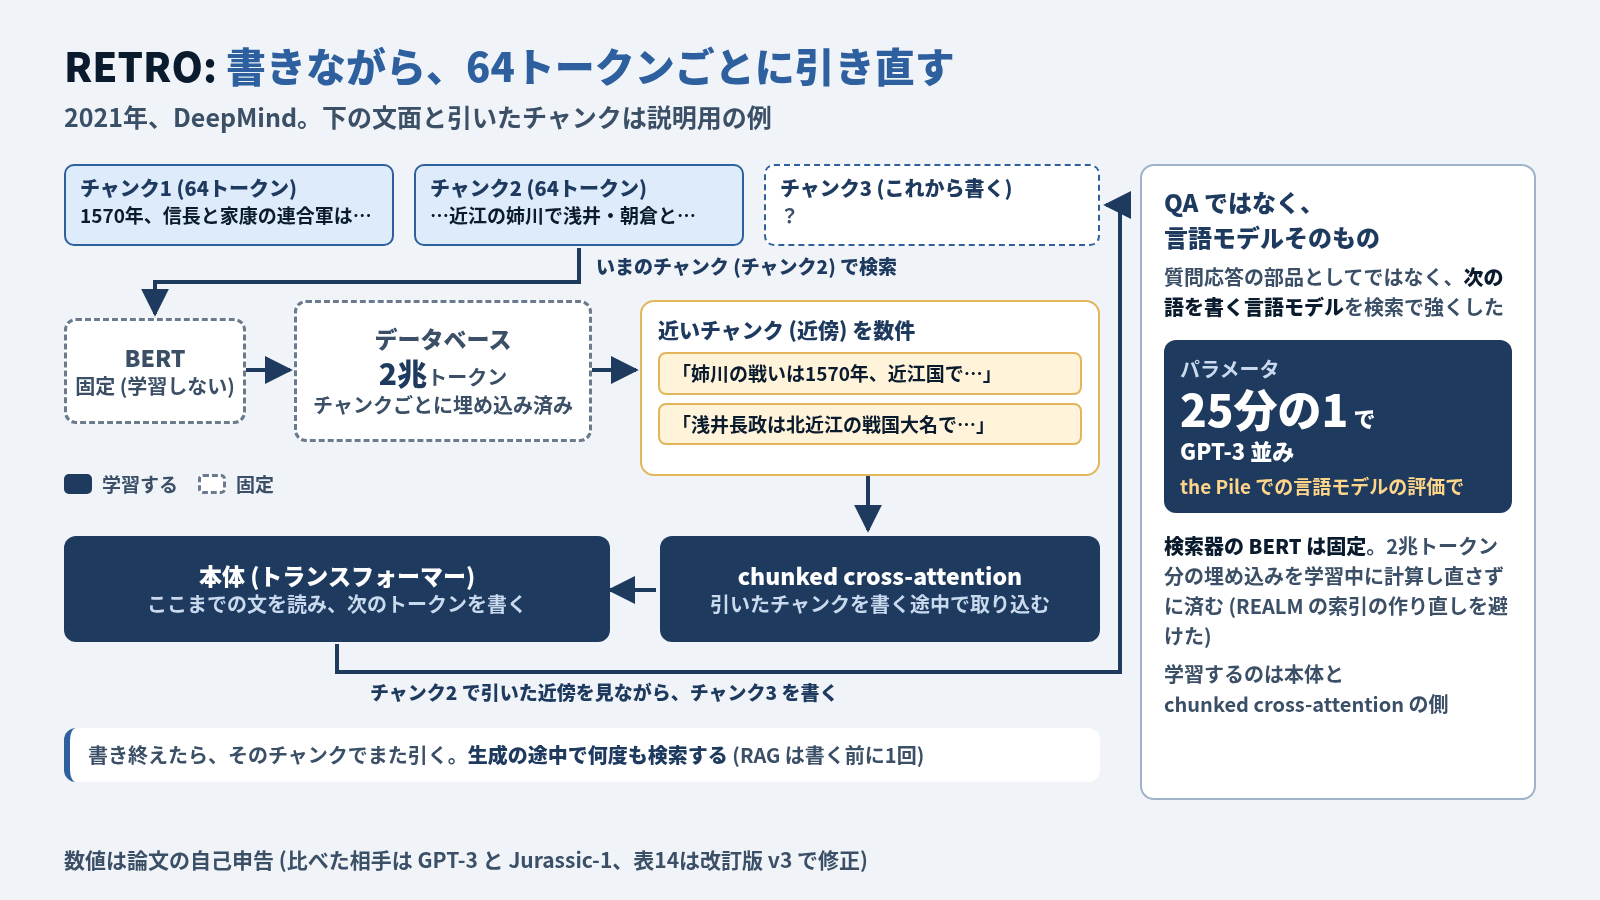
DeepMind の RETRO は、2兆トークンのデータベースから、生成の途中で似たチャンクを引きながら文章を書くモデルです (arXiv:2112.04426)。the Pile (英語の大規模なテキスト集) での言語モデルの評価で、パラメータが25分の1で GPT-3 に並ぶと報告しています (論文の自己申告。表14は改訂版 v3 で修正されています)。検索器には学習済みの BERT を固定して使い、学習したのは本体のほうでした。固定すれば埋め込みを定期的に計算し直さずに済むので REALM が払った索引の作り直しをここでも避けたことになります (論文もそれを固定の理由に挙げています)。
Atlas (2022年8月)
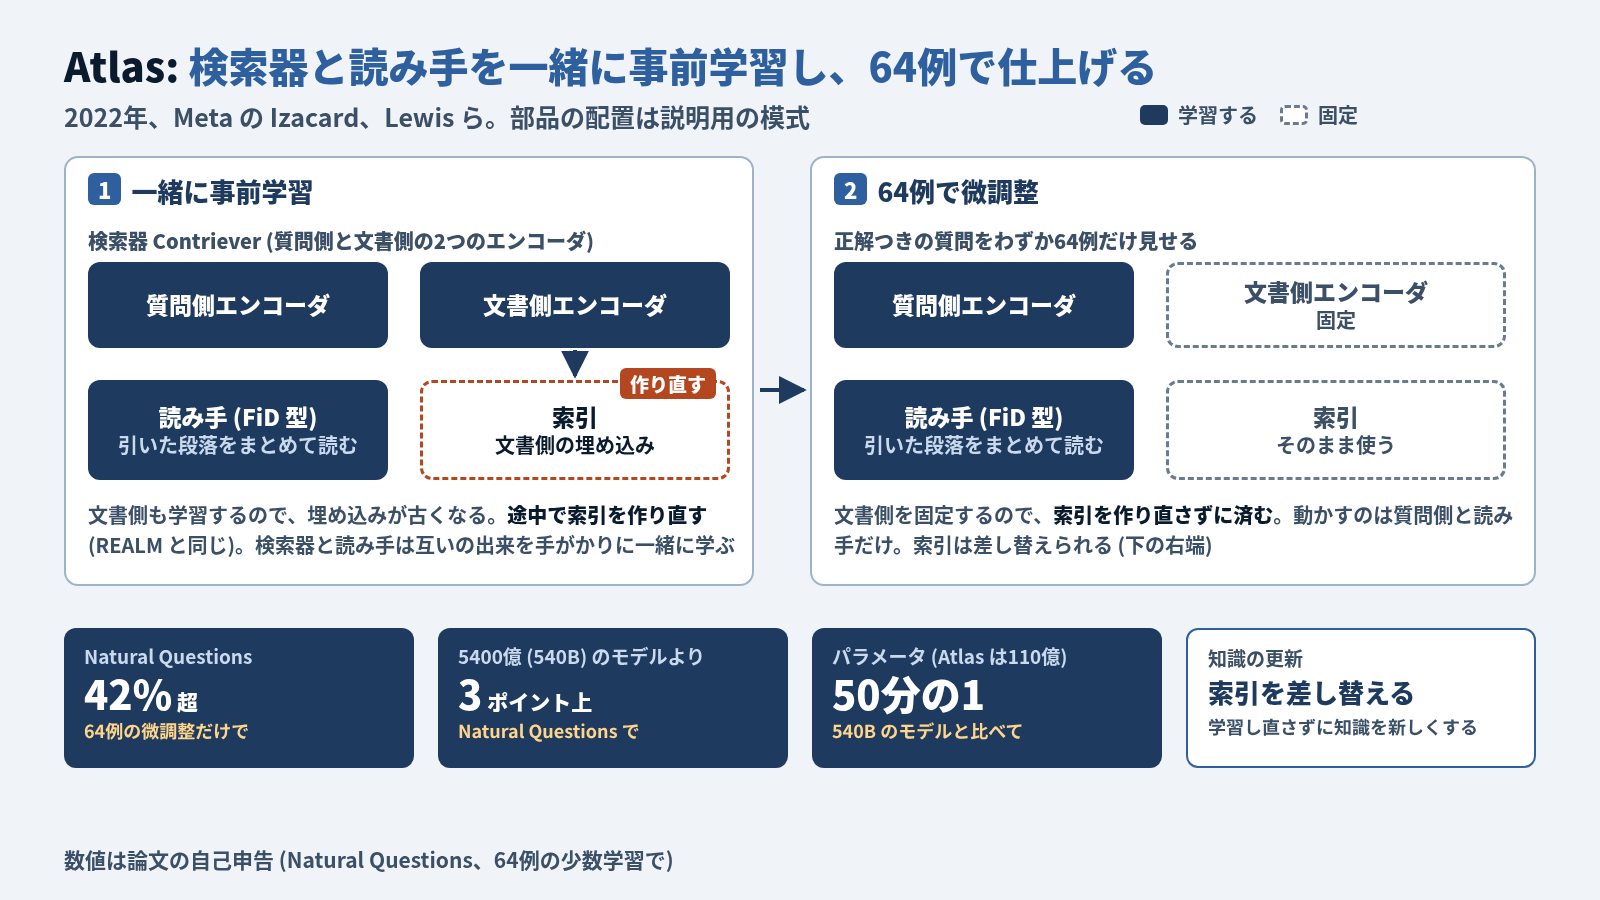
Meta の Atlas は、検索器と読み手を一緒に事前学習し、少ない例で質問応答に適応させます (arXiv:2208.03299)。事前学習では文書側のエンコーダも学習するので、REALM と同じく途中で索引を作り直します。64例の微調整では文書側を固定しました。例をわずか64個見せただけで Natural Questions の完全一致率42%を超え、5400億パラメータのモデルを3ポイント上回り、パラメータは50分の1だったと報告しています (論文の自己申告)。
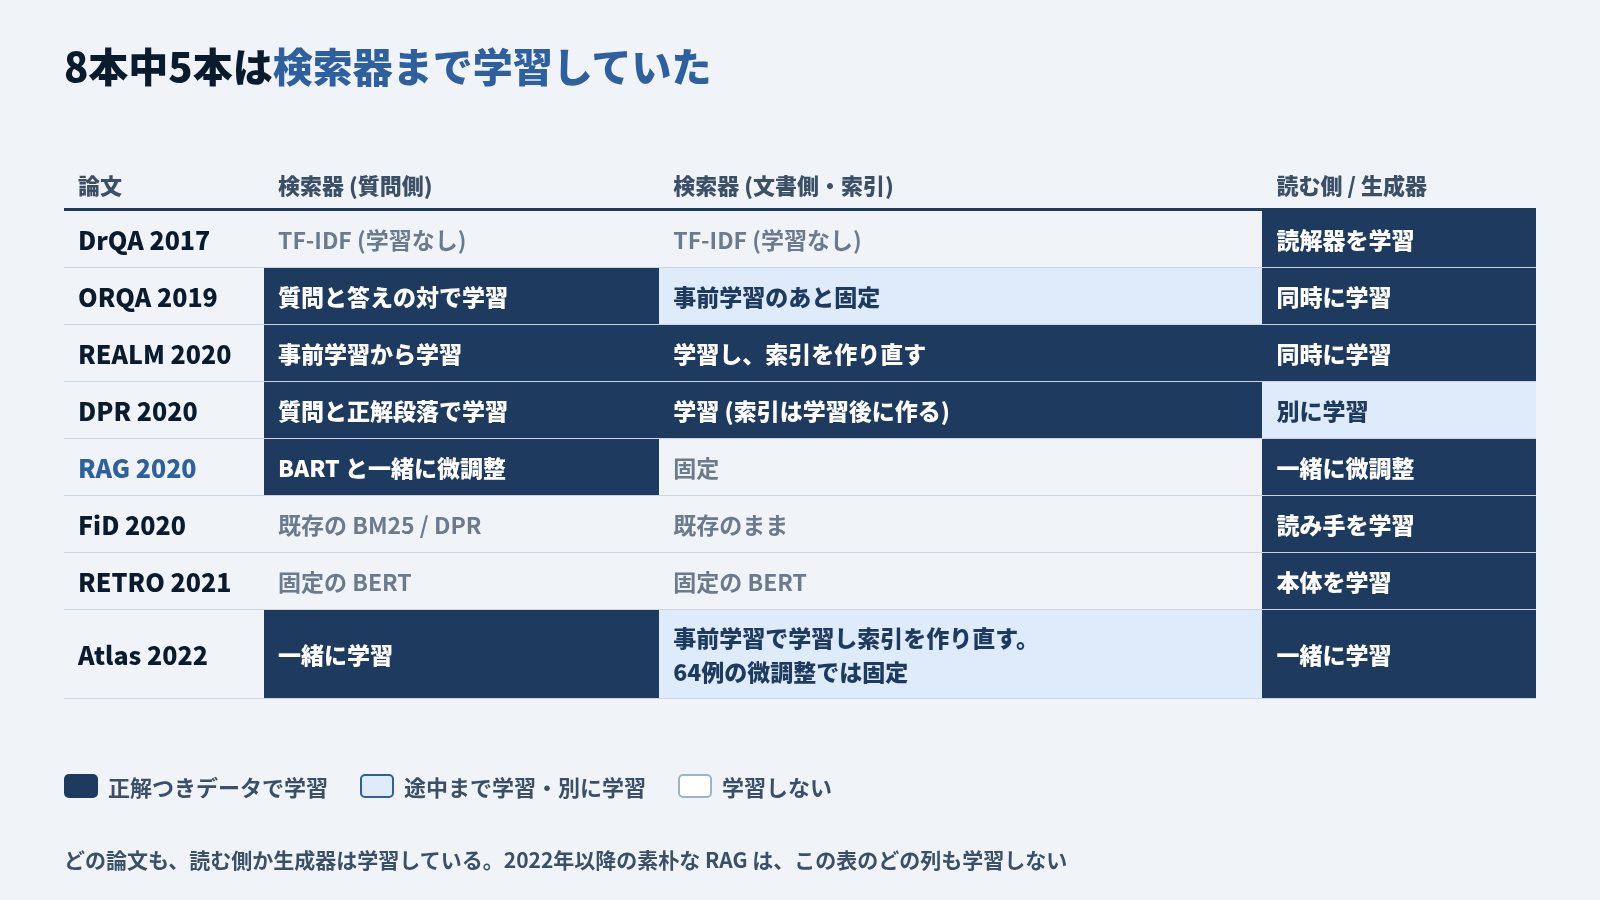
8本のうち5本は、検索器まで正解つきのデータで学習していました。
残ったものと、残らなかったもの
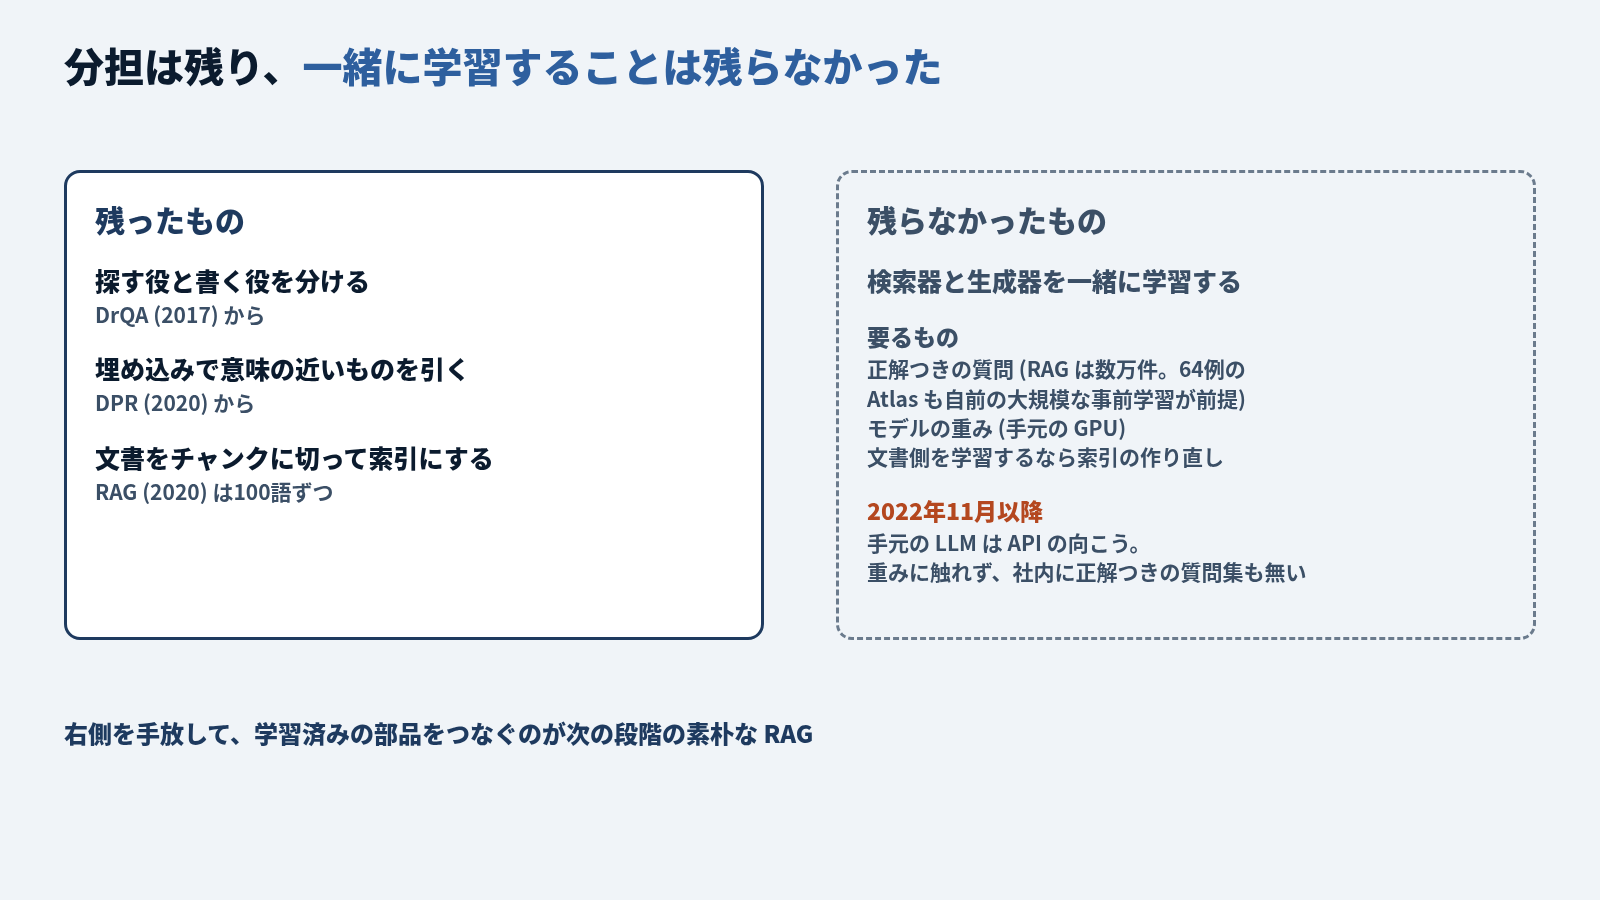
この5年で残ったものは3つあります。探す役と書く役を分ける構成。DPR から始まる、埋め込みで意味の近いものを引く検索。そして文書をチャンクに切って索引にする作り方です。どれも、今の RAG の部品表にそのまま載っています。残らなかったのは、検索器と生成器を一緒に学習することです。理由は表を見ると想像がつきます。一緒に学習するには正解つきの質問が要ります。RAG の論文は Natural Questions などの数万件で学習しました。64例で適応した Atlas も、その前に検索器と読み手の大規模な事前学習を自前で回しています。文書側を学習するなら索引を作り直す計算が要り、そもそもモデルの重みに手が届かないと始まりません。
2022年11月以降、手元にあるのは API の向こうの LLM になりました。重みは触れません。正解つきの社内質問集もありません。
そこで、学習済みの部品を学習せずにつなぐ形が標準になります。それが素朴な RAG の段階です。
日本では
日本語でも、同じ「探してから読む」の研究は同時期に進んでいました。中心にあったのはクイズです。
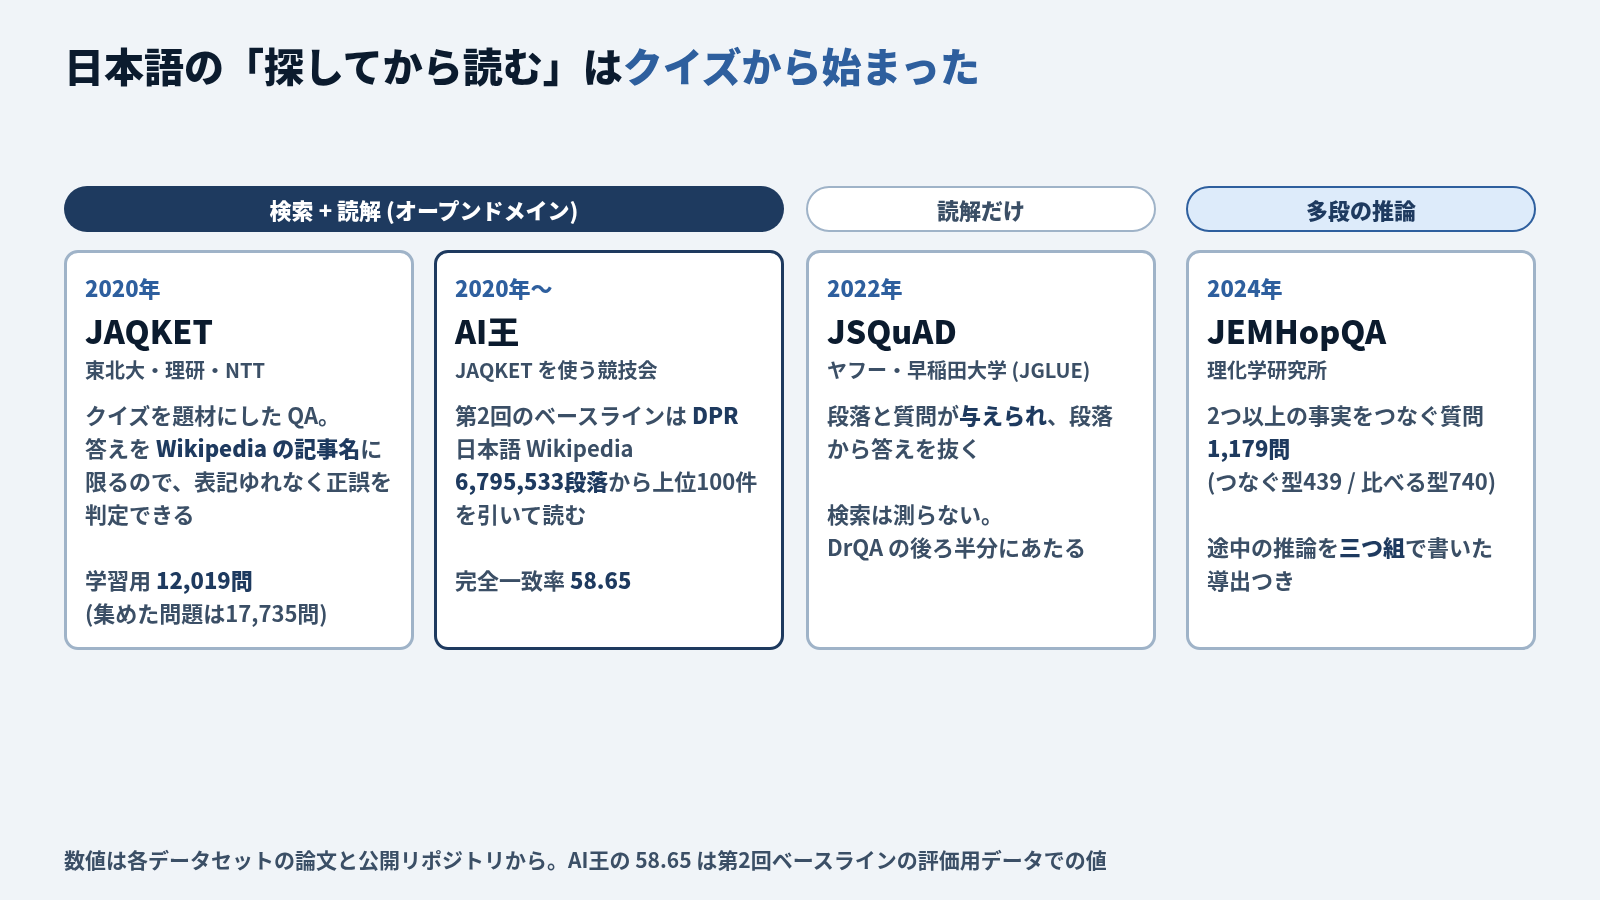
JAQKET は、東北大学・理化学研究所・NTT の鈴木らが2020年の言語処理学会で発表した、クイズを題材にした日本語のオープンドメイン質問応答のデータセットです (NLP2020 P2-24)。答えを Wikipedia の記事名に限ったので、答えの表記ゆれを気にせず正誤を判定できます。既存のクイズ大会の問題を17,735問集め、そこから作った学習用データは12,019問です。第1版は20択でした。
このデータを使った競技会が AI王 です。2020年に第1回が始まり、第2回のベースラインは DPR でした。2021年5月版の日本語 Wikipedia を6,795,533段落に切って索引にし、DPR で上位100件を引いて読解器が答えを抜き出す構成で、評価用データの完全一致率は58.65です (cl-tohoku/AIO2_DPR_baseline)。英語で2020年に出た DPR が、1年ほどで日本語の標準の比較相手になっていたことが分かります。
検索を含まない読解だけの評価には JSQuAD があります。ヤフーと早稲田大学河原研究室の JGLUE の一部で (LREC 2022)、Wikipedia の段落と質問が与えられ、段落の中から答えを抜き出します (yahoojapan/JGLUE)。DrQA の2段のうち、後ろの読解器だけを測る道具です。
2024年には理化学研究所の石井らが JEMHopQA を出しました (LREC-COLING 2024)。2つ以上の事実をつながないと答えられない多段の質問1,179問 (つなぐ型439問、比べる型740問) に、途中の推論を三つ組で書いた導出が付いています (aiishii/JEMHopQA)。このシリーズでは GraphRAG の章で、この開発用120問を使った予備測定を扱います。
次に読む
学習しない RAG がどう組まれ、どこで外すのかは、ベクトルデータベース7種を実測 素朴なRAGで扱います。ベクトルデータベースを7種類並べて測った私の実測も、そこで出てきます。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?