Agentic RAG 2025年 検索を学ぶAI
検索の判断は、ここで人の手を離れ始めます。
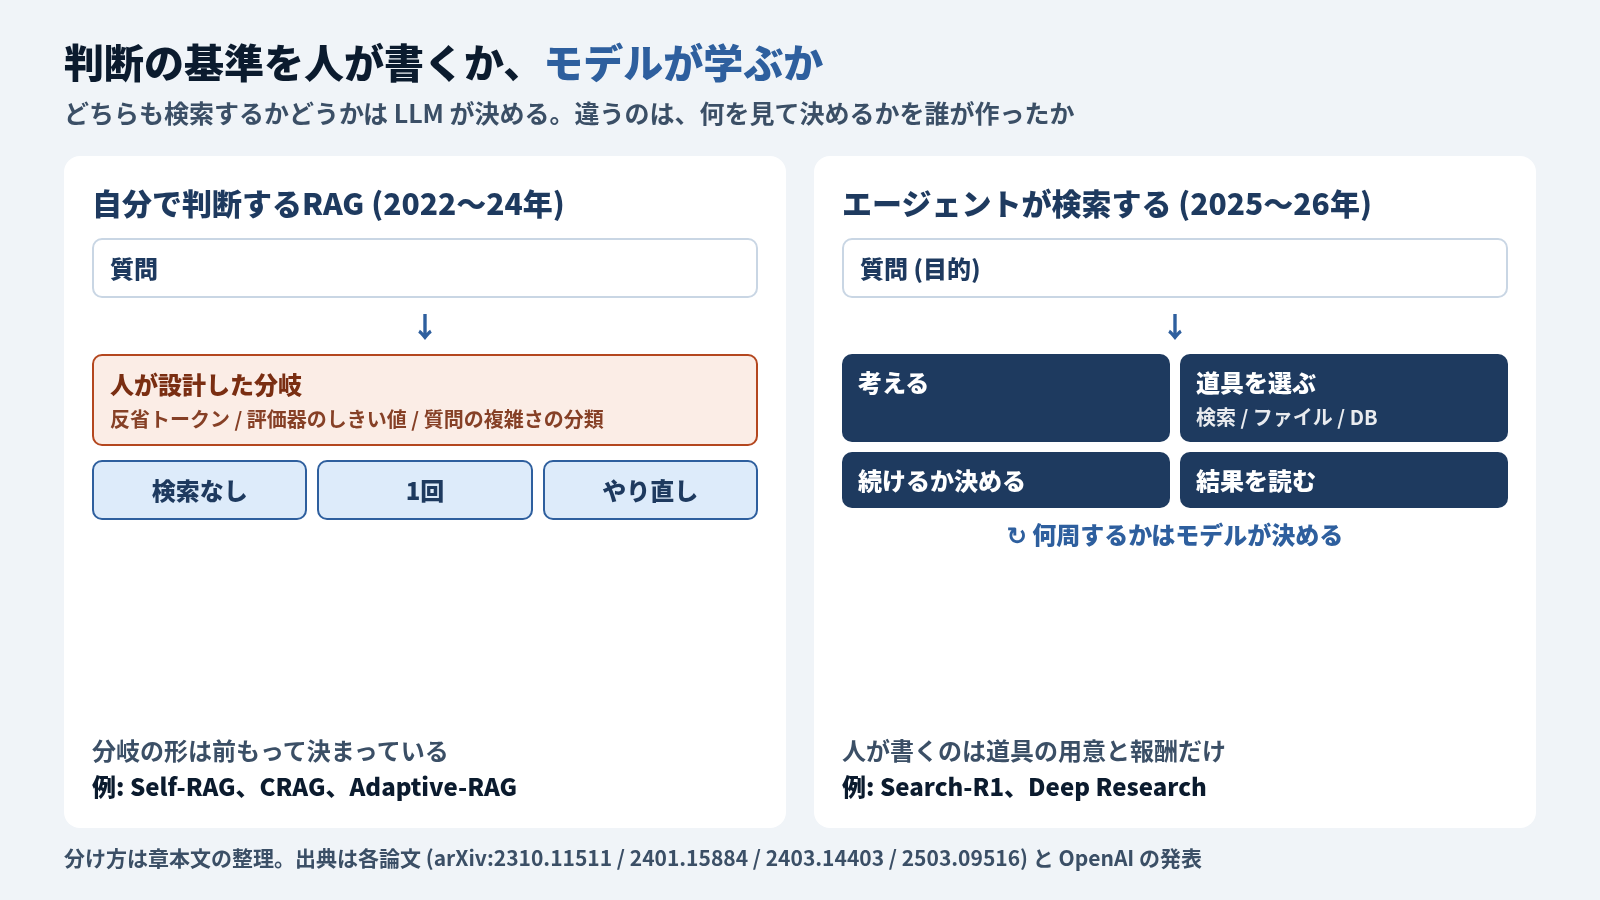
自分で判断するRAG の段階でも、検索するかどうかを決めていたのは LLM でした。ただし何を見て決めるかの基準は人が設計していたので、問いの種類が増えるたびに人が基準を書き足す必要がありました。2025年からの研究は、その基準を書くのをやめます。強化学習で答えの正しさに報酬を与えると、モデルはいつ・何を・何回検索するかを自分で身につけました。Search-R1 は、7つのデータセットの平均の完全一致率で、7B モデルなら同じ条件の素の RAG より相対で41%、比べた手法のうち最も強いものより24%高かったと報告しています。
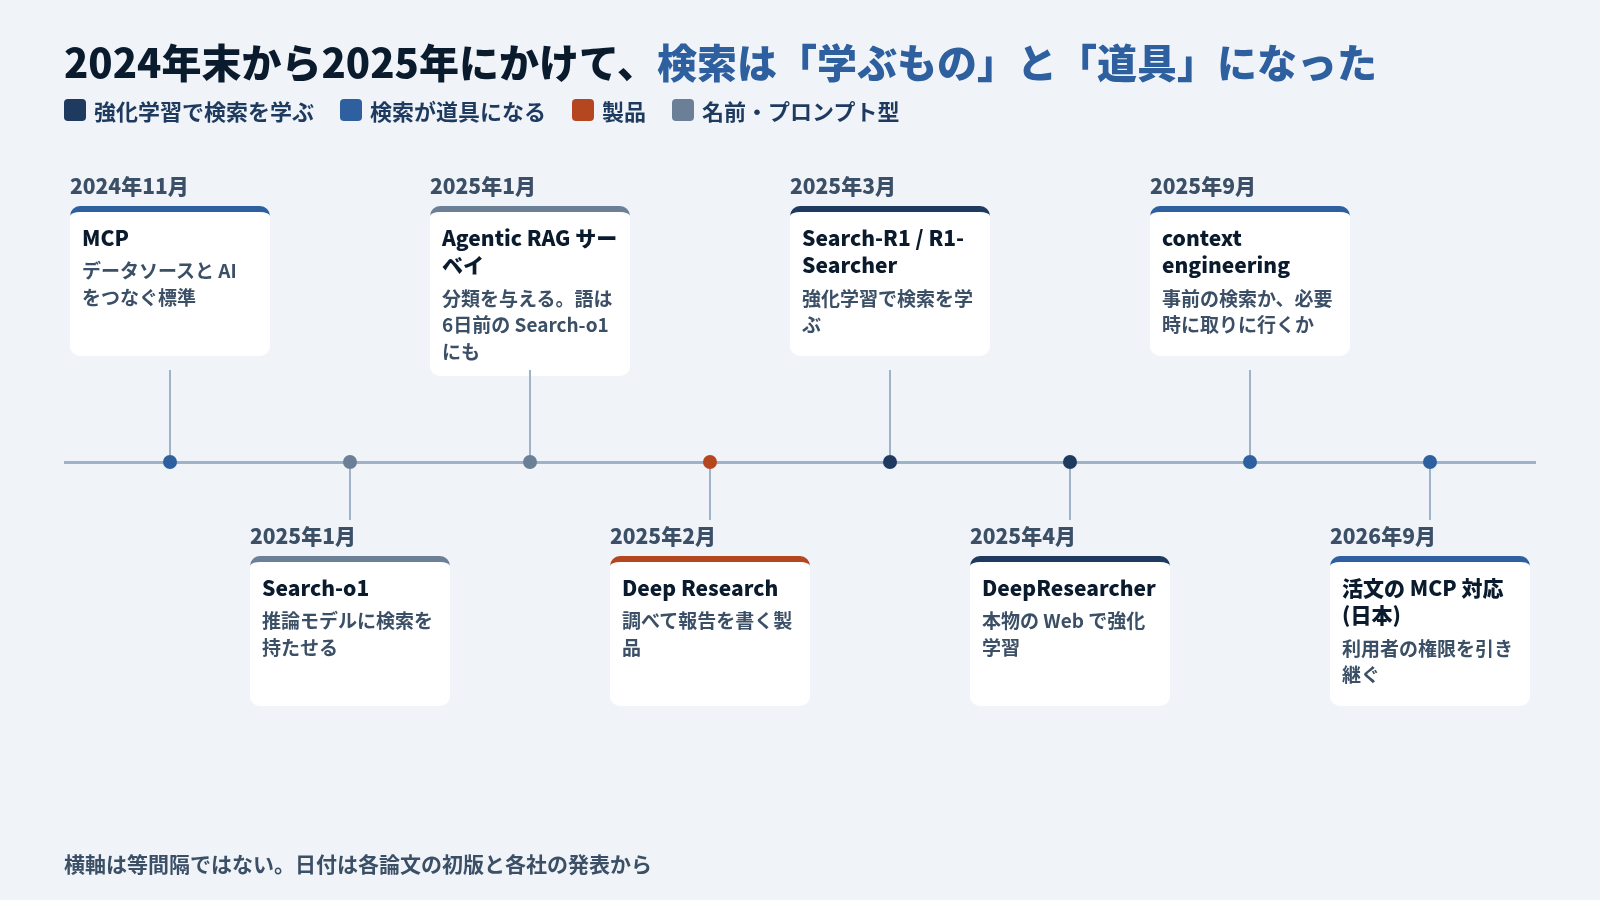
同じ時期に、検索は道具の1つになりました。2024年11月の MCP で、検索はファイルの読み込みやデータベースの問い合わせと同じ並びに置かれ、エージェントが必要な時点で呼び出すものになりました。人が書くのは道具の用意と報酬だけです。引き換えに、遅さと費用と、根拠の追いにくさが残ります。任せてよいのは、何を何回探せばよいかを前もって決められない問いです。経路の再現や根拠の提示が求められる業務では、いまも人が分岐を書くほうが向いています。
困りごと: 判断のルールを人が書ききれない
自分で判断するRAG の段階で、LLM は検索の回数ややり直しを決めるようになりました。Self-RAG は反省トークンという専用の記号を出して検索の要否を判定し、CRAG は軽い評価器で検索結果を採点して悪ければ Web 検索に切り替え、Adaptive-RAG は質問の複雑さを分類して検索なし・1回・反復を使い分けました。
どれも、判断の基準そのものは人が設計しています。どの記号を出したら検索するか、評価器の点が何点を下回ったらやり直すか、質問を何段階に分けるか。
問いの種類が増えると、この設計が追いつきません。「この会社の製品で、去年の不具合と同じ部品を使っているものは」という問いを考えてみてください。まず去年の不具合の記録を引き、そこに出てくる部品番号を読み、その部品を使う製品の一覧を引き直す必要があります。何回検索すれば足りるかは、1回目の結果を読むまで分かりません。前もって分岐を書いておくことができない問いです。
2025年1月: Agentic RAG という呼び名
2025年1月、この流れに Agentic RAG という呼び名が付き始めます。1月9日に出た Search-o1 (次の節) は、abstract で自分の仕組みを agentic retrieval-augmented generation と呼んでいました (arXiv:2501.05366)。その6日後の1月15日、Singh らのサーベイ論文が Agentic RAG を題名に掲げて整理を与えました (arXiv:2501.09136)。従来の RAG は手順が固定されていて、何段も考える問いや複雑なタスクに合わせて動きを変えられない、という指摘から始まります。
サーベイはエージェントの設計の型として、振り返り (reflection)、計画 (planning)、道具の使用 (tool use)、複数エージェントの協調 (multi-agent) の4つを挙げています。エージェントの数・制御の形・自律の度合い・知識の表し方の4軸で分類する、という書き方は、2026年4月に改訂された第4版の abstract のものです。
この章で「エージェント」と呼ぶのは、目的に向かって自分で次の行動を選んで道具を呼び出し、結果を見てまた選ぶことを繰り返す LLM です。
推論モデルに検索を持たせる: Search-o1
同じ2025年1月の Search-o1 は、OpenAI の o1 のように長く考える推論モデルに検索を組み込みました (arXiv:2501.05366)。考えている途中で知識が足りないところに来ると、モデルが自分で検索を呼びます。検索した文書は長くて雑音が多いので、Reason-in-Documents という別の部品で読み込んで要点にしてから推論に戻します。
ただし Search-o1 は、検索の呼び方をプロンプトで指示する方式です。重みは変えていません。
強化学習で検索の仕方を学ぶ
2025年3月から4月にかけて、検索の仕方そのものを強化学習で学ばせる研究が続けて出ました。Search-R1 (2025年3月) は、モデルが考えながら検索クエリを出せる形にして、強化学習で鍛えました (arXiv:2503.09516)。検索できる回数は最大4回です。報酬は最終的な答えが正解と完全一致したかどうか (EM) だけです。検索で取ってきた文章は学習の対象から外して (retrieved token masking)、モデルが自分で書いた部分だけを鍛えます。7つの質問応答データセットの平均の完全一致率で、Qwen2.5-7B は同じ条件の素の RAG より相対で41%高くなりました。比べた手法のうち最も強いもの (Rejection Sampling) と比べると24%、Qwen2.5-3B では20%です。abstract に載っているのは後の2つの数字です。
R1-Searcher (2025年3月) は2段階の強化学習で、推論の途中で外部の検索を自分から呼べるようにしました (arXiv:2503.05592)。1段目では、検索を1回でも呼べば0.5点、決まった書式を守れば0.5点という報酬で、まず検索を使うことを覚えさせます。答えの報酬 (正解との F1) が入るのは2段目からです。途中の手順に点を付ける報酬 (process reward) と、学習の出だしで別のモデルの真似をさせる工程 (蒸留) は使っていません。
DeepResearcher (2025年4月) は、決まった文書の山を離れて、本物の Web 検索の上で、最初から最後まで強化学習で鍛えました (arXiv:2504.03160)。プロンプトで組んだ方式より最大28.9ポイント、固定コーパスの上で強化学習した方式より最大7.2ポイント上回ったと報告しています。学習の結果として、計画を立てる、複数の情報源で裏を取る、行き詰まったら調べ直す、確かな答えが見つからないときはそう言う、といった振る舞いが出てきたとも書いています。
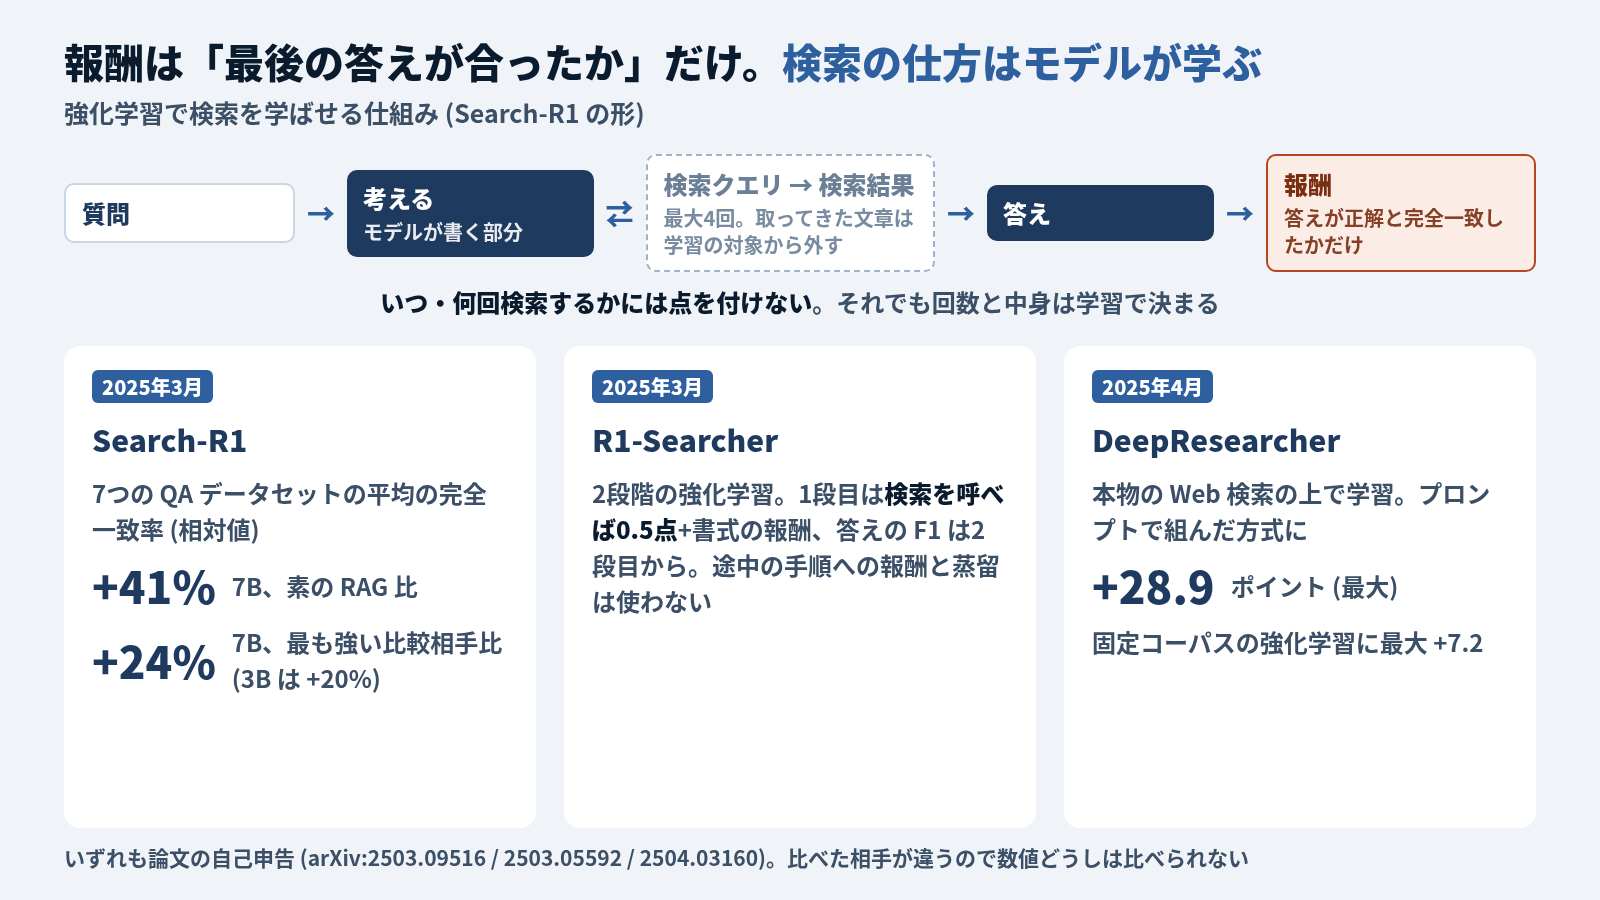
3つの数字は比べた相手が違うので、横に並べて大小を言うことはできません。共通しているのは、検索の判断が、人の書いたルールから、学習で得た重みに移ったことです。
2025年2月: Deep Research という製品
研究と並行して、製品も出ました。OpenAI が2025年2月2日に発表した Deep Research は、o3 をもとにした、Web を調べて報告を書くエージェントです (OpenAI)。専門家が作った難問を集めた Humanity’s Last Exam で26.6%と報告されていますが、これは OpenAI 自身の評価です。
仕事の単位が「質問に答える」から「調べて報告を書く」へ大きくなりました。
検索が道具の1つになった: MCP
もう1つの変化は配線の側で起きました。2024年11月25日、Anthropic は MCP (Model Context Protocol) を公開しました (Anthropic)。データソースと AI アシスタントをつなぐためのオープンな標準です。MCP の上では、社内の文書検索もファイルの読み込みもデータベースへの問い合わせも、同じ形の「道具」としてエージェントに見えます (MCP には道具のほかにリソースやプロンプトという種類もあり、ここは簡略化した言い方です)。RAG の検索は、パイプラインの決まった1段目の座を降りました。必要なときに選ばれる道具の1つです。
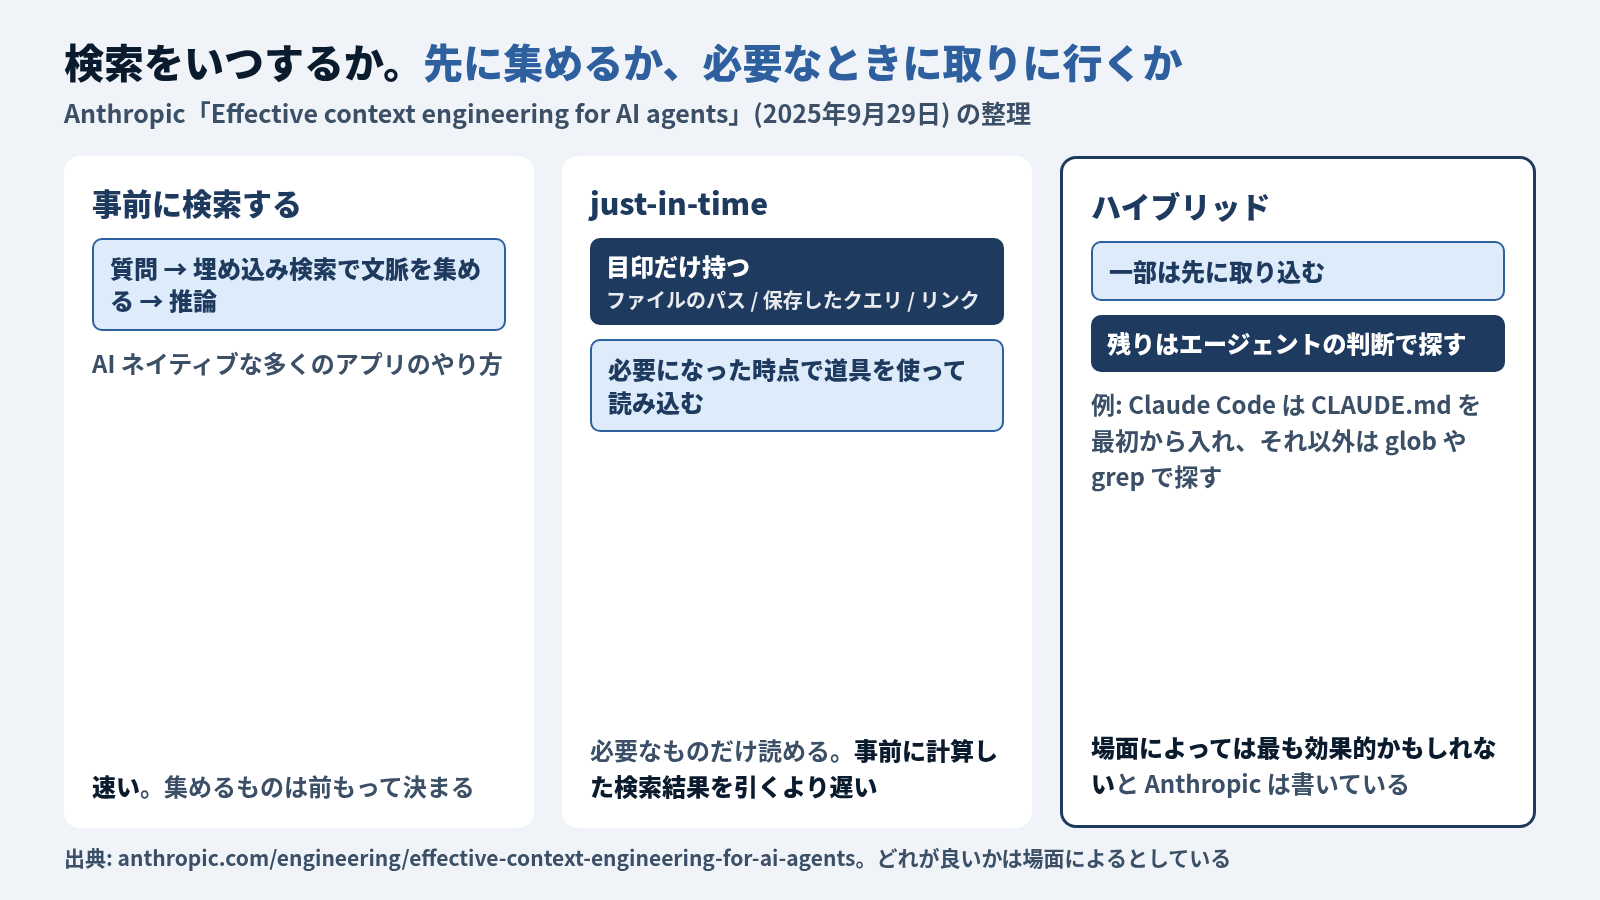
Anthropic は2025年9月29日の記事で、この違いを2つの方式として書いています (Anthropic)。1つは、AI ネイティブな多くのアプリ (原文は many AI-native applications) がやっている、推論の前に埋め込み検索 (ベクトル検索) で文脈を集めておく方式。もう1つは just-in-time と呼ぶ方式で、ファイルのパスや保存したクエリ、リンクのような軽い目印だけを持っておき、必要になった時点で道具を使って中身を読み込みます。
どちらが良いかは場面によると記事は書いています。実行時に探索する方式は、事前に計算した検索結果を引くより遅いと書いたうえで、場面によっては (原文は In certain settings)、速さのために一部を先に取り込み、残りをエージェントの判断で探索させるハイブリッドが最も効果的かもしれない (might) と書き、Claude Code を例に挙げています。Claude Code は CLAUDE.md というファイルを最初から文脈に入れ、それ以外は glob や grep で必要なときに探しに行きます。
任せると何を引き受けるか
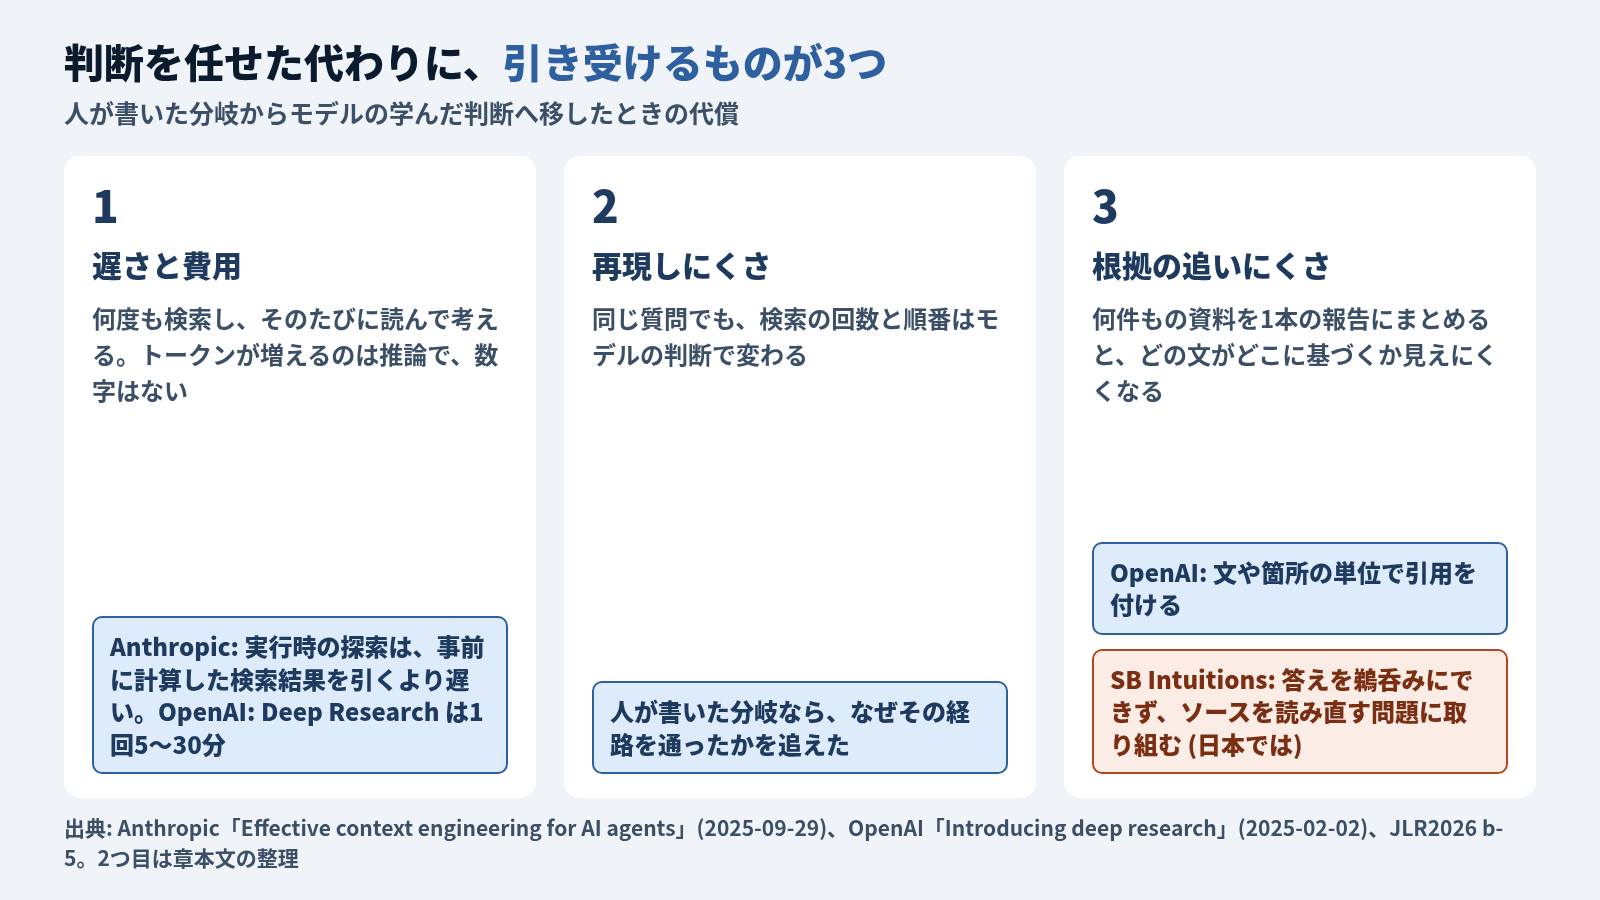
判断をモデルに任せた代わりに、引き受けるものが3つあります。
1つ目は遅さと費用です。何度も検索して、そのたびに読んで考えます。Anthropic は、実行時の探索は事前に計算した検索結果を引くより遅いと書いています。OpenAI は、Deep Research が1回の調査に5〜30分かかると書いています (OpenAI)。トークンの量を示した数字はどちらにもありません。読む回数が増えるぶんトークンも増えるというのは、私の推論です。
2つ目は再現しにくさです。同じ質問でも、検索の回数と順番はモデルの判断で変わります。人が書いた分岐なら経路を追えました。
3つ目は根拠の追いにくさです。何件もの資料を読んで1本の報告にまとめると、どの文がどの資料のどこに基づくのかが見えにくくなります。OpenAI は、Deep Research は出典の特定の文や箇所を引用でき、どの出力にも明確な引用が付くと書いています。一方で、後で紹介する SB Intuitions の発表は、Deep Research の答えを鵜呑みにできず、結局ソースを読み直すことになる、という問題意識から始まっています。引用が付くことと、読み手が根拠を確かめやすいことは別の話です。
任せる範囲の線
3つの代償を並べると、任せる範囲の線が引けます。
任せてよいのは、何を何回探せばよいかを前もって決められない問いです。去年の不具合から部品番号をたどる冒頭の例のように、1回目の結果を読むまで次の検索が決まらない問いは、人が分岐を書いても追いつきません。調べものの下調べのように、待ち時間を許せて、最後に人が読み直す前提の仕事も向いています。
人が分岐を書いたほうがよいのは、経路の再現や根拠の提示が求められる業務です。監査で「なぜこの文書を見てこの答えにしたか」を説明する、同じ問い合わせに毎回同じ手順で答える、といった仕事では、モデルの判断で検索の回数と順番が変わること自体が困る点になります。こちらは自分で判断するRAG のように、分岐を人が設計して LLM に判断させる形のほうが合います。
この線は、ここまでの一次資料から私が引いたもので、測ってはいません。
日本では
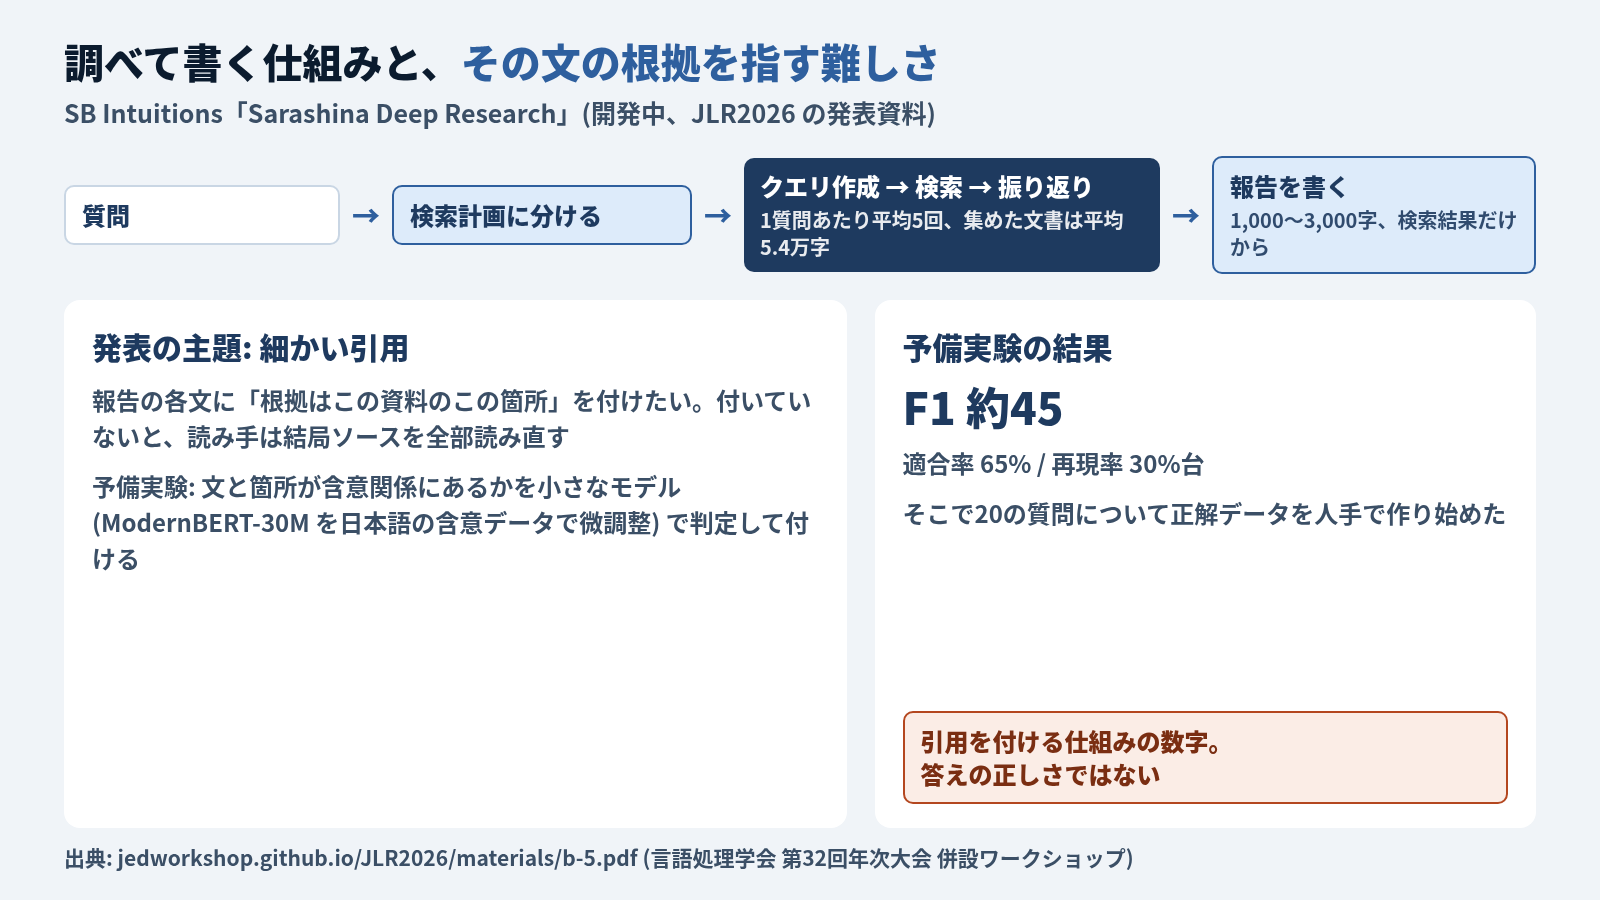
SB Intuitions の Sarashina Deep Research は、2026年の言語処理学会年次大会に併設されたワークショップ JLR2026 で発表されました (発表資料)。開発中のシステムです。質問を検索計画に分けてからクエリ作成と検索と振り返りを繰り返し、1つの質問あたり平均5回の検索で平均5.4万字の文書を集めて、1,000〜3,000字の報告を書かせています。モデルの内部知識は使わず、検索結果だけから書くようにシステムプロンプトで制御しているそうです。
発表の主題は、報告の各文に「根拠はこの資料のこの箇所」という細かい引用を付けることでした。Deep Research の答えを鵜呑みにできず、結局ソースを全部読み直すことになる、という問題意識です。文と資料の箇所が含意関係にあるかを小さなモデル (ModernBERT-30M を日本語の含意データで微調整したもの) で判定して引用を付ける予備実験では、人が確かめると F1 で約45 でした。適合率は65%と比較的高いものの、再現率が30%台です。そこで20の質問について正解データを人手で作り始めた、という報告です。
これは引用を付ける仕組みの数字です。答えの正しさではありません。
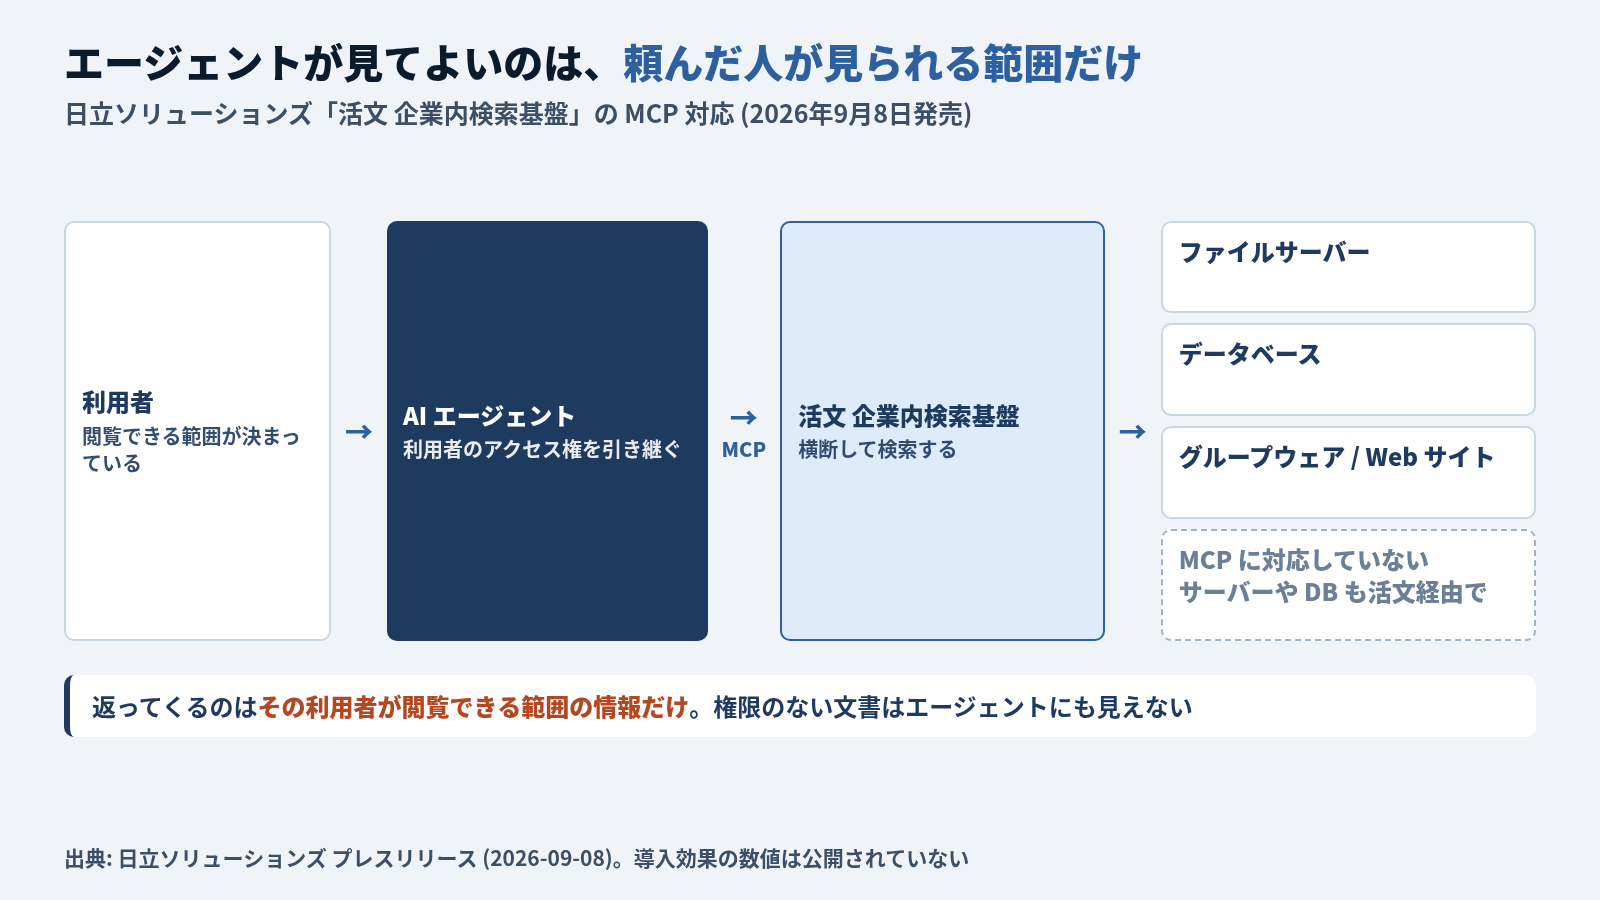
もう1つは配線の側です。日立ソリューションズは2026年9月8日、企業内検索基盤「活文」を MCP に対応させた最新版の販売を始めました (日立ソリューションズ)。AI エージェントが利用者のアクセス権を引き継いで、ファイルサーバー・データベース・グループウェアなどの社内情報のうち、その利用者が見られる範囲だけに自分でアクセスできる、という機能です。MCP に対応していないファイルサーバーやデータベースも、活文を経由すれば検索できるとしています。
日本の事例では、生成 AI を閉じた環境で使う形がよく出てきます。たとえば SMBC グループは2023年4月、グループ専用の環境で AI アシスタント「SMBC-GPT」の実証実験を始めています (NEC)。エージェントに検索を任せるとき、最初に問われるのは何を見てよいかです。
アクセス権を引き継ぐ設計は、この問いに検索の基盤の側で答えています。ただしこれは私の読みで、導入の効果を示す数値は公開されていません。
次に読む
エージェントが検索する段階でも、検索の道具そのものは BM25 や埋め込み検索のままです。LLM は道具の外側で、何を、何回検索するかを決めているだけです。最後の段階では、LLM が道具の内側に入り、索引そのものをたどって一段目の検索器の役を引き受けます。DecisionRAGとは 2026年の新検索手法へ進んでください。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?