DecisionRAGとは 2026年の新検索手法
エージェントが検索する段階まで来ても、検索の道具そのものは BM25 や埋め込み検索 (ベクトル検索) のままで、LLM は道具の外側から何を何回検索するかを決めていただけでした。LLM が道具の内側に入る型は、2023年の MemWalker から試されてきて、2025〜26年に続けて出ています。索引を「トピック、文書、段落」の木にしておき、LLM がその木を上から読んでたどるので、検索器 (質問に合う文書を索引から引いてくる部品) の役を LLM が引き受けることになります。
2026年10月の DecisionRAG は、この型を速くしました。各階層で候補の枝を、トークンを生成せずに1回の計算でまとめて判定し、4つのベンチマーク (最大は Natural Questions の268万段落) で1問0.7〜1.8秒だったと論文は報告しています。ただし効くのは、文書に見出しやカテゴリの構造がある場合です。上の階層で捨てた枝は二度と拾えません。ベクトル検索を置き換えるものとは言えません。構造のある文書群で、一段目の検索器を代える候補です。査読前で、論文にコード公開の記載はありません。
困りごと: 検索器が見落としたものは取り戻せない
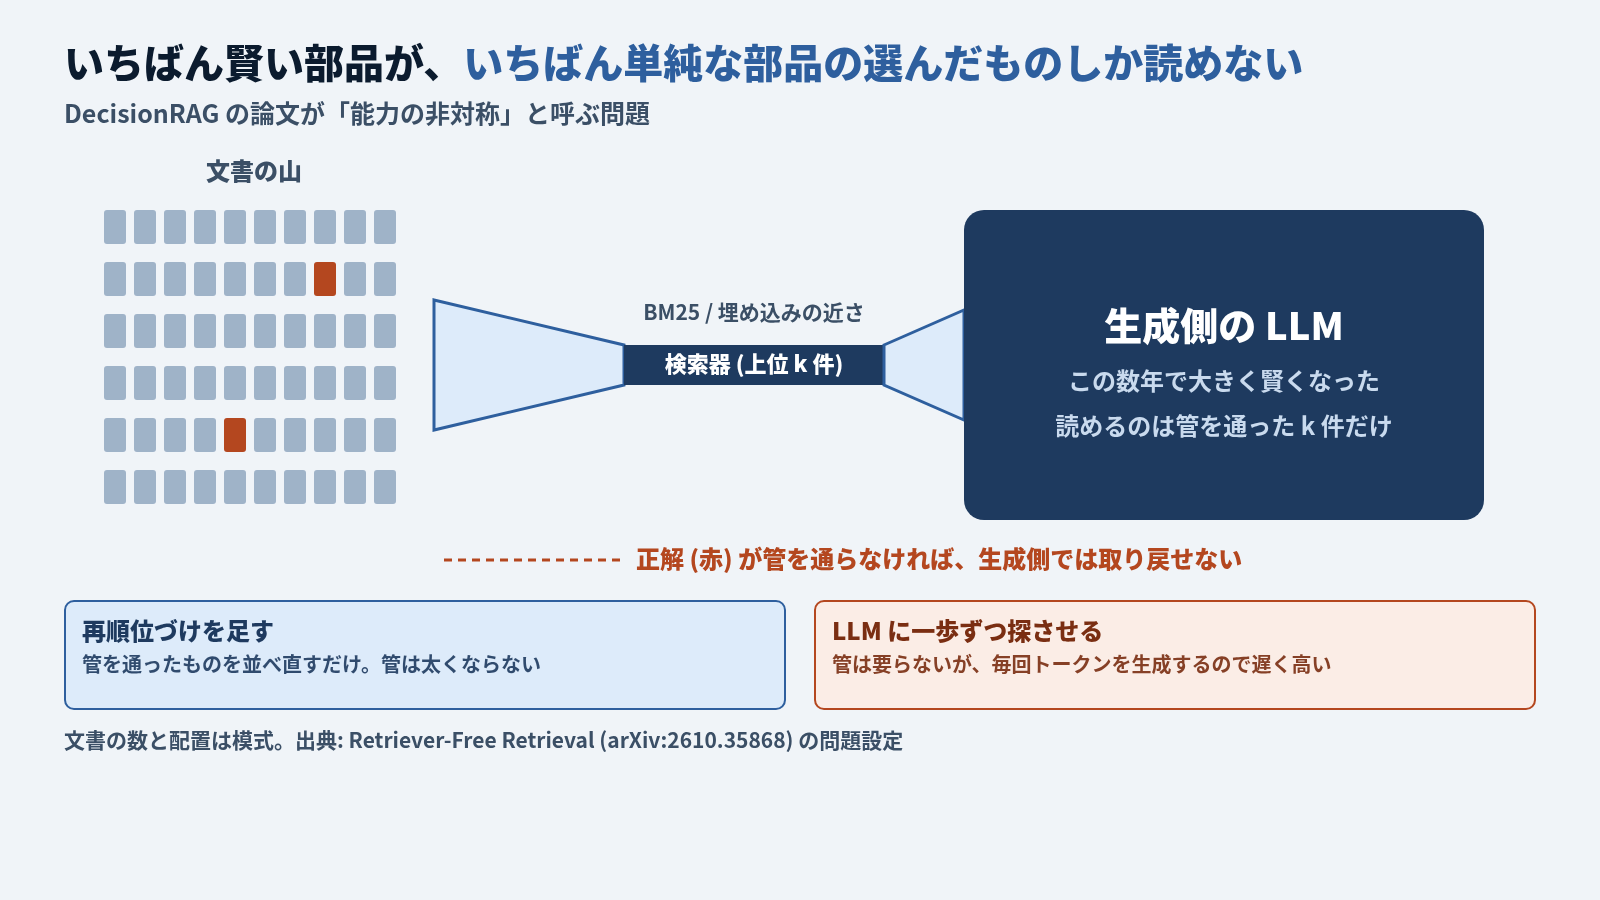
DecisionRAG の論文は、問題を1文で書いています。検索器が見つけられなかったものは、生成側がどれだけ強くても取り戻せない (arXiv:2610.35868)。
生成側の LLM はこの数年で大きく賢くなった一方で、何を読ませるかを決める検索器は、いまも単語の一致 (BM25) か決まった埋め込みの空間での近さ (ベクトル検索) で文書を選んでいます。論文はこれを能力の非対称と呼びます。いちばん賢い部品が、いちばん単純な部品の選んだものしか読めないのです。
再順位づけ (reranker。検索器が返した候補を、より重いモデルで並べ直す部品) を足しても、並べ直せるのは一段目が返したものだけです。エージェントが検索する段階のように LLM に一歩ずつ探させれば賢く選べますが、毎回トークンを生成するので遅く、高くつきます。
系譜: 木を作る、木をたどる
索引を木にして上からたどる考え方は、DecisionRAG が最初ではありません。論文自身も関連研究で、2023年10月の MemWalker を挙げています。長い文書から要約の木を作り、LLM がその木を読みながら下りていく方式です (arXiv:2310.05029)。
RAPTOR (2024年1月) は、チャンクを埋め込みでまとめて要約し、その要約をさらにまとめて要約する、を繰り返して下から木を作りました (arXiv:2401.18059)。細かいチャンクと全体の要約を別々の高さで引けるようにして、長い文書のあちこちに散った情報をまとめて使えるようにしたのが狙いです。GPT-4 と組み合わせると QuALITY というベンチマークで最高成績を絶対値で20%上げたと報告しています。木を作ったのは LLM ですが、木から引くときに使うのはまだ埋め込みの近さでした。
PageIndex (2025年4月にリポジトリ公開) は、Vectify AI が MIT ライセンスで公開しているオープンソースです (GitHub)。長い文書ごとに目次のような木を作り、LLM がその木を推論でたどります。ベクトルデータベースもチャンク分割も使わない「vectorless」をうたい、決算書や法律文書、技術マニュアルのような長い専門文書向けとしています。性能の数字は、ここでは引きません。
LATTICE (2025年10月) は、これを文書1本からコーパス全体に広げました (arXiv:2510.13217)。LLM が文書の要約を何段階も判断して、意味の木を上から作ります。検索のときは埋め込みモデルを使わず、LLM が木をたどります。推論が要る検索を集めた BRIGHT で nDCG@10 が46.7と、微調整した組み合わせの最良と並んだと報告しています。同じ LLM で再順位づけと比べると、使えるトークンが少ないうちは再順位づけのほうが得で、ある程度の予算を超えると LATTICE のほうが高いところまで伸びる、とも書いています。
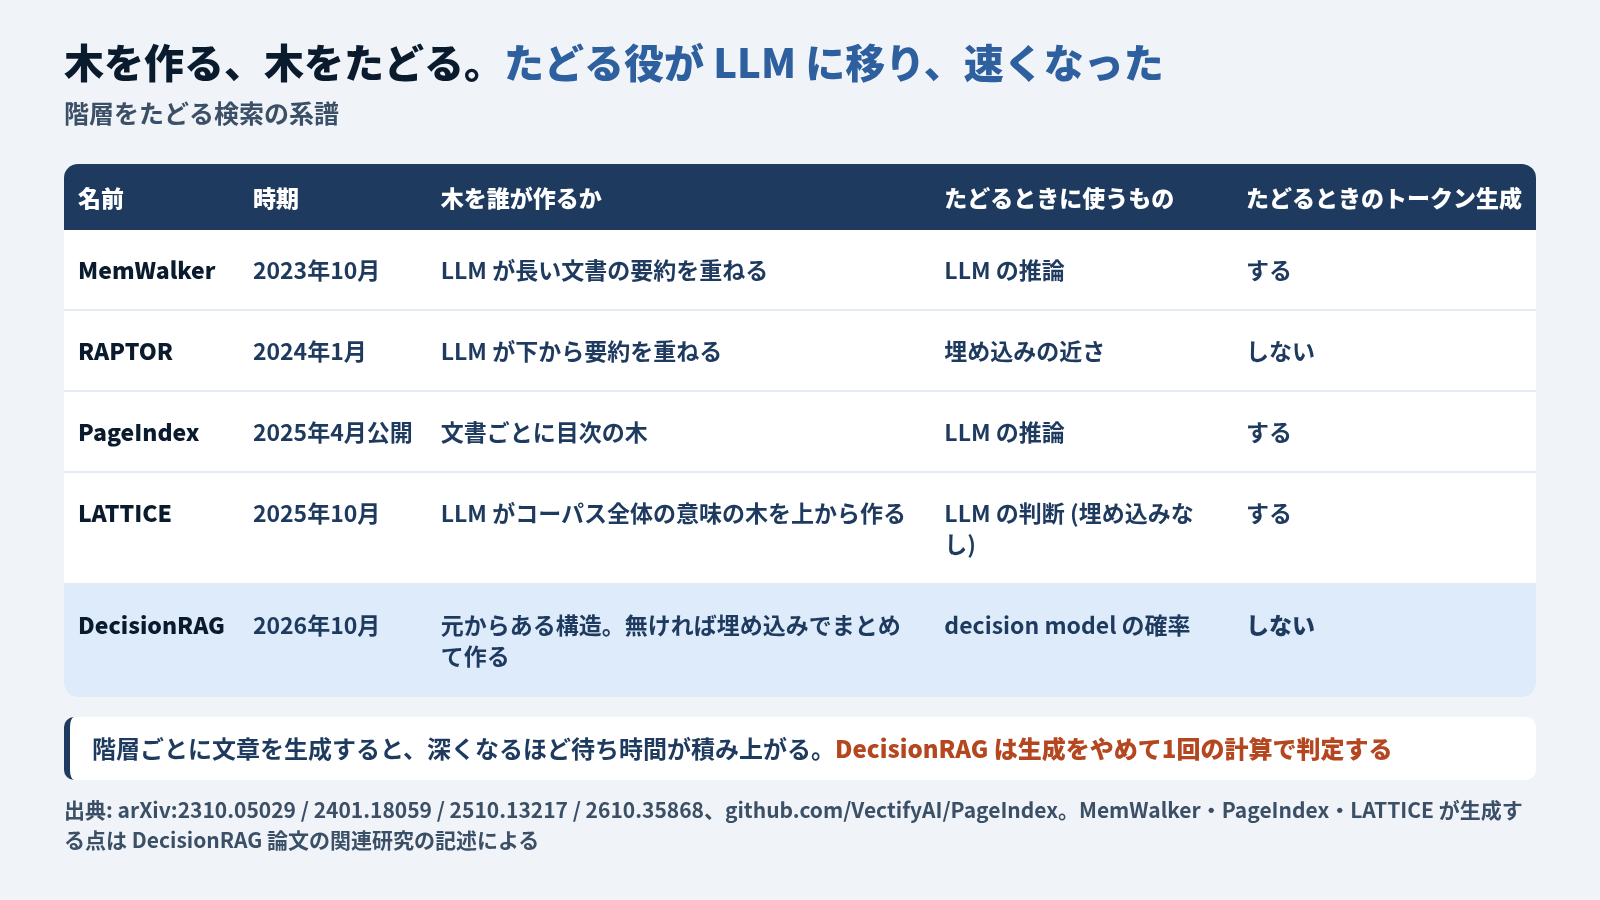
MemWalker、PageIndex、LATTICE は、各階層で LLM が文章を生成して判断します。階層が深くなるほど待ち時間が積み上がります。
DecisionRAG が変えたのはここです。
DecisionRAG の仕組み: 1回の計算でまとめて判定する
著者は Cornell 大学と ASAPP の Wan、Jünger、Du、Liu、Krishnan、Weinberger の6名です。中心にあるのは decision model と呼ぶ種類のモデルです。文脈と、はい/いいえで答える質問をたくさん渡すと、質問ごとに「はい」の確率を返します。文章は生成しません。何十もの質問に、同じ文脈の上で1回の計算 (forward pass) でまとめて答えます。論文は TypeSafe AI の Jev 1.13 という API で提供されているモデルを使っています。
論文のたとえは図書館です。棚の分類を見て、関係のありそうな棚にだけ行き、背表紙を見て本を選び、本を開いて段落を読む、という探し方です。DecisionRAG も同じように、上の階層から順に「この枝の先に答えがありそうか」を判定し、見込みのある枝だけを残して下ります。捨てた枝の先は一度も読みません。
Wikipedia から作った Natural Questions の例で数を追うと、こうなります。
- 108,626ページを、ページの題名と最初の1文の埋め込みで1,000のまとまりに分け、それぞれに Qwen3-8B で1文の説明を付けておく (検索の前に1回だけ)
- 質問が来たら、1,000の説明を8つの並列リクエストで判定して150を残す
- 残った150のまとまりに入っている約17,500のページ題名を判定して、ページを絞る
- 絞ったページの段落を判定し、最後に上位の段落を選択式で並べ直す
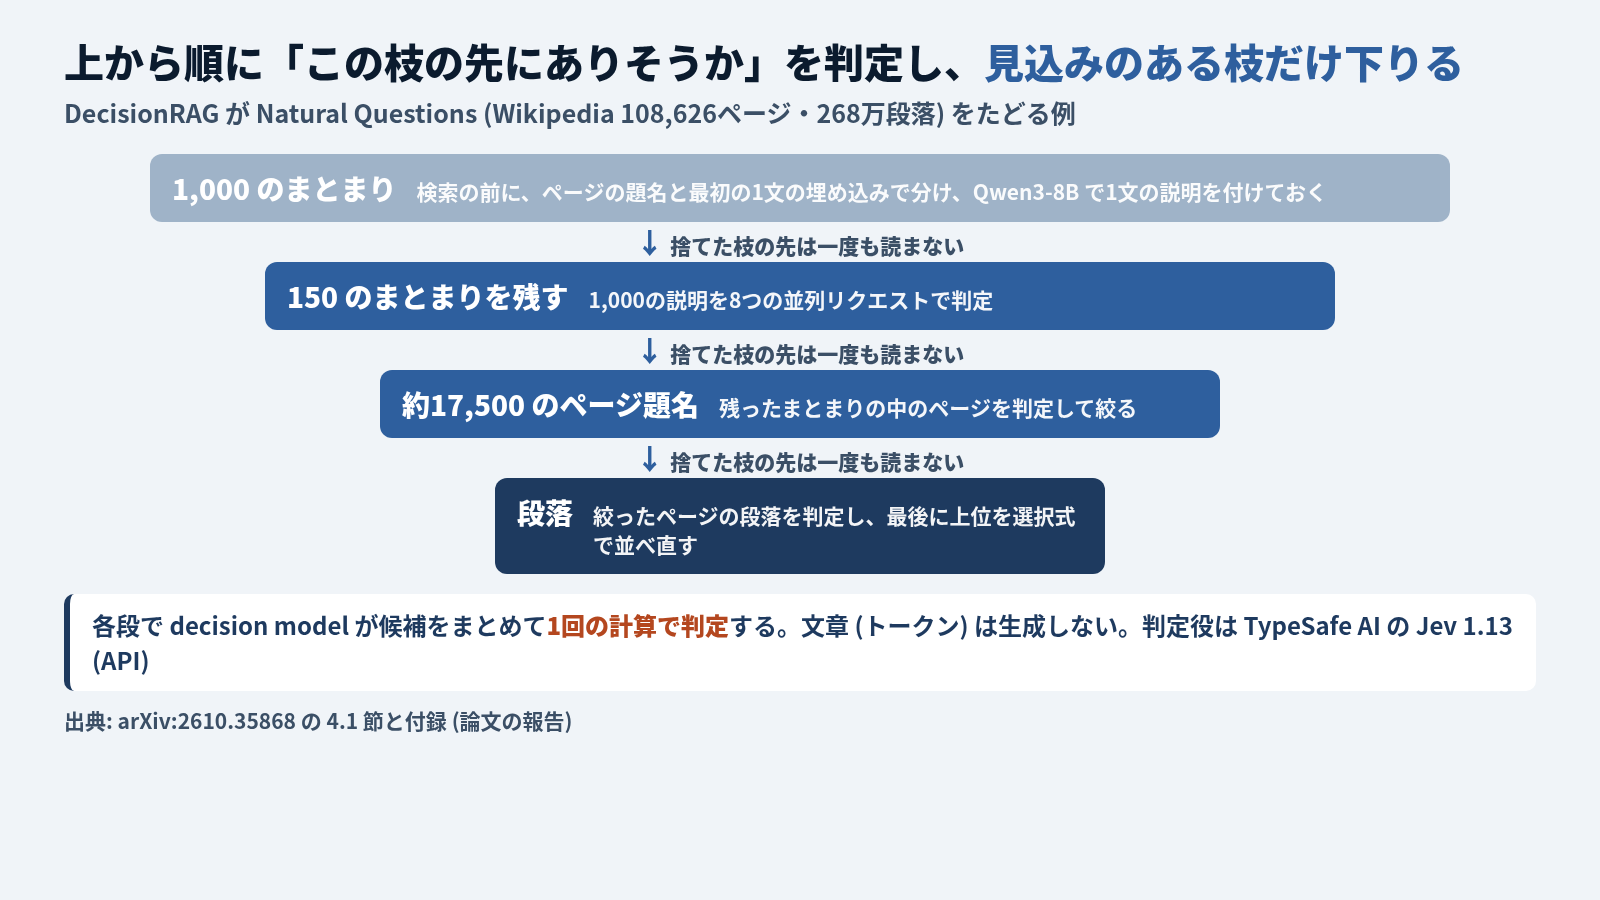
気をつけたい点が1つあります。「検索器なし」は、質問が来たあとの話です。Wikipedia にはページより上の構造が無いので、木を作る段階では埋め込みを使っています。MultiDoc2Dial ではヘルプセンター、ページ、段落という元からある構造をそのまま使いました。
候補を同じ文脈に並べて判定させることにも意味がある、と論文は書いています。単独で見れば関係ありそうな候補も、もっと良い候補が隣にあれば「はい」の確率が下がるので、確率どうしを比べやすくなるわけです。MultiDoc2Dial では、ページごとに別々に判定するより、まとめて判定したほうが1位の再現率が7.7ポイント高くなりました。
数字 (論文の自己申告)
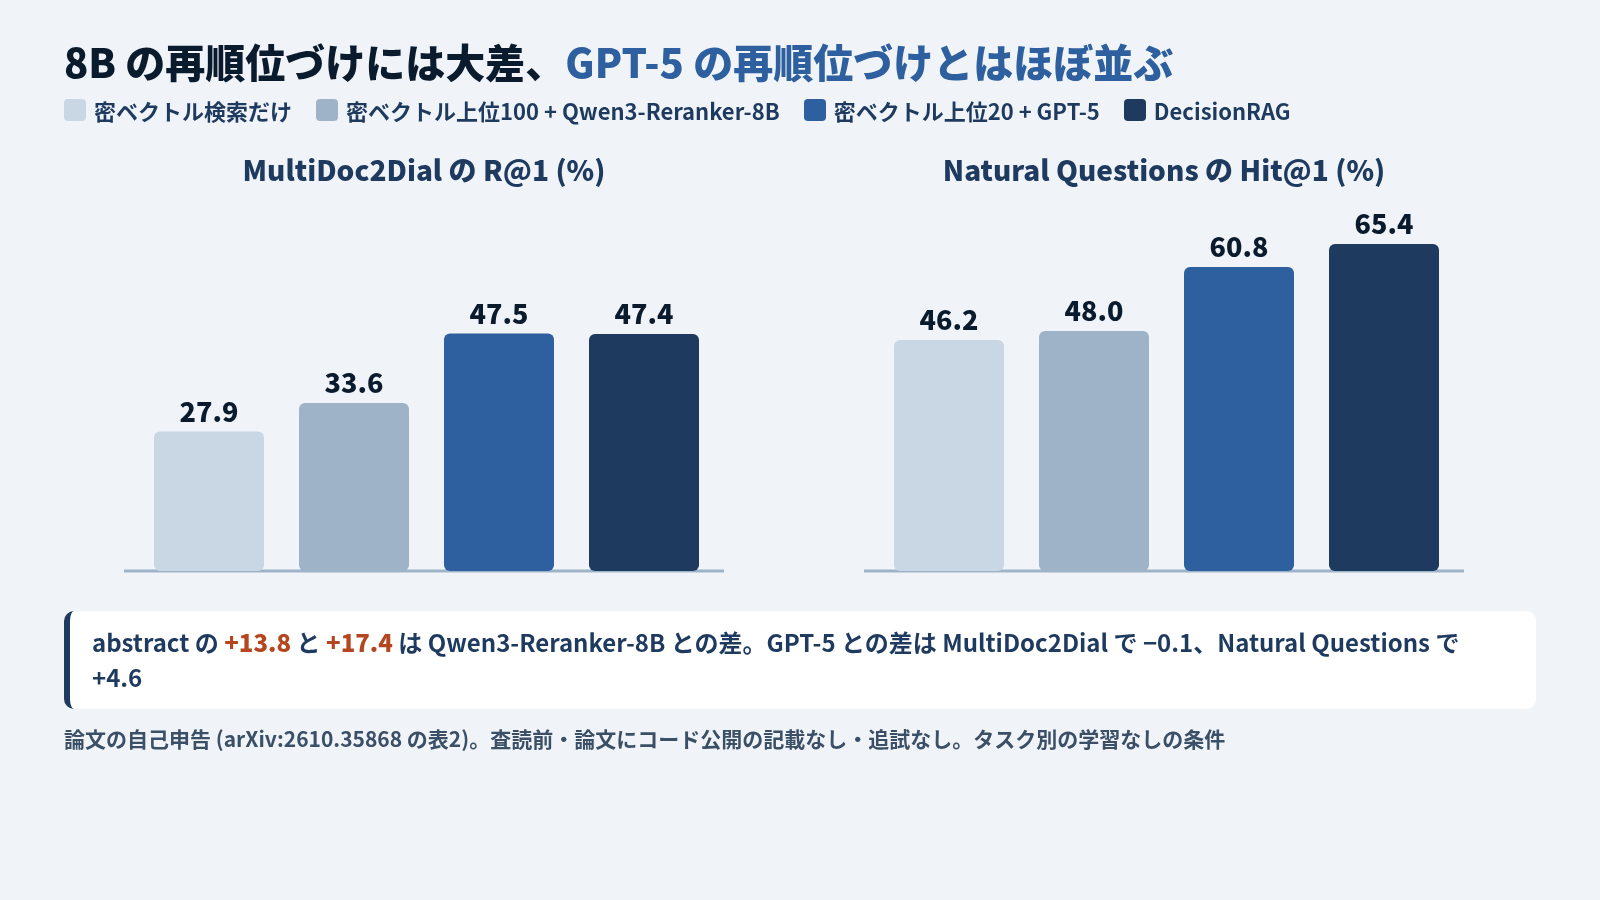
以下はどれも、査読前の論文の自己申告です。MultiDoc2Dial (ヘルプセンターの対話) の1位の再現率 (R@1) で、DecisionRAG は47.4%でした。密ベクトル検索の上位100件を Qwen3-Reranker-8B で再順位づけした方式は33.6%で、差は13.8ポイントです。Natural Questions の1位の的中率 (Hit@1) では65.4%で、同じ再順位づけ方式の48.0%を17.4ポイント上回りました。abstract が見出しに使っているのはこの2つの差です。
本文の表には、もう1つ比べる相手があります。密ベクトル検索の上位20件を GPT-5 に並べ直させた方式です。これとの差は、MultiDoc2Dial で47.4%対47.5%と並び、Natural Questions で65.4%対60.8%でした。
差はぐっと縮みます。
精度の差が縮む一方で、待ち時間には差が残ります。1問あたりの待ち時間の中央値は、DecisionRAG が0.68〜1.76秒でした。GPU 1枚で動かした Qwen3-Reranker-8B の方式は3.3〜14.3秒、GPT-5 で再順位づけする方式は11.8〜15.0秒です。同じ木を、文章を生成する LLM (GPT-5) にたどらせた場合と比べると、精度は一貫しては上がらず、待ち時間は34〜145倍だった、とも報告しています。ただし、この待ち時間には測り方の条件があります。DecisionRAG は提供元の API を実際に呼んで1問ずつ順に処理し、1問の中では最大8本のリクエストを並列に投げ、MTRAG では1段目を約40本の並列リクエストに分けています。測った問数はベンチマークごとに24〜100問で、木を作る前処理は時間に入っておらず、比べる側の GPT-5 の時間も、保存しておいた密ベクトル検索の上位20件を並べ直す部分だけを測ったものです。論文は付録で、機材も問数も揃っていないので、この比は条件を揃えた速度向上ではない (latency ratios are not controlled speedups) と断っています。費用も、DecisionRAG がいつも安いわけではありません。1問あたりの API 費用は、MultiDoc2Dial で0.22セント (GPT-5 の再順位づけは1.40セント) ですが、Natural Questions では2.33セントで、GPT-5 の1.40セントより高くつきます。
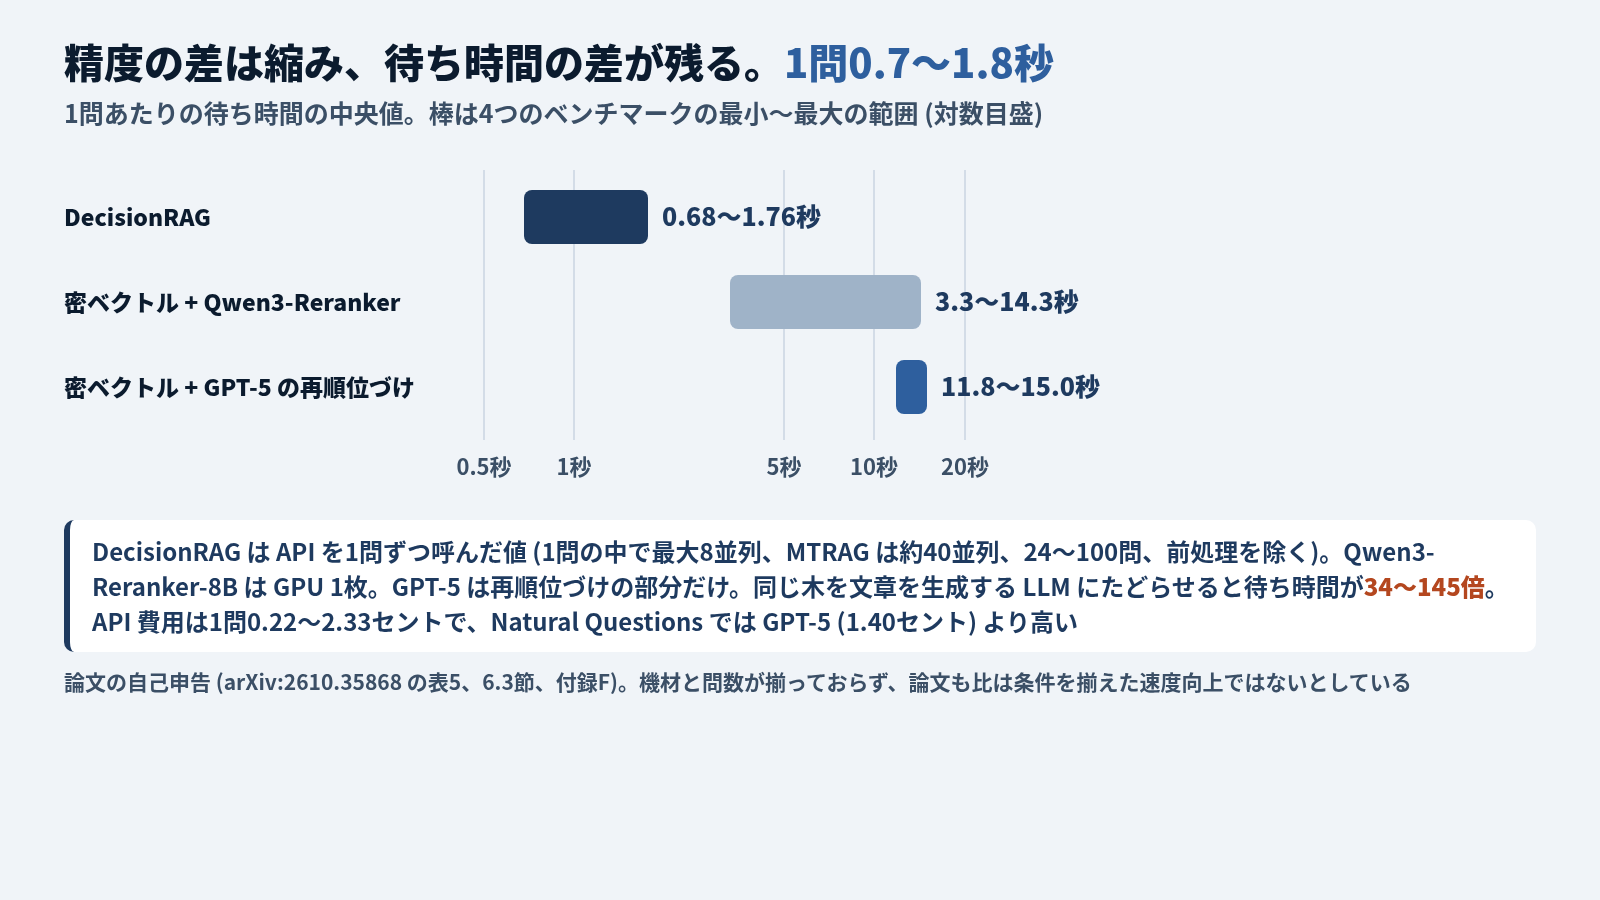
ベンチマークごとに、表の先頭に置かれた指標で GPT-5 の再順位づけと比べると、DecisionRAG は MTRAG と Natural Questions の2つで上、MultiDoc2Dial で並び、ConditionalQA で下でした (指標はベンチマークごとに R@1・Hit@1・R@5 と違います)。待ち時間は、ベンチマークごとに中央値の比をとると6.9〜17.6分の1です。ただし上の条件の違いがあるので、論文の主張を数字で言い直すなら「同程度の精度で、待ち時間は1桁ほど短い」が限度です。
Adaptive-RAG とどう違うか
名前に「判断」を掲げる手法はほかにもあります。よく似て見えるのが、自分で判断するRAGの章で扱った Adaptive-RAG (2024年3月、arXiv:2403.14403) です。どちらも「判断する RAG」ですが、判断している中身が違います。Adaptive-RAG はどれだけ検索するかを、DecisionRAG はどこに答えがあるかを判断します。
| Adaptive-RAG | DecisionRAG | |
|---|---|---|
| 判断すること | どれだけ検索するか (しない・1回・反復) | どこに答えがあるか (どのまとまり → どの文書 → どの段落) |
| 判断するとき | 検索の前に1回。質問を見て道を選ぶ | 検索の最中に、階層ごとに毎回 |
| 検索そのもの | 従来どおりの検索器 (BM25 や埋め込み) を使う | 質問のたびの検索器は使わず、判定で木をたどる |
| 判断する部品 | 小さな分類器 (T5 程度) | decision model (トークンを生成せず、候補の枝をまとめて採点) |
| 困りごと | 簡単な質問に検索しすぎ、難しい質問に検索が足りない | 検索器が取りこぼしたものは、生成側では取り戻せない |
| シリーズでの位置 | 判断の仕組みは人が設計し、判断を機械がする段階 | LLM が検索器そのものになる段階 |
図書館にたとえると、Adaptive-RAG は質問を聞いて「調べなくても答えられます」「目録を1回引けば足ります」「何度か行き来が要ります」と段取りを決める司書です。調べるときは、いつもの目録 (検索器) を引きます。DecisionRAG は、目録を使わずに棚を歩くやり方です。「歴史の棚 → 戦国の段 → この本 → この章」と、階層ごとに進む先を選んで下りていきます。
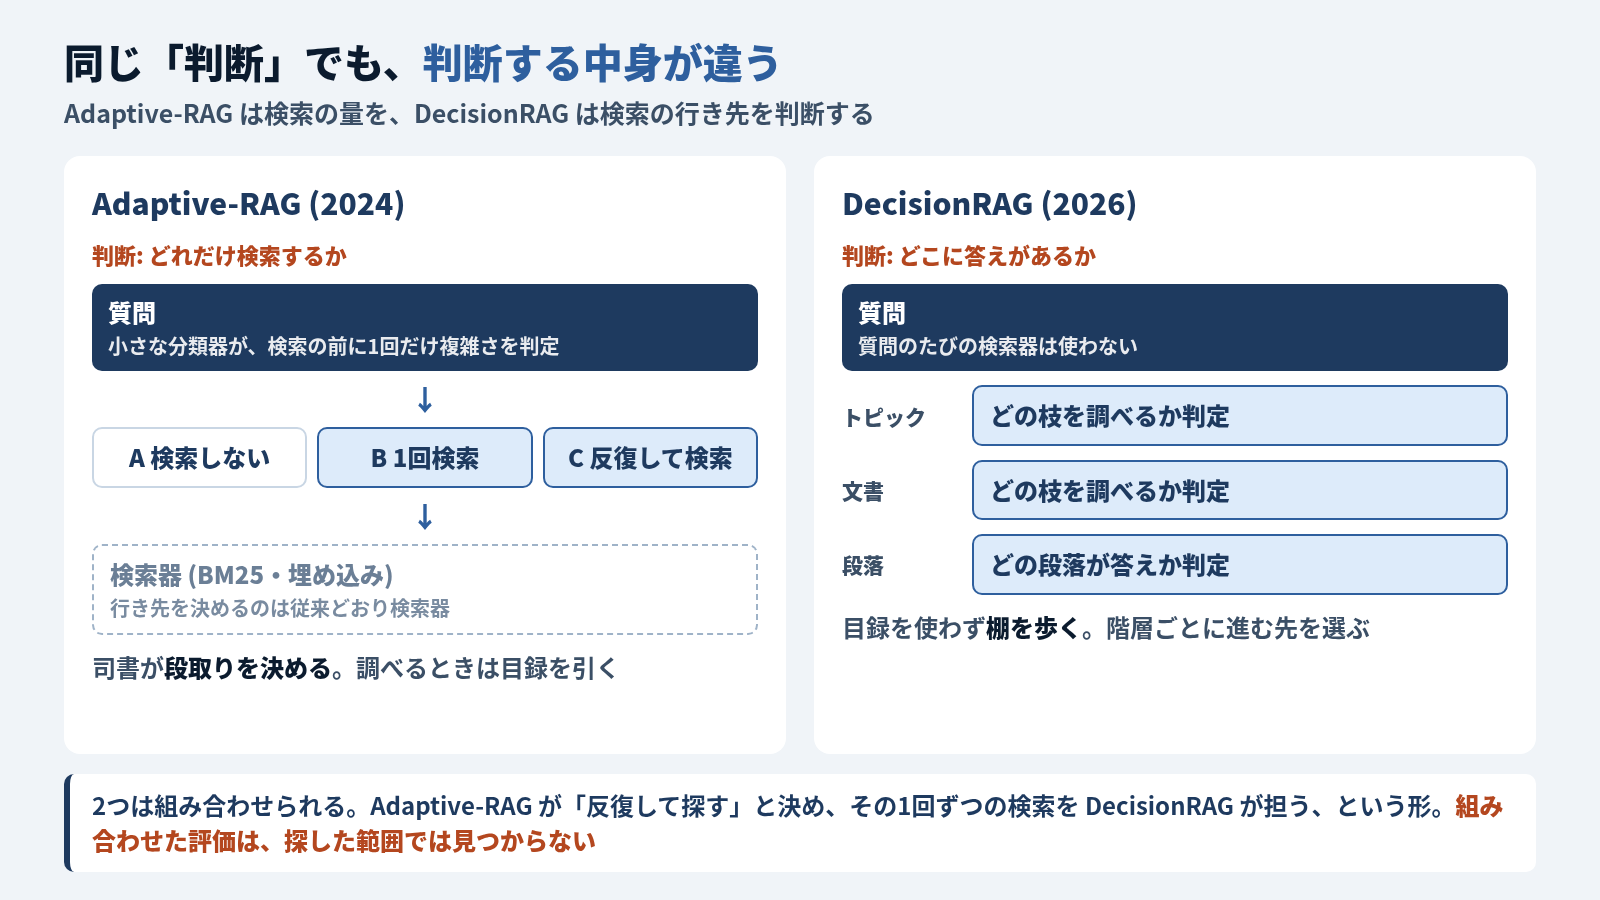
判断している場所が違うので、2つは組み合わせられます。Adaptive-RAG が「反復して探す」と決め、その1回ずつの検索を DecisionRAG が担う、という形です。ただし、組み合わせて測った評価は、私が探した範囲では見つかりませんでした。組み合わせて良くなるかどうかは、私の推論の段階です。
名前の似た手法 (Retriever Portfolios や JevRAG。Self-RAGとCRAG 検索を判断する7手法の章の後半) も、検索の量を決める側か行き先を決める側かで分けて読めば混同しません。
効かない条件
論文自身が限界を2つ書いています。1つ目は文書の構造と説明の質に頼ることで、整理されていない文書や中身の分からない見出しでは、どの枝が見込みありかを判定できずに精度が落ちます。
2つ目は、捨てた枝は取り戻せないことです。Natural Questions のテスト問題のうち最初の100問で、上の階層に残すまとまりの割合を変えた実験では、15%残せば、全ページの題名を平らに判定したのと同程度の上位10件の再現率 (86.2%と84.5%) を、5分の1の費用で出せました。5%を下回ると正解の入ったまとまりを捨てることが増え、1%では上位10件の再現率が63.7%まで落ちています。
この弱点の手当てとして、論文は最後の段に密ベクトル検索の上位20件を足す設定を試しています。表のほとんどの指標で最も成績が良かったのはこの設定でした (Natural Questions の R@10 だけは Qwen3-Reranker の89.0が上)。
ベクトル検索は捨てられていません。見落とした分を拾う役です。
限界として書かれてはいませんが、論文が評価していない問いもあります。4つのベンチマークは、答えの根拠となる段落を探す質問です。複数の文書をまたいで答えを組み立てる多段の質問、文書群の全体を問う質問、文書が更新されたときの木の作り直しは、評価の対象に入っていません。木を作る費用についても、付録は「DecisionRAG は段落を一切埋め込まない。木を作るのに前処理が要るのは Natural Questions だけ」(DecisionRAG encodes no passages. Only on Natural Questions does building the hierarchy require an offline pass) と書くにとどまり、文書が増えたり変わったりしたときの手間は測られていません。GraphRAG 系譜とベクトル検索との実測比較の章で見た全体を問う質問に効くかどうかは、この論文からは分かりません。
日本では
LLM が索引の木をたどる検索や、ベクトルを使わない検索の、数値つきの国内事例は、私が探した範囲では見つかりませんでした。
いちばん近いのは、弥生と筑波大学の2025年の研究です。会計の解説ページの検索で、ベクトル検索の結果を LLM に再順位づけさせて1位の正答率を上げました。ただしこれは一段目をベクトル検索のまま、そのあとで LLM が並べ直す方式で、DecisionRAG とは LLM が入る位置が違います。数字と条件はハイブリッド検索 RAGの外れを3分の1にの章で扱っています。
規程集やマニュアルのように章と節の見出しを持つ文書群なら、木をたどる型を試す前提は揃いやすいはずです。一方で、DecisionRAG の判定役は海外の API で提供されているモデルでした。社内文書を外に出せない環境では、手元で動く decision model が出てくるまで試しにくいでしょう。どちらも私の推論で、測ってはいません。
シリーズの振り返り: 検索の判断を誰が持つか
9つの章を「検索の判断を誰が持つか」で並べ直すと、判断は少しずつ人の手から LLM へ移ってきました。
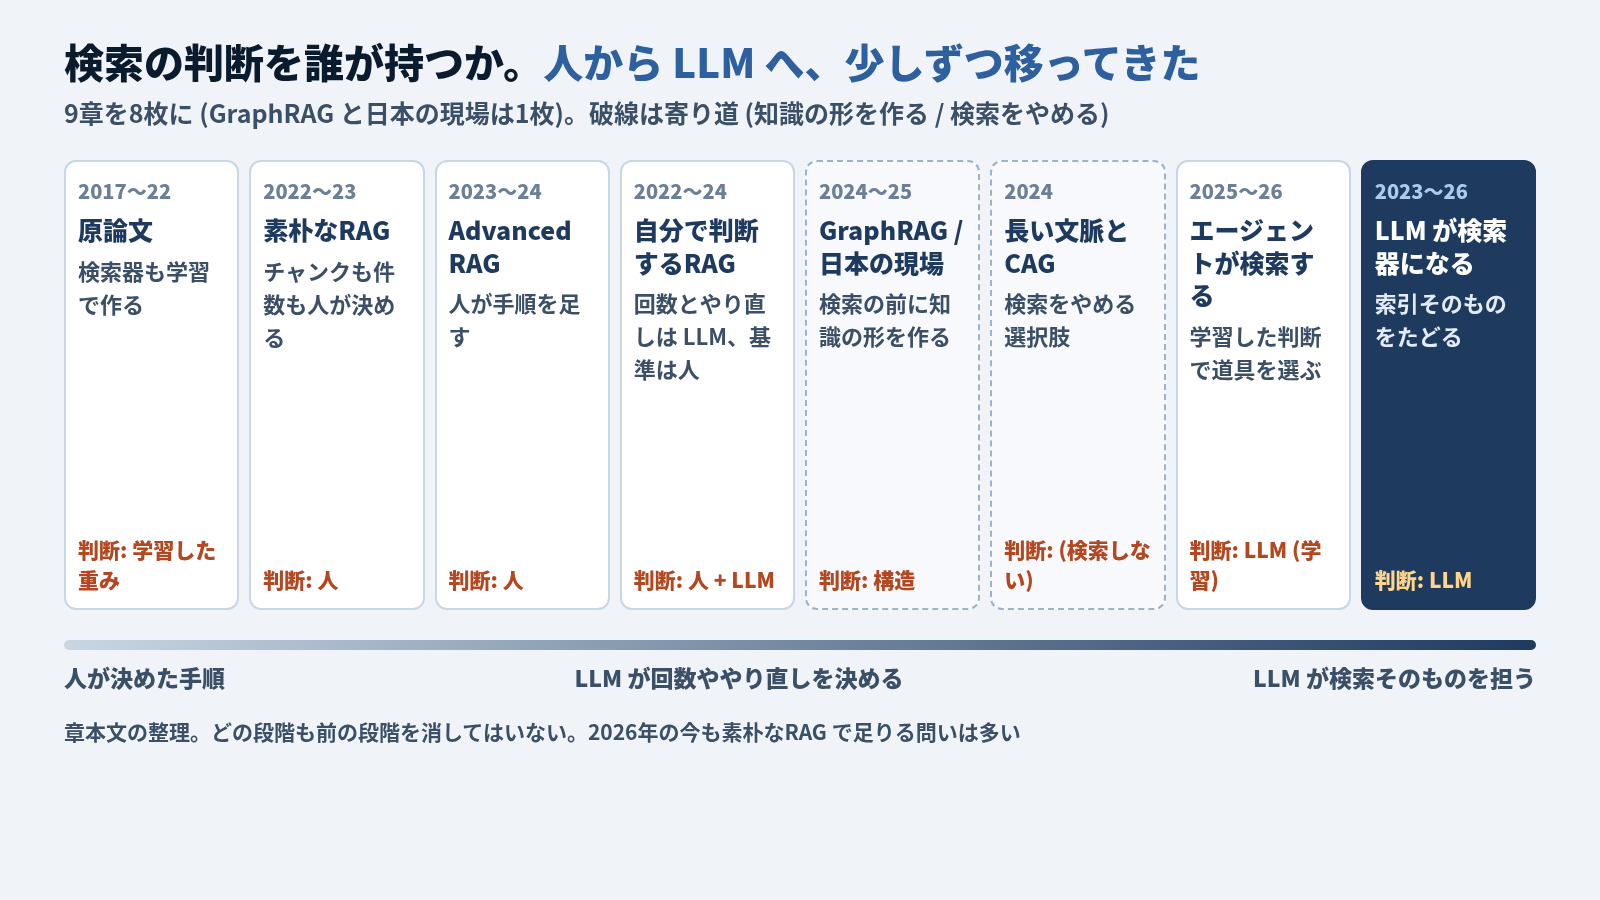
素朴なRAG では、チャンクの大きさも、何件引くかも、人が決めていました。Advanced RAG では、人が手順を足しました。自分で判断するRAG で、LLM が検索の回数ややり直しを決めるようになりましたが、何を見て決めるかの基準は人が書いていました。エージェントが検索する段階で、その基準も強化学習で学ばれるようになり、検索は道具の1つになりました。そして LLM が検索器になる段階で、LLM は道具の外から内へ入り、索引そのものをたどり始めています。
途中には寄り道もありました。GraphRAG と日本の現場の章は、検索の前に知識の形を整える話でした。長い文脈と CAG は、検索をやめるという選択肢でした。どの段階も、前の段階の困りごとから出てきていて、前の段階を消してはいません。2026年の今も、素朴なRAG で足りる問いはたくさんあります。どの段階を選ぶかは、問いの形と文書の形で決まります。状況ごとにどれが残るかは、シリーズの入口の「自分ならどれか」にまとめています。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?