コンテキストウィンドウ100万でもRAGが残る理由
2024年、LLM が一度に読める長さ (文脈窓) が100万トークンまで伸び、「知識を全部入れてしまえば検索は要らないのでは」という問いが現実の選択肢になりました。比べた論文が出した答えは、使い分けでした。計算資源を十分に使えば長い文脈 (長文脈) をそのまま読ませるほうが平均点は上でしたが、費用は検索のほうがはるかに安く、しかも6割を超える質問で両者の答えは一致していました。
使い分けの線は3本です。知識の量が文脈窓に収まるか、費用として毎回の入力トークンを払えるか、更新頻度が低いか。3つとも当てはまるなら、知識を先に全部読ませてキャッシュする CAG (Cache-Augmented Generation) が成り立ちます。どれか1つでも外れるなら、検索は残ります。
困りごと: 全部入れれば検索は要らないのか
Advanced RAG と自分で判断するRAG は、検索器 (質問に合う文書を索引から引いてくる部品) の使い方を良くする工夫でした。Advanced RAG は質問を書き直して検索結果を再順位づけで並べ直し、自分で判断するRAG は検索するかどうかややり直すかどうかを LLM に決めさせました。GraphRAG と日本の技能伝承の章は、検索の前に知識の形を整えました。それでも、検索器が上位に拾わなかった文書は LLM の目に入りませんし、チャンクの切れ目で答えが2つに割れることもあります。
そこに出てきたのが、もっと素朴な問いです。選ぶから外すのであって、全部渡せば外しようがないのでは。
2024年2月: 100万トークンの文脈窓
きっかけは2024年2月15日の Gemini 1.5 の発表です (Google)。標準の文脈窓は128,000トークンで、限られた開発者と企業向けに最大100万トークンを試験提供するとしたうえで、100万トークンなら1時間の動画、11時間の音声、3万行を超えるコード、70万語を超える文章を一度に扱えるとも、研究段階では1,000万トークンまで試したとも書かれています。長い文章の中に1つだけ埋めた文を探させる試験 (needle in a haystack) では、100万トークンの長さで99%見つけたそうです。
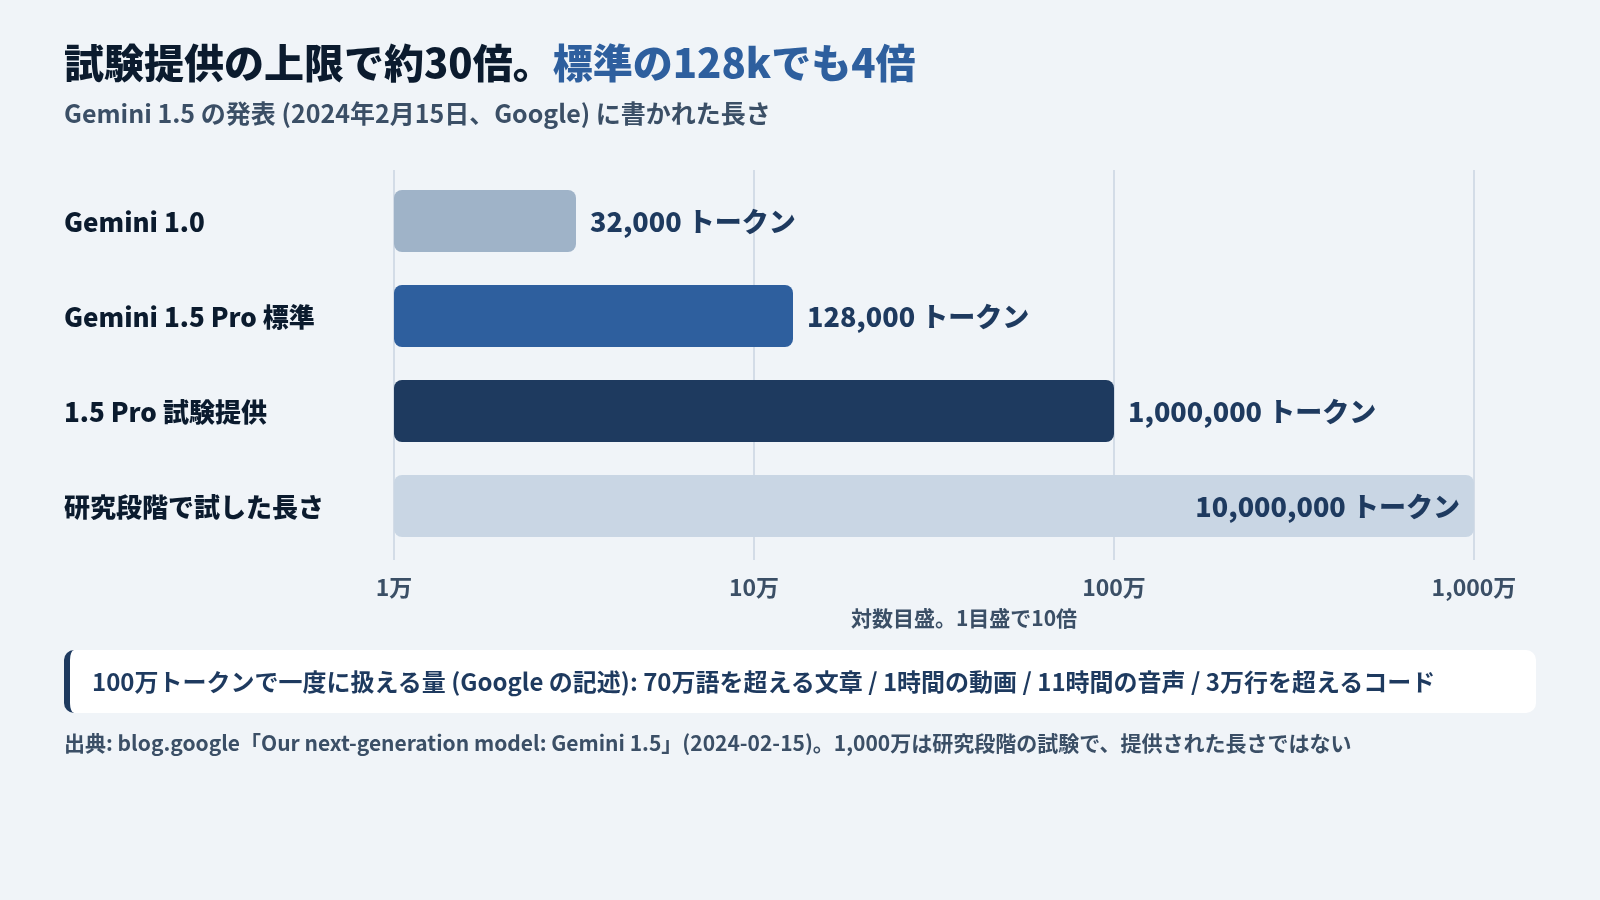
前の世代の Gemini 1.0 は32,000トークンでした。試験提供の上限で比べると約30倍、標準の128,000トークンで比べても4倍です。
社内の規程集やマニュアル1冊なら丸ごと収まる長さになり、「RAG は要らなくなる」という議論が出ました。ただ、この言い回しを誰が最初に言ったのかは、私が探した範囲では特定できなかったので、ここでは「そういう議論が出た」とだけ書いておきます。
先に答えていた論文: 4Kと検索で16Kに並ぶ
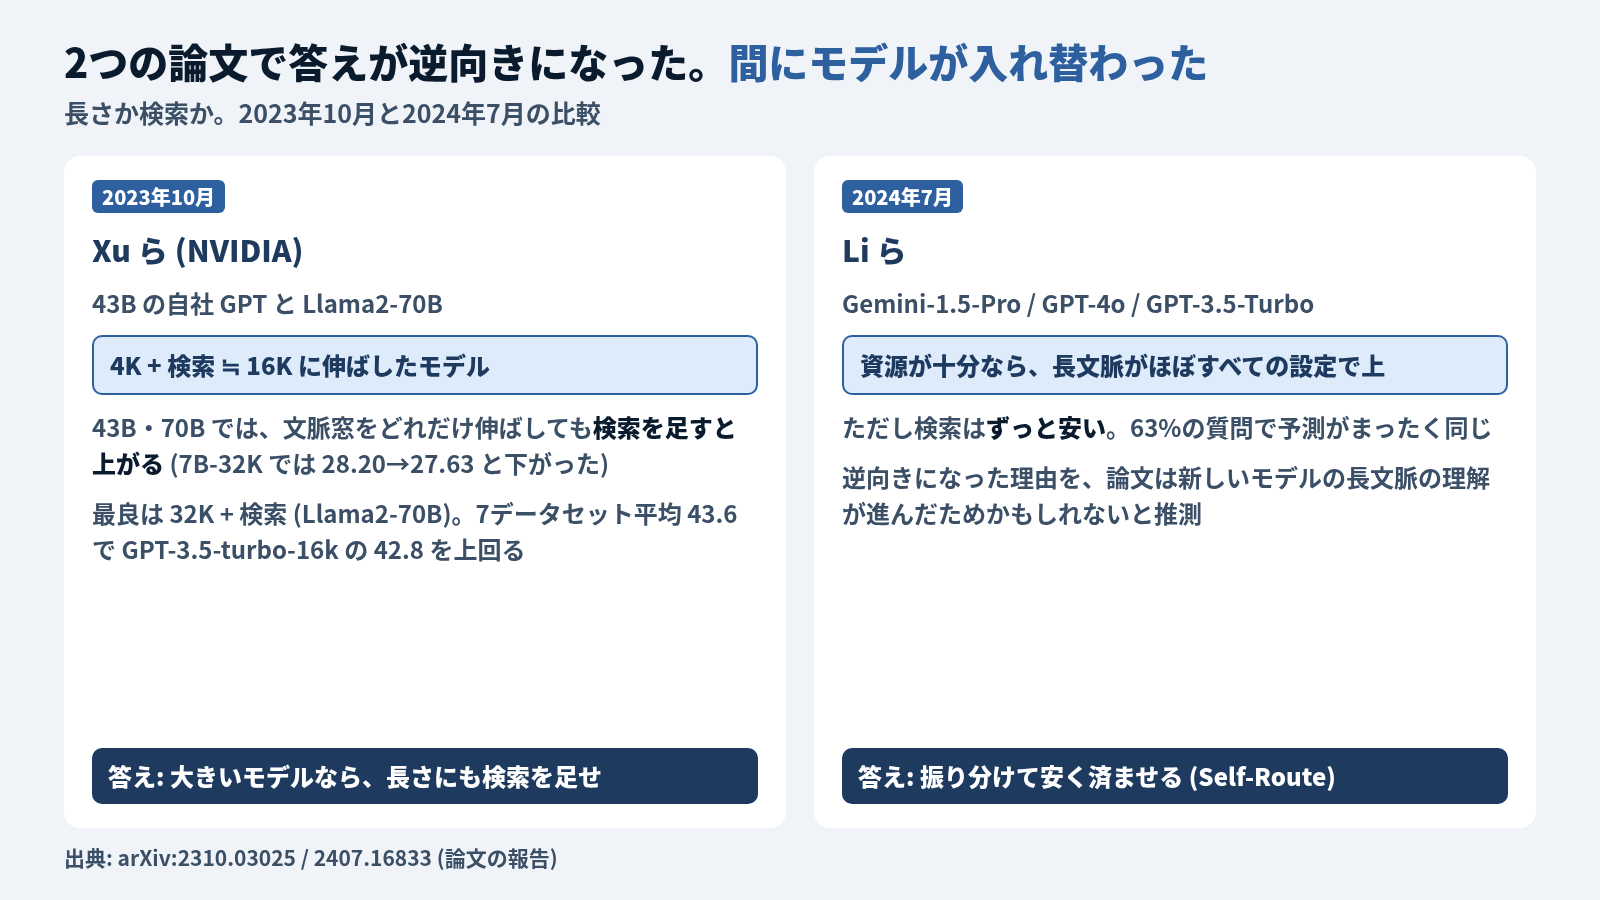
実はこの問いには、Gemini 1.5 より前に答えた論文があります。NVIDIA の Xu らが2023年10月に出した Retrieval meets Long Context Large Language Models です (arXiv:2310.03025)。43B の自社 GPT と Llama2-70B を使い、文脈窓を4,000トークンのまま検索を足したモデルと、文脈窓を16,000トークンに伸ばして微調整したモデルを比べました。結果は、4K に単純な検索を足しただけで、16K に伸ばしたモデルと同程度です。計算量はずっと少なく済みます。さらに、43B と70B のモデルでは、文脈窓をどれだけ伸ばしても検索を足すと成績が上がりました。ただし追加で試した小さい Llama2-7B では、32K に伸ばしたモデルに検索を足すと平均が28.20から27.63に下がっています。いちばん良かったのは、32K に伸ばした Llama2-70B に検索を足した組み合わせで、7つのデータセットの平均で43.6と、GPT-3.5-turbo-16k の42.8を上回っています。
長さか検索か、という問いへのこの論文の答えは「大きいモデルなら、長さにも検索を足せ」でした。
2024年7月: 資源が十分なら長文脈が勝つ。ただし検索は安い
Gemini 1.5 と GPT-4o が出たあとで比べ直したのが、Li らの2024年7月の論文です (arXiv:2407.16833)。Gemini-1.5-Pro・GPT-4o・GPT-3.5-Turbo の3つで、公開データセットを使って検索と長文脈を比べています。結果は Xu らと逆向きでした。計算資源を十分に使えば、長文脈はほぼすべての設定で検索より平均点が高くなりました。 論文は、差が出た理由を新しいモデルの長文脈の理解が進んだためかもしれないと推測しています。
それでも検索には残る理由がありました。費用です。
API の料金は入力トークン数で決まるので、検索で文脈を短くすれば安くなりますし、両者の答えを突き合わせると、63%の質問で予測がまったく同じで、70%の質問では点数の差が10未満でした。正解も間違いも、同じところで同じように出していたのです。
そこで論文は Self-Route という組み合わせ方を提案しました。
まず検索したチャンクだけを LLM に渡し、「このチャンクで答えられるか」を本人に判定させます。答えられると言えばその答えを使い、答えられないと言った質問だけ全文を渡して長文脈で解かせます。Gemini-1.5-Pro では82%の質問が最初の段で片付き、長文脈と同程度の成績のまま、費用は Gemini-1.5-Pro で65%、GPT-4o で39%下がったと報告されています。
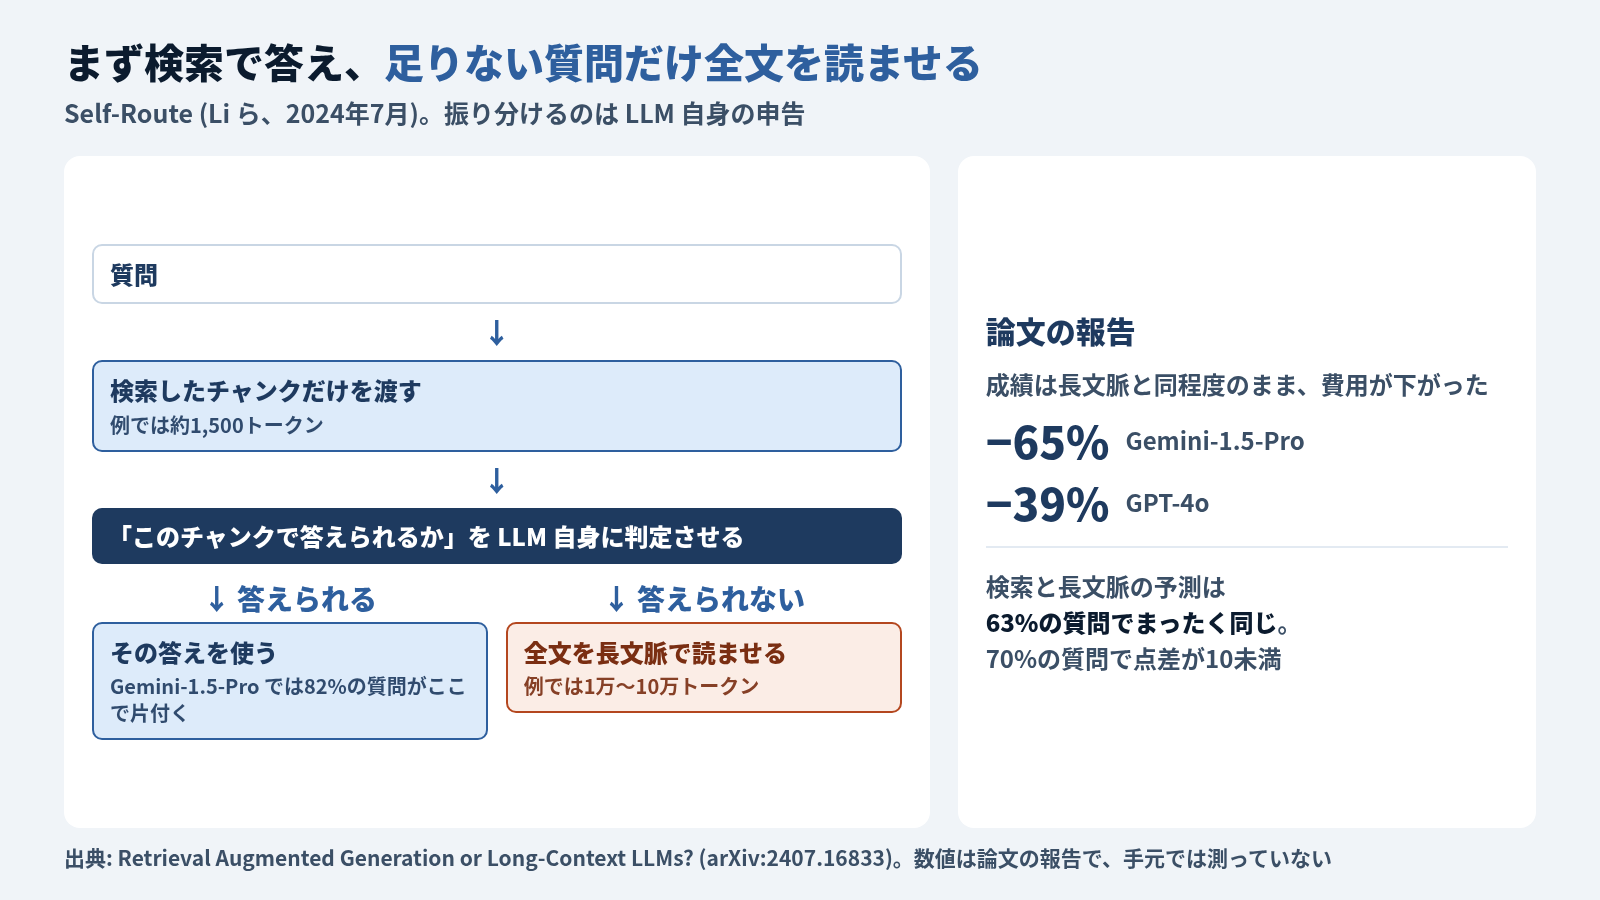
ここで判断しているのは LLM です。
検索で足りるかどうかを、人が決めたしきい値を使わず、LLM 自身の申告で振り分けています。この「判断を誰が持つか」の移り方は、次の Agentic RAG の段階でさらに進みます。
長く入れると真ん中が抜ける
「全部入れれば外さない」には、入れたものを LLM が全部使える、というもう1つの前提があります。2023年7月の Lost in the Middle は、答えの載った文書が並びの真ん中にあると正答率が大きく落ちることを示しました (arXiv:2307.03172)。実験の中身と数字はベクトルデータベース7種を実測 素朴なRAGの章で扱っています。
Gemini 1.5 は、長い文章に1つだけ埋めた文を99%見つけたと書いていました。埋めた文を1つ探すことと、散らばった複数の事実を拾って組み合わせることは別の仕事なので、99%は「長く入れたものを全部使える」ことの証明にはなりません。しかも、埋めた文を探す型の試験でも劣化は出ます。Anthropic は2025年9月の記事で、needle in a haystack 型の試験から、文脈のトークンが増えるほど中身を正確に思い出す力が落ちる現象 (context rot) が見つかったと書き、程度の差はあってもすべてのモデルに出るとしています (Anthropic)。
長く入れられることと、長く入れたものを使えることは、分けて考える必要があります。
2024年12月: CAG、小さい知識は先に全部読ませる
それでも、知識が小さければ全部入れる方式は強いままです。そこを方式として定めたのが、2024年12月の Don’t Do RAG: When Cache-Augmented Generation is All You Need for Knowledge Tasks です (arXiv:2412.15605)。
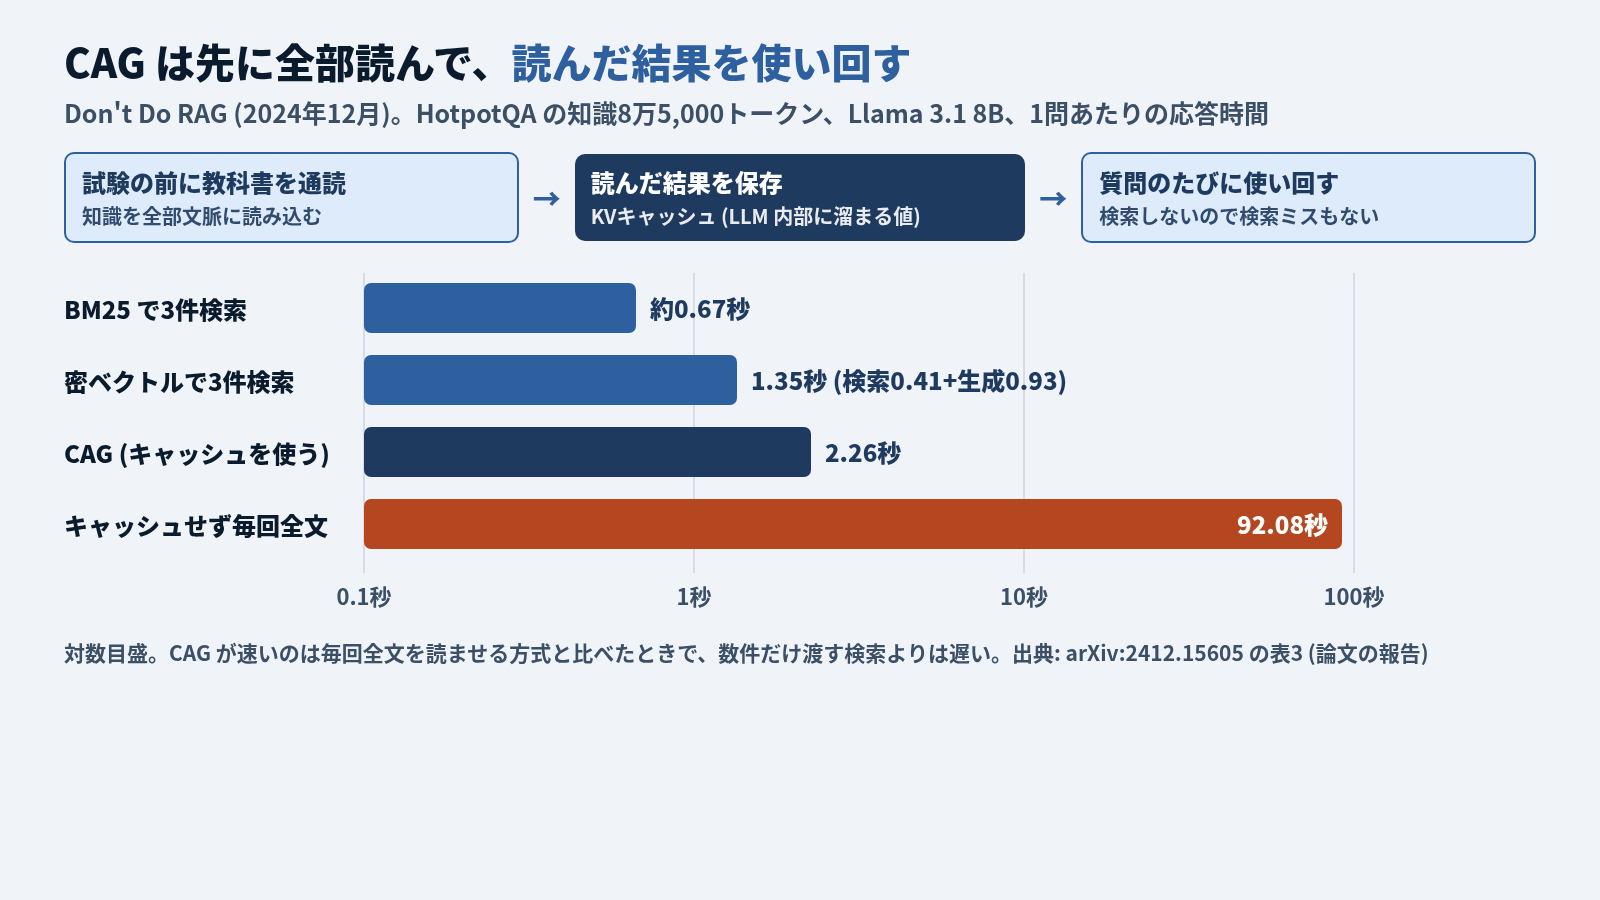
仕組みを試験勉強にたとえます。RAG は質問が来るたびに教科書の索引を引いて該当ページを開く方式で、CAG は試験の前に教科書を1冊通読しておく方式です。
LLM が文章を読むと、途中の計算結果 (KVキャッシュ。読んだ内容を後で参照するために LLM 内部に溜めておく値) ができ、CAG はこれを保存しておいて質問のたびに使い回します。毎回全文を読み直さないので速く、検索しないので検索ミスもありません。
論文は Llama 3.1 8B を使い、HotpotQA から2万1,000〜8万5,000トークン、SQuAD から2万1,000〜5万トークンの知識を作って比べました。回答の近さ (BERTScore) では、小と中の大きさで両データとも CAG が検索 (BM25 と密ベクトルの両方) を上回りました。いちばん大きい8万5,000トークンの HotpotQA では、BM25 で3件か5件検索したほうが上です。知識が大きくなるほど差は縮み、HotpotQA では逆転しました。ただし最大5万トークンの SQuAD では、いちばん大きい設定でも CAG が上のままです。
速さの差ははっきりしています。8万5,000トークンの HotpotQA で、キャッシュせずに毎回全文を読ませると生成に92.08秒かかりました。CAG は2.26秒です。ただし BM25 で3件だけ渡す検索は約0.67秒で、CAG より速く済みます。CAG が速いのは「毎回全文を読む」方式と比べたときです。
論文自身が限界も書いています。知識を全部文脈に載せるので、小さい会社の社内知識、FAQ、コールセンターのように、量が扱える大きさの用途に向く。大きなデータでは実用的でない、と。
使い分けの3本の線
ここまでの論文を並べると、検索をやめられる条件が見えてきます。
- 量: 知識が文脈窓に収まるか。収まっても、長いほど真ん中が抜けやすくなる
- 費用: 質問のたびに全文ぶんの入力トークンを払えるか。CAG はキャッシュで読み直しを省けるが、キャッシュを持っておく側の費用がかかる
- 更新頻度: 知識が変わるたびにキャッシュを作り直せるか。検索なら、変わった文書の索引だけ差し替えれば済む
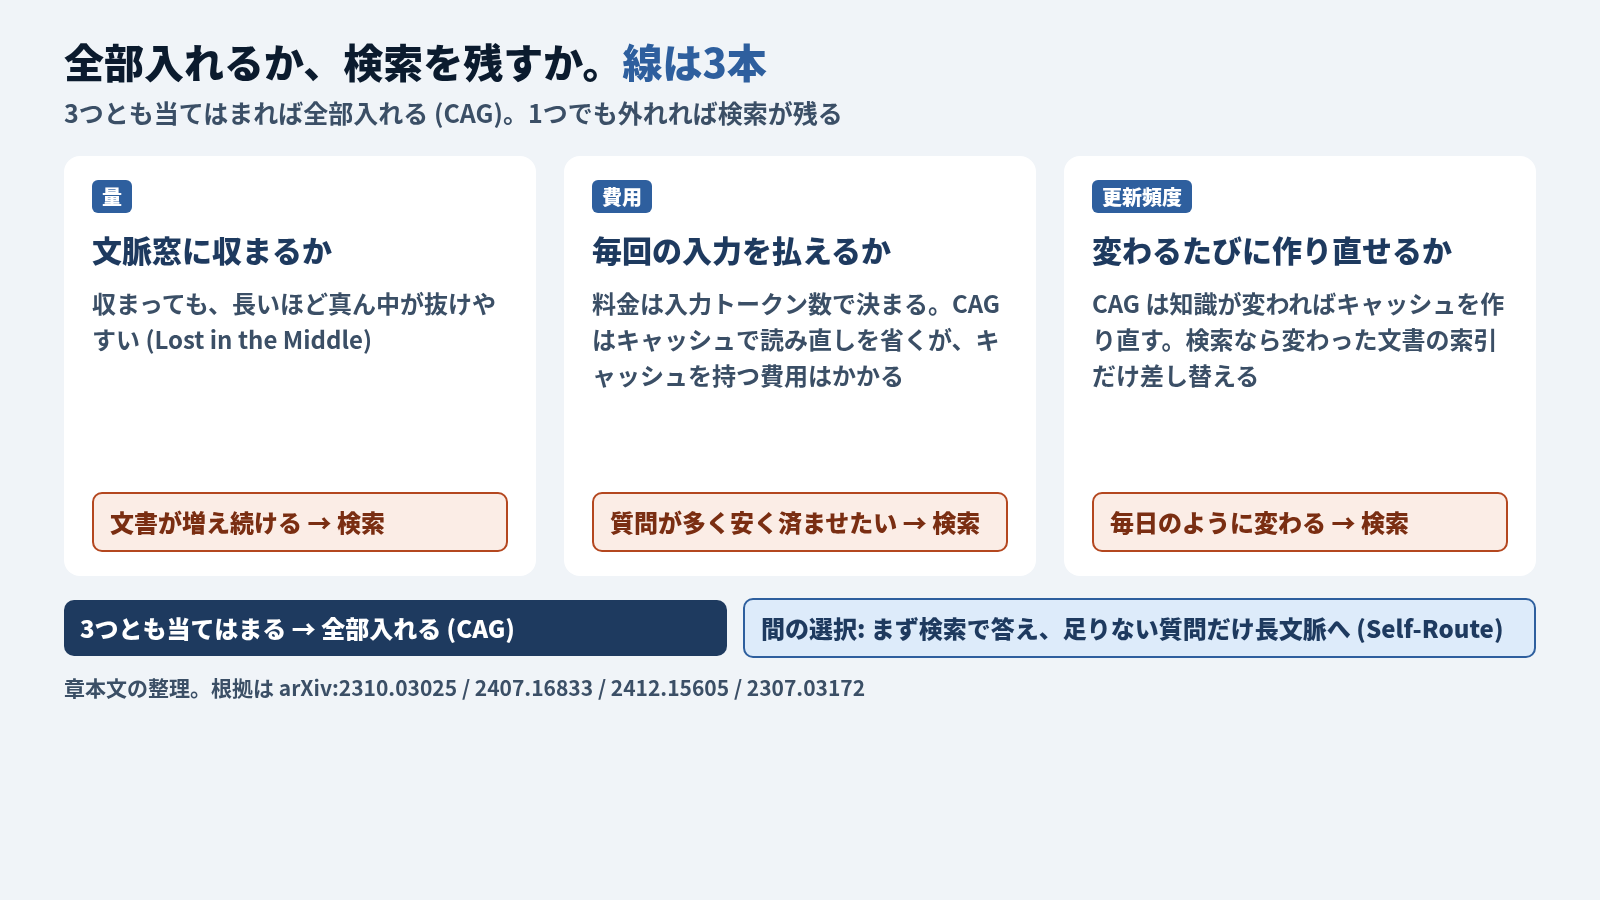
3本とも満たせば全部入れ、どれかが外れれば検索を残します。その間に、Self-Route のように両方を持って質問ごとに振り分ける選択があります。
「RAG は要らなくなるか」と聞かれたら、要らなくなる範囲はある、と答えます。その範囲は思ったより狭いはずです。社内文書は改定が多いので、特に更新頻度の線が外れやすいと私は見ています。これは推論で、測ってはいません。
日本では
日本語で長文脈と検索を比べた国内の公開事例は、私が探した範囲では見つかりませんでした。
代わりに、日本の社内文書に当てはめるときに効いてくる論点が1つあります。表と画像が多いことです。
奈良先端大などの JDocQA は、5,504件の PDF 文書に1万1,600件の日本語の質問と回答を付けたデータセットです (arXiv:2403.19454)。報告書、スライド、パンフレット、Web ページを集めており、答えるには文章だけでなく図や表の理解が要る、と作った側が書いています。
もう1つは Allganize が公開した RAG-Evaluation-Dataset-JA です (Hugging Face)。金融・情報通信・製造・公共・流通小売の5業種で PDF を集め、業種ごとに60問、計300問を作っています。各質問について、答えの根拠が段落・表・画像のどれにあるかを記録しており、その割合は文書のページに出てくる頻度を反映させたと書かれています。集計すると、段落142問、表83問、画像75問。表か画像に根拠がある質問が約半分 (300問中158問) です。
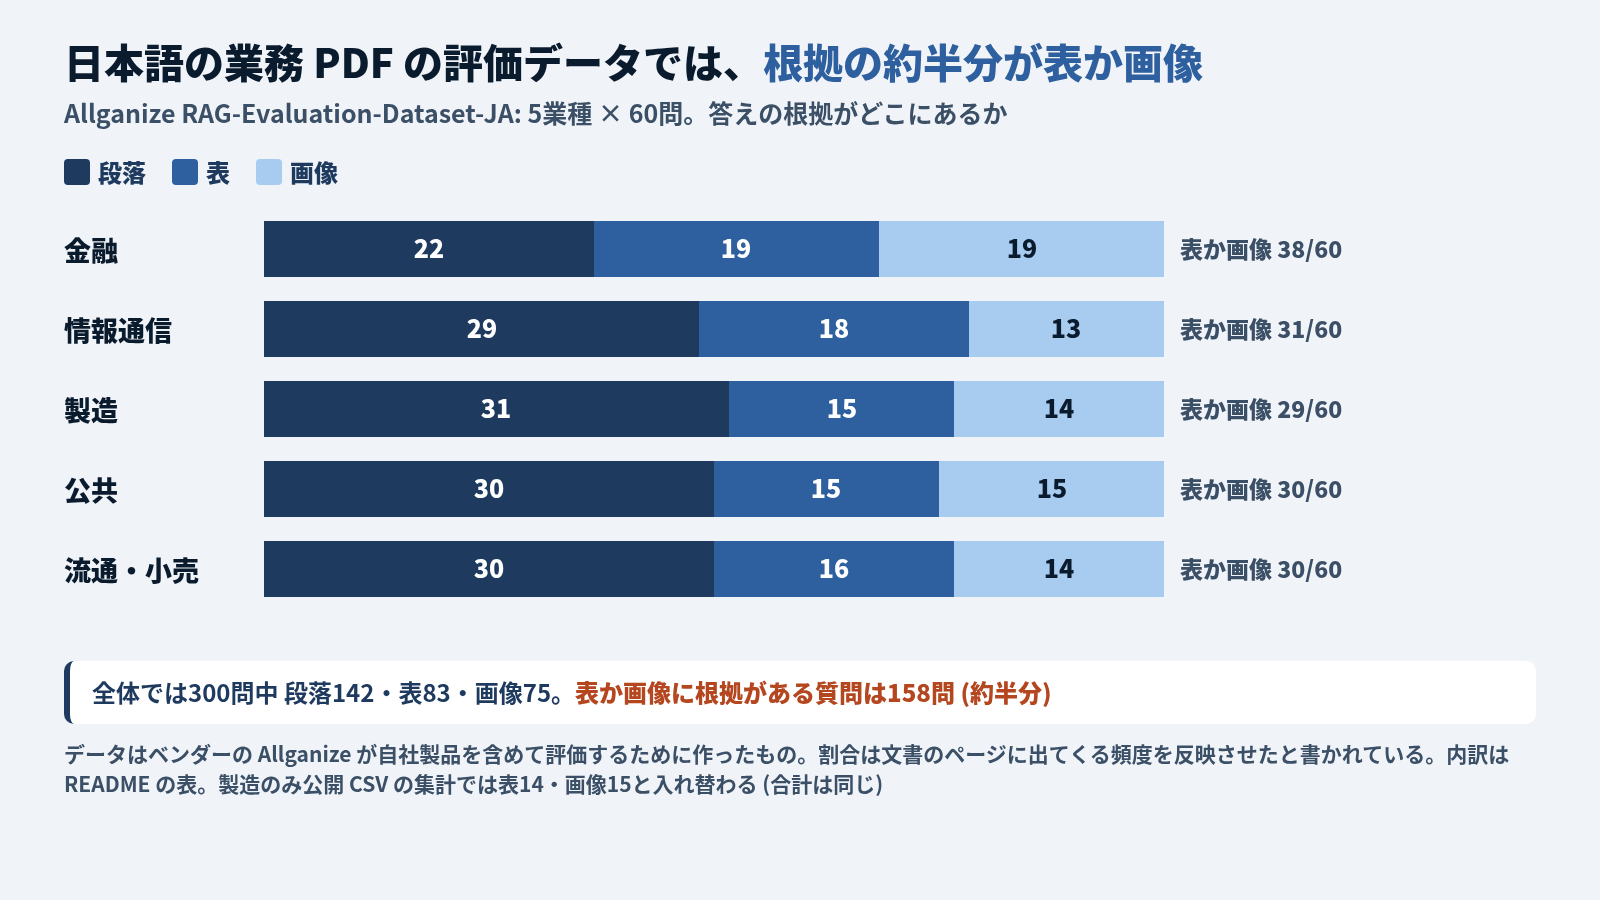
このデータはベンダーが自社製品を含めて評価するために作ったもので、順位表でも自社製品が上位にいます。順位の数字は割り引いて読む必要があります。それでも、根拠の種類の割合は質問の作り方の記録なので、日本の業務 PDF の中身を考える材料にはなります。
PDF を長文脈に全部入れるとき、テキストに変換してから入れる構成が多いはずです (構成の割合は調べておらず、私の推論です)。表が崩れたまま文字になり、画像の中の数字が抜け落ちていれば、全部入れても読めません。
検索でも同じです。どちらを選ぶかより前に、文書を正しく文字にする工程が精度の上限を決めます。
次に読む
検索をやめる、という選択肢を見たあとは、逆向きの流れを見ます。検索そのものを、LLM が道具として使いこなす方向です。何を検索するか、何回検索するかを人が設計するのをやめ、モデルが学んだ判断に任せます。Agentic RAG 2025年 検索を学ぶAIへ進んでください。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?