GraphRAG 系譜とベクトル検索との実測比較
ベクトル検索の RAG は、質問文に似たチャンクを上位から集めます。似ているかどうかで集めるので、答えが2つの文書にまたがっていたり、どのチャンクにも書かれていない全体像を問われたりすると届きません。自分で判断するRAGは、検索の回数を増やしてこれを補おうとしました。GraphRAG は逆に、索引を作る段階で文書から関係を取り出し、グラフにしておく方向です。
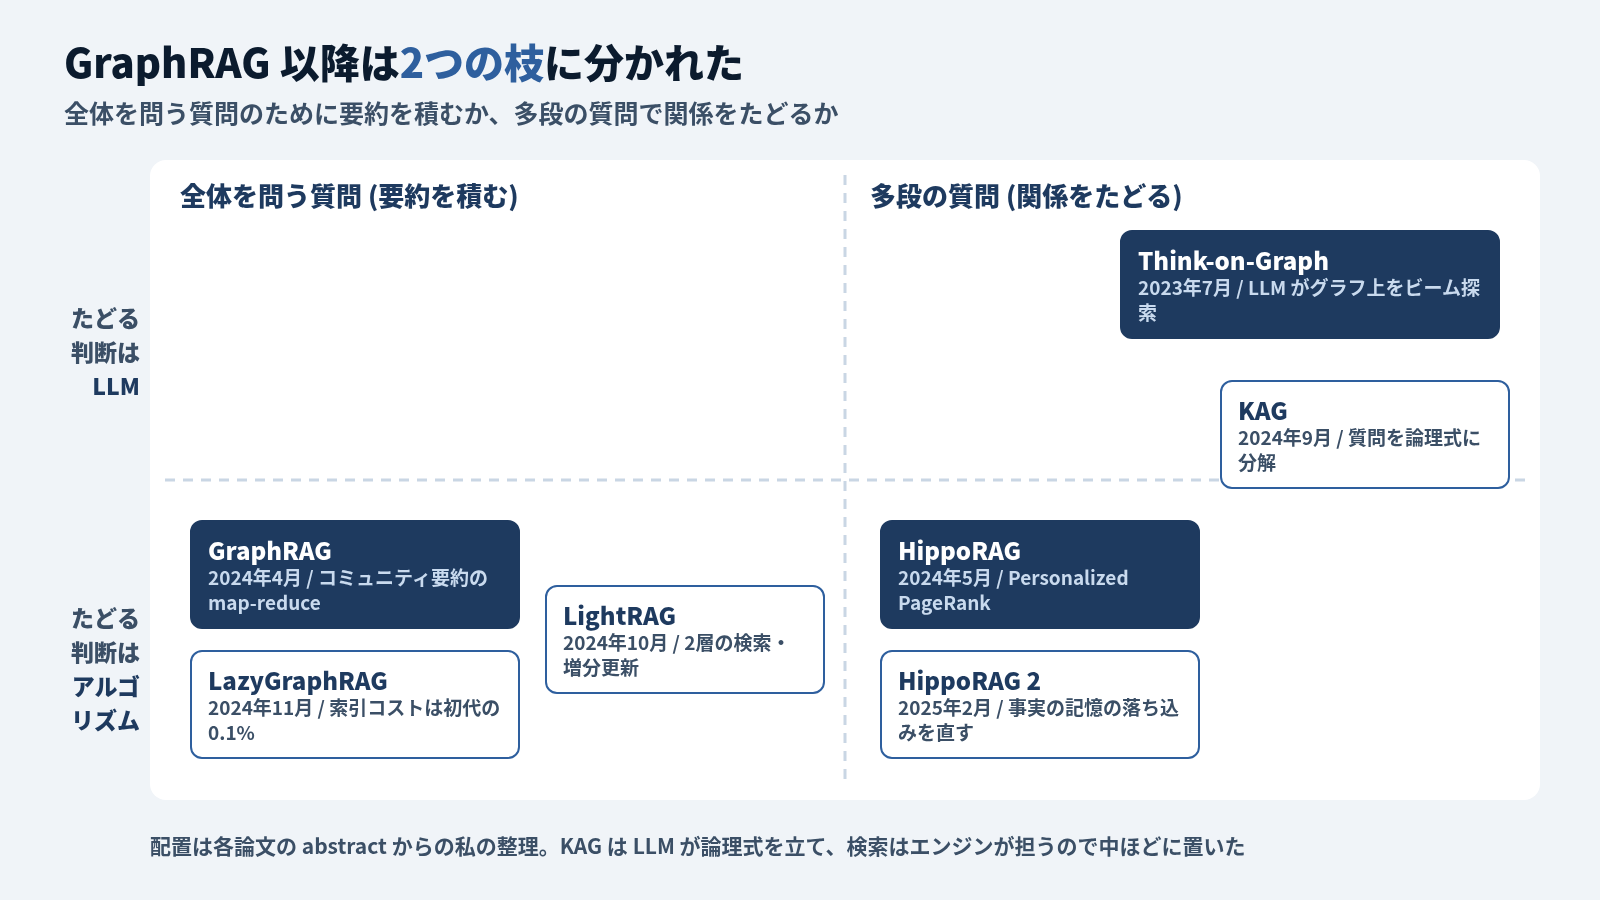
2024年2月の Microsoft Research のブログと4月の論文から、系譜は2つに分かれました。全体を問う質問に答えるために要約を積む方向 (GraphRAG、LazyGraphRAG、LightRAG) と、多段の質問でグラフをたどる方向 (HippoRAG、KAG、Think-on-Graph) です。どちらも、論文が報告する優位は特定の問いの型の上で出ています。
私が日本語の多段質問120問で測った予備測定では、自作の簡易 GraphRAG は61.7%で、ベクトル検索の73.3%を下回りました。負けが一番大きかったのは、グラフが2つ目の記事に届かなかった問いです。1つの作り方を1回測っただけです。それでも、グラフにすれば多段に強くなるとは限らない、とは言えます。
ナレッジグラフと、この章で使う言葉
この章では次の言葉を使います。
- ナレッジグラフ: 物事と物事の関係を、点と線で表したデータ
- ノード: 点。人物・施設・製品のような物事 (エンティティ) が1つずつ入る
- エッジ: 線。「死没した場所」「設置された」のような関係が1本ずつ入る
- 多段 (マルチホップ): 答えにたどり着くまでに、別々の文書にある事実を2つ以上つなぐ必要がある質問。グラフの上では、エッジを2本以上たどることに当たる
ナレッジグラフそのものの説明は既存シリーズの入口にあります。この章は、RAG の歴史の中で GraphRAG がどこから出てきて、どう枝分かれしたかに絞ります。
2024年2月: 素朴な RAG は点をつなげない
Microsoft Research は2024年2月13日のブログ (GraphRAG: Unlocking LLM discovery on narrative private data) で、素朴な RAG の苦手を2つ挙げました。別々の文書にある情報を、共通の属性を手がかりにつなぐこと (点と点をつなぐ)。それから、大きな文書の集まり全体にまたがる主題を要約することです。
1つ目は多段の質問の困りごとで、自分で判断する RAG が検索の回数で解こうとしたものと同じです。2つ目を、GraphRAG の論文は query-focused summarization (QFS、質問に沿った要約) の一種と呼び、主題にしました。
2024年4月: From Local to Global
2024年4月24日の論文「From Local to Global: A Graph RAG Approach to Query-Focused Summarization」(arXiv:2404.16130) は、全体を問う質問をこう位置づけます。
RAG fails on global questions directed at an entire text corpus, such as “What are the main themes in the dataset?”, since this is inherently a query-focused summarization (QFS) task, rather than an explicit retrieval task.
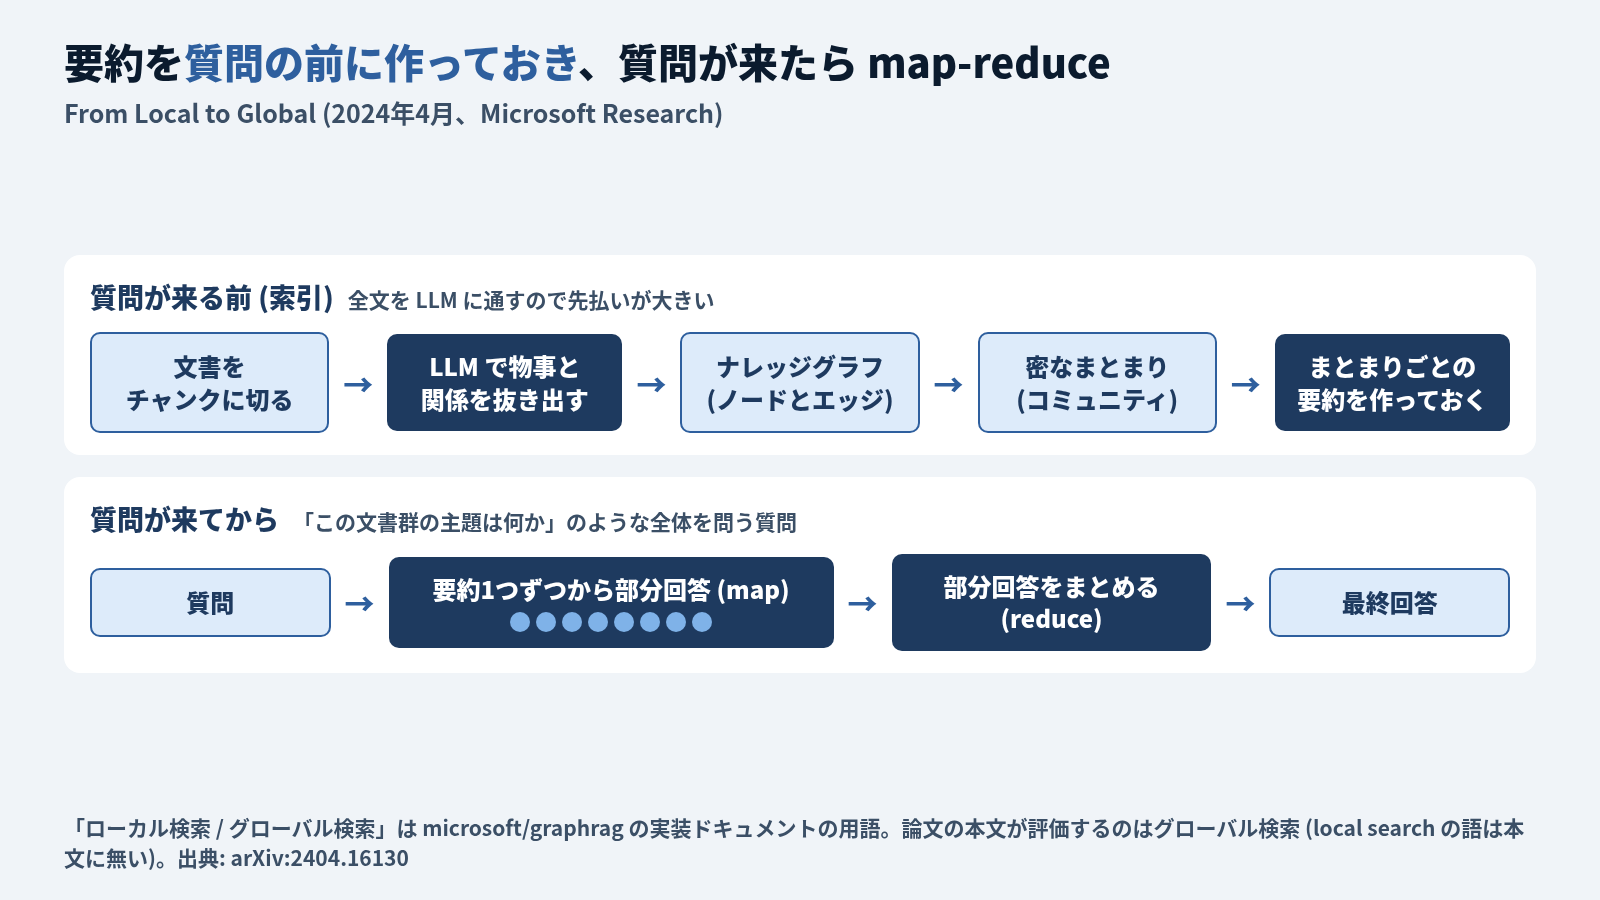
論文の見方では、「この文書群の主題は何か」は答えを取ってくる問題に当たりません。全体を要約する問題です。そこで、索引を2段階で作ります。
- LLM で文書のチャンクから物事と関係を抜き出し、ナレッジグラフを作る
- 密につながったノードのまとまり (コミュニティ) を見つけ、まとまりごとの要約を質問が来る前に作っておく
質問が来たら、コミュニティ要約の1つずつから部分回答を作り (map)、部分回答をまとめて最終回答にします (reduce)。
評価に使ったのは、約100万トークンの podcast 書き起こしと約170万トークンのニュース記事です。全体を問う質問を LLM に各125問作らせ、2つの方式の回答を LLM に見比べさせて勝ち負けを数えます (5回の平均)。論文の要約が書く包括性 (comprehensiveness) の勝率「podcast で72〜83%、ニュースで72〜80%」には、グラフを使わない条件 (TS: 元の文章を直接 map-reduce で要約する方式) が含まれています。グラフを使う4条件 (C0〜C3) に限ると、ベクトル検索の RAG に対する勝率は podcast で72・75・78・79%、ニュースで72・75・79・79%、つまり72〜79%です。一番勝ったのは、グラフを使わない TS です。83%と80%でした。全体を問う質問での優位は、グラフより要約の map-reduce から来る部分が大きい、と読めます。一番上の階層のコミュニティ要約 (C0) を使う条件では、元の文章を直接要約する方式より97%以上少ないトークンで済んだと書いています。
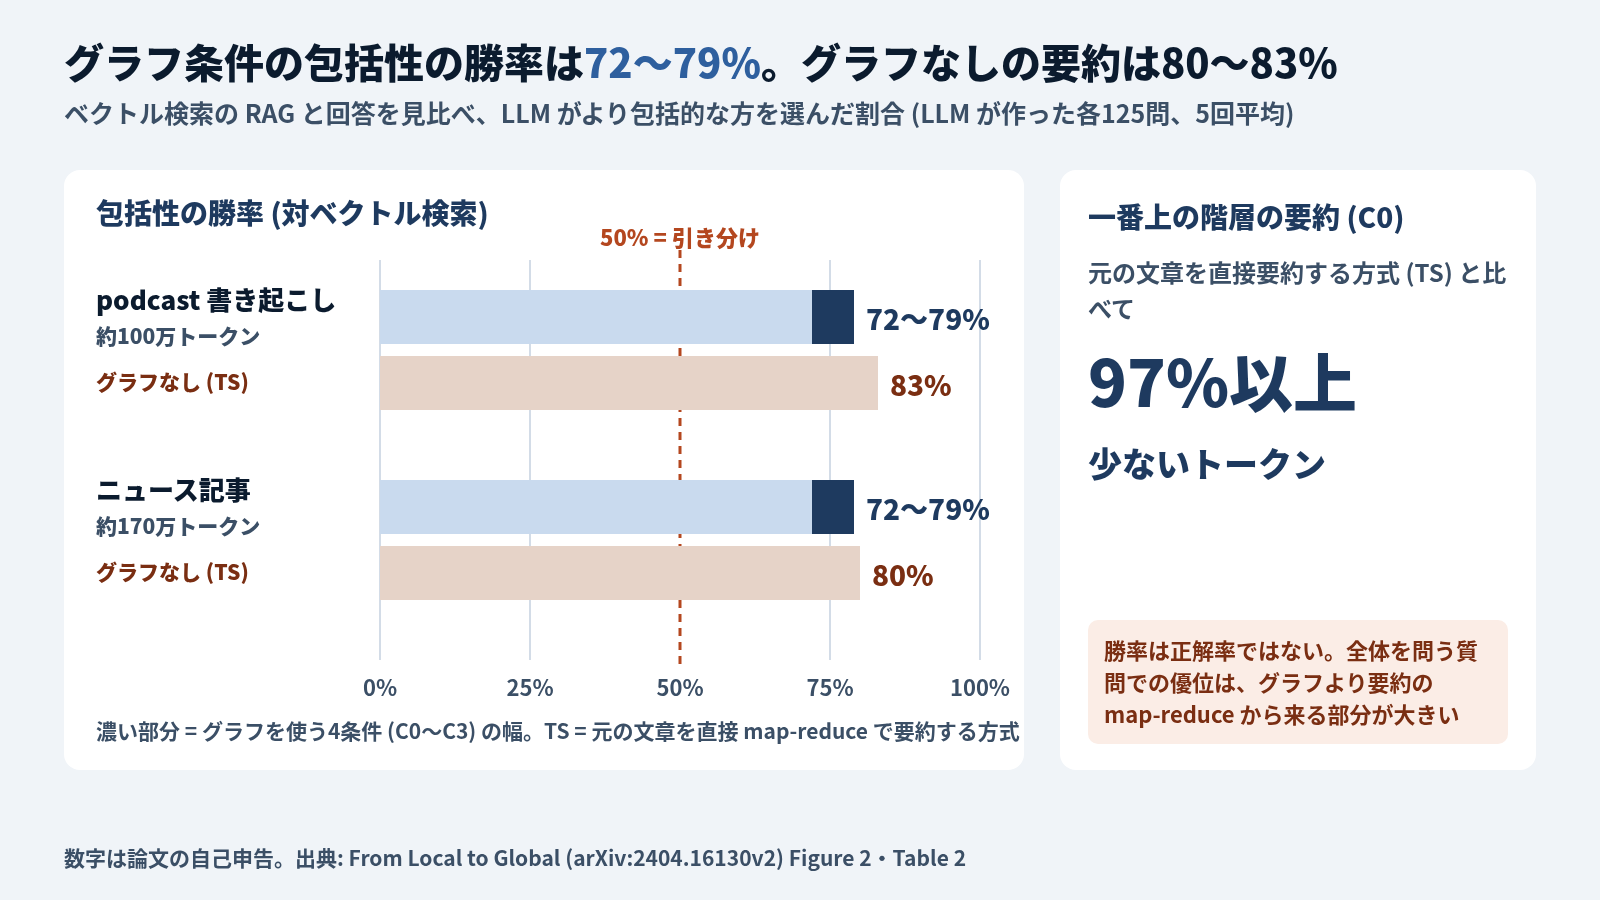
数字を読むときに外せない条件が2つあります。勝率は正解率ではありません。LLM がどちらの回答がより包括的かを選んだ割合です。もう1つ、扱っている質問は全体の主題を問う型で、「東條英機が死没した施設は何という戦争の後に設置されましたか」のような答えが1つに決まる多段の質問ではありません。
ここでよく出てくる「ローカル検索 / グローバル検索」という呼び分けは、microsoft/graphrag (2024年3月27日に repo 作成) の実装ドキュメントの用語です。質問に出てくる物事から出発して近くの関係と文章を集めるのがローカル、コミュニティ要約を全部使うのがグローバルです。論文 (arXiv v2) の本文にも global search の語は出てきますが、local search の語はありません。
2024年11月以降: 安く作る、たどって答える
初代の GraphRAG は、索引の段階で全文を LLM に通します。文書が増えるほど先払いが膨らむので、その後の手法はまず費用に手を付け、次に多段の質問へ広がりました。
LazyGraphRAG (2024年11月25日、Microsoft Research ブログ) は、要約を質問が来るまで遅らせ、索引コストを初代 GraphRAG の0.1%に下げたと書いています (自社評価)。この桁の変化が何を変えたかは、なぜ今ナレッジグラフで扱いました。
LightRAG (2024年10月8日、arXiv:2410.05779) は、グラフとベクトルを組み合わせます。検索は2層で、具体的な物事の層と抽象的な主題の層を引きます。新しい文書が来たときに索引を作り直さず足せる、増分更新も売りにしています。
HippoRAG (2024年5月23日、arXiv:2405.14831、NeurIPS 2024) は多段の質問に向いた設計です。ナレッジグラフの上で、質問に出てくるノードから Personalized PageRank という計算を回し、関係の先にあるノードまで一度に点数を配ります。多段の質問で既存手法を最大20%上回ったと報告しています。1回の検索で IRCoT の反復検索と同等以上の成績を出し、しかも10〜30倍安く6〜13倍速い、という主張です (論文の自己申告)。IRCoT は、自分で判断する RAG の段階で推論と検索を交互に回した手法です。同じ多段の問題を、こちらは検索の回数でなく索引の形で解きました。
HippoRAG 2 (2025年2月20日、arXiv:2502.14802、ICML 2025) の abstract は、構造を足した RAG の弱点をはっきり書いています。ナレッジグラフのような構造を足した RAG は、関係をつなぐ課題 (associativity) では伸びる一方で、
their performance on more basic factual memory tasks drops considerably below standard RAG.
素朴な事実を答える課題では、普通の RAG を大きく下回る、という指摘です。HippoRAG 2 はこの落ち込みを直す方向で、元の文章の扱いを厚くしています。
KAG (2024年9月10日、arXiv:2409.13731、Ant Group) は、ナレッジグラフと元のチャンクを相互に索引します。質問は論理式に分解して推論させます。2WikiMultiHopQA で F1 が相対19.6%、HotpotQA で33.5%改善したと書いています (論文の自己申告)。
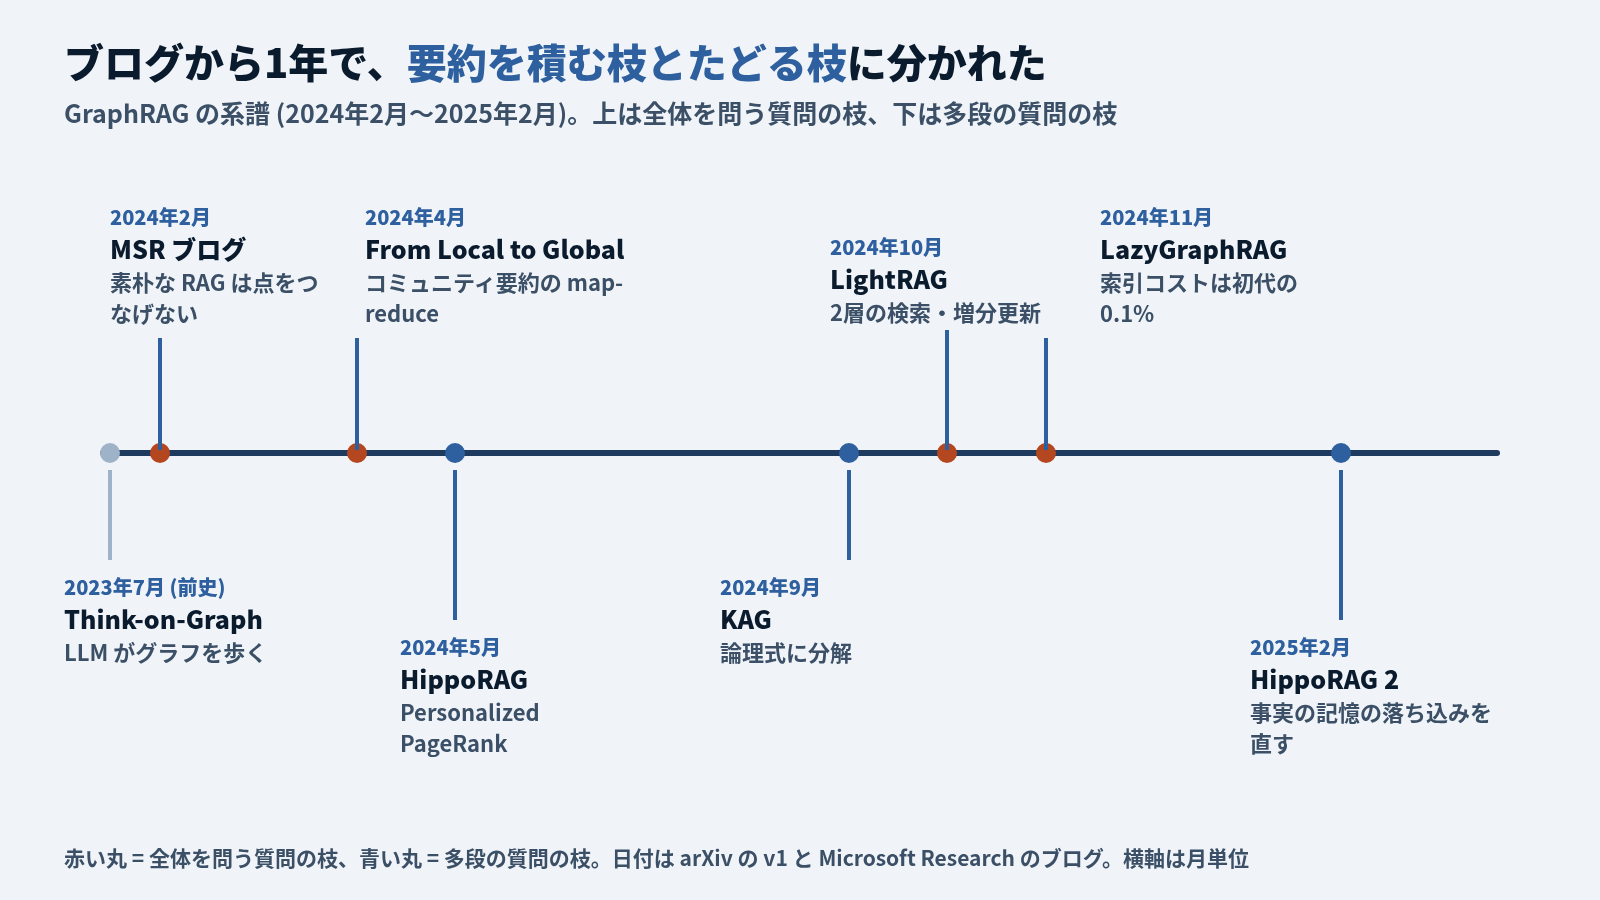
Think-on-Graph (2023年7月15日、arXiv:2307.07697、ICLR 2024) は時期が少し早いですが、系譜の上では別の枝です。LLM をエージェントとしてナレッジグラフの上を歩かせ、有望な経路をビーム探索で残しながらたどります。グラフをたどる判断は LLM が持ちます。
実測: 日本語の多段質問120問で、自作の簡易 GraphRAG を測った
論文の数字は、それぞれの作り方と問いの型の上で出ています。手元のモデルと日本語の質問ではどうなるかを、小さく1回だけ測りました (2026年10月24〜25日。実験リポジトリ iris-lab の exp048 で、リポジトリは非公開です。数字は集計スクリプトが出した results/summary.md を中心に、一部は README と生データの集計から引いています)。
- 質問: JEMHopQA (理研の日本語多段質問データセット) の dev 版120問。2つの記事の事実をつないで答える「つなぐ型」(compositional) 47問と、2つを比べる「比べる型」(comparison) 73問
- 文書: 各問の関連記事 219本を Wikipedia から取り、記事の冒頭4,000文字で打ち切って (193記事が打ち切り)、2,382個のチャンク (最大400文字) に切って1つの山にまとめた
- モデル: 回答も関係の抽出も qwen3.5:9b (Ollama、温度0、think=false で推論モードは切った)。埋め込みは bge-m3
- 条件: 文脈なし / ベクトル検索 / 自作の簡易 GraphRAG / 両方を混ぜたもの。文脈の上限はどれも3,000文字
- 追加の変種: グラフの関係の行を、質問との文字の重なりで並べ直してから詰める版も全120問で回した。簡易 GraphRAG が59.2%、混ぜたものが65.0%で、並べ直さない版より上がらなかった
ここで言う GraphRAG は自作の簡易版で、Microsoft GraphRAG ではありません。チャンクごとに9Bで (主語, 関係, 目的語) を抜き出してグラフにし、質問に出てくる物事のノードから1〜2段の近くの関係と、その出典のチャンクを文脈に入れます。コミュニティ要約も、同じ物事の表記ゆれをまとめる処理もしていません。
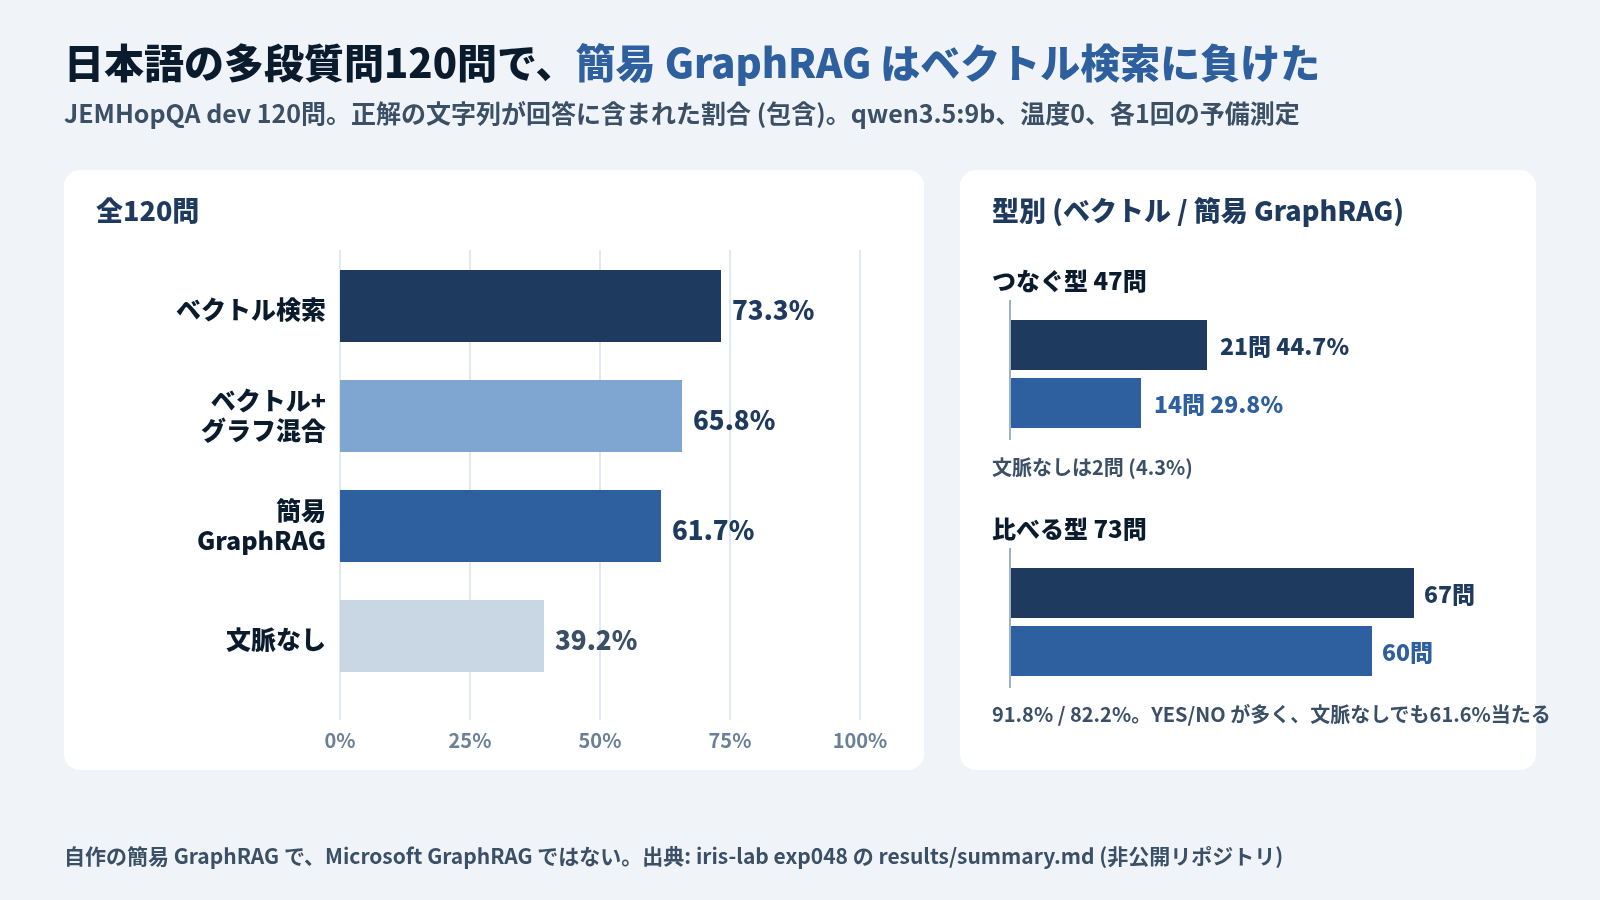
正解の文字列が回答に含まれた割合は、ベクトル検索が73.3%で一番高く、簡易 GraphRAG は61.7%でした。混ぜたものは65.8%、文脈なしは39.2%です。差が一番大きいのはつなぐ型で、ベクトル検索の21/47問に対して簡易 GraphRAG は14/47問です。
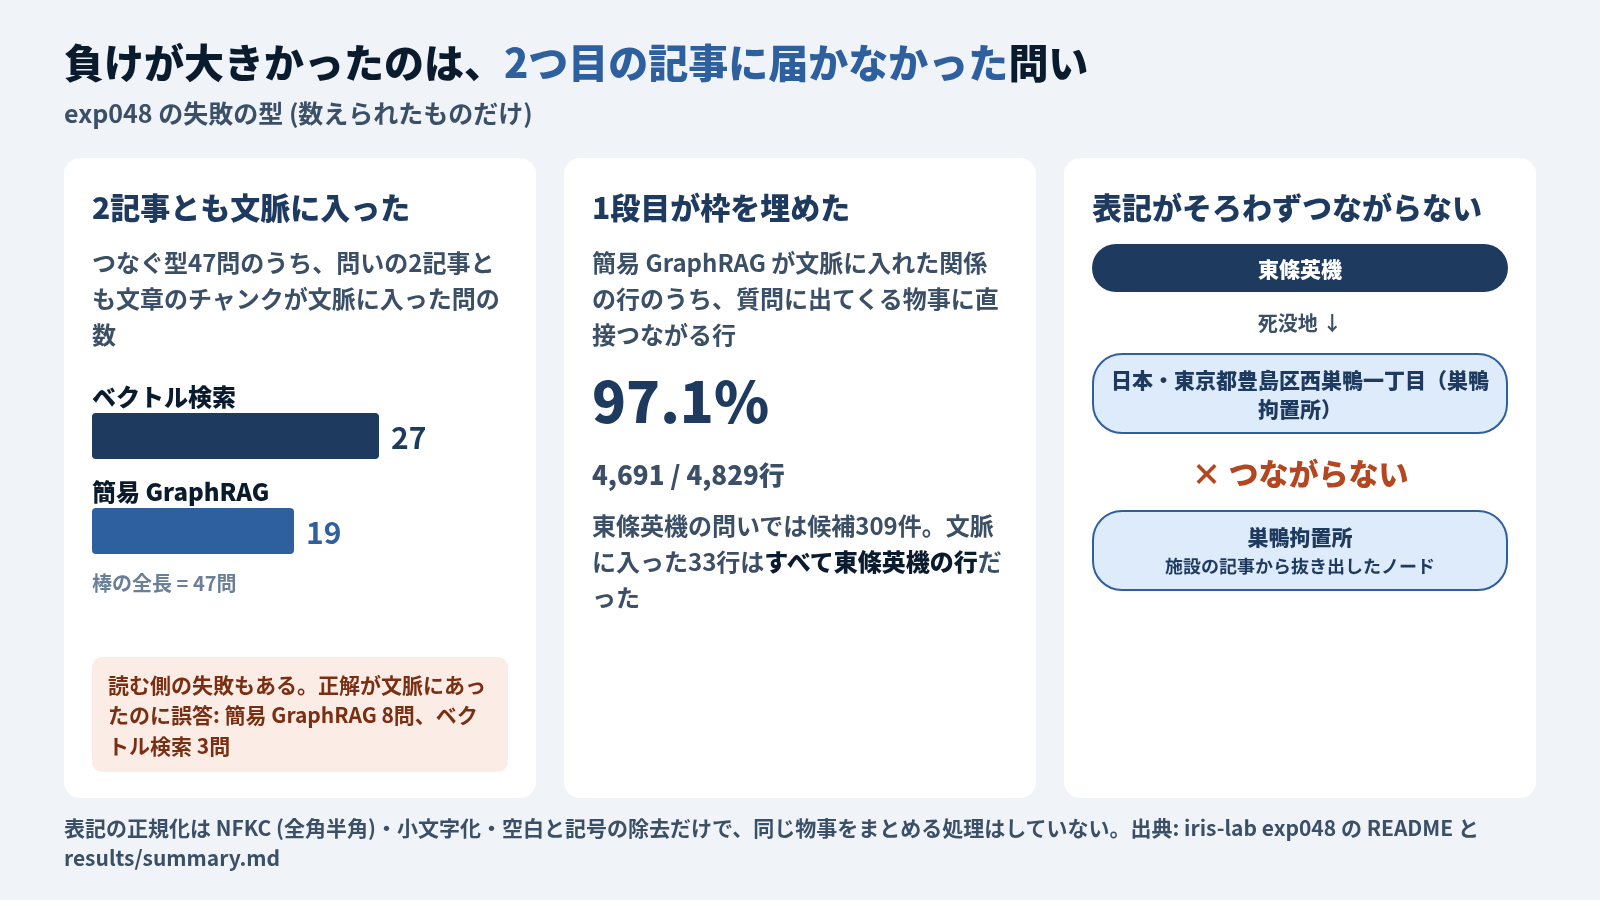
主な原因は検索の側にあると私は見ています。つなぐ型47問のうち、問いの2記事ともチャンクが文脈に入ったのは、ベクトル検索で27問、簡易 GraphRAG で19問です。簡易 GraphRAG が文脈に入れた関係の行は、97.1% (4,691/4,829行) が質問に出てくる物事に直接つながる行でした。1段目の関係が文脈の枠を埋めてしまい、2段目の先にある記事の事実がほとんど入らなかったわけです。冒頭の東條英機の問いでは、近くの関係の候補が309件あり、文脈に入った33行はすべて東條英機の行でした。ただし、読む側の失敗もあります。正解が文脈に入っていたのに誤答した問いは、簡易 GraphRAG で8問、ベクトル検索で3問でした。
もう1つ、表記をそろえる処理が粗かったことも効いています。東條英機の死没地は「日本・東京都豊島区西巣鴨一丁目(巣鴨拘置所)」という1つの長いノードになり、巣鴨拘置所の記事から抜き出した「巣鴨拘置所」のノードとつながりませんでした。グラフの上で2段たどる道が、そもそも無かったことになります。
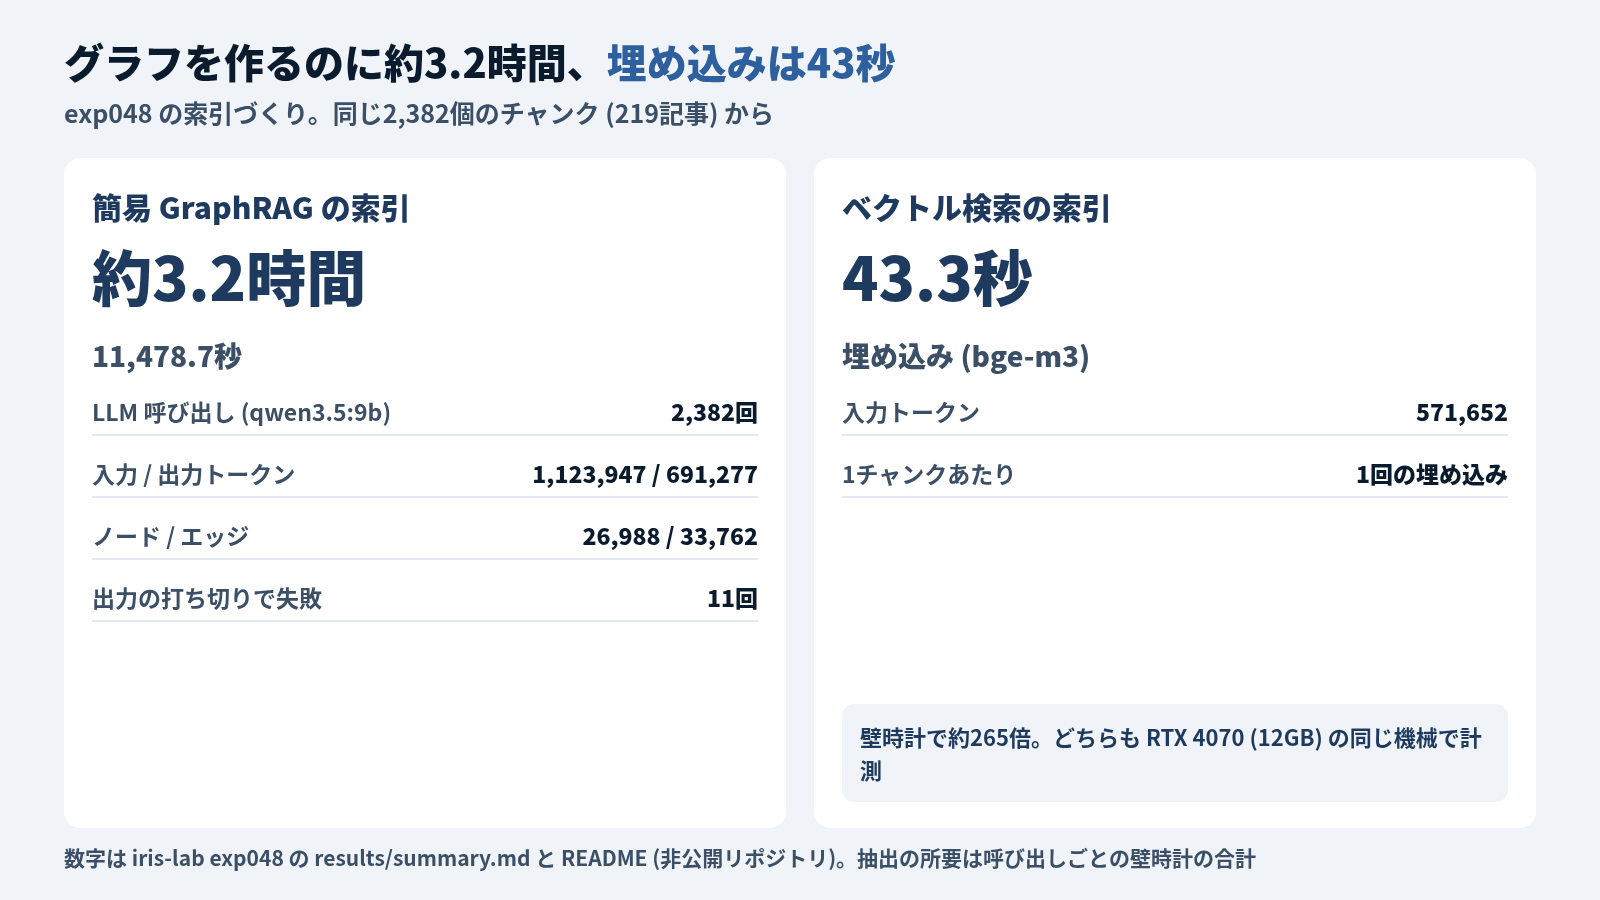
作る費用の差も大きく出ました。関係の抽出は2,382回の LLM 呼び出しで約3.2時間かかり、ノード26,988個、エッジ33,762本のグラフになりました。同じチャンクの埋め込みは43.3秒です。
HippoRAG 2 の論文と並べると、向きが逆です。論文は、構造を足した RAG が落ちるのは素朴な事実の記憶で、多段 (associativity) ではむしろ伸びると書いています。私の測定では、多段の質問でもベクトル検索を下回りました。比べられる測定ではありません。私の作り方のほうがずっと粗いからです。言えるのは、1つの作り方を1回測った範囲で、1段目で文脈が埋まる作り方ではベクトル検索に負けた、というところまでです。
グラフをそもそも入れるべきか、何段までたどれるかは、既存シリーズで別に測っています。何段目から崩れるかとモデルの大きさの関係はナレッジグラフが効く段数、何をグラフにするかの判断は何をグラフにするかにあります。この章ではそこを繰り返しません。
日本では
富士通は2024年6月4日に、企業規則や法令、マニュアル、映像などの大量のデータからナレッジグラフを自動で作り、生成 AI の回答に使う「ナレッジグラフ拡張 RAG」を発表しました (プレスリリース)。技術紹介のページでは、参照できる量を1,000万トークン超としています (技術ページ)。ベンダーの自己申告で、比較の条件は書かれていません。
研究の側では、神戸大学とデンソーテンがナレッジグラフを使う RAG に BM25 を組み合わせた手法を言語処理学会 NLP2026 (P1-10) で発表しています。ただし評価データは英語です。ソフトバンクは Amazon Neptune でのグラフ RAG の検証を公開していますが、定性的な報告で数字はありません。
日本語の多段質問で GraphRAG 系とベクトル検索を同じ条件で比べた公開の数字は、私が探した範囲では見つかりませんでした。上の exp048 は、その空白を埋めるための小さな1回目です。
製造業でナレッジグラフを使う国内事例は、検索を良くするという技術の話より、熟練者が辞めると知識が消えるという組織の話として出てきます。それは次の章で扱います。
次に読む
GraphRAG を製造業の現場に持ち込むと、文書をグラフにする工程より手前で詰まります。熟練者の頭の中にしかない判断を、どうやって言葉にするか。暗黙知をナレッジグラフに 2007年問題からに進んでください。
 関連書籍 ナレッジグラフ活用大全 ナレッジグラフ 活用大全 | GraphRAG・Neo4j・RDF・Property Graph・Emotion AI の実践書 書籍ページを見る →
この記事は役に立ちましたか?